- تحدد البنية الدقيقة كيفية تنفيذ وحدة المعالجة المركزية لمجموعة تعليمات المعالج وتحدد عدد التعليمات لكل دورة، والتوازي الداخلي، والكفاءة الفعلية، بما يتجاوز التردد أو حجم الذاكرة المؤقتة.
- تجمع تصميمات مثل AMD Zen و Zen 2 بين ذاكرة التخزين المؤقت المحسّنة، والتنفيذ خارج الترتيب، و SMT، ووحدات المتجهات الكبيرة لتعزيز الأداء لكل دورة ولكل واط.
- تتيح استراتيجية رقاقة المعالج و Infinity Fabric زيادة عدد النوى في EPYC و Ryzen مع الحفاظ على تكاليف مضبوطة وأداء تنافسي للغاية.
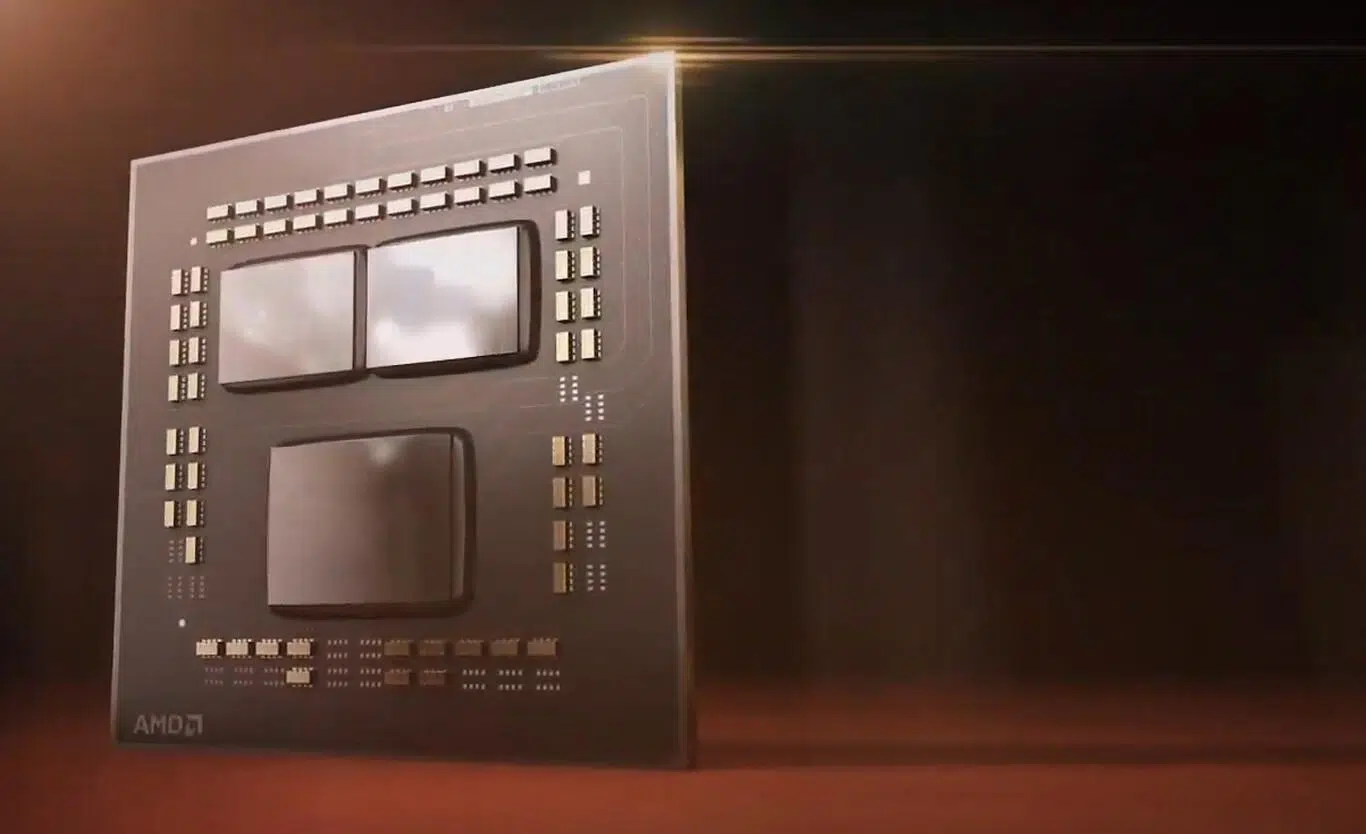
غالباً ما يتم تجاهل البنية الدقيقة لوحدة المعالجة المركزية لصالح أرقام أكثر جاذبية مثل جيجاهرتز أو ميجابايت من ذاكرة التخزين المؤقت، ولكن في التصميم الداخلي للمعالج تحديداً، يتم تحديد معظم أدائه الحقيقي وكفاءته، وحتى نوع البرامج التي يمكنها الاستفادة منه على أفضل وجه.
عند قراءة المواصفات الفنية التي تشير إلى النوى، والخيوط، وذاكرة التخزين المؤقت L3، أو AVX2 ، فإنك في الواقع ترى النتائج الملموسة لبنية معمارية دقيقة معينة. إن فهم كيفية تنظيم هذه المكونات داخليًا، وما يميز معالج Zen 3 عن Zen 2، أو معالج Intel الهجين عن معالج Ryzen الكلاسيكي، أمر أساسي لاختيار وحدة المعالجة المركزية المناسبة لك ومعرفة سبب تفوق بعضها في الألعاب، والبعض الآخر في عمليات الرندر، والبعض الآخر في مهام الخوادم.
ISA، والهندسة المعمارية الكلية، والهندسة المعمارية الجزئية: تنظيم المفاهيم
قبل الخوض في تعقيدات خطوط المعالجة والمتنبئات، من المفيد التمييز بين ثلاثة مستويات غالباً ما يتم الخلط بينها: بنية النظام الكلية، ومجموعة تعليمات المعالج، والبنية الدقيقة . يصف كل منها طبقة مختلفة من طبقات الحاسوب.
من جهة، هناك البنية الكلية، أو تصميم النظام الشامل ، الذي يشمل كل ما تراه على اللوحة الأم: وحدة المعالجة المركزية، ووحدات التحكم بالذاكرة، والناقلات، والذاكرة الرئيسية، ورقائق الإدخال/الإخراج، ووحدات التحكم بالتخزين، وأي مسرعات خارجية، ومنطق الوصول المباشر إلى الذاكرة. إنها صورة عامة لكيفية اتصال مكونات الأجهزة الكبيرة وكيفية تدفق البيانات بينها.
وفوق ذلك توجد بنية مجموعة التعليمات (ISA) ، وهي مجموعة التعليمات التي يفهمها المعالج: أنواع البيانات التي يتعامل معها، وحجم الكلمة، وعدد ونوع السجلات، وأنماط العنونة، وتنسيقات التعليمات، وما إلى ذلك. عندما تبرمج بلغة التجميع باستخدام رموز مختصرة مثل ADD وSUB وMUL ، أو استدعاء ملحقات مثل SSE أو AVX أو NEON، فإنك تتواصل مباشرة مع بنية مجموعة التعليمات (ISA).
وأخيرًا، لدينا الشفرة الدقيقة، أو μISA ، التي تُحدد العمليات الدقيقة الداخلية التي تستخدمها بعض البنى المعقدة (مثل x86) لتنفيذ تعليمات CISC الخاصة بها. ويمكن تحديث هذه الشفرة الدقيقة عبر البرامج الثابتة لإصلاح الأخطاء أو إضافة دعم لتعليمات جديدة.
ما هي البنية الدقيقة لوحدة المعالجة المركزية (CPU) تحديداً؟
تُعدّ البنية الدقيقة لوحدة المعالجة المركزية بمثابة المخطط الداخلي الذي يُحدد كيفية تنفيذ تعليمات مجموعة تعليمات المعالج (ISA) وكيفية انتقال البيانات داخل الشريحة. قد يشترك معالجان في نفس مجموعة تعليمات المعالج (على سبيل المثال، AMD64 في معالجات إنتل وAMD)، ومع ذلك يختلفان اختلافًا جذريًا في السلوك والأداء، وذلك بسبب بنيتهما الدقيقة أو ربما نتيجةً لها.
يتضمن هذا التصميم عناصر مثل نوع وحدة التحكم ، وما إذا كان يتم استخدام التعليمات البرمجية الدقيقة القابلة للبرمجة أو المنطق السلكي؛ والتسلسل الهرمي للذاكرة؛ وعمق خط الأنابيب؛ وعدد الوحدات الوظيفية التي تعمل بالتوازي؛ وما إذا كان المعالج قادرًا على تنفيذ التعليمات خارج الترتيب وبشكل تخميني.
بالإضافة إلى ذلك، يجب على المصمم اختيار عمق خط الأنابيب : من وحدات المعالجة المركزية البسيطة بدون خطوط أنابيب، حيث تتم معالجة كل تعليمة من البداية إلى النهاية قبل بدء التعليمة التالية، إلى التصميمات الحديثة ذات المراحل العديدة (جلب، فك التشفير، إعادة التسمية، الإرسال، التنفيذ، الكتابة مرة أخرى، التقاعد ...) التي تسمح بتشغيل العشرات من التعليمات في نفس الوقت.
يرتبط بهذا عدد ونوع وحدات التنفيذ : وحدات الحساب والمنطق للأعداد الصحيحة، ووحدات الضرب، ووحدات القسمة، ووحدات الفاصلة العائمة للأعداد العشرية العددية والمتجهة، ووحدات توليد العناوين لحساب عناوين الذاكرة، ووحدات القفز، وما إلى ذلك. إذا كانت هناك عدة وحدات من نفس النوع، فإننا نتحدث عن معالجات فائقة القياس، قادرة على إرسال عدة تعليمات في كل دورة.
هذا هو الأساس لتقنيات متقدمة مثل التنفيذ التخميني ، حيث يتوقع المعالج حل أحد الفروع وينفذ التعليمات من أحد هذه الفروع مسبقًا. إذا كان التوقع صحيحًا، يتم توفير الوقت؛ أما إذا فشل، فيتم تجاهل العمل المنجز وتفريغ خط الأنابيب، مع ما يترتب على ذلك من تكلفة.
تستخدم معظم وحدات المعالجة المركزية الحديثة عالية الأداء أيضًا التنفيذ خارج الترتيب (OoO) . فبدلاً من الالتزام الصارم بترتيب البرنامج، يقوم المعالج داخليًا بإعادة ترتيب التعليمات وتنفيذ تلك التي تكون بياناتها جاهزة أولاً، متجنبًا دورات الخمول بينما تنتظر التعليمات الأخرى الذاكرة أو نتيجة العمليات السابقة.
لضمان عمل كل هذا دون الإخلال بدلالات البرنامج، يتم استخدام إعادة تسمية السجلات . يرى المترجم مجموعة محدودة من السجلات المنطقية، لكن البنية الدقيقة تترجمها إلى مجموعة أكبر من السجلات الفيزيائية، وتُعيّن وجهات جديدة ديناميكيًا لكسر التبعيات الزائفة والسماح بمزيد من التوازي.
وأخيرًا، يمكن أن يركز التصميم على إضافة التوازي على مستوى النواة والخيوط . ويشمل ذلك كل شيء بدءًا من وحدات المعالجة المركزية أحادية النواة وصولًا إلى الرقاقات التي تحتوي على عشرات أو مئات النوى (متعددة النوى)، وأنظمة المعالجات المتعددة ذات المقابس المتعددة المتصلة بشبكات متداخلة عالية السرعة (Infinity Fabric، وIntel Mesh، وNVLink، وما إلى ذلك)، ودعم تعدد الخيوط المتزامن (SMT) بحيث يمكن لكل نواة فعلية معالجة خيطين منطقيين أو أكثر.
التوافق، ومجموعات تعليمات المعالج، وعائلات البنية الدقيقة
بما أن البنية الدقيقة ليست سوى تطبيق محدد لمجموعة تعليمات المعالج ، فقد تحتوي مجموعة تعليمات المعالج الواحدة على عشرات البنى الدقيقة المختلفة على مر السنين وبين مختلف الشركات المصنعة. وهذا ما يحدث تحديدًا مع معالجات x86-64/AMD64 أو ARM.
بالنظر إلى معالجات AMD ضمن بنية AMD64 ISA فقط، نجد عائلات متنوعة مثل K8/Hammer وK10 وBulldozer وسلسلة Zen بأكملها (Zen وZen+ وZen 2 وZen 3 وZen 4...). جميعها تنفذ نفس مجموعة التعليمات الأساسية، لكن تنظيمها الداخلي وذاكرات التخزين المؤقت وخطوط الأنابيب وأساليب التنفيذ المتوازي تختلف اختلافًا جذريًا.
عند تغيير بنية مجموعة التعليمات (ISA)، يكون التحسن في التوافق تاماً. لا يمكن لمعالج قائم على بنية ARM A64 (مثل Apple Silicon) تشغيل الملفات الثنائية المُجمّعة لبنية x86-64، والعكس صحيح، إلا باستخدام طبقة ترجمة أو محاكاة مثل Rosetta 2 أو QEMU أو ما شابه، مع ما يترتب على ذلك من انخفاض في الأداء.
حتى بين المعالجات التي تشترك في نفس مجموعة التعليمات (ISA)، لا يوجد ما يضمن دعمها جميعًا لنفس مجموعة التعليمات أو الامتدادات. قد تفتقر شريحة قديمة إلى AVX2 أو AVX-512، أو قد لا تُنفذ شريحة ARM SoC سوى مجموعة فرعية من الامتدادات الاختيارية. لذلك، قد يفشل برنامج ثنائي يستخدم AVX-512 بكثافة في الإقلاع على وحدة معالجة مركزية لا تدعم سوى SSE4.
عند تجميع البرامج، من الممارسات الشائعة إنشاء ملفات تنفيذية عامة لمجموعة تعليمات محددة (على سبيل المثال، x86-64 مع دعم SSE2 على الأقل) دون الاستفادة الكاملة من أي بنية دقيقة معينة، وذلك لضمان تشغيل الملف التنفيذي على أكبر عدد ممكن من وحدات المعالجة المركزية. مع ذلك، إذا قمت بالتجميع باستخدام علامات ضبط خاصة ببنية دقيقة محددة (مثل -march=znver3، -mtune=skylake، إلخ)، يمكنك تحسين الأداء بشكل ملحوظ على تلك العائلة من المعالجات، على حساب فقدان التوافق مع غيرها.
تراخيص ISA والملكية الفكرية للتصميم
لا يقتصر الأمر على حماية شفرة البرنامج بالتراخيص، بل تشمل الحماية أيضًا مجموعات تعليمات المعالج (ISAs) والبنى الدقيقة . لا يمكن لأحد استنساخ مجموعة تعليمات معالج x86 أو AMD64 بشكل قانوني دون ترخيص، تمامًا كما لا يمكن نسخ تصميم وحدة المعالجة المركزية (CPU) الخاص دون إذن.
في مجال مجموعات تعليمات المعالجات (ISAs)، توجد ثلاثة مناهج رئيسية. من جهة، هناك مجموعات تعليمات المعالجات المغلقة ، حيث يتحكم المالك بشكل صارم في من يمكنه تنفيذ النوى المتوافقة. المثال الكلاسيكي هو IA-32 (x86-32)، الذي كان مملوكًا تاريخيًا لشركة إنتل، والتي منحت تراخيص لشركات AMD وVIA وغيرها، بعد معارك قانونية.
ينطبق وضع مشابه على معالجات AMD64/x86-64 ، التي صممتها AMD في البداية ثم رخصتها لاحقًا لشركة Intel (التي أطلقت عليها اسم EM64T) من خلال اتفاقيات الترخيص المتبادل. كما حصلت شركات أخرى، مثل Hygon في الصين، على تراخيص لإصدارات محددة (على سبيل المثال، Zen 1 للسوق الصينية).
ثم لدينا بنى مجموعات التعليمات (ISAs) ذات التراخيص المرنة ، حيث يقدم المالك تراخيص ISA ونوى IP جاهزة للتكامل. تُعدّ ARM وSPARC وOpenPOWER من بين هذه البنى: يمكنك الدفع لاستخدام Cortex A/M/R أو Neoverse كما هي، أو للحصول على ترخيص يسمح لك بتصميم بنى دقيقة خاصة بك فوق بنية مجموعة التعليمات، كما تفعل Apple مع M1/M2/M3 أو Qualcomm مع Kryo.
وأخيرًا، توجد بنى معمارية مجموعة التعليمات مفتوحة المصدر ، حيث يمكن لأي شخص إنشاء بنى معمارية دقيقة متوافقة دون دفع رسوم ترخيص (مع إمكانية تسجيل براءات اختراع أو إغلاق تطبيقاتهم الخاصة). يُعدّ RISC-V أفضل مثال على ذلك: فبنية مجموعة التعليمات هذه مرخصة بموجب ترخيص BSD المتساهل، وتتوفر خيارات تتراوح بين نواة مفتوحة بالكامل مكتوبة بلغة Verilog أو Chisel، وتصاميم تجارية مغلقة.
إضافةً إلى بنية مجموعة التعليمات (ISA)، تُعدّ كل بنية دقيقة محددة (مثل نواة Zen 4، أو Cortex X4، أو تصميم وحدة معالجة الرسومات، إلخ) جزءًا من الملكية الفكرية المسجلة أو الحاصلة على براءة اختراع. كما توجد هنا تصاميم مفتوحة المصدر، منشورة كنوى برمجية بلغة وصف الأجهزة (HDL) لتوليفها في مصفوفات البوابات المنطقية القابلة للبرمجة (FPGAs) أو دمجها في أنظمة على رقاقة (SoCs) مخصصة.
التعمق أكثر في البنى الدقيقة الحديثة: حالة AMD Zen
لفهم كيفية ترجمة كل هذا إلى أداء واقعي، لا شيء يضاهي تحليل عائلة منتجات محددة. لقد أحدثت AMD تحولاً جذرياً في أعمالها بفضل معمارية Zen وإصداراتها المتعاقبة ، إذ انتقلت من حقبة Bulldozer الصعبة ومعالجات FX القديمة إلى منافسة Intel بقوة (بل وتفوق عليها أحياناً) في أسواق أجهزة الكمبيوتر المكتبية والخوادم وأجهزة الكمبيوتر المحمولة.
بعد فشل استراتيجية AMD Fusion ، أعادت الشركة هيكلة عملياتها واختارت تصميمًا عالي الأداء بقيادة جيم كيلر، من بين آخرين. هدفت خطة Zen إلى زيادة عدد التعليمات المنفذة في الدورة الواحدة (IPC) بشكل كبير مقارنةً بمعالج Bulldozer، وتحسين الأداء لكل واط، واستعادة مكانتها في أداء النواة الواحدة، حيث كانت إنتل متفوقة لسنوات.
كان أحد التغييرات الرئيسية هو تعزيز الواجهة الأمامية ، وهي الجزء المسؤول عن جلب التعليمات وتجهيزها. قدّمت معمارية Zen ذاكرة تخزين مؤقتة للعمليات الدقيقة ، تخزن العمليات الدقيقة التي تم فك تشفيرها مسبقًا، على غرار ما فعلته بعض معماريات Intel الدقيقة مثل Conroe. افتقرت معمارية Bulldozer إلى هذه الميزة، واعتمدت بشكل أكبر على التسلسل الهرمي التقليدي لذاكرة التخزين المؤقتة للتعليمات، مما أثر سلبًا على إنتاجيتها.
يستطيع مُفكِّك شفرة معالج Zen ترجمة ما يصل إلى أربع تعليمات CISC x86-64 في كل دورة إلى عمليات دقيقة شبيهة بمعالجات RISC. تُوضع هذه العمليات الدقيقة في قائمة انتظار تُغذَّى من مُخزن العمليات الدقيقة، والذي بدوره يُمكنه إرسال ما يصل إلى ست عمليات دقيقة في كل دورة إلى مُجدوِلات النظام الخلفي. هنا يبدأ التنفيذ خارج الترتيب.
فصلت AMD بوضوح مسارات معالجة الأعداد الصحيحة والأعداد العشرية . ففي جانب معالجة الأعداد الصحيحة، تُغذّى وحدات الحساب والمنطق (ALUs) ووحدات معالجة البيانات (AGUs) ومنطق التحميل/التخزين من قائمة انتظار العمليات الدقيقة. هذا المنطق قادر على تنفيذ عمليتي تحميل بحجم 16 بايت وعملية تخزين واحدة بحجم 16 بايت في كل دورة من ذاكرة تخزين مؤقتة من المستوى الأول (L1D) بسعة 32 كيلوبايت و8 مسارات، مع سياسة الكتابة المؤجلة.
تُغذي وحدات FMAC وAVX جانبَي الفاصلة العائمة والمتجهة . وبفضل منفذي الضرب ومنفذي الجمع، يستطيع معالج Zen تنفيذ عمليتين FMA بحجم 128 بت أو عملية AVX واحدة بحجم 256 بت في كل دورة ساعة. يُعد هذا التوازي على مستوى التعليمات أحدَ أهمّ أسباب أدائه المتميز في ظلّ أحمال العمل الحسابية المكثفة.
التسلسل الهرمي لذاكرة التخزين المؤقت، وذاكرة الترجمة السريعة، وتنظيم الذاكرة في Zen
تُنظَّم بنية الذاكرة في معمارية Zen على ثلاثة مستويات تخزين مؤقت: مستوى L1 منفصل للتعليمات والبيانات، ومستوى L2 خاص لكل نواة، ومستوى L3 مشترك . ورغم أنها ترث البنية الأساسية للمعماريات الدقيقة السابقة، فقد تم تحسين الأحجام والترابط والسياسات.
توفر ذاكرة التخزين المؤقت للتعليمات (L1I ) سعة 64 كيلوبايت لكل نواة، مع 4 مسارات ترابطية، مما يضاعف عدد المسارات لكل وحدة مقارنةً بمعالج Bulldozer ويقلل من التعارضات. كما زادت سعة ذاكرة التخزين المؤقت للبيانات ( L1D ) إلى 32 كيلوبايت، مع 8 مسارات وسياسة كتابة مؤجلة، مقارنةً بـ 16 كيلوبايت و4 مسارات وسياسة الكتابة المباشرة في معالج Bulldozer، مما يحسن بشكل ملحوظ كلاً من معدل الوصول وكفاءة الكتابة.
تم تصميم ذاكرة التخزين المؤقت من المستوى الثاني (L2) بسعة 512 كيلوبايت لكل نواة و8 مسارات، بدلاً من 2 ميجابايت و16 مسارًا مشتركًا لكل وحدة في الجيل السابق. أما ذاكرة التخزين المؤقت من المستوى الثالث (L3) ، فتُقدم عدة ميجابايت لكل نواة مع ترابط 16 مسارًا، وتعمل كآخر مستوى مشترك قبل الوصول إلى ذاكرة الوصول العشوائي الديناميكية (DRAM).
في الوقت نفسه، يفصل نظام Zen مخازن الترجمة المؤقتة (TLBs) إلى مخازن ترجمة مؤقتة للتعليمات (ITLBs) ومخازن ترجمة مؤقتة للبيانات (DTLBs) ، ولكل منها عدة مستويات ومئات المدخلات، مع حماية التكافؤ. هذا يقلل بشكل كبير من زمن استجابة ترجمة العناوين من الافتراضية إلى الفيزيائية، وهو أمر بالغ الأهمية مع ازدياد أحجام الذاكرة.
عندما نتحدث عن ذاكرة تخزين مؤقتة ثنائية أو رباعية أو ثمانية الاتجاهات ، فإننا نصف قدرتها على الربط، والتي ترتبط ارتباطًا وثيقًا بمفهوم التداخل في الذاكرة. زيادة القدرة على الربط تعني وجود طرق مختلفة لتخزين كتلة من البيانات في تلك الذاكرة المؤقتة، مما يقلل من التعارضات، ولكن على حساب منطق أكثر تعقيدًا قليلاً وزيادة طفيفة في زمن الاستجابة.
من المهم أيضًا فهم الفرق بين الكتابة المباشرة والكتابة المؤجلة . في الكتابة المباشرة، تُحدِّث كل عملية كتابة كلاً من الذاكرة المؤقتة والذاكرة الرئيسية في آنٍ واحد، مما يُبسِّط عملية الاتساق ولكنه يزيد من حجم البيانات المنقولة. أما في الكتابة المؤجلة، فتُكتب البيانات في الذاكرة المؤقتة فقط، ويُعلَّم السطر ببت التغيير؛ ولا تُحدَّث ذاكرة الوصول العشوائي الديناميكية (DRAM) إلا عند إخراج ذلك السطر، مما يوفر عرض النطاق الترددي ويُحسِّن الأداء على حساب منطق أكثر تعقيدًا بعض الشيء.
زين وزين+: قفزة نوعية في مؤشر أسعار المستهلك والكفاءة
يمثل Zen قفزة كبيرة في IPC لشركة AMD مقارنة بـ Bulldozer ، وذلك بفضل الجمع بين واجهة أمامية أفضل، ومتنبئ فرعي أفضل، ووحدات تنفيذ أكثر، وSMT بدلاً من CMT (حيث تتعامل كل نواة كاملة مع خيطين، بدلاً من مشاركة جزء من وحدة الفاصلة العائمة بين نواتين منطقيتين) وهيكل ذاكرة تخزين مؤقت أكثر منطقية.
إضافةً إلى التصميم، استفادت AMD من عمليات تصنيع أكثر تطوراً باستخدام تقنية FinFET وعُقد أصغر ، مما يسمح بزيادة كثافة الترانزستورات، وتقليل استهلاك الطاقة مع الحفاظ على نفس الأداء، ورفع الترددات مع الحفاظ على قيم TDP معقولة ( منحنى الجهد-التردد ). وكان هذا التوازن بين الأداء لكل واط حاسماً لاستعادة القدرة التنافسية في أجهزة الكمبيوتر المحمولة والخوادم.
كما أدى الانتقال من Bulldozer إلى Zen إلى ظهور قوائم انتظار أطول للتقاعد، وجدولة تعليمات أكبر، وعرض نطاق ترددي داخلي أكبر، وتوقع التفرع بتقنيات تعتمد حتى على الشبكات العصبية البسيطة، وSMT قادر على ضغط وحدات التنفيذ المتاحة بشكل أفضل.
في هذا السياق، يبرز معمارية Zen+ ، التي يمكن اعتبارها بمثابة "تحديث" في استراتيجية Tick-Tock القديمة لشركة إنتل: نفس التصميم الأساسي لمعمارية Zen، ولكن بتصنيع أكثر دقة، مع تحسينات في التردد، وتقليل طفيف في زمن الاستجابة، وتعديلات داخلية في التوقيت. إنها ليست ثورة معمارية، بل تحسين يُترجم إلى بضع نقاط أداء إضافية.
Zen 2: رقاقات صغيرة، ودعم كامل لتقنية AVX2، وتحسينات عميقة
مع معمارية Zen 2 ، لم تعد AMD تكتفي بتحسين عملية التصنيع، بل تُدخل تغييرات جوهرية على البنية الدقيقة وتُطلق استراتيجية الرقاقات الصغيرة على نطاق واسع . فبدلاً من رقاقة واحدة كبيرة متجانسة، تُقسّم التصميم إلى عدة رقاقات حسابية أصغر حجماً بتقنية 7 نانومتر (CCDs) ورقاقة إدخال/إخراج منفصلة بتقنية 12 نانومتر تتولى إدارة الذاكرة و PCIe والوصلات البينية.
يُحسّن هذا النهج القائم على الرقاقات الصغيرة إنتاجية كل رقاقة (إذ يُسهّل تصنيع رقاقات صغيرة خالية من العيوب)، ويُقلّل التكاليف، ويُسهّل زيادة عدد النوى: ببساطة أضف المزيد من وحدات CCD للوصول إلى 16 أو 32 نواة أو أكثر في معالجات EPYC وThreadripper. لكنّ المقابل هو تعقيد أكبر قليلاً في الاتصال الداخلي، اعتمادًا على تقنية Infinity Fabric للربط البيني، والتي تُواصل AMD تطويرها جيلًا بعد جيل.
من حيث الأداء الخام، تتحدث AMD عن حوالي +15% IPC لـ Zen 2 مقارنة بـ Zen+ عند نفس التردد وتحسين الأداء الإجمالي لكل واط يمكن أن يصل إلى حوالي +75% مقارنة بأول Zen عند دمج تحسينات التصميم والمعالجة.
في وحدة المعالجة الخلفية المتجهة، يُكمل Zen 2 الحلقة المفقودة: فهو يوفر دعمًا كاملاً لبروتوكول AVX2 ذي 256 بت في عملية دقيقة واحدة ، دون تقسيم التعليمات إلى عمليتين 128 بت كما كان الحال في Zen/Zen+. هذا يعني أن وحدات تنفيذ المتجهات أصبحت الآن 256 بت حقيقية، ويمكنها معالجة أحمال عمل AVX2 بكامل سرعتها مع انخفاض ملحوظ في التردد مقارنةً بالتصاميم الأخرى.
كما يجري تعزيز ذاكرة التخزين المؤقت للعمليات الدقيقة، حيث تزداد سعتها إلى 4 كيلوبايت (ضعف حجمها)، مستفيدةً من المساحة التي تم توفيرها بتقليص حجم ذاكرة التخزين المؤقت L1I إلى النصف، مع مضاعفة قدرتها على الربط من 4 إلى 8 طرق. وقد خلصت المحاكاة الداخلية لشركة AMD إلى أنه بالنسبة لمعظم أحمال العمل الواقعية، فإن ذاكرة تخزين مؤقت أكبر للعمليات الدقيقة أفضل من ذاكرة تخزين مؤقت أكبر من L1I.
تمت مضاعفة سعة ذاكرة التخزين المؤقت من المستوى الثالث لكل وحدة معالجة مركزية ، مما يساهم في تقليل حالات الفشل في المستوى الأخير، على الرغم من زيادة زمن الوصول من حوالي 35 إلى 40 دورة. وللتخفيف من هذا التأثير، حسّن معالج Zen 2 عرض نطاق التحميل والتخزين، وطوّر سياسة الجلب المسبق.
جانب آخر مهم هو مُتنبئ التفرعات. يستخدم معالج Zen 2 مُتنبئ TAGE (الهندسة المُوسومة) بأكثر من 7 مدخل، قادر على الاستفادة من سجلات البيانات ذات الأطوال المتغيرة والمدخلات المُوسومة. هذا يقلل من التداخل بين التفرعات المختلفة، ووفقًا لشركة AMD، يُقلل عدد التنبؤات الخاطئة بنحو 30% مقارنةً بالنظام السابق، مما يُترجم مباشرةً إلى عدد أقل من عمليات تنظيف خط الأنابيب وزيادة في عدد التعليمات المنفذة في الدورة الواحدة.
الواجهة الخلفية لـ Zen 2: وحدات معالجة البيانات، والمخازن المؤقتة، وزمن الاستجابة المعدل
في كامل النظام الخلفي، يواصل معالج Zen 2 إرسال ما يصل إلى ست عمليات دقيقة لكل دورة من مخزن إعادة الترتيب، الذي تم توسيعه إلى حوالي 224 مدخلاً (مقارنةً بـ 192 مدخلاً في معالج Zen). وتنقسم وحدات الجدولة إلى أربعة طوابير لوحدات الحساب والمنطق (ALUs) تحتوي كل منها على 16 مدخلاً، وطابور واحد لوحدات الحساب والوحدات الجيوفيزيائية (AGUs) يحتوي على 28 مدخلاً.
يزداد عدد وحدات توليد العناوين (AGUs) من اثنتين إلى ثلاث، مع العلم أنها ليست متطابقة تمامًا: اثنتان منها قادرتان على معالجة عمليات التحميل والكتابة، بينما تتخصص الثالثة في عمليات التخزين. صُمم هذا التوزيع ليتناسب مع أنماط البرامج النموذجية، حيث تكون عمليات التحميل عادةً أكثر تكرارًا وأهمية من عمليات التخزين.
في مستوى الفاصلة العائمة، يمكن للمعالج الخلفي استقبال أربع عمليات دقيقة لكل دورة لوحدات FMA المتجهة ذات 256 بت، مدعومة بملف سجلات فيزيائية مكون من 160 مدخلاً. وقد تم تحسين مسارات التحميل/التخزين ذات 256 بت لتغذية هذه الوحدات بمعدل ثابت في ظل أحمال العمل المتجهة الثقيلة.
يعمل Zen 2 أيضًا على تعديل زمن استجابة بعض العمليات : على سبيل المثال، يقلل ضرب الأعداد العشرية زمن استجابته من 4 إلى 3 دورات، مما يُحسّن أداء حلقات الحساب العددي الضيقة جدًا. وبشكل عام، هناك مجموعة من التحسينات الصغيرة موزعة على كامل مسار المعالجة، تُسهم مجتمعةً في زيادة عدد العمليات لكل دورة (IPC) الملحوظة في الاختبارات المعيارية والتطبيقات العملية.
فيما يتعلق بالتسلسل الهرمي الداخلي لمجموعات النوى، تستخدم AMD مفهوم CCX (مجموعة النوى) : وهي عبارة عن كتلة من 4 نوى تشترك في نفس ذاكرة التخزين المؤقت L3 (16 ميجابايت في Zen 2). هذا الحجم الإضافي يعني زمن استجابة أعلى قليلاً، ولكنه في المقابل يقلل من معدل الفشل، خاصة في التطبيقات ذات مجموعات العمل الكبيرة.
للمقارنة، يمكننا استذكار أرقام زمن الاستجابة الداخلية التقريبية: حوالي 4 دورات للذاكرة L1 ، وحوالي 12 دورة للذاكرة L2، وحوالي 40 دورة للذاكرة L3. يكمن السر في الاحتفاظ بأكبر قدر ممكن من البيانات في الذاكرتين L1 وL2 وتقليل حركة البيانات إلى الذاكرة L3 وذاكرة الوصول العشوائي الديناميكية (DRAM) ، وهو أمر تعمل عليه البنية الدقيقة والمترجمات معًا.
نسيج إنفينيتي: المادة اللاصقة المستخدمة في الرقائق وتأثيرها على الأداء
أحد المكونات التي لا ترتبط دائمًا بالبنية الدقيقة، ولكنها حيوية في Zen 2 وما بعدها، هو Infinity Fabric . تعمل هذه الناقلة الخاصة كـ "طريق سريع" للاتصالات بين CCXs وCCDs وشريحة الإدخال/الإخراج والذاكرة، وبشكل عام، بين جميع وحدات النظام على شريحة واحدة (SoC).
إن تقنية Infinity Fabric هي تطور لتقنية HyperTransport ، وهي ناقل بيانات عالي السرعة ابتكرته AMD منذ سنوات، واستخدمته أيضًا جهات خارجية مثل NVIDIA وCisco وSun وأعضاء آخرين في الاتحاد. تستمد Infinity Fabric فلسفة الروابط القابلة للتوسع من نقطة إلى نقطة، ولكنها مُكيّفة لتلبية احتياجات أنظمة SoC الحديثة وربط وحدة المعالجة المركزية بوحدة معالجة الرسومات.
في معمارية Zen 2، تُقدّم AMD تقنية IF2 ، التي تدعم PCIe 4.0 وناقل بيانات داخلي 512 بت بين وحدات CCX، أي ضعف سعة الإصدار الأول. يُترجم هذا إلى عرض نطاق ترددي أكثر فعالية وتحسين في الكفاءة تُقدّره AMD بنحو 27% مقارنةً بتقنية IF1، مما يُساعد على تخفيف تأثير التبديل بين الشرائح على الأداء.
علاوة على ذلك، فإن ساعة Infinity Fabric منفصلة جزئيًا عن ساعة DRAM ، مما يسمح للذاكرة الرئيسية بالتوسع إلى ترددات أعلى في سيناريوهات معينة دون إجبار IF بالضرورة على مواكبة ذلك، مما يوفر مجالًا أكبر للضبط الدقيق للمتحمسين ومصممي الأنظمة.
في معالجات الخوادم مثل EPYC ، التي تحتوي على أربع رقاقات حسابية أو أكثر، فإن Infinity Fabric هو ما يجعل من الممكن توصيل جميع الرقاقات معًا بتكوينات شبه كاملة (دوران 180 درجة، روابط مباشرة، إلخ)، مما يحقق نطاقات تردد من رقاقة إلى رقاقة يمكن أن تتجاوز بسهولة 150 جيجابايت/ثانية ثنائية الاتجاه اعتمادًا على سرعة DDR المستخدمة.
إن الجمع بين بنية دقيقة قوية في كل نواة ، وتصميم قابل للتطوير باستخدام الرقاقات الصغيرة، ووصلات سريعة بما فيه الكفاية، يسمح لشركة AMD بتجميع وحدات المعالجة المركزية التي تحتوي على 32 أو 64 نواة أو أكثر بأداء متميز في أحمال العمل المتوازية للغاية، مع الحفاظ على معدل IPC تنافسي لكل خيط.
في نهاية المطاف، عند مقارنة المعالجات في اختبارات أداء الألعاب، أو معالجة الرسومات ثلاثية الأبعاد، أو عمليات التجميع الضخمة، أو المحاكاة العلمية، فإنّ سرعة المعالج (جيجاهرتز) وعدد النوى لا يمثلان سوى جزء من الصورة. ما يُحدث الفرق الحقيقي هو كيفية تنظيم البنية الدقيقة للمعالج للتنفيذ الداخلي ، وكيفية استغلالها أو إهدارها لكل دورة ساعة، والمفاضلات التي أجراها المصنّع بين زمن الاستجابة، وعرض النطاق الترددي، واستهلاك الطاقة، والتعقيد.

مؤشر
- 1 ISA، والهندسة المعمارية الكلية، والهندسة المعمارية الجزئية: تنظيم المفاهيم
- 2 ما هي البنية الدقيقة لوحدة المعالجة المركزية (CPU) تحديداً؟
- 3 التوافق، ومجموعات تعليمات المعالج، وعائلات البنية الدقيقة
- 4 تراخيص ISA والملكية الفكرية للتصميم
- 5 التعمق أكثر في البنى الدقيقة الحديثة: حالة AMD Zen
- 6 التسلسل الهرمي لذاكرة التخزين المؤقت، وذاكرة الترجمة السريعة، وتنظيم الذاكرة في Zen
- 7 زين وزين+: قفزة نوعية في مؤشر أسعار المستهلك والكفاءة
- 8 Zen 2: رقاقات صغيرة، ودعم كامل لتقنية AVX2، وتحسينات عميقة
- 9 الواجهة الخلفية لـ Zen 2: وحدات معالجة البيانات، والمخازن المؤقتة، وزمن الاستجابة المعدل
- 10 نسيج إنفينيتي: المادة اللاصقة المستخدمة في الرقائق وتأثيرها على الأداء