- نموذج متعدد الوسائط أصلي مع النص والصورة والصوت والفيديو والبث في الوقت الفعلي.
- SOTA في 22/36 معايير صوتية/فيديو ومتعددة اللغات (119/19/10 لغة).
- هندسة Thinker–Talker مع MoE وزمن انتقال منخفض والتحكم الفوري في النظام.
- يوصى بالنشر باستخدام vLLM/Transformers وDocker والأدوات المساعدة الرسمية.
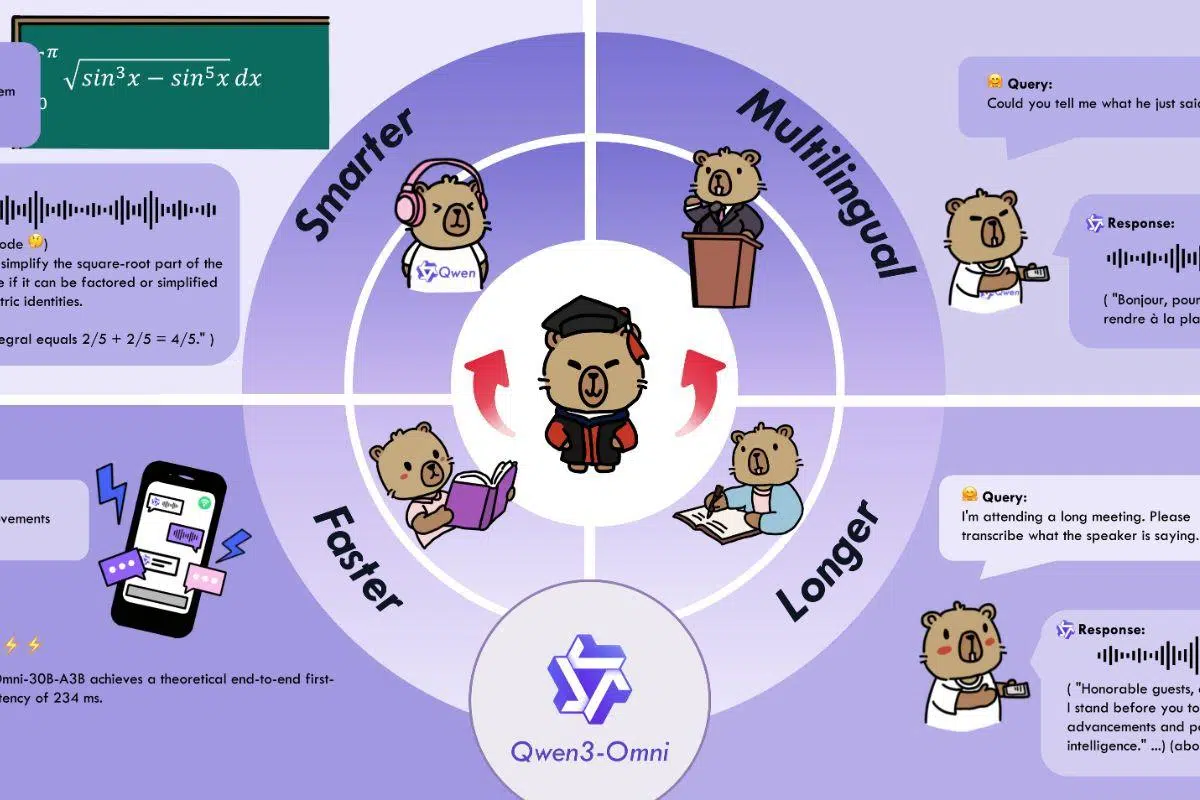
أحدث ظهور Qwen3-Omni نقلة نوعية في مجال الذكاء الاصطناعي: نموذج أصلي واحد قادر على فهم النصوص والصور والصوت والفيديو والاستجابة لها ، مع تقديم ردود فورية كتابية وشفوية. لا نتحدث هنا عن "وصلات" متعددة الوسائط، بل عن بنية مصممة أساسًا لدمج الوسائط بزمن استجابة منخفض وتحكم سلوكي دقيق.
في وقتٍ يُجري فيه الجميع تقريبًا اختباراتٍ على روبوتات الدردشة والمساعدين، يأتي برنامج Qwen3-Omni بطموحٍ كبير: فهو يدعم 119 لغةً نصية، ويتعرف على الكلام في 19 لغةً ويتحدث في 10 لغات ، ويفهم ملفات صوتية طويلة (تصل إلى 30 دقيقة)، ويحقق نتائجَ قياسيةً في عشرات الاختبارات. علاوةً على ذلك، يهدف تصميمه القائم على التفكير والتحدث، ونهجه القائم على مزيج الخبراء، إلى تحقيق سرعة الاستجابة وجودة الاستدلال في سيناريوهات العالم الحقيقي.
ما هو Qwen3-Omni وماذا يقدم؟
Qwen3-Omni هي عائلة من النماذج الأساسية متعددة الوسائط واللغات، مصممة لمعالجة النصوص والصور والصوت والفيديو، مع إخراج نصي وكلام طبيعي. يكمن سر تميزها ليس فقط في تنوع المدخلات والمخرجات، بل أيضاً في خاصية البث المباشر التي تتيح حواراً سلساً واستجابة فورية.
أدخل الفريق العديد من التحسينات المعمارية لرفع الأداء والكفاءة، منها: التدريب المسبق المبكر الذي يركز على النصوص أولاً، بالإضافة إلى التدريب متعدد الوسائط، وتصميم يعتمد على نموذج "مزيج الخبراء" (MoE) الذي يحافظ على الأداء في النصوص والصور مع تعزيز جودة الصوت والفيديو. وبفضل هذه التحسينات، حقق النموذج أعلى مستوى في 22 من أصل 36 معيارًا للصوت والفيديو ، وأعلى مستوى مفتوح المصدر في 32 من أصل 36 معيارًا، بنتائج تُضاهي نتائج Gemini 2.5 Pro في التعرف التلقائي على الكلام، وفهم الصوت، والمحادثات الصوتية.
القدرات والوسائل الرئيسية
يُعدّ Qwen3-Omni جاهزًا للاستخدام في تطبيقات الصوت والصورة والوسائط السمعية البصرية في العالم الحقيقي، مع دعم واسع النطاق للغات متعددة: 119 لغة نصية، و19 لغة إدخال صوتي، و10 لغات إخراج صوتي . تشمل لغات الإدخال الصوتي الإنجليزية والصينية والكورية واليابانية والألمانية والروسية والإيطالية والفرنسية والإسبانية والبرتغالية والماليزية والهولندية والإندونيسية والتركية والفيتنامية والكانتونية والعربية والأردية؛ وتشمل لغات الإخراج الإنجليزية والصينية والفرنسية والألمانية والروسية والإيطالية والإسبانية والبرتغالية واليابانية والكورية، وغيرها.
تُبرز مجموعة كتب الطبخ الرسمية مدى اتساع نطاق استخداماته. في مجال الصوت، يُقدم البرنامج ميزات التعرف التلقائي على الكلام متعدد اللغات والطويل ، وتحويل الكلام إلى نص والعكس، وتحليل الموسيقى (الأسلوب، الإيقاع، الأنواع)، ووصف المؤثرات الصوتية، وإضافة الترجمة المصاحبة لأي ملف صوتي . كما يدعم البرنامج التحليل المختلط للمقاطع الصوتية التي تحتوي على كلام وموسيقى وأصوات محيطة.
في مجال الرؤية الحاسوبية، يوفر النظام تقنية التعرف الضوئي على الأحرف (OCR) المتقدمة للصور المعقدة، واكتشاف وتحديد مواقع الأجسام ، وضمان جودة الصور، وحل المعادلات الرياضية المتعلقة بالصور (حيث يتألق نموذج التفكير)، ووصف الفيديو، والتنقل من منظور الشخص الأول عبر الفيديو، وتحليل انتقالات المشاهد . أما في سيناريوهات الصوت والصورة، فيُظهر النظام ضمان جودة الصوت والفيديو مع مزامنة الوقت، والتفاعل الموجه مع مدخلات الصوت والصورة ، والحوارات مع سلوك المساعد.
كوكيل، يتميز بقدرته على العمل عن طريق الاتصال الصوتي ، مما يفتح مسارات عمل صوتية تقوم بتنشيط الأدوات، وفي المهام المشتقة يوجد برنامج Omni-Captioner للترجمة بتفاصيل كبيرة، مما يدل على قابلية تعميم البرنامج الأساسي.
المفكر والمتحدث في الهندسة المعمارية والتصميم مع وزارة التعليم
من أبرز الفروقات الرئيسية فصلُ المسؤوليات: يقوم المفكر بإنشاء النص (مع تنويعات تتضمن تسلسلًا واضحًا للأفكار)، بينما يُنتج المتحدث الصوت في الوقت الفعلي . يتيح هذا الفصل إجراء محادثة صوتية طبيعية مع الحفاظ على مستوى عالٍ من فهم النص والتخطيط له.
توزع قاعدة بيانات MoE عبء العمل بين الخبراء وتعتمد على التدريب المسبق لتقنية AuT للحصول على تمثيلات عامة قوية. علاوة على ذلك، يقلل استخدام ترميز متعدد الرموز في قناة الصوت من زمن الاستجابة إلى الحد الأدنى، وهو أمر بالغ الأهمية للمكالمات أو المساعدين حيث يُحسب كل جزء من مئة من الثانية.
الأداء والمعايير: النص والرؤية والصوت والوسائط السمعية والبصرية
يحافظ جهاز Qwen3-Omni على أداء متطور في عرض النصوص والصور دون أي تراجع مقارنةً بأجهزة Qwen الأخرى ذات الحجم المماثل والمخصصة لوضع واحد، بينما يتصدر أداء الصوت والصورة في معظم الاختبارات . في مجموعة من 36 معيارًا لأداء الصوت والصورة، حقق الجهاز أداءً متميزًا في 32 منها، وتفوقًا شاملًا في 22 منها، متجاوزًا بذلك جهازي Gemini 2.5 Pro وGPT-4o في عدة جوانب.
من أبرز الإنجازات في مجال معالجة النصوص: في اختبار AIME25، حقق نموذج Flash-Instruct درجة تقارب 65,9؛ وفي اختبار ZebraLogic ، وصل نموذج Instruct إلى 90، وفي اختبار MultiPL-E حقق أداءً تنافسيًا مقارنةً بنموذج GPT-4. وفي مهام المحاذاة مثل IFEval وWritingBench، أظهر نموذجا Instruct وThinking درجات عالية ومستقرة.
في مجال الصوت، تُعدّ نتائج التعرف التلقائي على الكلام (ASR) للغتين الصينية والإنجليزية ممتازة: ففي برنامجي WenetSpeech و LibriSpeech، يُقلّل البرنامج بشكل ملحوظ من معدل أخطاء الكلمات، حيث تصل الأرقام إلى 1,22/2,48 في LibriSpeech clean/other، وفي مجموعات بيانات مثل FLEURS (متعددة اللغات)، يُقدّم معدلات منخفضة للغاية. أما في برنامج VoiceBench، فتُصنّف مقاييس مثل AlpacaEval وCommonEval وWildVoice برنامج Qwen3-Omni على قدم المساواة مع أنظمة المراجع المغلقة، ويتفوّق في تحليل الصوت في MMAU v05.15.25.
في التطبيقات السمعية البصرية، يُعدّ مقياس WorldSense (بقيمة 54,1 تقريبًا ) الأكثر استخدامًا ، متفوقًا على Gemini-2.5-Flash. علاوة على ذلك، في برامج مثل DailyOmni و VideoHolmes، يُحقق إصدار Thinking تحسيناتٍ ملحوظة مقارنةً بأحدث أنظمة المصادر المفتوحة. أما في مجال الرؤية الحاسوبية، فيتفوق هذا الإصدار في MMMU وMathVista وMathVision وفهم المستندات (AI2D وChartQA)، مع تحقيق نتائج ممتازة في العد (CountBench) وفهم الفيديو (Video-MME وMLVU).
تم قياس توليد الصوت بدون تدريب مسبق: بالمقارنة مع عائلات مثل CosyVoice وSeed-TTS، يُظهر Qwen3-Omni اتساقًا أفضل في المحتوى عبر لغات متعددة وتشابهًا عاليًا بين المتحدثين . في قسم اللغات المتعددة، تُظهر جداول "اتساق المحتوى" و"تشابه المتحدثين" أن Qwen3-Omni 30B-A3B يتمتع بقدرة تنافسية عالية في اللغتين الصينية والإنجليزية، وأداءً قويًا في الألمانية والإيطالية والبرتغالية والإسبانية واليابانية والكورية والفرنسية والروسية. في مجال تحويل النص إلى كلام عبر اللغات ، يحقق Qwen3-Omni معدلات خطأ كلمات/اتساقًا أفضل عبر عدة أزواج (مثل: الصينية ← الإنجليزية، اليابانية ← الإنجليزية، الكورية ← الصينية) مقارنةً بـ CosyVoice 2/3.
الموديلات المتوفرة واستخدامات كل منها
تتضمن مجموعة Qwen3-Omni ثلاثة أجزاء رئيسية، كل منها مصمم لاستخدام محدد: التوجيه ، والتفكير ، والتعليق . جميعها تنبع من نفس النواة ولكن مع قدرات مختلفة يتم تفعيلها أو ضبطها بدقة لمهام محددة.
يحتوي برنامج Qwen3-Omni-30B-A3B- Instruct على وظيفتي Thinker و Talker، ويقبل الصوت والفيديو والنصوص، ويعيد النصوص والصوت. إنه الخيار الأمثل إذا كنت ترغب في تفاعل كامل ونتائج صوتية فورية، ويُنصح به لعروض الصوت أو الفيديو التوضيحية .
يركز برنامج Qwen3-Omni-30B-A3B- Thinking على التفكير المنطقي المتسلسل ، ويدعم الصوت والفيديو والنص من خلال مخرجات نصية. وهو مفيد للتحليل المتعمق، وحل المشكلات المعقدة، والرياضيات المرئية، أو سير العمل الذي لا يتطلب مخرجات صوتية ولكنه يتطلب تفكيرًا منظمًا للغاية.
برنامج Qwen3-Omni-30B-A3B- Captioner هو نسخة محسّنة من برنامج ترجمة الصوت عالي الدقة ومنخفض النشاط الزائد . وهو برنامج مفتوح المصدر، ويغطي نطاقًا واسعًا من الصوت بتفاصيل دقيقة، ويسد ثغرة تاريخية في بيئة البرامج مفتوحة المصدر: ترجمة موثوقة وغنية للصوت متعدد الأغراض.
زمن الوصول والتحكم في الوقت الحقيقي والسلوك
تم تحسين النظام للتفاعل الفوري، حيث تبلغ أوقات الاستجابة حوالي 211 مللي ثانية للصوت و507 مللي ثانية للصوت والفيديو . بالإضافة إلى البث المباشر، يُركز النظام على سلاسة الحوار وثبات الصوت، وذلك بفضل الأدوار الواضحة لكل من المفكر (النص) والمتحدث (الصوت).
لتحسين الأداء، يمكنك تخصيص النمط باستخدام موجهات النظام . في سيناريوهات الصوت والفيديو حيث يُستخدم صوت الفيديو كمرجع، يقترح الفريق موجه نظام يحافظ على منطق المفكر مع توفير نص أكثر وضوحًا وسلاسة، مما يُسهّل على المتحدث التحدث بطلاقة . كما يُنصح بالحفاظ على قيمة مُعامل `use_audio_in_video` ثابتة طوال المحادثة متعددة الأدوار.
في التقييم، هناك إرشادات محددة: لا تقم بتعيين مطالبة النظام ، واتبع تنسيق ChatML لكل معيار، وعندما لا تكون هناك مطالبة، استخدم ما يلي بشكل افتراضي: التعرف التلقائي على الكلام باللغة الصينية ("请将这段中文语音转换为纯文本。")، والتعرف التلقائي على الكلام بلغات أخرى ("Transcribe the audio into text.")، و S2TT ("استمع إلى الكلام المقدم <source_language> …")، وكلمات الأغاني (" Transcribe the song lyrics" … بدون علامات ترقيم، مع فصل الأسطر بفواصل").
النشر والمتطلبات والأدوات
للحصول على تجربة محلية متكاملة، يوصي الفريق باستخدام Hugging Face Transformers ومراجعة مراحل هندسة البرمجيات ، ولكن تجدر الإشارة إلى أنه نظرًا لكونها بنية MoE، فقد تعمل ببطء مع استدلال HF؛ وللتطبيقات الإنتاجية أو التطبيقات ذات زمن الاستجابة المنخفض ، ينصحون باستخدام vLLM أو واجهة برمجة تطبيقات DashScope ، بل ويقدمون صورة Docker تتضمن بيئات لكليهما. تم دمج كود Transformers بالفعل، ولكن حزمة PyPI لم تُصدر بعد ويجب تثبيتها من المصدر.
توفر هذه الأدوات المساعدة لمعالجة الصوت والصور/الفيديو (base64، عناوين URL، المدخلات المتداخلة)، وتوصي باستخدام FlashAttention 2 مع Transformers لتقليل استهلاك ذاكرة وحدة معالجة الرسومات عند التحميل باستخدام float16 أو bfloat16 . يتضمن vLLM أيضًا FlashAttn2، ويتم شرح معلمات مثل limit_mm_per_prompt (لتخصيص ذاكرة وحدة معالجة الرسومات مسبقًا) و max_num_seqs للتوازي بالتفصيل ؛ بالإضافة إلى ذلك، فإن زيادة tensor_parallel_size تُمكّن الاستدلال متعدد وحدات معالجة الرسومات.
هناك بعض النصائح المفيدة لتوفير الموارد: إذا لم تكن بحاجة إلى الصوت، يمكنك تعطيل خاصية Talker بعد التهيئة، مما يوفر حوالي 10 جيجابايت من ذاكرة الفيديو. وإذا كنت ترغب في إخراج نص أسرع، فاستخدم `return_audio=False` أثناء الإنشاء. كما تم توفير الحد الأدنى النظري لمتطلبات الذاكرة لـ BF16 مع FlashAttn2: على سبيل المثال، يستخدم Instruct 30B-A3B حوالي 78,9 جيجابايت مع 15 ثانية من الفيديو و144,8 جيجابايت مع 120 ثانية؛ بينما يستخدم Thinking حوالي 68,7 جيجابايت و131,7 جيجابايت على التوالي.
لإعداد عرض توضيحي محلي على الويب ، يُنصح بتجهيز بيئة vLLM (أو بيئة Transformers الأبطأ)، والتأكد من تثبيت ffmpeg ، واستخدام البرامج النصية الخاصة بهم. كما يُوفرون صور Docker جاهزة لوحدات معالجة الرسومات (GPU) باسم "qwenllm/qwen3-omni" مع NVIDIA Container Toolkit ، وتعيين المنافذ (مثلاً، من المضيف 8901 إلى الحاوية 80)، وخيار التشغيل من 0.0.0.0. يمكنك إعادة الدخول إلى الحاوية أو حذفها عند الحاجة.
العروض التوضيحية وواجهات برمجة التطبيقات والنظام البيئي
إذا كنت لا ترغب في التثبيت محليًا، يمكنك تجربة العروض التوضيحية على Hugging Face Spaces وModelScope Studio ، والتي تتضمن تجارب لـ Qwen3-Omni-Realtime وInstruct وThinking وCaptioner. كما يتوفر Qwen Chat مع البث المباشر: ما عليك سوى تحديد خيار مكالمة الصوت/الفيديو في الواجهة.
لتحقيق تكامل قابل للتوسع مع زمن استجابة منخفض، يُنصح باستخدام واجهة برمجة تطبيقات DashScope ، التي توفر أداءً أكثر قابلية للتنبؤ. علاوة على ذلك، يتواصل المجتمع عبر قنوات مثل Discord وWeChat ، وينشر أدلة استخدام تتضمن سجلات تنفيذ حقيقية تُمكّن المستخدمين من إعادة إنتاج النتائج بتغيير المطالبات أو النماذج.
خارطة الطريق والتحسينات المستمرة
يعمل الفريق على تطوير ميزات إضافية مثل التعرف على الكلام متعدد المتحدثين ، وتطبيق تقنية التعرف الضوئي على الأحرف (OCR) على الفيديو، وتحسينات على التعلم السمعي البصري الاستباقي، وتطوير سير عمل أكثر ثراءً للوكلاء . كما أشاروا إلى أن دعم إخراج الصوت في vLLM لنموذج Instruct سيكون متاحًا قريبًا، مما يُكمل دورة النشر في الوقت الفعلي من تلك الواجهة الخلفية.
الأسئلة الشائعة: دعم وقت التشغيل والكمية
أفاد بعض المستخدمين بعدم قدرتهم على تشغيل Qwen3-Omni حتى مع البرامج المعتادة، وأنهم لا يرون الكميات في Hugging Face ؛ علاوة على ذلك، يبلغ حجم الملف الأصلي ذي 16 بت حوالي 70 جيجابايت، وهو حجم كبير بالنسبة لأجهزة الكمبيوتر ذات الإمكانيات المحدودة. يوضح المشروع نفسه أن Transformers قد تم دمجه بالفعل ولكن بدون حزمة PyPI ، والتي يجب تثبيتها من المصدر، وأن vLLM هو الخيار المفضل للاستدلال، على الرغم من أن دعم الصوت Instruct في vLLM سيصدر قريبًا.
فيما يتعلق بالتكميم، لا توجد حتى الآن أي عناصر نائبة مدرجة في HF لـ Qwen3-Omni 30B-A3B، ومن الجدير بالذكر أن خاصية MoE والطبيعة متعددة الوسائط تُعقّد التوافق الفوري مع بيئات التشغيل مثل llama.cpp. بالنسبة لمن يحتاجون إلى الاختبار الآن، فإن التوصية الرسمية هي استخدام Docker + Transformers/vLLM من المصدر أو واجهة برمجة التطبيقات ، ومتابعة المستودع للحصول على طلبات سحب الدعم والتكميمات المستقبلية عند توفرها.
ممارسات التقييم الجيدة والمطالبات
لإعادة إنتاج الأرقام، تُفصّل الإرشادات التالية: تستخدم معظم معايير الأداء فك التشفير الجشع في Instruct بدون أخذ عينات، وبالنسبة لـ Thinking، يجب مراعاة المعلمات الموجودة في ملف generation_config.json . كما يتم ضبط معدل إطارات الفيديو على fps=2 أثناء التقييم، ويُشار إلى أن مطالبة المستخدم يجب أن تتبع البيانات متعددة الوسائط ما لم تُحدد مجموعة البيانات خلاف ذلك.
عندما لا يتضمن معيار الأداء أي توجيهات، يمكن استخدام التوجيهات الافتراضية (التعرف التلقائي على الكلام باللغة الصينية/غيرها، S2TT، كلمات الأغاني). إضافةً إلى ذلك، يجب عدم ضبط توجيهات النظام أثناء التقييم لضمان قابلية مقارنة النتائج بين الأنظمة وعمليات التشغيل المختلفة.
تُقدّم Qwen3-Omni نفسها كمنصة شاملة حقيقية، تتميز بزمن استجابة منخفض، ودعم واسع النطاق للغات متعددة، وإمكانيات صوتية ومرئية متطورة ، ومسار نشر واضح باستخدام Transformers وvLLM وDocker. بالنسبة لمن يبحثون عن نموذج واحد يتعامل مع النصوص والصور بسلاسة دون المساس بالأداء، ويستمع ويتحدث ويفهم الفيديو ، فهي خيار يصعب منافسته اليوم.
مؤشر
- 1 ما هو Qwen3-Omni وماذا يقدم؟
- 2 القدرات والوسائل الرئيسية
- 3 المفكر والمتحدث في الهندسة المعمارية والتصميم مع وزارة التعليم
- 4 الأداء والمعايير: النص والرؤية والصوت والوسائط السمعية والبصرية
- 5 الموديلات المتوفرة واستخدامات كل منها
- 6 زمن الوصول والتحكم في الوقت الحقيقي والسلوك
- 7 النشر والمتطلبات والأدوات
- 8 العروض التوضيحية وواجهات برمجة التطبيقات والنظام البيئي
- 9 خارطة الطريق والتحسينات المستمرة
- 10 الأسئلة الشائعة: دعم وقت التشغيل والكمية
- 11 ممارسات التقييم الجيدة والمطالبات
