- Microsoft Fabric централизира данни, управление, изкуствен интелект и анализи в реално време в OneLake и унифицирани възможности.
- Платформата укрепва управлението, сигурността и разходите чрез Purview, OneLake security, DLP, DSPM и интеграция с Azure Cost Management.
- Инструментите за Data Factory, Dataflow Gen2 и миграция улесняват преместването на съществуващи работни натоварвания и оркестрирането на сложни канали.
- Copilot, агенти за данни, MCP и нови работни натоварвания, като Fabric IQ и Real-Time Intelligence, задвижват усъвършенствани сценарии за изкуствен интелект и автоматизация.
Ако работите с данни в екосистемата на Microsoft от известно време, със сигурност сте забелязали, че Microsoft Fabric се е превърнал в централен център за съвременни анализи , обединявайки всичко, което преди това е било разпръснато в Power BI, Azure Synapse, Data Factory и други услуги, в една единствена платформа. В тази статия ще разгледаме подробно най-новите функции, пътната карта и практическите последици от Fabric за анализи, управление, изкуствен интелект и анализи в реално време.
Идеята е, че след като приключите с четенето, ще имате ясна представа какво предлага Microsoft Fabric днес, накъде се развива и как влияе върху архитектурата на данните на вашата организация: възможности за управление с Purview, автоматизация с API и Git, нови функции на изкуствен интелект, интелигентност в реално време, сигурност в OneLake, миграции, производителност и много други.
Microsoft Fabric и рамката за приемане в облака: управление, разходи и автоматизация
В рамките на Cloud Adoption Framework (CAF), Microsoft публикува серия от ръководства за съгласуване на дизайна на Microsoft Fabric с основните принципи на проектиране на целевите зони . Последната част от тази поредица разглежда три ключови области: управление, оптимизация на капацитета и автоматизация/DevOps.
От страна на управлението, разходите за капацитет на Fabric се показват чрез Azure Cost Management . Това позволява вградена интеграция на потреблението на капацитет F (и други SKU) в табла за управление на разходите, сигнали и анализи на разходите в Azure. Не става въпрос само за виждане на сметката: можете да сравните тази информация с етикети, абонаменти или групи ресурси, за да разберете кой какво харчи и защо.
Техническата архитектура и бизнес моделът на Fabric позволяват на клиентите да контролират фино потреблението на капацитет, за да оптимизират оперативните разходи . На практика това се изразява в няколко лоста:
- Мащабиране на възможностите FУвеличаване или намаляване на капацитета въз основа на предвидими пикове, като например кампании за продажби, счетоводни срокове или големи количества данни.
- Възможности за пауза и възобновяванеАдминистраторите на Fabric могат да поставят на пауза F капацитет, когато не е необходим (например през нощта или през уикендите в некритични среди), за да намалят разходите за изчисления.
- Защита от пренапрежениеДва параметъра на ниво капацитет контролират как се управляват фоновите задачи, за да се предотврати насищането на средата: Праг за отхвърляне на фона и Праг за възстановяване на фона.
- Резервации на капацитетВъзможно е да се резервира капацитет за определени периоди, за да се получат отстъпки, при условие че очакваното потребление е стриктно планирано.
В областта на управлението на данни, Fabric разчита на Microsoft Purview като централен компонент за каталогизиране, произход и класификация . Purview позволява на потребителите да прилагат етикети за чувствителност, да преглеждат произхода на различни източници, трансформации и потребление, да сертифицират активи от данни и да провеждат кампании за качество на данните, като същевременно интегрират елементи на Fabric (Lakehouse, Warehouse, KQL, Power BI и др.).
Компонентът „Автоматизация на платформата и DevOps“ се фокусира основно върху Git интеграцията, процесите на внедряване и REST API . Работните пространства на Fabric могат да бъдат свързани с Git хранилища, което позволява на множество разработчици да си сътрудничат по един и същ проект за инженерство на данни, наука за данни или анализ в реално време, без да се припокриват работата.
Git и Deployment Pipelines позволяват оркестрацията на жизнените цикли на разработка, тестване и производство по контролиран начин : популяризиране на съдържание, проследяване на промени, синхронизиране на артефакти и управление на версии. От март 2025 г. тези pipelines поддържат (в общо или предварително състояние) широк спектър от типове елементи, включително тригери, табла за управление, потоци от данни, pipelines от данни, datamarts, lakehouses, data warehouses, KQL, бележници, номерирани отчети, организационни приложения и други.
Успоредно с това, Fabric предоставя много широк набор от REST API, с които да се автоматизира почти всяка административна или внедряваща задача: създаване на работни пространства и папки, групова миграция на елементи, управление на връзки и шлюзове, извличане на дефиниции, активиране на тръбопроводи или преносими компютри, наред с други неща.
Ключови актуализации в анализите, изкуствения интелект и управлението за Microsoft Fabric
Еволюцията на Fabric е белязана от огромен брой предварителни функции и нови възможности, които засягат почти всяка област на платформата . Те са групирани и обсъдени по-долу по структуриран начин, за да се покаже пълният им обхват.
Функции на изкуствен интелект в хранилището за данни и мултимодални функции
В областта на релационните данни, Fabric Data Warehouse интегрира AI функции директно в T-SQL (предварителен преглед). Това позволява:
- Класифицирайте или категоризирайте текст.
- Анализирайте настроенията.
- Извличане на структурирана информация от свободен текст.
- Превеждайте текст между езици.
- Правилна граматика.
Целта е да се елиминира необходимостта от напускане на SQL контекста, за да се обогатят данните с изкуствен интелект . Тези функции са комбинирани с по-широка мултимодална поддръжка в AI функциите на Fabric, които вече могат да обработват изображения (JPG/JPEG, PNG, GIF, WebP), PDF файлове и често срещани текстови формати, както и входни данни за файлови пътища.
Включени са помощни програми като aifunc.load за добавяне на папки в таблици с опции за подкани и схеми, aifunc.list_file_paths за преминаване през файлови пътища и ai.infer_schema за извеждане на схеми, съвместими с ai.extract . Всичко това ви позволява да трансформирате и обогатявате данни, без да изграждате сложни канали от нулата.
OneLake, Delta, Apache Iceberg и мултиплатформен достъп
На нивото за съхранение, OneLake остава обединеното езеро, където се намира целият Fabric. Едно от основните подобрения е възможността за показване на таблиците на Delta Lake като таблици на Apache Iceberg, без да се преместват или дублират данни, така че съвместимите с Iceberg двигатели да могат директно да четат какво се съдържа в OneLake.
Освен това, OneLake вече поддържа данни от Apache Iceberg, записани директно от Snowflake и консумирани във Fabric чрез достъп без копиране . Тази стратегия засилва оперативната съвместимост: Fabric не е предназначен да бъде силоз, а по-скоро център за данни, който други двигатели могат да използват, без да дублират съхранението.
По същия начин, OneLake поддържа преки пътища към Azure Blob Storage , OneDrive и SharePoint и разширява сигурността с роли за достъп, сигурност на ниво папка, ред и колона, както и модел на сигурност, който трети страни могат да спазват благодарение на разширението на модела на оторизирания двигател.
Особено важна функция е обединяването на каталога OneLake с Azure Databricks, което позволява достъп без копиране от Unity Catalog до таблиците на OneLake . По този начин OneLake остава източникът на истина, но Databricks може да прави заявки към данните директно, синхронизирайки само метаданните.
SQL база данни върху Fabric: производителност, сигурност и виртуализация
SQL базата данни на Fabric получава свои собствени възможности: опции за ALTER DATABASE SET , поддръжка на сравнение и пълнотекстово индексиране в предварителен преглед. По отношение на производителността и цената на базата данни има няколко подобрения:
- Автоматично уплътняване на индекси за намаляване на съхранението, входно-изходните операции и подобряване на времето за заявки, без да се налага планиране на задачи по поддръжка.
- Максимален лимит на виртуални ядра за контрол на използването на изчислителни ресурси (4 или 32 vCore), предназначени да предотвратят прекомерната консумация на споделен капацитет от работно натоварване.
- Персонализирани SQL пулове които дават на администраторите на работното пространство подробен контрол върху разпределението на ресурсите и маршрутизирането на заявките по име на приложение.
Виртуализацията на данни е активирана и в SQL базата данни, което позволява заявки към външни данни, съхранявани в OneLake, с T-SQL, свързване на файлове в общи формати с локални релационни таблици чрез съединения, без да е необходимо физическо импортиране на данните.
По отношение на сигурността, SQL базата данни поддържа Private Link на ниво клиент (предварителен преглед) , което улеснява частното и контролирано насочване на трафика на данни, интегрирайки се с цялостната конфигурация на защитена мрежа на Fabric.
Разузнаване в реално време, Eventhouse, Eventstream и Activator
Модулът за разузнаване в реално време (RTI) се превърна в един от ключовите отличителни белези на Fabric. Eventhouse и Eventstream работят заедно, за да приемат, обработват и задействат събития в реално време от всякакви източници, а Activator оркестрира действията, които се задействат при определени условия.
Сред най-мощните нови функции са:
- Откриване на аномалии без код с автоматичен избор на модел, опростен интерфейс и гъвкави известия.
- Бизнес събития, които улавят ключови бизнес моменти, генерирани от функции за потребителски данни и бележници, и ви позволяват да активирате предупреждения, персонализирана логика, потоци, AI модели или Spark задачи.
- Интеграция на функциите за активиране и потребителски даннитака че функциите, създадени във Fabric, да могат да обработват събития от всякакъв източник, включително вътрешни събития от самата платформа и от OneLake.
- Възможност за обработка на събития със SQL (SQL оператор в Eventstream), което позволява трансформация на потоци в реално време с известен SQL синтаксис.
Добавени са подходящи конектори, като например Cribl (за приемане на лог файлове и телеметрия от множество източници), конектор със Solace PubSub+ и поддръжка на стрийминг през частни мрежи чрез Azure Virtual Network, VPN, ExpressRoute или частни крайни точки.
За схеми за данни и договори, Eventstream въвежда регистър на схеми , който дефинира и валидира схеми на събития за по-стабилни канали, както и поддръжка за регистъра на схеми на Confluent, който да се свързва с Kafka в Confluent Cloud, като същевременно се спазват съществуващите договори.
Възможности за Copilot и изкуствен интелект в цялата платформа
Copilot във Fabric вече е достъпен в световен мащаб, с поддръжка за Power BI, Data Factory, Data Science & Data Engineering и писане на заявки в KQL . Освен това са добавени специфични възможности:
- Copilot за Dataflow Gen2 (Modern Get Data), което помага за приемането и трансформирането на данни с инструкции на естествен език.
- Copilot за хранилище за данни (чат), достъпен от бутон на лентата, за ускоряване на складовите задачи чрез диалогов прозорец.
- Copilot за крайна точка на SQL анализи, който генерира и оптимизира SQL заявки от бизнес описания.
- Копилот на преносими компютри с познания за контекста на работното пространство, езерото, структурата на тетрадките и средата за изпълнение, способен да генерира многостъпков код, да рефакторира, да обобщава сложни тетрадки и да диагностицира грешки с опцията „Поправяне с Copilot“.
- Вградено автоматично довършване (довършване на код) и довършване на код на Notebook Copilot (предварителен преглед), за да се пише Python по-бързо и с по-малко грешки.
Освен това, базата от AI технологии се разширява с предварително изградени интегрирани Foundry Tools (Azure OpenAI, Azure Language, Azure Translator), OpenAI плъгини за Eventhouse (ai_embed_text и ai_chat_completion) и серия от агенти и агенти за данни, които позволяват на други приложения, включително Copilot Studio, да работят с Fabric данни по оркестриран начин.
Агенти за данни на Fabric, MCP и инструменти за разработчици
Fabric въвежда агенти за данни, способни да оркестрират достъпа до данни, и инструменти за агенти с изкуствен интелект, с Python SDK и директна интеграция с Microsoft Copilot Studio. Това улеснява изграждането на разговорни асистенти, които работят с корпоративни данни, управлявани във Fabric.
Успоредно с това, протоколът за контекст на модела (MCP) се превръща в ключов компонент на интеграцията между AI агентите и Fabric услугите. Има специални MCP сървъри за Activator и Eventhouse, както и ориентиран към разработка Fabric MCP, който:
- Това позволява на AI асистентите да генерират код и съдържание за Fabric елементи.
- Интегрира се с инструменти за разработка като VS Code и GitHub Codespaces.
- Той представя инструменти за консултации и действие въз основа на данни в реално време в Eventhouse.
За ежедневната работа на разработчика има няколко елемента, които трябва да се откроят, включително средата за разработка : разширение за MSSQL за VS Code с поддръжка на SQL базата данни на Fabric , драйверът Microsoft ADO.NET и драйверът ODBC за Fabric Data Engineering (връзка към Spark SQL чрез Livy), както и Spark конектор за SQL бази данни, който опростява удостоверения достъп от Spark до SQL бази данни в Azure и Fabric.
Включен е и Fabric CLI , достъпен като интегрирана задача в Azure DevOps, който ви позволява да автоматизирате управлението на работни пространства, елементи и внедрявания, без ръчно да инсталирате външни инструменти.
Фабрика за данни, миграции на данни и оркестрация във Fabric
Слоят за интеграция на данни на Fabric разчита на Data Factory и Dataflow Gen2, които получават функции, за да направят оркестрацията по-интелигентна, по-автоматизирана и с по-лесни миграции от съществуващи платформи.
Dataflow Gen2: производителност, публични API и диагностика
В Dataflow Gen2 откриваме няколко функции в предварителен преглед:
- Разширено редактиране на целеви заявки да коригирате логиката в местоназначението директно от самата среда за създаване.
- Разделени изчислениякоето позволява части от потока от данни да се изпълняват паралелно, намалявайки общото време за оценка.
- Изтегляне на диагностика на ниво изпълнение, със структурирани пакети от лог файлове за анализ на производителността и разрешаване на инциденти.
- Публични API за програмно създаване, актуализиране, изтриване, планиране и наблюдение на потоци от данни.
- Публични параметри с поддръжка на CI/CDкоито позволяват обновяване на потоците от данни чрез предаване на стойности от тръбопроводи или други източници.
- Последни данни за бърз достъп до наскоро използвани елементи в лентата на Power Query и в Modern Get Data.
Всичко това се допълва от възможността за програмно оценяване на Power Query чрез REST , което отваря вратата за изпълнение на M скриптове като част от автоматизирани процеси, интегрирането им със Spark, конвейери или външни инструменти, възползвайки се от конекторите на Power Query.
Фабрика за данни: адаптивна производителност, свързаност и DBT
В по-"класическата" част от интеграцията, Data Factory в Fabric въвежда:
- Адаптивна настройка на производителността за активност по копиране, която интелигентно настройва параметрите на производителност според конфигурацията и контекста на изпълнение.
- Поддръжка за заснемане на промени в данните (CDC) в задача за копиране, за да се репликират непрекъснато само промените (вмъквания, актуализации, изтривания).
- Локални шлюзове с опция за ръчно надграждане управлявано от Fabric портала, API или скриптове.
- скорошна връзка, който добавя свойства за последно използване към връзките, за да улесни одита и управлението на жизнения цикъл.
- работа с роден DBT, което позволява изпълнението на DBT проекти в рамките на Fabric с интегрирана оркестрация, тестване, документация и управление.
- Извикване на активност на SSIS пакета в конвейери, за да се изпълняват SSIS пакети от самата оркестрация във Fabric.
Потребителското изживяване е подобрено и с инструмент за избор на сайт в SharePoint , който елиминира необходимостта от ръчно въвеждане на URL адреси, и с поддръжка на MCP за Data Factory, което позволява на асистентите с изкуствен интелект да създават и внедряват Dataflow Gen2 просто от инструкции на естествен език.
Инструменти за миграция и репликация на данни
Microsoft силно насърчава миграцията към Fabric чрез няколко специфични инструмента:
- Оценка на миграцията на Fabric за фабрика за данни, който анализира подготовката на ADF конвейерите и мигрира поддържаните към работно пространство на Fabric с картографиране на връзки.
- Асистент за миграция за хранилище за данникойто вече може да се свърже директно с изходното хранилище, за да го премести в хранилището на данни Fabric.
- Асистент за миграция на SQL база данни, насочена към мигриране на локални SQL Server натоварвания, с импортиране на схеми чрез DACPAC, откриване на несъвместимости и препоръки.
Що се отнася до репликацията, се предоставя поддръжка за огледално копиране от различни оперативни източници (Azure Database for MySQL, Google BigQuery, SQL Server и др.) към Fabric, с възможност за контрол на това кои таблици се репликират, рестартиране на процесите на огледално копиране чрез REST и, в случай на Databricks, съпоставяне на политиките на Unity Catalog със сигурността на OneLake.
Включен е и конектор за репликация от Lakehouse, използващ Delta Change Data Feed , който предоставя промените от Lakehouse Delta таблиците на съвместими дестинации, без да се налага да се преоткрива колелото с домашно приготвени CDC решения.
Сигурност, разширено управление и наблюдение във Fabric
Едно от най-големите притеснения за всяка аналитична платформа е как да се защитят данните, да се управлява използването им и да се следи потреблението на ресурси . Fabric се развива бързо в тези области.
Сигурност и защита на данните в OneLake
OneLake добавя цялостен модел за сигурност на достъпа до данни с:
- Роли за достъп до данни за lakehouse с конфигурируеми разрешения от интерфейс за сигурност, базиран на папки.
- Поддръжка на сигурност за преки пътища, така че трети страни да могат да спазват определените политики.
- API за сигурност на достъпа до данни на OneLake, който позволява автоматизирано управление на разрешенията.
- Разширяване на модела към външни двигатели (OneLake сигурност за трети страни).
Успоредно с това, защитата е разширена с DLP ограничаване на достъпа до всички структурирани данни в OneLake (SQL, KQL, хранилища) и е въведен DSPM за AI за Fabric Copilots и агенти за данни , който следи взаимодействията с AI за чувствителна информация и рисково поведение, с интеграция с Purview Audit и eDiscovery.
В равнината на идентичността се появяват функции като идентичности, свързани с елементи (напр. Lakehouse и Eventstream) чрез REST API, които елиминират зависимостта от собственика за определени операции, и удостоверяването на преките пътища на OneDrive и SharePoint чрез идентичности на работното пространство или принципала на услугата.
Централизирано управление и каталог на OneLake
Управлението на данни е подобрено с ново централизирано табло в каталога на OneLake , където собствениците на данни могат да видят обобщен изглед на създадените от тях елементи, да получат препоръки за действия по управление и да имат достъп до всички налични инструменти за подобряване на сигурността и съответствието.
Освен това е активиран API за търсене в каталог на OneLake , заедно с инструмент MCP, който позволява откриването на елементи в цялата Fabric среда от код или AI агенти, с едно повикване, като се спазват разрешенията и метаданните за каталога.
Мониторинг на капацитети, потребление и работа
Платът осигурява няколко слоя наблюдаемост:
- Мониторинг на работното пространство, което създава база данни във Fabric, където се консолидират лог файлове и показатели от множество елементи (включително задания за копиране с подробно наблюдение).
- Мониторинг на работното пространство за задача за копиранес показатели като пропускателна способност, обем на данните, кодове за грешки и времена, всички насочени към централизиран анализ.
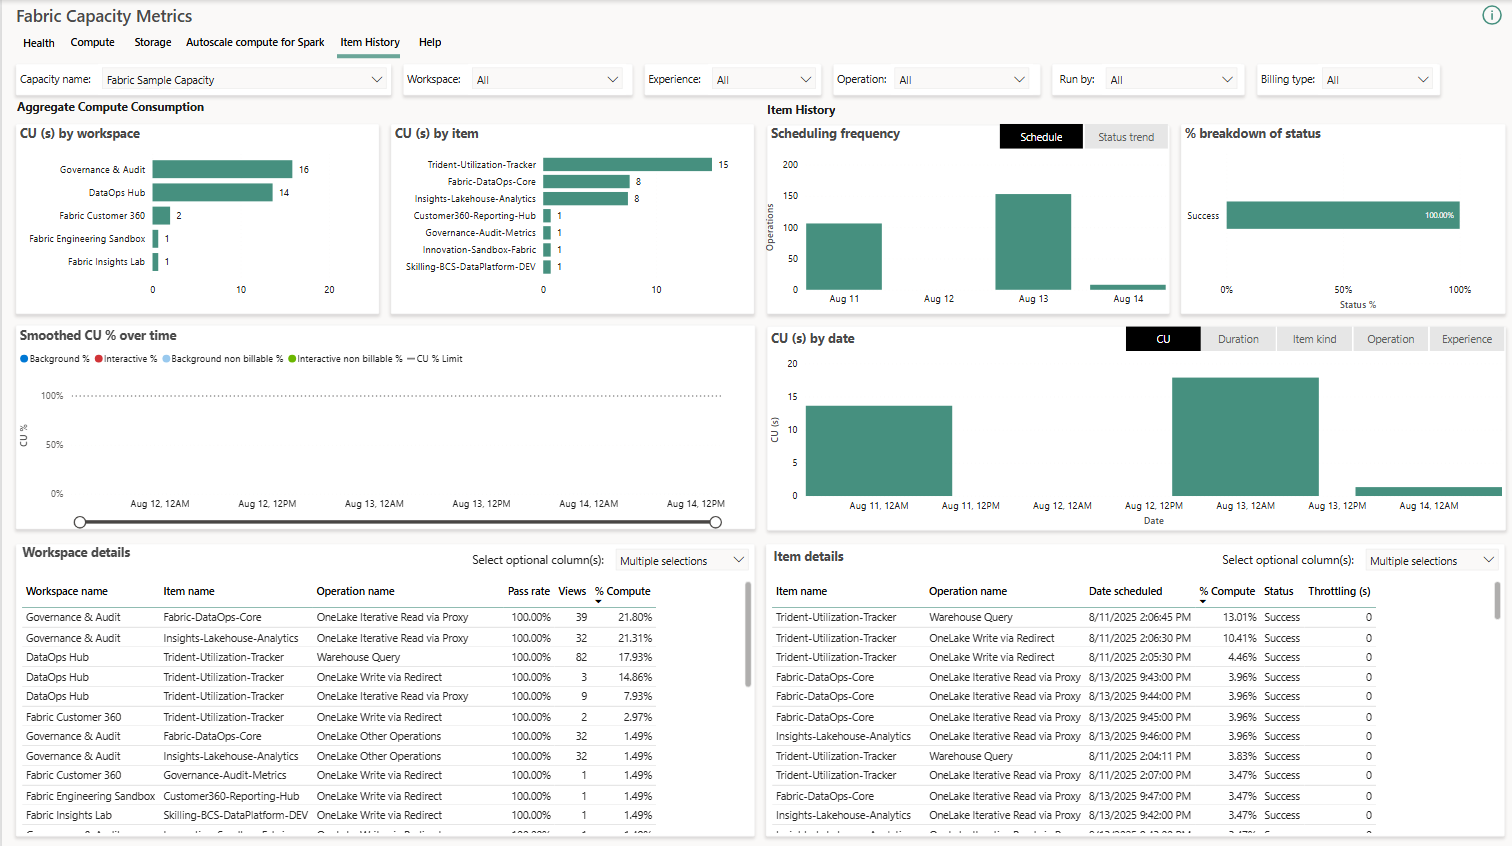
- История на артикулите при прилагане на показатели за капацитет, с 30-дневни изгледи за потреблението на CU за всеки елемент, филтрируеми по работно пространство и тип.
- Защита от пренапрежение на ниво работно пространствокоето позволява задаване на прагове за потребление на работно пространство в 24-часов подвижен прозорец, автоматично блокиране на тези, които ги надвишават, и маркиране на работните пространства като „критично важни“, за да се изключат от ограниченията.
В допълнение към това, се пуска първоначален набор от Fabric Admin API , фокусирани върху откриването на работни пространства, елементи и подробности за потребителския достъп, улеснявайки динамичните инвентаризации и периодичния контрол на достъпа.
Бизнес моделиране, планиране и нови работни натоварвания
Отвъд техническия слой, Microsoft въвежда нови бизнес-ориентирани работни натоварвания върху Fabric. Едно от най-забележителните е Fabric IQ, което има за цел да обедини бизнес семантиката, данните и моделите за интелигентни агенти, които вземат решения въз основа на цялостен поглед върху организацията.
В рамките на Fabric IQ се появяват следните елементи:
- Онтология (предварителен преглед), вид елемент, където обекти, взаимоотношения, свойства и ограничения са дефинирани според бизнес езика на компанията.
- План (предварителен преглед), платформа без код за планиране, отчитане, анализи, интеграция и съвместно управление.
В Real-Time Intelligence се появява и конструкторът на цифрови близнаци , продукт, специализиран в моделирането на цифрови близнаци въз основа на данни в реално време, с цел оптимизиране на физически операции, наблюдение на състояния и симулиране на сценарии.
От друга страна, работното натоварване на Fabric IQ се въвежда като отделно работно натоварване, а инструментите за поддръжка за управление и семантично подравняване продължават да се разширяват, затваряйки кръга между моделите на данни, бизнес логиката и приложенията за изкуствен интелект/аналитика.
Подобрения в производителността, потребителското изживяване и продуктивността
В заключение на прегледа, заслужава да се подчертае серия от междусекторни подобрения, които не винаги попадат в заглавията, но оказват голямо влияние върху ежедневните операции на екипите.
В раздела за Spark и разпределени изчисления, Fabric представя:
- Fabric Runtime 2.0 (предварителен преглед) с Apache Spark 4.0, Delta Lake 4.0, Java 21, Scala 2.13 и Python 3.12 на Azure Linux 3.0.
- Инструмент за сравнение на приложения на Sparkкоето ви позволява да избирате и сравнявате до четири Spark изпълнения едновременно.
- Диагностичен емитер на искри, който събира регистрационни файлове, показатели и събития от приложенията на Spark и ги изпраща до дестинации като центрове за събития, хранилища или Log Analytics.
- Библиотека за диагностика на JobInsight, библиотека за анализ на завършени Spark изпълнения чрез API (заявки, задания, етапи, задачи, изпълнители, регистрационни файлове на събития).
В слоя на хранилището е добавено клъстериране на данни за подобряване на производителността и намаляване на разходите за достъп, колони IDENTITY за сурогатни ключове, както и контрол на версиите и поддръжка на CI/CD чрез SQL Database проекти във VS Code (Warehouse source control).
Потребителското изживяване на Fabric портала също се развива с преглеждане с раздели и инструмент за преглед на обекти , което позволява на потребителите да отварят множество елементи едновременно и да превключват бързо между тях. Това, заедно с подобрения като автоматичното свързване на Lakehouse в Git и набора от помощни програми за поддръжка на Lakehouse (дейности по поддръжка и обновяване на крайните точки на SQL), допринася за по-лесна за ползване и гъвкава платформа.
И накрая, функции като групово импортиране/експортиране на дефиниции на елементи (за миграции, шаблони и архивиране на метаданни), REST за папки, поддръжка на параметри при активиране на елементи от Activator и зареждане на данни от OneLake в Excel с интегриран каталог, допълват екосистема, която започва да покрива почти всички обичайни нужди на един съвременен екип за данни.
С целия този набор от възможности – от централизирано управление, гранулирана сигурност и интелигентна оркестрация, до вграден в SQL изкуствен интелект, анализи в реално време, цифрови близнаци и MCP агенти – Microsoft Fabric се утвърждава като цялостна платформа за данни, където ключът вече не е само съхранението и визуализирането на данни, а управлението, автоматизирането и използването на изкуствен интелект за захранване на всяка част от жизнения цикъл на данните . Това позволява на организациите постепенно да развиват своите архитектури, мигрирайки съществуващите системи и позволявайки нови решения много по-бързо, отколкото при традиционните подходи.