- VibeVoice е модел на Microsoft TTS, способен да генерира дълъг, изразителен звук с множество високоговорители, идеален за подкасти и аудиокниги.
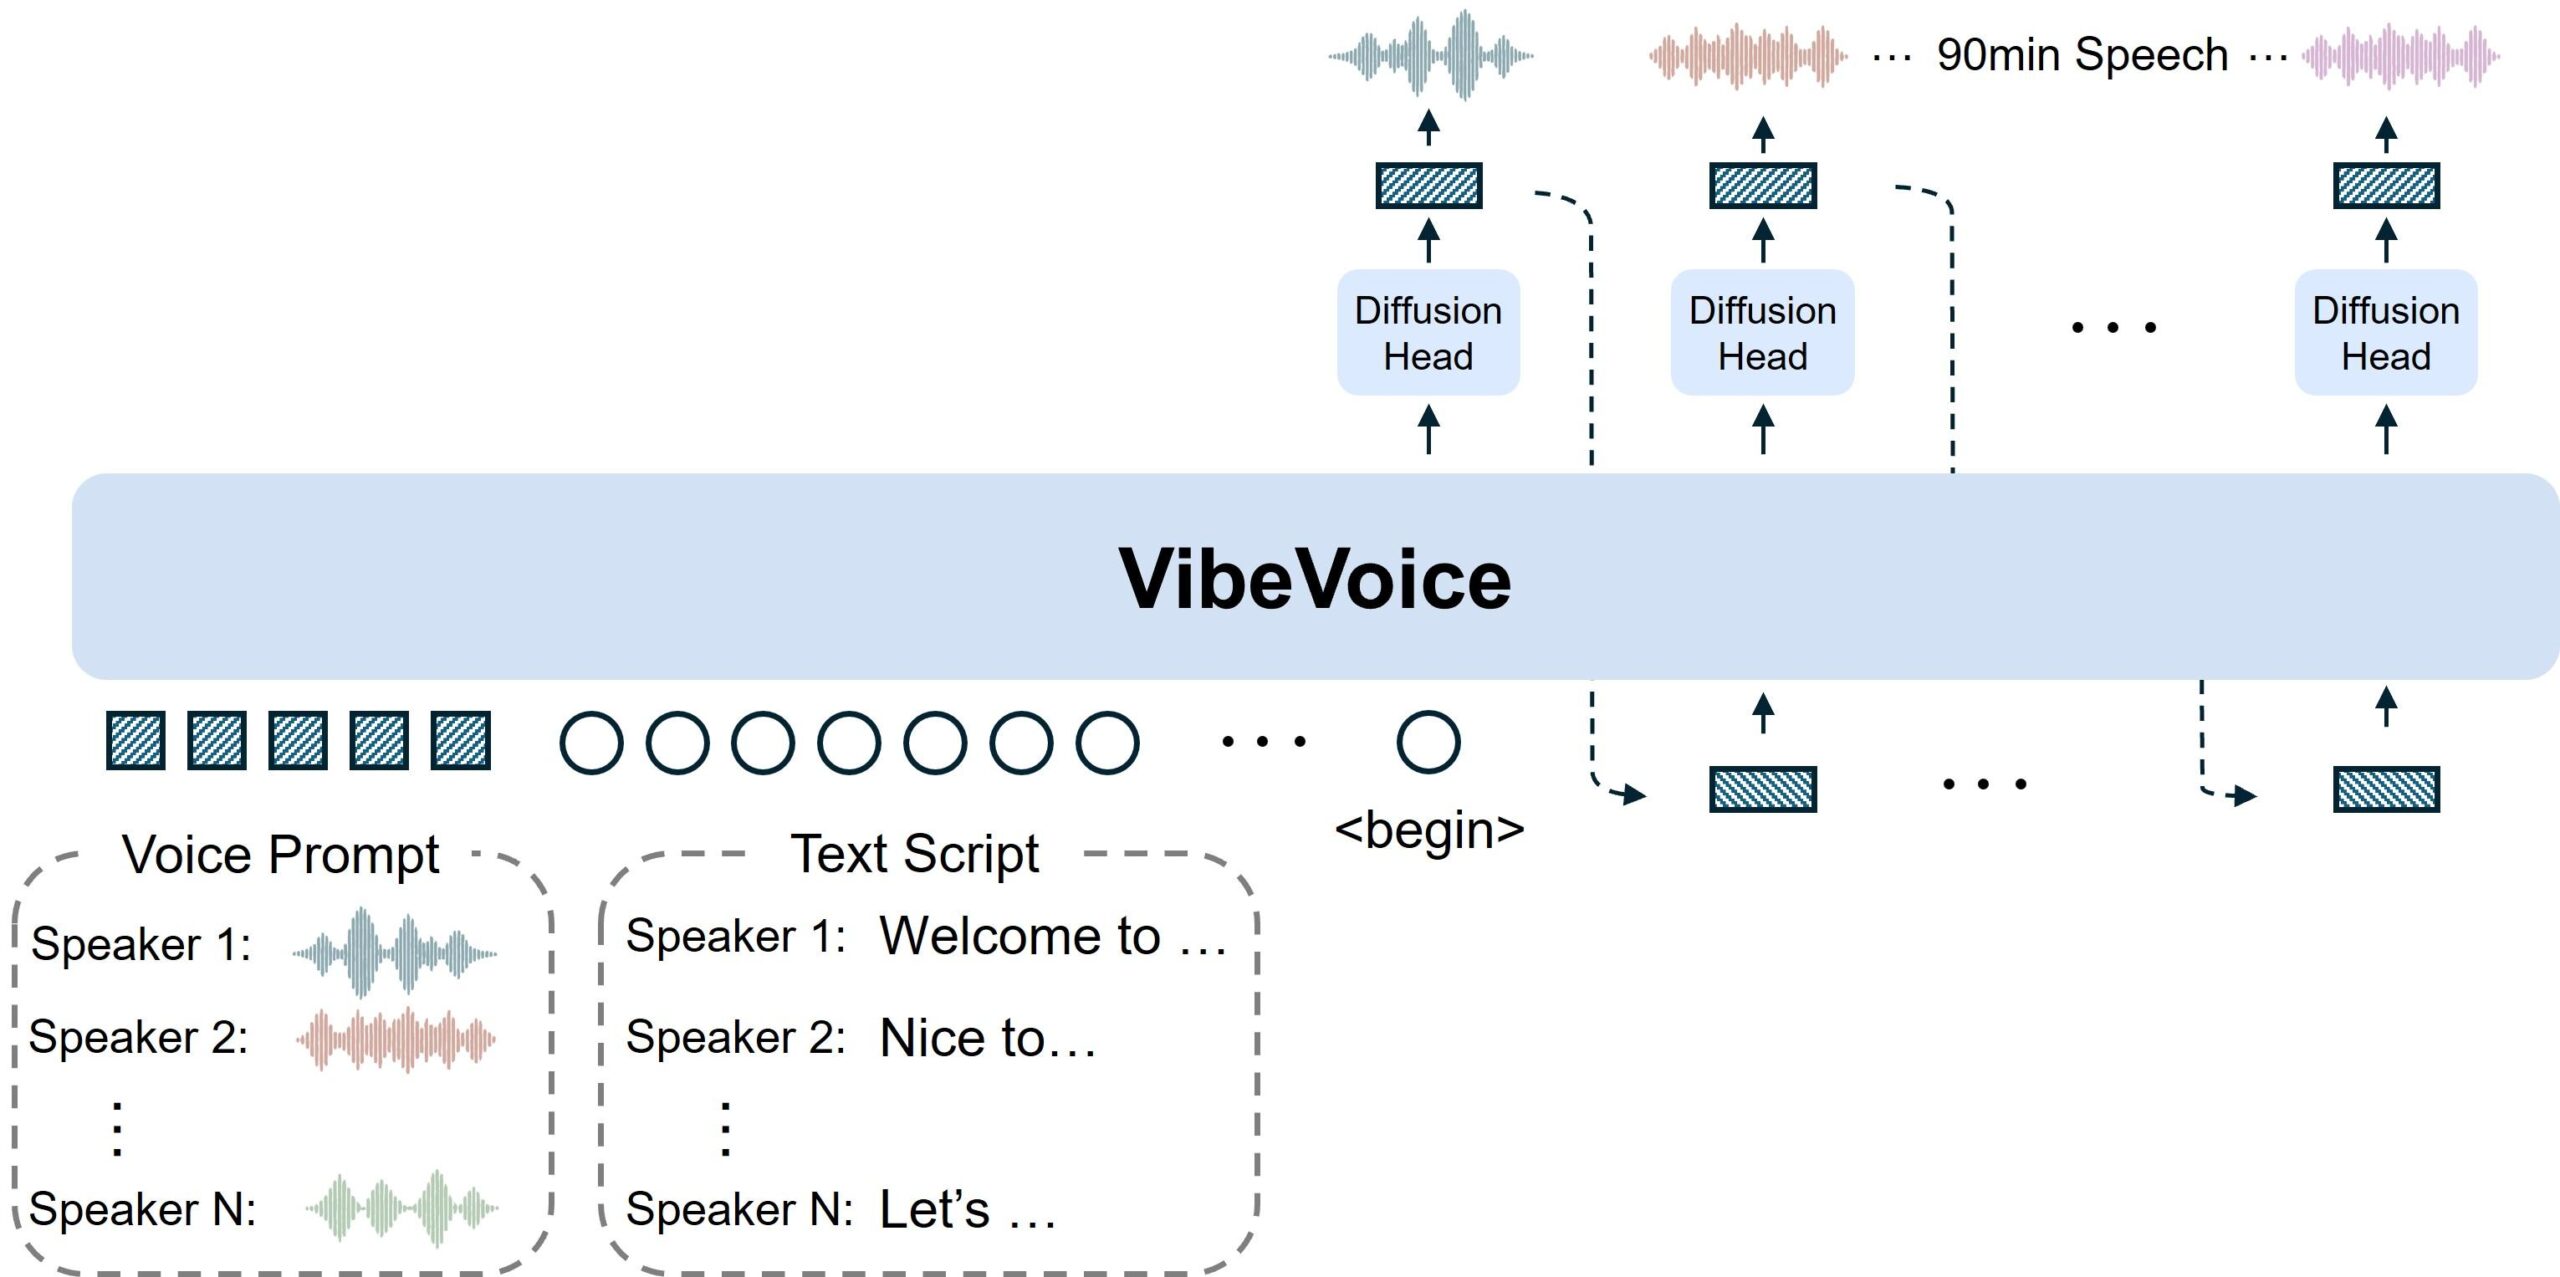
- Неговата архитектура комбинира токенизатори на реч, голям езиков модел и дифузия, за да постигне естествени гласове дори в аудио записи с продължителност до 90 минути.
- Позволява отговори почти в реално време с леки вариации, но изисква отговорна употреба поради рисковете от клониране на глас и дийпфейкове.
- Пуснат е като изследователска рамка с отворен код, въпреки че Microsoft временно е ограничила хранилището поради опасения от злоупотреба.
Появата на VibeVoice на Microsoft революционизира начина, по който се създават подкасти и дългоформатно аудио съдържание с помощта на изкуствен интелект. Този модел с отворен код TTS (текст в реч) не само генерира хиперреалистични гласове, но и позволява воденето на разговори с множество говорители с продължителност до 90 минути без неудобни прекъсвания или спадове в качеството.
Целта на VibeVoice е да предостави на всеки виртуална звукозаписна кабина, способна професионално да продуцира подкасти, аудиокниги или разкази от компютър. Всичко, от което се нуждаете, е скрипт и някои основни технически познания, за да настроите модела, а изкуственият интелект ще се погрижи за останалото: интонация, естественост, промени в гласа и непрекъснатост в целия звук.
Какво е VibeVoice и защо е толкова важен за подкастите?
Моделът е базиран на технологията TTS (Text-to-Speech), което означава, че директно трансформира текста в реч , но с ниво на плавност и нюанс, което много наподобява човешката реч. VibeVoice първоначално беше пуснат във версии с параметри 1.5B и 7B , предназначени да балансират качеството и възможността за генериране на дълги аудио потоци без прекомерна консумация на ресурси.
Една от най-големите му предимства е способността му да записва непрекъснато до 90 минути аудио , поддържайки гласова последователност и интонация през цялото време. Това го прави особено полезен за пълни подкасти, глави от аудиокниги или дълги епизоди с образователно съдържание, където преди това са били необходими множество сесии на запис с човешки гласови актьори.
Освен това, VibeVoice е проектиран да обработва до четири различни гласа в един аудиозапис , което позволява симулирани интервюта, панелни дискусии, диалози между герои или епизоди, разказани от различни актьори. Тази възможност за много високоговорители е ключова за това подкастите, задвижвани от изкуствен интелект, да бъдат по-динамични и ангажиращи.
Как работи VibeVoice: усъвършенстван синтез на реч и ниска латентност
Освен привличащото вниманието заглавие, това, което прави VibeVoice специален, е неговата техническа архитектура, предназначена за дълги аудио записи и разговори . Microsoft комбинира няколко компонента, за да направи гласа да звучи естествено, да се адаптира към текста и да се генерира в реално време или почти в реално време.
Системата използва непрекъснати акустични и семантични речни токенизатори , които работят на много ниска честота, около 7,5 Hz. Това означава, че кондензира аудио информацията на по-малко „стъпки“ в секунда в сравнение с други модели, запазвайки прецизността на звука, като същевременно значително намалява изчислителните разходи при работа с дълги поредици.
В допълнение към това компресирано представяне, в действие влиза голям езиков модел (LLM) , който е отговорен за интерпретирането на съдържанието на скрипта, потока на разговора и кой говори във всеки даден момент. По този начин той разбира дали става въпрос за въпрос, отговор, ироничен коментар или промяна на темата и съответно адаптира гласовия изход.
Накрая се използва дифузионна глава за реконструкция на висококачествени акустични детайли: тембър, вокална текстура, фини дихания и други нюанси. Тази комбинация от LLM + дифузия гарантира, че полученият звук е постоянен, изразителен и приятен за слушане за продължителни периоди.
Успоредно с това, Microsoft пусна специфичен вариант, наречен VibeVoice-Realtime-0.5B , проектиран за изключително бързи отговори: този модел може да започне да излъчва глас около 300 милисекунди след получаване на текста. Тоест, практически в реално време, идеален за гласови агенти, разговорни асистенти или приложения, където латентността трябва да бъде минимална.
Налични версии: модели, параметри и препоръчителни приложения
В рамките на екосистемата VibeVoice са представени няколко версии с различни размери и ориентации на моделите , предназначени както за дълги аудио, така и за интерактивни приложения.
От една страна, имаме основните варианти с параметри 1.5B и 7B , предназначени за обработка на обширно съдържание, като например пълни подкасти, симулирани радиопрограми, глави от аудиокниги или аудио курсове. По-големият брой параметри позволява по-голям капацитет за улавяне на нюанси и управление на сложни диалози, въпреки че също така увеличава хардуерните изисквания.
От друга страна, версията VibeVoice-Realtime-0.5B дава приоритет на скоростта на реакция пред размера на модела. Въпреки че има „само“ 0,5 милиарда параметри , скромно количество в сравнение с гиганти като ChatGPT или Gemini, именно това му позволява да генерира до 90 минути непрекъснат звук, като същевременно поддържа ясен глас и стабилна интонация.
Този вариант в реално време е особено привлекателен за гласови агенти, чатботове, виртуални асистенти и всяко приложение, където потребителят очаква изкуственият интелект да реагира незабавно с глас, а не само с текст. С латентност близо до 300 ms, преживяването е много подобно на разговор с някого от другата страна.
Във всички случаи моделът е предназначен за използване от локални или изследователски среди , тъй като Microsoft първоначално реши да го пусне като проект с отворен код, достъпен от GitHub и платформи като Hugging Face, което улеснява общността да го тества, адаптира и изгражда инструменти върху него.
Практически приложения: как да създадете подкаст с VibeVoice
Едно от водещите приложения на VibeVoice несъмнено е създаването на подкасти без нужда от човешки гласови актьори . За всеки, който има идеи, сценарии или писмено съдържание, но не смее да застане пред микрофон, този модел открива огромна възможност.
Общият работен процес за създаване на подкаст с VibeVoice обикновено включва подготовка на добре структуриран сценарий : въведение, блокове със съдържание, потенциални интервюта (реални или измислени), преходи и заключение. Колкото по-ясен е текстът, толкова по-добре моделът може да улови промените в тона, паузите и ролите на всеки „човек“ в разговора.
След това, използвайки инструменти, изградени върху модела (скриптове, графични интерфейси или интеграции с други приложения), всяка част от текста се присвоява на един от наличните говорители . Можем например да използваме един глас за водещия, друг за повтарящ се гост, друг за въпроси, четени от публиката, и четвърти за информационни бележки или спонсорирани сегменти.
Моделът генерира непрекъснат звук, като същевременно спазва реда на скрипта, гласовите преходи и ритъма на разговора. След това резултатът може да бъде усъвършенстван в традиционен аудио редактор, като се добави фонова музика, звукови ефекти, преходи или се направят малки корекции на силата на звука и еквалайзера.
Благодарение на възможността да генерираме до 90 минути съдържание без загуба на съгласуваност , можем да създадем цял епизод наведнъж: няма нужда да записваме на малки блокове или да се притесняваме за умора на гласа, дикционни грешки или фонов шум, нещо, което във физическа кабина е постоянно главоболие.
Клониране на глас с изкуствен интелект и персонализиране на гласа
Един от най-деликатните, но мощни напредък в тази технология е „клонирането на глас“ или клонирането на глас, задвижвано от изкуствен интелект . То включва техники за синтез, базирани на дълбоко обучение, които позволяват възпроизвеждане на тембъра, речевите модели и нюансите на конкретен глас.
На практика тези системи анализират уникални характеристики на целевия глас, като тембър, форманти, ритъм на речта и прозодични модели (паузи, акценти, въпросителна интонация и др.). Само с няколко секунди семпъл те са в състояние да генерират синтетичен глас, който много наподобява оригинала.
В случая с VibeVoice се споменава, че е възможно да се постигнат много точни симулации само с 10 секунди оригинално аудио , улавяйки доста добре емоционалното въздействие и текстурата на гласа. За един подкаст това отваря възможности като запазване на „бранд гласа“ дори след като реалният човек е спрял да записва, или създаване на повтарящи се герои с постоянна вокална идентичност.
Тази възможност обаче е свързана с много сериозни етични рискове и необходимостта от откриване на синтетичен звук :
Поради тази причина Microsoft подчертава, че VibeVoice се пуска в рамките на изследователска дейност и с ясни предупреждения: не трябва да се използва за кражба на самоличност, измами, манипулации или дезинформационни кампании. Отговорното използване е ключов компонент на цялата тази екосистема.
Предимства за създателите на съдържание и малките проекти
С компютър, способен да управлява модела, и известно време за писане на сценарии, е възможно да се конвертират дълги текстове в професионално аудио за минути. Това се отнася за информативни подкасти, новинарски бюлетини, художествени истории, сериализирани романи или дори разказани технически ръководства.
Това е и чудесна помощ при рециклирането на съществуващо писмено съдържание : статии в блогове, бюлетини, дискусии в социалните медии или доклади могат да бъдат трансформирани в аудио епизоди, които разширяват обхвата на съобщението и предлагат по-удобен начин за тези, които предпочитат да слушат, вместо да четат.
Друго предимство е постоянството на качеството във времето . Докато актьорът, озвучаващ човешки глас, може да променя енергията, интонацията или яснотата си в зависимост от деня, изкуственият интелект поддържа постоянно ниво, което улеснява серийното производство: няколко епизода, записани в един дубъл, ще запазят едно и също гласово присъствие и стил.
В образователната област VibeVoice е идеално решение за аудио курсове, четене с насоки и достъпни материали за хора със зрителни увреждания или за тези, които просто предпочитат да учат, като слушат, докато изпълняват други задачи. Възможността за генериране на устни версии на уроци или дълги документи предлага множество възможности.
Рискове, ограничения и решение на Microsoft относно хранилището
Другата страна на монетата е, че изкуственият интелект, способен да имитира човешки гласове и да генерира реалистична реч, повдига сериозни етични и безопасни проблеми. Рискът от злонамерена употреба е реален и големите технологични компании са все по-наясно с него.
В самия текст за стартиране, Microsoft изрично заявява, че VibeVoice не трябва да се използва за дийпфейкове, кражба на самоличност или незаконни дейности . Също така директно забранява използването му в контексти на дезинформация или измами, именно защото нивото му на реализъм би могло лесно да заблуди нищо неподозиращите слушатели.
Въпреки че гласът, който генерира, е много убедителен, създателите на модела посочват, че той все още не улавя всички тънкости на истински човешки глас : дишанията, емоционалните микровариации, определени естествени паузи и промените в ритъма са все още по-богати при човек, отколкото при изкуствения интелект. Това „несъвършенство“ може да помогне отчасти да се установи, че си имаме работа със синтетичен глас, но границата става все по-размита.
След пускането на проекта като изследователска рамка с отворен код , Microsoft откри случаи, в които моделът е бил използван по начини, които не са в съответствие с първоначалното му намерение и принципите за отговорно използване. В отговор компанията обяви, че е била принудена временно да деактивира хранилището, докато не гарантира, че тези употреби извън обхвата вече не могат да се случват.
В изявлението се подчертава, че отговорното използване на изкуствен интелект е основен принцип за Microsoft и че те предпочитат да поставят на пауза и да преглеждат, вместо да поддържат инструмент, който би могъл да улесни сериозни злоупотреби. Въпреки това документацията, демонстрациите и техническите материали вече са послужили за вдъхновение на общността и за продължаване на развитието на областта на синтеза на реч.
Други приложения освен подкастинга
Въпреки че медийното внимание е фокусирано предимно върху подкастите, VibeVoice открива доста широк спектър от приложения в света на генерираното от изкуствен интелект аудио. Много от тях се вписват и в стратегиите за дигитално съдържание и автоматизация.
Един от най-очевидните примери са аудиокнигите и разказваните истории , където наличието на изразителни гласове, способни да задържат вниманието в продължение на десетки минути, е от решаващо значение. Възможността за работа с множество високоговорители позволява на всеки герой да има свой собствен глас, което значително подобрява слушателското изживяване в сравнение с един-единствен разказвач.
В областта на гласовите агенти и разговорните асистенти, версията на VibeVoice в реално време е идеална. Бот, който отговаря със закъснение от само 300 ms, се усеща много по-естествено от такъв, на когото му отнема няколко секунди, за да говори, което прави взаимодействията с обслужването на клиенти, чатботовете или гласовите интерфейси много по-плавни.
Друга много интересна област е тази на автоматизираното съдържание : обобщения на новини, пазарни актуализации, периодични отчети или дори четене на имейли и известия могат да бъдат генерирани без човешка намеса, поддържайки глас, съответстващ на имиджа на марката.
И накрая, има по-експериментални приложения, като например създаването на измислени диалози, симулирани интервюта или развлекателни програми, създадени изцяло от изкуствен интелект . Тук езикови модели за писане на сценарии се комбинират с VibeVoice за озвучаване, което води до формати, които доскоро изглеждаха като научна фантастика.
Като се има предвид цялостната картина, VibeVoice се откроява като ключов играч в новата вълна от генерирано от изкуствен интелект аудио , способно да комбинира естествени гласове, разговори с множество участници, много дълги аудио клипове и почти мигновени отговори. Използвано отговорно и в рамките на установените етични граници, то може да се превърне в невероятно мощен инструмент за всеки, който иска да стартира или мащабира подкаст, да продуцира аудиокниги или да добави професионални озвучавания към своите дигитални проекти, без винаги да разчита на традиционно звукозаписно студио.
