- টেক্সট, ছবি, অডিও এবং ভিডিও এবং রিয়েল-টাইম স্ট্রিমিং সহ নেটিভ ওমনিমোডাল মডেল।
- SOTA ২২/৩৬ অডিও/ভিডিও বেঞ্চমার্ক এবং বহুভাষিক (১১৯/১০/১১৯ ভাষা)।
- MoE, কম ল্যাটেন্সি এবং সিস্টেম প্রম্পট নিয়ন্ত্রণ সহ থিঙ্কার-টকার আর্কিটেকচার।
- ভিএলএলএম/ট্রান্সফরমার, ডকার এবং অফিসিয়াল ইউটিলিটিগুলির সাথে প্রস্তাবিত স্থাপনা।
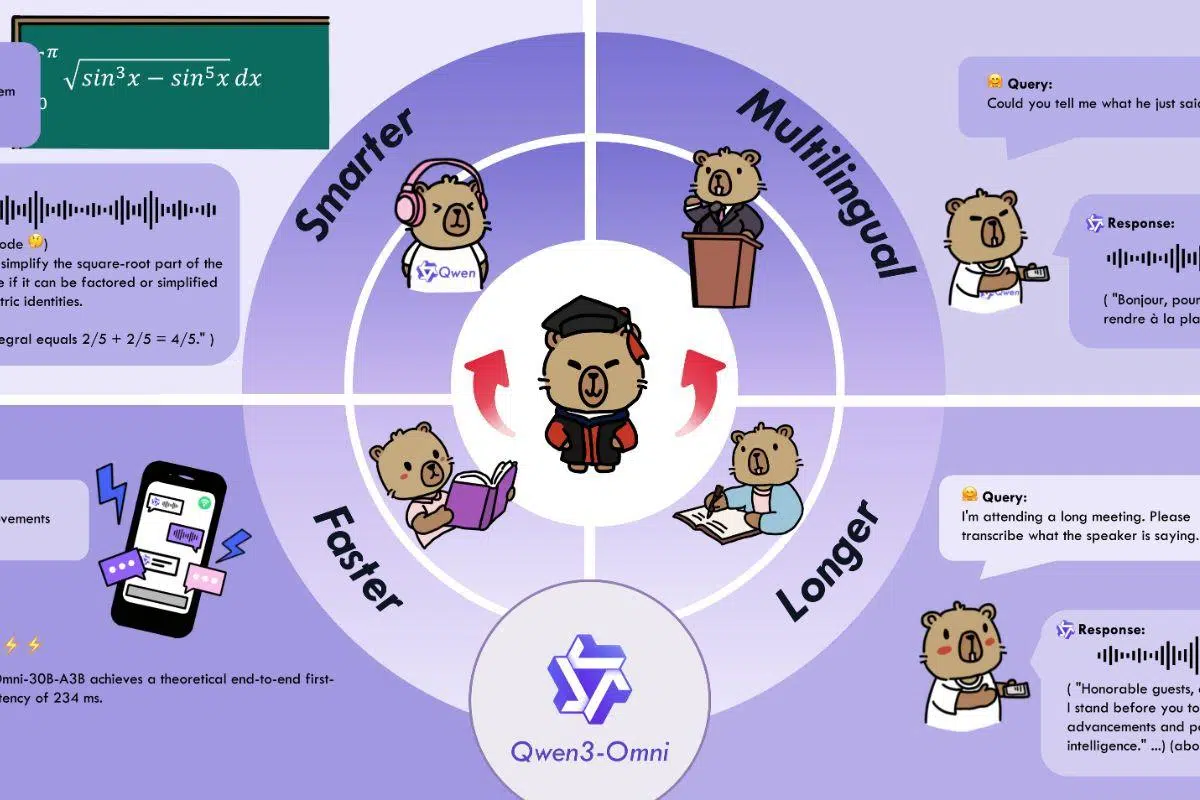
Qwen3-Omni-এর আগমন কৃত্রিম বুদ্ধিমত্তার (AI) জগৎকে আমূল বদলে দিয়েছে: এটি এমন একটি একক নেটিভ মডেল যা টেক্সট, ছবি, অডিও এবং ভিডিও বুঝতে ও সে অনুযায়ী প্রতিক্রিয়া জানাতে সক্ষম , এবং তাৎক্ষণিকভাবে লিখিত ও কথ্য উভয় রূপেই সাড়া দেয়। আমরা এখানে মাল্টিমোডাল "প্যাচ"-এর কথা বলছি না, বরং এমন একটি মৌলিকভাবে পরিকল্পিত আর্কিটেকচারের কথা বলছি যা স্বল্প ল্যাটেন্সি এবং সূক্ষ্ম আচরণগত নিয়ন্ত্রণের মাধ্যমে বিভিন্ন মোডালিটিকে একীভূত করে ।
এমন এক সময়ে যখন প্রায় সবাই চ্যাটবট এবং অ্যাসিস্ট্যান্ট পরীক্ষা করছে, তখন Qwen3-Omni উচ্চাকাঙ্ক্ষা নিয়ে হাজির হয়েছে: এটি টেক্সটের মাধ্যমে ১১৯টি ভাষা সমর্থন করে, ১৯টি ভাষায় কথা শনাক্ত করতে পারে এবং ১০টি ভাষায় কথা বলতে পারে , দীর্ঘ অডিও (৩০ মিনিট পর্যন্ত) বুঝতে পারে এবং কয়েক ডজন পরীক্ষায় বেঞ্চমার্ক স্কোর অর্জন করেছে। এছাড়াও, এর থিঙ্কার-টকার ডিজাইন এবং মিক্সচার অফ এক্সপার্টস পদ্ধতির লক্ষ্য হলো বাস্তব জীবনের পরিস্থিতিতে দ্রুত প্রতিক্রিয়া এবং যুক্তির গুণমান নিশ্চিত করা।
Qwen3-Omni কী এবং এটি কী অফার করে?
Qwen3-Omni হলো মৌলিক, সর্বমাধ্যমীয় এবং এন্ড-টু-এন্ড বহুভাষিক মডেলের একটি পরিবার, যা টেক্সট, ছবি, অডিও এবং ভিডিও প্রক্রিয়াকরণ করার জন্য ডিজাইন করা হয়েছে এবং এর আউটপুট টেক্সট ও স্বাভাবিক কথ্য ভাষা উভয় রূপেই প্রদান করে। এর মূল বৈশিষ্ট্য শুধু এর বিভিন্ন ধরনের ইনপুট ও আউটপুটের মধ্যেই নিহিত নয়, বরং এর স্ট্রিমিং কার্যকারিতা, সাবলীল কথোপকথনের পালাবদল এবং তাৎক্ষণিক প্রতিক্রিয়া জানানোর ক্ষমতার মধ্যেও রয়েছে।
দলটি পারফরম্যান্স এবং দক্ষতার জন্য বেশ কিছু আর্কিটেকচারাল উন্নতি এনেছে: প্রাথমিক “টেক্সট-ফার্স্ট” প্রি-ট্রেনিং-এর সাথে মিশ্র মাল্টিমোডাল ট্রেনিং-এর সমন্বয়, এবং মিক্সচার অফ এক্সপার্টস (MoE) সহ একটি ডিজাইন যা টেক্সট ও ইমেজে এর পারফরম্যান্স বজায় রেখে অডিও এবং ভিডিওর পারফরম্যান্স বৃদ্ধি করে। এই উন্নতিগুলোর ফলে, মডেলটি ৩৬টি অডিও/ভিডিও বেঞ্চমার্কের মধ্যে ২২টিতে SOTA এবং ৩৬টির মধ্যে ৩২টিতে ওপেন-সোর্স SOTA অর্জন করেছে , এবং এর ফলাফল ASR, অডিও বোধগম্যতা, ও স্পিচ কনভারসেশন-এর ক্ষেত্রে Gemini 2.5 Pro-এর সাথে তুলনীয়।
মূল ক্ষমতা এবং পদ্ধতি
Qwen3-Omni বাস্তব জগতের অডিও, ভিশন এবং অডিওভিজ্যুয়াল অ্যাপ্লিকেশনের জন্য প্রস্তুত, সাথে রয়েছে ব্যাপক বহুভাষিক সমর্থন: ১১৯টি টেক্সট ভাষা, ১৯টি ভয়েস ইনপুট ভাষা এবং ১০টি ভয়েস আউটপুট ভাষা । ভয়েস ইনপুট ভাষাগুলোর মধ্যে রয়েছে ইংরেজি, চীনা, কোরিয়ান, জাপানি, জার্মান, রুশ, ইতালীয়, ফরাসি, স্প্যানিশ, পর্তুগিজ, মালয়, ডাচ, ইন্দোনেশিয়ান, তুর্কি, ভিয়েতনামী, ক্যান্টনিজ, আরবি এবং উর্দু; এবং আউটপুট ভাষাগুলোর মধ্যে রয়েছে ইংরেজি, চীনা, ফরাসি, জার্মান, রুশ, ইতালীয়, স্প্যানিশ, পর্তুগিজ, জাপানি এবং কোরিয়ান ইত্যাদি।
অফিসিয়াল কুকবুকগুলোর সংকলন এর ব্যবহারের ব্যাপকতা তুলে ধরে। অডিওর ক্ষেত্রে, এটি বহুভাষিক এবং দীর্ঘ-অডিও স্পিচ রিকগনিশন (ASR) , স্পিচ-টু-টেক্সট ও স্পিচ-টু-স্পিচ অনুবাদ, সঙ্গীত বিশ্লেষণ (শৈলী, ছন্দ, ধরণ), সাউন্ড এফেক্ট বর্ণনা এবং যেকোনো অডিওর ক্যাপশনিং প্রদর্শন করে । এটি স্পিচ, সঙ্গীত এবং পারিপার্শ্বিক শব্দযুক্ত ট্র্যাকের মিশ্র বিশ্লেষণও সমর্থন করে।
ভিজ্যুয়াল ক্ষেত্রে, এটি জটিল ছবির জন্য ‘হার্ড’ ওসিআর, অবজেক্ট ডিটেকশন ও গ্রাউন্ডিং , ইমেজ কিউএ, ছবির গাণিতিক সমাধান (যেখানে থিঙ্কিং মডেলটি বিশেষভাবে কার্যকর), ভিডিও ডেসক্রিপশন, ফার্স্ট-পার্সন ভিডিও-ভিত্তিক নেভিগেশন এবং সিন ট্রানজিশন অ্যানালাইসিস প্রদান করে । অডিওভিজ্যুয়াল ক্ষেত্রে, এটি টাইম অ্যালাইনমেন্ট সহ অডিও-ভিডিও কিউএ, এভি ইনপুটের সাথে গাইডেড ইন্টারঅ্যাকশন এবং অ্যাসিস্ট্যান্ট আচরণের সাথে ডায়ালগ প্রদর্শন করে।
একটি এজেন্ট হিসেবে, এটি অডিও থেকে কল করার ক্ষমতার জন্য বিশেষভাবে উল্লেখযোগ্য , যা এমন ভয়েস ওয়ার্কফ্লো চালু করে যা বিভিন্ন টুল সক্রিয় করে। এর থেকে উদ্ভূত কাজগুলোর মধ্যে অত্যন্ত বিস্তারিতভাবে সাবটাইটেল দেওয়ার জন্য একটি অমনি-ক্যাপশনার রয়েছে , যা মূলটির সাধারণ প্রয়োগযোগ্যতা প্রমাণ করে।
MoE-এর সাথে থিঙ্কার-টকার আর্কিটেকচার এবং ডিজাইন
এর অন্যতম প্রধান পার্থক্য হলো দায়িত্বের বিভাজন: থিঙ্কার টেক্সট তৈরি করে (যার মধ্যে সুস্পষ্ট ধারাবাহিক যুক্তিসহ বিভিন্ন সংস্করণ থাকে), এবং টকার রিয়েল-টাইম অডিও তৈরি করে । এই পৃথকীকরণ স্বাভাবিক কণ্ঠে কথোপকথনের সুযোগ দেয়, এবং একই সাথে সিস্টেমটি টেক্সট বোঝার ও পরিকল্পনার উচ্চ মান বজায় রাখে।
MoE ডেটাবেস বিশেষজ্ঞদের মধ্যে কাজের চাপ বন্টন করে এবং শক্তিশালী সাধারণ উপস্থাপনার জন্য AuT প্রি-ট্রেনিংয়ের ওপর নির্ভর করে। অধিকন্তু, অডিও চ্যানেলে মাল্টি-কোড এনকোডিংয়ের ব্যবহার ল্যাটেন্সি সর্বনিম্ন পর্যায়ে কমিয়ে আনে, যা এমন কল বা অ্যাসিস্ট্যান্টের জন্য অত্যন্ত গুরুত্বপূর্ণ যেখানে সেকেন্ডের প্রতিটি একশ ভাগের এক ভাগও মূল্যবান।
কর্মক্ষমতা এবং মানদণ্ড: পাঠ্য, দৃষ্টি, অডিও এবং অডিওভিজ্যুয়াল
একক মোডের উপর দৃষ্টি নিবদ্ধ করা একই আকারের Qwen মডেলগুলোর তুলনায় Qwen3-Omni তার টেক্সট এবং ইমেজ পারফরম্যান্সে কোনো অবনতি ছাড়াই অত্যাধুনিক মান বজায় রাখে, অন্যদিকে অডিও এবং অডিওভিজ্যুয়াল পারফরম্যান্সে এটি বেশিরভাগ পরীক্ষায় সেরা স্থান অধিকার করে । ৩৬টি অডিও এবং অডিওভিজ্যুয়াল বেঞ্চমার্কের মধ্যে এটি ৩২টিতে ওপেন-সোর্স SOTA এবং ২২টিতে মোট SOTA অর্জন করে, যা Gemini 2.5 Pro এবং GPT-4o-কে বেশ কয়েকটি ক্ষেত্রে ছাড়িয়ে যায় ।
টেক্সট ক্ষেত্রে কিছু উল্লেখযোগ্য মাইলফলক হলো: AIME25- এ Flash-Instruct ভ্যারিয়েন্টটি প্রায় ৬৫.৯ স্কোর করে; ZebraLogic- এ Instruct ৯০-এ পৌঁছায় এবং MultiPL-E- তে এটি GPT-4o-এর সাথে প্রতিযোগিতামূলক স্কোর অর্জন করে। IFEval এবং WritingBench-এর মতো অ্যালাইনমেন্ট টাস্কগুলোতে Instruct এবং Thinking মডেলগুলো উচ্চ ও ধারাবাহিক স্কোর প্রদর্শন করে।
অডিওর ক্ষেত্রে, চীনা এবং ইংরেজির জন্য ASR-এর ফলাফল চমৎকার: WenetSpeech এবং LibriSpeech- এ এটি শব্দ ভুলের হার উল্লেখযোগ্যভাবে কমিয়ে দেয়, LibriSpeech clean/other-এ এর মান ১.২২/২.৪৮-এর কাছাকাছি থাকে এবং FLEURS (বহুভাষিক)-এর মতো সেটে এটি খুব কম হার প্রদান করে। VoiceBench-এ, AlpacaEval, CommonEval, এবং WildVoice-এর মতো মেট্রিকগুলো Qwen3-Omni-কে ক্লোজড রেফারেন্স সিস্টেমের সমপর্যায়ে রাখে এবং MMAU v05.15.25- এ অডিও রিজনিং-এর ক্ষেত্রে এটি উৎকৃষ্ট ।
অডিওভিজ্যুয়াল অ্যাপ্লিকেশনগুলিতে, সবচেয়ে বেশি উদ্ধৃত মেট্রিক হলো ওয়ার্ল্ডসেন্স (প্রায় ৫৪.১ ), যা জেমিনি-২.৫-ফ্ল্যাশকে ছাড়িয়ে গেছে। এছাড়াও, ডেইলিওমনি এবং ভিডিওহোমসের মতো সুইটগুলিতে , থিঙ্কিং ভ্যারিয়েন্টটি পূর্ববর্তী ওপেন-সোর্স SOTA অ্যাপ্লিকেশনগুলির তুলনায় উন্নতি সাধন করেছে। পিওর ভিশনের ক্ষেত্রে, এটি MMMU, MathVista, MathVision এবং ডকুমেন্ট কম্প্রিহেনশনে (AI2D, ChartQA) চমৎকার পারফর্ম করে এবং কাউন্টিং (CountBench) ও ভিডিও কম্প্রিহেনশনে (Video-MME, MLVU) খুব ভালো স্কোর অর্জন করেছে ।
জিরো-শট ভয়েস জেনারেশনও পরিমাপ করা হয়েছিল: CosyVoice এবং Seed-TTS-এর মতো ফ্যামিলিগুলোর তুলনায়, Qwen3-Omni একাধিক ভাষায় উন্নততর কন্টেন্ট কনসিস্টেন্সি এবং উচ্চ স্পিকার সিমিলারিটি প্রদর্শন করে । বহুভাষিক বিভাগে, "কন্টেন্ট কনসিস্টেন্সি" এবং "স্পিকার সিমিলারিটি" টেবিলগুলো দেখায় যে Qwen3-Omni 30B-A3B চীনা এবং ইংরেজিতে অত্যন্ত প্রতিযোগিতামূলক এবং জার্মান, ইতালীয়, পর্তুগিজ, স্প্যানিশ, জাপানি, কোরিয়ান, ফরাসি এবং রাশিয়ান ভাষায় শক্তিশালী। ক্রস-লিঙ্গুয়াল টিটিএস- এ , এটি CosyVoice 2/3-এর তুলনায় বেশ কয়েকটি জোড়ায় (যেমন, zh→en, ja→en, ko→zh) উন্নততর WER/কনসিস্টেন্সি অর্জন করে।
উপলব্ধ মডেল এবং প্রতিটি কী কাজে ব্যবহৃত হয়
Qwen3-Omni লাইনে তিনটি প্রধান অংশ রয়েছে, যার প্রতিটি একটি নির্দিষ্ট ব্যবহারের জন্য ডিজাইন করা হয়েছে: Instruct , Thinking , এবং Captioner । এগুলি সবই একই মূল ভিত্তি থেকে উদ্ভূত, তবে নির্দিষ্ট কাজের জন্য এগুলির ভিন্ন ভিন্ন ক্ষমতা সক্রিয় বা সূক্ষ্মভাবে সমন্বয় করা হয়েছে।
Qwen3-Omni-30B-A3B- Instruct-এ Thinker এবং Talker অন্তর্ভুক্ত রয়েছে, এটি অডিও, ভিডিও এবং টেক্সট গ্রহণ করে এবং টেক্সট ও অডিও ফেরত দেয়। আপনি যদি সম্পূর্ণ ইন্টারঅ্যাকশন এবং রিয়েল-টাইম কথ্য ফলাফল চান, তবে এটিই সঠিক পছন্দ এবং ভয়েস বা ভিডিও ডেমোর জন্য এটি সুপারিশ করা হয়।
Qwen3-Omni-30B-A3B- Thinking পদ্ধতিটি শৃঙ্খল যুক্তিসহ চিন্তাশীল ব্যক্তির উপর আলোকপাত করে এবং টেক্সচুয়াল আউটপুটের মাধ্যমে অডিও, ভিডিও ও টেক্সট সমর্থন করে। এটি গভীর বিশ্লেষণ, জটিল সমস্যার সমাধান, ভিজ্যুয়াল গণিত, অথবা এমন কর্মপ্রবাহের জন্য উপযোগী যেখানে ভয়েস আউটপুটের প্রয়োজন নেই কিন্তু সর্বোত্তম কাঠামোগত চিন্তাভাবনার প্রয়োজন রয়েছে।
Qwen3-Omni-30B-A3B- Captioner হলো উচ্চ-নির্ভুল ও স্বল্প-অতিসক্রিয়তা সম্পন্ন অডিও সাবটাইটলিং- এর একটি পরিমার্জিত সংস্করণ । এটি ওপেন সোর্স, বিস্তৃত পরিসরের অডিও অত্যন্ত বিস্তারিতভাবে কভার করে এবং ওপেন-সোর্স ইকোসিস্টেমের একটি ঐতিহাসিক শূন্যস্থান পূরণ করে: সাধারণ ব্যবহারের অডিওর জন্য নির্ভরযোগ্য ও সমৃদ্ধ ক্যাপশন ।
বিলম্ব, বাস্তব সময় এবং আচরণগত নিয়ন্ত্রণ
সিস্টেমটি তাৎক্ষণিক যোগাযোগের জন্য অপ্টিমাইজ করা হয়েছে, যেখানে অডিওর জন্য রেসপন্স টাইম প্রায় ২১১ মিলিসেকেন্ড এবং অডিও-ভিডিওর জন্য ৫০৭ মিলিসেকেন্ড । স্ট্রিমিংয়ের পাশাপাশি, স্বাভাবিক কথোপকথনের পালাবদল এবং স্থিতিশীল কণ্ঠস্বরের ওপর জোর দেওয়া হয়েছে, যা থিঙ্কার (টেক্সট) এবং টকার (ভয়েস) -এর সুস্পষ্ট ভূমিকার মাধ্যমে সম্ভব হয়েছে ।
সূক্ষ্ম সমন্বয়ের জন্য, আপনি সিস্টেম প্রম্পট ব্যবহার করে স্টাইলটি কাস্টমাইজ করতে পারেন । যেসব অডিও-ভিডিও পরিস্থিতিতে ভিডিওর অডিও রেফারেন্স হিসেবে ব্যবহৃত হয়, সেখানে টিম এমন একটি সিস্টেম প্রম্পট ব্যবহারের পরামর্শ দেয় যা থিঙ্কারের যুক্তিবোধ বজায় রেখে আরও পাঠযোগ্য ও কথোপকথনমূলক টেক্সট প্রদান করে, ফলে টকারের পক্ষে অনর্গল কথা বলা সহজ হয়। এছাড়াও, একাধিক পালাবিশিষ্ট কথোপকথন জুড়ে `use_audio_in_video` প্যারামিটারটি সামঞ্জস্যপূর্ণ রাখার সুপারিশ করা হয় ।
মূল্যায়নের ক্ষেত্রে কিছু নির্দিষ্ট নির্দেশিকা রয়েছে: সিস্টেম প্রম্পট সেট করবেন না , প্রতিটি বেঞ্চমার্কের ChatML ফরম্যাট অনুসরণ করুন এবং, যখন কোনো প্রম্পট থাকবে না, তখন ডিফল্টরূপে নিম্নলিখিতগুলি ব্যবহার করুন: Chinese ASR (“请将这段中文语音转换为纯文本。”), ASR other languages (“অডিওকে টেক্সটে রূপান্তর করুন।”), S2TT (“প্রদত্ত <source_language> স্পিচ শুনুন…”), এবং গানের কথা (“ গানের কথা রূপান্তর করুন ”… বিরামচিহ্ন ছাড়া, লাইনগুলো ব্রেক দিয়ে আলাদা করে”)।
স্থাপনা, প্রয়োজনীয়তা এবং সরঞ্জাম
একটি সম্পূর্ণ স্থানীয় অভিজ্ঞতার জন্য, দলটি হাগিং ফেস ট্রান্সফর্মার্স (Hugging Face Transformers) ব্যবহার করার এবং সফটওয়্যার ইঞ্জিনিয়ারিং পর্যায়গুলো পর্যালোচনা করার পরামর্শ দেয় , তবে মনে রাখবেন: এটি একটি MoE আর্কিটেকচার হওয়ায়, HF ইনফারেন্সের সাথে এটি ধীরগতিতে চলতে পারে; প্রোডাকশন বা লো-ল্যাটেন্সি অ্যাপ্লিকেশনের জন্য , তারা vLLM বা ড্যাশস্কোপ এপিআই (DashScope API) ব্যবহার করার পরামর্শ দেয় এবং এমনকি উভয়ের জন্য এনভায়রনমেন্টসহ একটি ডকার ইমেজও সরবরাহ করে। ট্রান্সফর্মার্স কোডটি ইতিমধ্যে মার্জ করা হয়েছে, কিন্তু PyPI প্যাকেজটি এখনও রিলিজ করা হয়নি এবং এটি সোর্স থেকে ইনস্টল করতে হবে।
তারা অডিও এবং ছবি/ভিডিও (বেস৬৪, ইউআরএল, ইন্টারলিভড ইনপুট) পরিচালনার জন্য ইউটিলিটি সরবরাহ করে এবং ফ্লোট১৬ বা বিফ্লোট১৬ লোড করার সময় জিপিইউ মেমরি কমাতে ট্রান্সফর্মার সহ ফ্ল্যাশঅ্যাটেনশন ২ ব্যবহারের পরামর্শ দেয়। ভিএলএলএম-এর সাথে ফ্ল্যাশঅ্যাটেনশন২ অন্তর্ভুক্ত থাকে এবং প্যারালেলিজমের জন্য limit_mm_per_prompt (যা জিপিইউ মেমরি আগে থেকে বরাদ্দ করে) এবং max_num_seqs-এর মতো প্যারামিটারগুলোর বিস্তারিত বিবরণ দেওয়া থাকে ; এছাড়াও, tensor_parallel_size বাড়ালে মাল্টি-জিপিইউ ইনফারেন্স সক্ষম হয়।
রিসোর্স সাশ্রয়ের জন্য কিছু দরকারি টিপস রয়েছে: যদি আপনার অডিওর প্রয়োজন না হয়, তাহলে ইনিশিয়ালাইজেশনের পর আপনি টকার (Talker) নিষ্ক্রিয় করে দিতে পারেন, এতে প্রায় ১০ জিবি ভিআরএএম (VRAM) সাশ্রয় হবে। আর যদি আপনি দ্রুত টেক্সট আউটপুট চান, তাহলে জেনারেশনের সময় `return_audio=False` ব্যবহার করুন । FlashAttn2 সহ BF16-এর জন্য ন্যূনতম তাত্ত্বিক মেমোরির প্রয়োজনীয়তাও দেওয়া হয়েছে: উদাহরণস্বরূপ, Instruct 30B-A3B ১৫ সেকেন্ডের ভিডিওর জন্য প্রায় ৭৮.৯ জিবি এবং ১২০ সেকেন্ডের জন্য ১৪৪.৮ জিবি ব্যবহার করে; Thinking যথাক্রমে প্রায় ৬৮.৭ জিবি এবং ১৩১.৭ জিবি ব্যবহার করে।
একটি লোকাল ওয়েব ডেমো সেট আপ করার জন্য , তারা আপনার vLLM এনভায়রনমেন্ট (অথবা ধীরগতির Transformers এনভায়রনমেন্ট) প্রস্তুত করা, ffmpeg ইনস্টল করা আছে কিনা তা নিশ্চিত করা এবং তাদের স্ক্রিপ্ট ব্যবহার করার পরামর্শ দেয়। তারা NVIDIA Container Toolkit , পোর্ট ম্যাপিং (যেমন, হোস্ট 8901 → কন্টেইনার 80) এবং 0.0.0.0 থেকে সার্ভ করার বিকল্প সহ GPU-রেডি ডকার ইমেজ “qwenllm/qwen3-omni” অফার করে। প্রয়োজন অনুযায়ী আপনি কন্টেইনারটি পুনরায় প্রবেশ করাতে বা মুছে ফেলতে পারেন।
ডেমো, এপিআই এবং ইকোসিস্টেম
আপনি যদি স্থানীয়ভাবে ডেপ্লয় করতে না চান, তাহলে Hugging Face Spaces এবং ModelScope Studio-তে ডেমো ব্যবহার করে দেখতে পারেন , যেখানে Qwen3-Omni-Realtime, Instruct, Thinking, এবং Captioner-এর অভিজ্ঞতা রয়েছে। রিয়েল-টাইম স্ট্রিমিং সহ Qwen Chat- ও উপলব্ধ আছে: এর জন্য ইন্টারফেসে ভয়েস/ভিডিও কল অপশনটি বেছে নিন ।
কম লেটেন্সিতে স্কেলেবল ইন্টিগ্রেশনের জন্য ড্যাশস্কোপ এপিআই (DashScope API) হলো প্রস্তাবিত পদ্ধতি , যা সবচেয়ে অনুমানযোগ্য পারফরম্যান্স প্রদান করে। এছাড়াও, কমিউনিটি ডিসকর্ড এবং উইচ্যাটের মতো চ্যানেলের মাধ্যমে সমন্বয় করে এবং বাস্তব এক্সিকিউশন লগসহ কুকবুক প্রকাশ করে, যা ব্যবহারকারীদের প্রম্পট বা মডেল পরিবর্তন করে ফলাফল পুনরুৎপাদন করতে সাহায্য করে।
রোডম্যাপ এবং চলমান উন্নতি
দলটি একাধিক বক্তার স্পিচ রিকগনিশন , ভিডিওতে ওসিআর প্রয়োগ, প্রোঅ্যাকটিভ অডিওভিজ্যুয়াল লার্নিং-এর উন্নতি এবং আরও সমৃদ্ধ এজেন্ট ওয়ার্কফ্লো-এর মতো অতিরিক্ত ফিচার নিয়ে কাজ করছে। তারা আরও জানিয়েছে যে, ইন্সট্রাক্ট মডেলের জন্য ভিএলএলএম-এ অডিও আউটপুট সাপোর্ট শীঘ্রই উপলব্ধ হবে, যা ঐ ব্যাকএন্ড থেকে রিয়েল-টাইম ডেপ্লয়মেন্ট চক্রটি সম্পূর্ণ করবে।
প্রায়শই জিজ্ঞাসিত প্রশ্নাবলী: রানটাইম সাপোর্ট এবং কোয়ান্টাইজেশন
কিছু ব্যবহারকারী মন্তব্য করেছেন যে, তাঁরা প্রচলিত টুলগুলো দিয়েও Qwen3-Omni চালাতে পারছেন না এবং Hugging Face-এ কোয়ান্ট দেখতে পাচ্ছেন না ; উপরন্তু, এর নেটিভ ১৬-বিট ফরম্যাটের আকার প্রায় ৭০ জিবি, যা সাধারণ মানের কম্পিউটারের জন্য একটি সমস্যা। প্রজেক্টটি নিজেই স্পষ্ট করেছে যে Transformers ইতোমধ্যেই মার্জ করা হয়েছে, কিন্তু PyPI প্যাকেজটি ছাড়া , যা সোর্স থেকে ইনস্টল করতে হবে, এবং ইনফারেন্সের জন্য vLLM-ই পছন্দের বিকল্প, যদিও অদূর ভবিষ্যতে vLLM-এ Instruct অডিও সাপোর্ট প্রকাশ করা হবে ।
কোয়ান্টাইজেশনের বিষয়ে বলতে গেলে, Qwen3-Omni 30B-A3B-এর জন্য HF-এ এখনও কোনো প্লেসহোল্ডার তালিকাভুক্ত করা হয়নি, এবং এটি মনে রাখা দরকার যে এর MoE (মোড অফ এফেক্ট) ও মাল্টিমোডাল প্রকৃতি llama.cpp-এর মতো রানটাইমগুলোর সাথে তাৎক্ষণিক সামঞ্জস্যকে জটিল করে তোলে। যাদের এখনই পরীক্ষা করার প্রয়োজন, তাদের জন্য আনুষ্ঠানিক পরামর্শ হলো সোর্স বা এপিআই থেকে Docker + Transformers/vLLM ব্যবহার করা, এবং সাপোর্টের জন্য পুল রিকোয়েস্ট ও ভবিষ্যতের কোয়ান্টাইজেশনগুলো উপলব্ধ হলে সেগুলোর জন্য রিপোজিটরির উপর নজর রাখা ।
ভালো মূল্যায়ন অনুশীলন এবং প্রম্পট
সংখ্যাগুলো পুনরুৎপাদন করার জন্য, নিম্নলিখিত নির্দেশিকাগুলো বিস্তারিতভাবে দেওয়া হলো: বেশিরভাগ বেঞ্চমার্কে স্যাম্পলিং ছাড়া Instruct-এ গ্রিডি ডিকোডিং ব্যবহার করা হয়, এবং Thinking-এর জন্য generation_config.json- এর প্যারামিটারগুলো অবশ্যই মেনে চলতে হবে । ইভ্যালুয়েশনের সময় ভিডিও ফ্রেম রেটও fps=2- তে সেট করা থাকে, এবং এটিও নির্দেশ করা হয় যে ডেটাসেটে অন্য কিছু নির্দিষ্ট করা না থাকলে ইউজার প্রম্পটটি মাল্টিমোডাল ডেটা অনুসরণ করবে।
যখন কোনো বেঞ্চমার্কে প্রম্পট অন্তর্ভুক্ত থাকে না, তখন ডিফল্ট প্রম্পটগুলো (চীনা ASR/অন্যান্য, S2TT, গানের কথা) ব্যবহার করা যেতে পারে। এছাড়াও, বিভিন্ন সিস্টেম এবং রানের মধ্যে ফলাফল তুলনীয় রাখা নিশ্চিত করতে, ইভ্যালুয়েশনের সময় সিস্টেম প্রম্পট সেট করা উচিত নয়।
Qwen3-Omni নিজেকে একটি সত্যিকারের অমনিমোডাল প্ল্যাটফর্ম হিসেবে উপস্থাপন করে, যার রয়েছে স্বল্প ল্যাটেন্সি, ব্যাপক বহুভাষিক সমর্থন, অত্যাধুনিক অডিও ও ভিডিও সক্ষমতা এবং Transformers, vLLM ও Docker ব্যবহার করে একটি সুস্পষ্ট ডেপ্লয়মেন্ট পথ। যারা এমন একটি একক মডেল খুঁজছেন যা পারফরম্যান্সের সাথে আপোস না করে নির্বিঘ্নে টেক্সট ও ছবি পরিচালনা করতে পারে এবং একই সাথে ভিডিও শুনতে, বলতে ও বুঝতে পারে , তাদের জন্য এটি আজকের দিনে একটি অপ্রতিদ্বন্দ্বী প্রস্তাব।