- VibeVoice je Microsoftov TTS model sposoban za generiranje dugog, izražajnog zvuka s više zvučnika, idealnog za podcaste i audio knjige.
- Njegova arhitektura kombinuje tokenizatore govora, veliki jezički model i difuziju kako bi se postigli prirodni glasovi čak i u audio snimcima dužine do 90 minuta.
- Omogućava odgovore gotovo u realnom vremenu s malim varijacijama, ali zahtijeva odgovornu upotrebu zbog rizika kloniranja glasa i deepfakeova.
- Objavljen je kao istraživački okvir otvorenog koda, iako je Microsoft privremeno ograničio repozitorij zbog zabrinutosti oko zloupotrebe.

Dolazak Microsoftovog VibeVoice-a revolucionira način na koji se podcasti i dugi audio sadržaji kreiraju pomoću umjetne inteligencije. Ovaj TTS (text-to-speech) model otvorenog koda ne samo da generira hiperrealistične glasove, već omogućava i produkciju razgovora s više govornika i trajanjem koje može doseći i do 90 minuta bez neugodnih prekida ili padova kvalitete.
Cilj VibeVoice-a je da svima pruži virtuelnu kabinu za snimanje sposobnu za profesionalnu produkciju podcasta, audio knjiga ili naracija sa računara. Sve što vam treba je skripta i neko osnovno tehničko znanje za postavljanje modela, a vještačka inteligencija će se pobrinuti za ostalo: intonaciju, prirodnost, promjene glasa i kontinuitet tokom cijelog zvuka.
Šta je VibeVoice i zašto je toliko važan za podcaste?
Model je zasnovan na TTS (Text-to-Speech) tehnologiji, što znači da direktno transformiše tekst u govor , ali sa nivoom tečnosti i nijansi koji blisko podsjeća na ljudski govor. VibeVoice je prvobitno objavljen u verzijama sa parametrima 1.5B i 7B , dizajniranim da uravnoteže kvalitet i mogućnost generisanja dugih audio streamova bez prekomjerne potrošnje resursa.
Jedna od njegovih najvećih prednosti je sposobnost kontinuiranog snimanja do 90 minuta zvuka , održavajući konzistentnost glasa i intonaciju tokom cijelog snimanja. To ga čini posebno korisnim za cijele podcaste, poglavlja audio knjiga ili duge epizode edukativnog sadržaja gdje su ranije bile potrebne višestruke sesije snimanja s ljudskim glasovnim glumcima.
Nadalje, VibeVoice je dizajniran da obradi do četiri različita glasa u jednom audio snimku , omogućavajući simulirane intervjue, panel diskusije, dijaloge između likova ili epizode koje pripovijedaju različiti glasovni glumci. Ova mogućnost više govornika ključna je za dinamičnije i zanimljivije podcaste pokretane umjetnom inteligencijom.
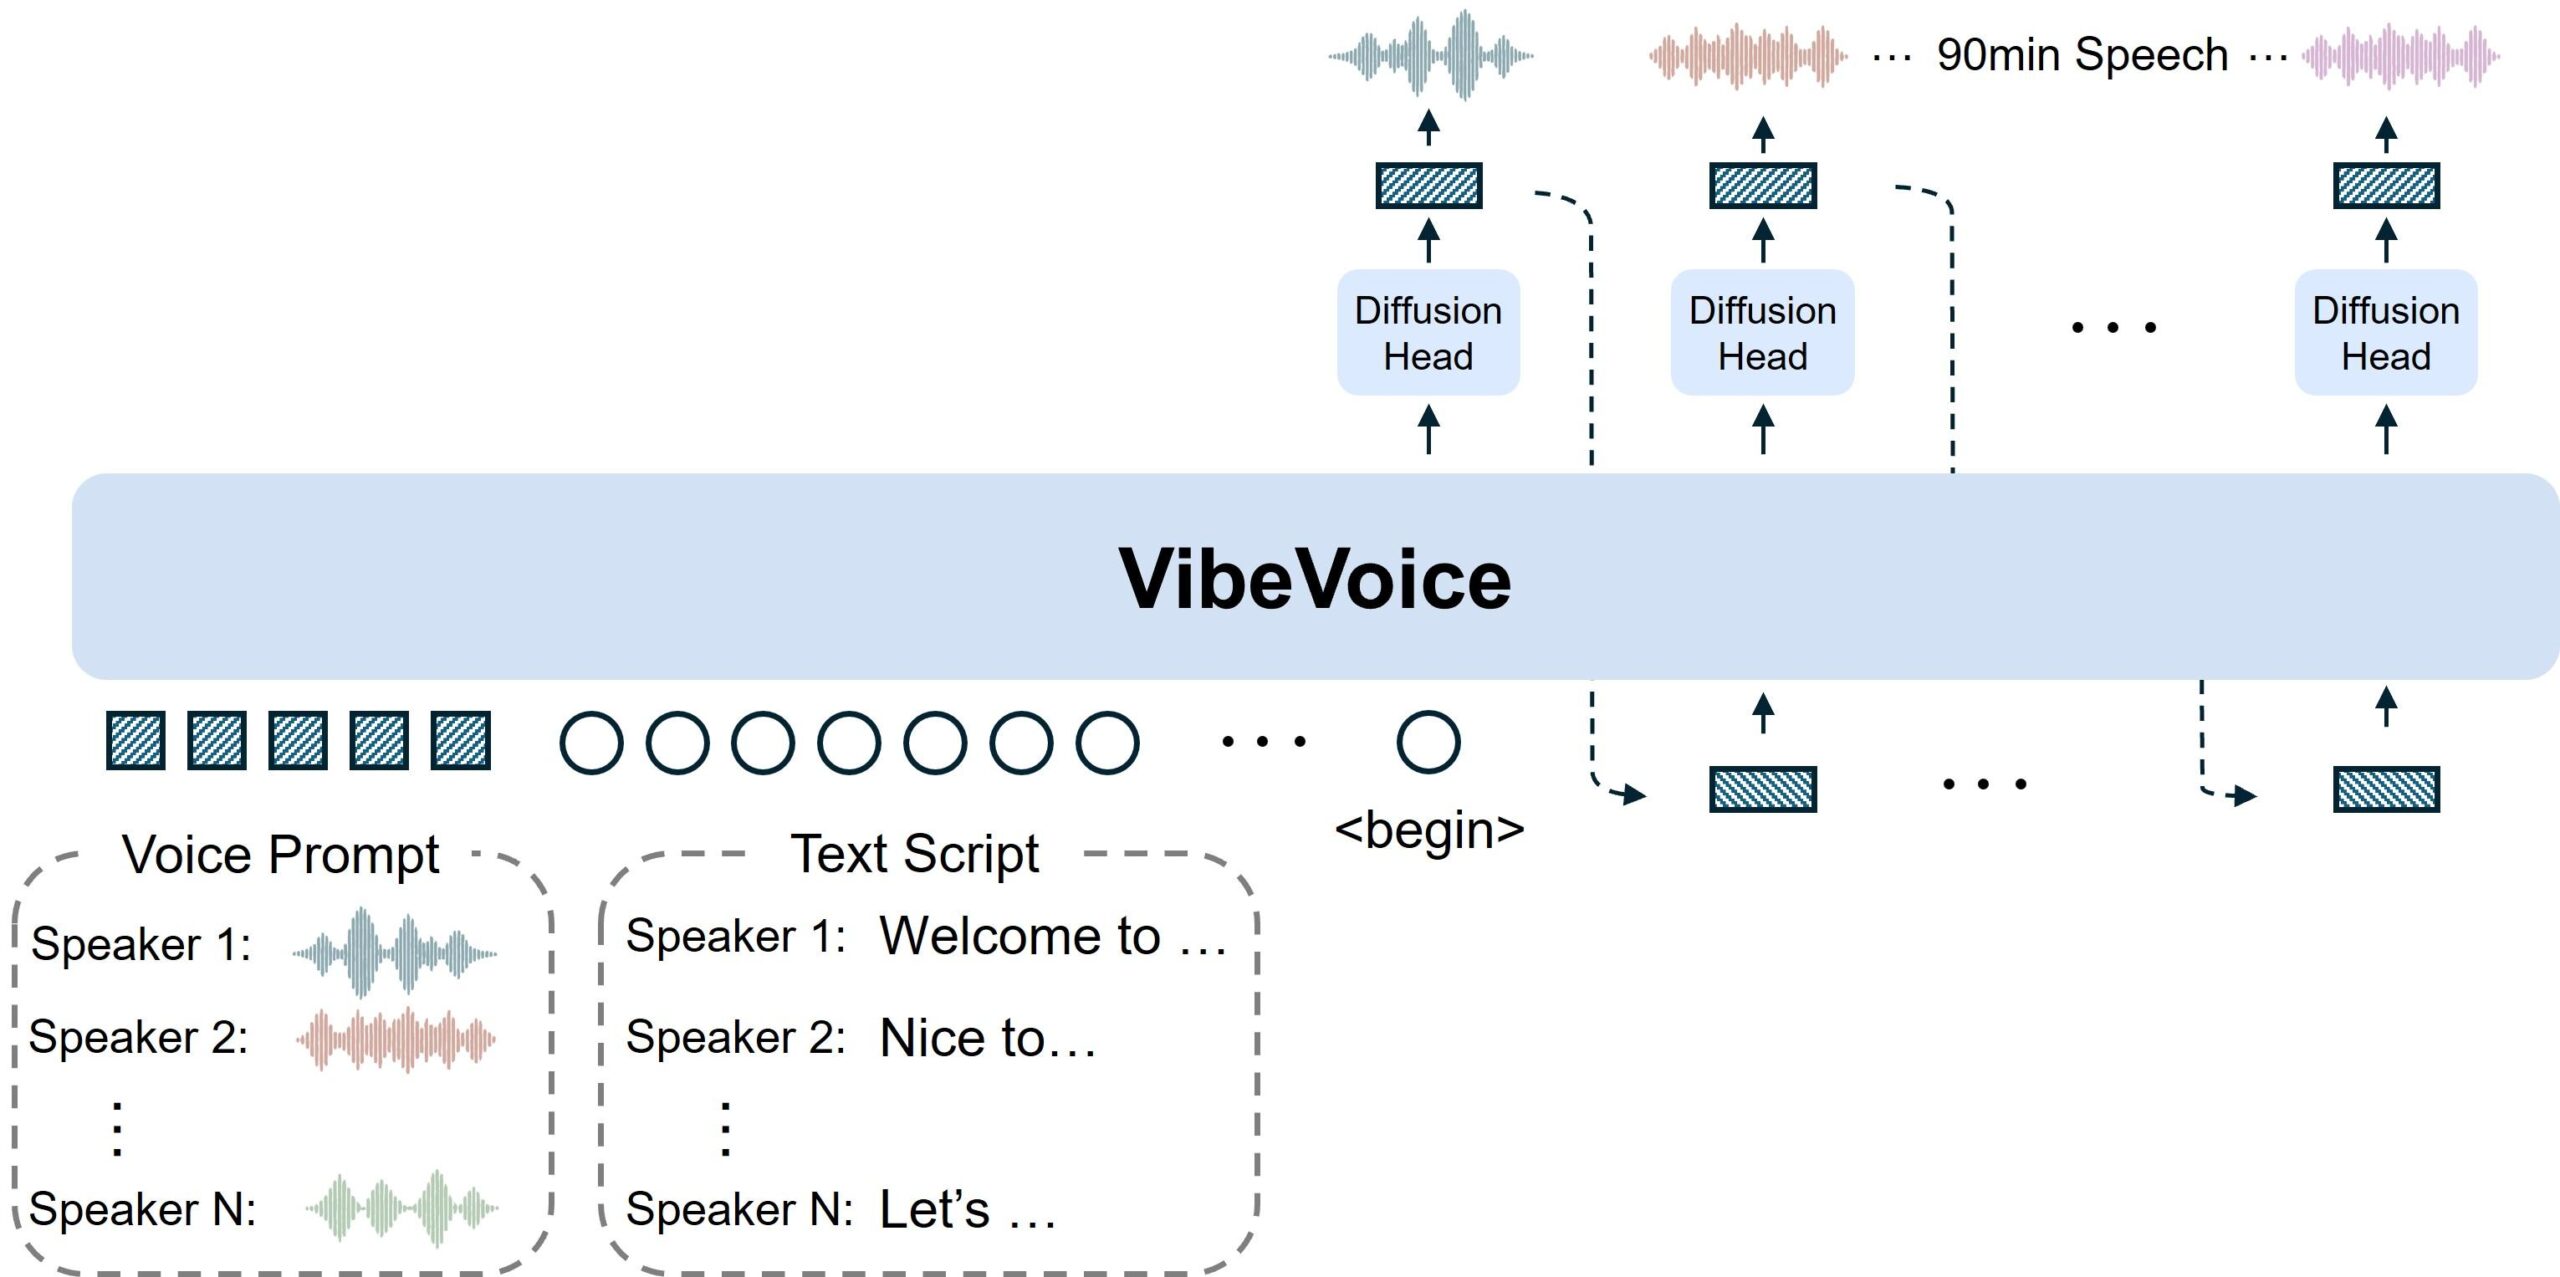
Kako VibeVoice funkcioniše: napredna sinteza govora i niska latencija
Pored privlačnog naslova, ono što VibeVoice čini posebnim je njegova tehnička arhitektura dizajnirana za duge audio snimke i razgovore . Microsoft kombinuje nekoliko komponenti kako bi glas zvučao prirodno, prilagođavao se tekstu i generisao se u realnom vremenu ili gotovo u realnom vremenu.
Sistem koristi kontinuirane akustičke i semantičke tokenizatore govora koji rade na vrlo niskoj frekvenciji, oko 7,5 Hz. To znači da sažima audio informacije u manji broj "koraka" u sekundi u odnosu na druge modele, čuvajući vjernost zvuka i značajno smanjujući računarske troškove pri radu s dugim sekvencama.
Pored ove komprimirane reprezentacije, na scenu stupa veliki jezički model (LLM) , koji je odgovoran za interpretaciju sadržaja skripte, toka razgovora i ko govori u datom trenutku. Na taj način, razumije da li se radi o pitanju, odgovoru, ironičnom komentaru ili promjeni teme i shodno tome prilagođava glasovni izlaz.
Konačno, difuzijska glava se koristi za rekonstrukciju visokokvalitetnih akustičnih detalja: boje glasa, vokalne teksture, suptilnog disanja i drugih nijansi. Ova kombinacija LLM + difuzije osigurava da je rezultirajući zvuk konzistentan, ekspresivan i ugodan za slušanje tokom dužeg perioda.
Paralelno s tim, Microsoft je lansirao specifičnu varijantu pod nazivom VibeVoice-Realtime-0.5B , dizajniranu za izuzetno brze odgovore: ovaj model može početi emitirati glas oko 300 milisekundi nakon prijema teksta. To jest, praktično u realnom vremenu, idealno za glasovne agente, konverzacijske asistente ili aplikacije gdje latencija mora biti minimalna.
Dostupne verzije: modeli, parametri i preporučena upotreba
Unutar VibeVoice ekosistema, predstavljeno je nekoliko verzija s različitim veličinama i orijentacijama modela , dizajniranih i za duge audio i za interaktivne aplikacije.
S jedne strane, imamo glavne varijante s parametrima od 1.5B i 7B , dizajnirane za obradu opsežnog sadržaja kao što su puni podcasti, simulirani radio programi, poglavlja audio knjiga ili audio kursevi. Veći broj parametara omogućava veći kapacitet za hvatanje nijansi i upravljanje složenim dijalozima, iako također povećava hardverske zahtjeve.
S druge strane, verzija VibeVoice-Realtime-0.5B daje prioritet brzini odziva u odnosu na veličinu modela. Iako ima "samo" 0,5 milijardi parametara , što je skromna količina u poređenju sa gigantima poput ChatGPT-a ili Geminija, upravo to mu omogućava generisanje do 90 minuta neprekidnog zvuka uz održavanje jasnog glasa i stabilne intonacije.
Ova varijanta u realnom vremenu je posebno atraktivna za glasovne agente, chatbotove, virtuelne asistente i bilo koju aplikaciju gdje korisnik očekuje da će vještačka inteligencija odmah odgovoriti glasom, a ne samo tekstom. Sa latencijom blizu 300 ms, iskustvo je vrlo slično razgovoru s nekim na drugom kraju.
U svim slučajevima, model je namijenjen za upotrebu iz lokalnih ili istraživačkih okruženja , budući da je Microsoft prvobitno odlučio da ga objavi kao projekat otvorenog koda, dostupan putem GitHub-a i platformi poput Hugging Face-a, što zajednici olakšava testiranje, prilagođavanje i izgradnju alata na njemu.
Praktična primjena: kako kreirati podcast pomoću VibeVoice-a
Jedna od vodećih aplikacija VibeVoice-a je nesumnjivo kreiranje podcasta bez potrebe za ljudskim glasovnim glumcima . Za svakoga ko ima ideje, scenarije ili pisani sadržaj, ali se ne usuđuje stati pred mikrofon, ovaj model otvara ogromnu priliku.
Opći tijek rada za produkciju podcasta pomoću VibeVoice-a obično uključuje pripremu dobro strukturiranog scenarija : uvod, blokove sadržaja, potencijalne intervjue (stvarne ili izmišljene), prijelaze i završetak. Što je tekst jasniji, to model bolje može uhvatiti promjene u tonu, pauzama i ulogama svake "osobe" u razgovoru.
Zatim, korištenjem alata izgrađenih na modelu (skripti, grafičkih interfejsa ili integracija s drugim aplikacijama), svaki dio teksta dodjeljuje se jednom od dostupnih govornika . Možemo, na primjer, koristiti jedan glas za prezentera, drugi za gosta koji se stalno pojavljuje, treći za pitanja koja se čitaju iz publike i četvrti za informativne bilješke ili sponzorirane segmente.
Model generira kontinuirani zvuk poštujući redoslijed skripte, glasovne prijelaze i ritam razgovora. Nakon toga, rezultat se može poboljšati u tradicionalnom audio editoru, dodavanjem pozadinske muzike, zvučnih efekata, prijelaza ili manjim prilagođavanjem jačine zvuka i ekvilizacije.
Zahvaljujući mogućnosti generiranja do 90 minuta sadržaja bez gubitka koherentnosti , možemo kreirati kompletnu epizodu u jednom potezu: nema potrebe za snimanjem u malim blokovima ili brigom o umoru glasa, greškama u dikcije ili pozadinskoj buci, nečemu što u fizičkoj kabini predstavlja stalnu glavobolju.
Kloniranje glasa pomoću umjetne inteligencije i personalizacija glasa
Jedan od najdelikatnijih, ali i najmoćnijih napredaka u ovoj tehnologiji je "kloniranje glasa" ili kloniranje glasa pokretano umjetnom inteligencijom . Ono uključuje tehnike sinteze zasnovane na dubokom učenju koje omogućavaju replikaciju boje glasa, govornih obrazaca i nijansi određenog glasa.
U praksi, ovi sistemi analiziraju jedinstvene karakteristike ciljanog glasa, kao što su boja glasa, formanti, ritam govora i prozodijski obrasci (pauze, akcenti, upitna intonacija itd.). Sa samo nekoliko sekundi uzorka, oni su u stanju generirati sintetički glas koji je vrlo sličan originalu.
U slučaju VibeVoice-a, spominje se da je moguće postići vrlo precizne simulacije sa samo 10 sekundi originalnog zvuka , prilično dobro hvatajući emocionalni uticaj i teksturu glasa. Za podcast, ovo otvara mogućnosti kao što je održavanje "glasa brenda" čak i nakon što stvarna osoba prestane snimati ili kreiranje ponavljajućih likova sa konzistentnim vokalnim identitetom.
Međutim, ova mogućnost dolazi s vrlo ozbiljnim etičkim rizicima i potrebom za detekcijom sintetičkog zvuka :
Iz tog razloga, Microsoft naglašava da se VibeVoice objavljuje u okviru istraživanja i uz jasna upozorenja: ne bi se trebao koristiti za krađu identiteta, prevaru, manipulaciju ili kampanje dezinformacija. Odgovorna upotreba je ključna komponenta cijelog ovog ekosistema.
Prednosti za kreatore sadržaja i male projekte
S računarom koji može pokrenuti model i određenim vremenom za pisanje scenarija, moguće je pretvoriti duge tekstove u profesionalni audio zapis za nekoliko minuta. To se odnosi na informativne podcaste, vijesti, fiktivne priče, serijalizirane romane ili čak narativne tehničke priručnike.
Također je od velike pomoći u recikliranju postojećeg pisanog sadržaja : članci na blogu, bilteni, teme na društvenim mrežama ili izvještaji mogu se transformirati u audio epizode koje proširuju doseg poruke i nude praktičniji način za one koji radije slušaju nego čitaju.
Još jedna prednost je konzistentnost kvalitete tokom vremena . Dok ljudski glasovni glumac može mijenjati svoju energiju, intonaciju ili jasnoću ovisno o danu, vještačka inteligencija održava konstantan nivo, što olakšava serijsku produkciju: nekoliko epizoda snimljenih u jednom pokušaju zadržat će istu prisutnost i stil glasa.
U obrazovnom području, VibeVoice je savršen izbor za audio kurseve, vođena čitanja i pristupačne materijale za osobe s oštećenjem vida ili one koji jednostavno preferiraju učiti slušajući dok obavljaju druge zadatke. Mogućnost generiranja govornih verzija lekcija ili dugih dokumenata nudi mnoštvo mogućnosti.
Rizici, ograničenja i Microsoftova odluka u vezi s repozitorijem
Druga strana medalje je da vještačka inteligencija sposobna da oponaša ljudske glasove i generiše realističan govor izaziva ozbiljne etičke i sigurnosne probleme. Rizik od zlonamjerne upotrebe je stvaran, a velike tehnološke kompanije su sve više svjesne toga.
U samom tekstu o lansiranju, Microsoft eksplicitno navodi da se VibeVoice ne smije koristiti za deepfakeove, krađu identiteta ili ilegalne aktivnosti . Također direktno zabranjuje njegovu upotrebu u kontekstima dezinformacija ili prevare, upravo zato što bi njegov nivo realizma lako mogao prevariti nesuđene slušaoce.
Iako je glas koji generira vrlo uvjerljiv, kreatori modela ističu da on i dalje ne obuhvata sve suptilnosti pravog ljudskog glasa : udisaji, emocionalne mikrovarijacije, određene prirodne pauze i promjene ritma su i dalje bogatije kod osobe nego kod vještačke inteligencije. Ova "nesavršenost" može djelimično pomoći da se otkrije da imamo posla sa sintetičkim glasom, ali granica postaje sve nejasnija.
Nakon objavljivanja projekta kao istraživačkog okvira otvorenog koda , Microsoft je otkrio slučajeve u kojima je model korišten na načine koji nisu bili u skladu s njegovom prvobitnom namjerom i principima odgovorne upotrebe. Kao odgovor, kompanija je objavila da je bila prisiljena privremeno onemogućiti repozitorij dok ne osigura da se ove upotrebe izvan opsega više ne mogu događati.
U izjavi se naglašava da je odgovorna upotreba umjetne inteligencije osnovni princip za Microsoft i da radije pauziraju i preispituju nego održavaju alat koji bi mogao olakšati ozbiljnu zloupotrebu. Uprkos tome, dokumentacija, demonstracije i tehnički materijali već su poslužili za inspiraciju zajednice i nastavak unapređenja oblasti sinteze govora.
Druge primjene osim podkastinga
Iako je medijska pažnja prvenstveno usmjerena na podcaste, VibeVoice otvara prilično širok spektar slučajeva upotrebe u svijetu zvuka generiranog umjetnom inteligencijom. Mnogi od njih se također uklapaju u strategije digitalnog sadržaja i automatizacije.
Jedan od najočitijih primjera su audio knjige i narativne priče , gdje je ključno imati ekspresivne glasove sposobne zadržavati pažnju desetinama minuta. Mogućnost korištenja više govornika omogućava svakom liku da ima svoj vlastiti glas, što znatno poboljšava iskustvo slušanja u poređenju s jednim naratorom.
U oblasti glasovnih agenata i konverzacijskih asistenata, VibeVoice-ova verzija u realnom vremenu je idealna. Bot koji odgovara sa zakašnjenjem od samo 300 ms djeluje mnogo prirodnije od onog kojem treba nekoliko sekundi da progovori, što interakcije sa korisničkom službom, chatbotovima ili glasovnim interfejsima čini mnogo glatkijim.
Još jedno vrlo zanimljivo područje je automatizirani sadržaj : sažeci vijesti, novosti s tržišta, periodični izvještaji ili čak čitanje e-pošte i obavještenja mogu se generirati bez ljudske intervencije, održavajući glas u skladu s imidžom brenda.
Konačno, postoje i eksperimentalnije primjene, poput kreiranja fiktivnih dijaloga, simuliranih intervjua ili zabavnih programa u potpunosti kreiranih pomoću umjetne inteligencije . Ovdje se jezički modeli za pisanje scenarija kombiniraju s VibeVoiceom za glasovnu glumu, što rezultira formatima koji su nedavno izgledali kao naučna fantastika.
Gledajući cjelokupnu sliku, VibeVoice se ističe kao ključni igrač u novom valu zvuka generiranog umjetnom inteligencijom , sposoban da kombinuje prirodne glasove, razgovore s više učesnika, vrlo duge audio klipove i gotovo trenutne odgovore. Korišten odgovorno i unutar utvrđenih etičkih granica, može postati nevjerovatno moćan alat za svakoga ko želi da pokrene ili skalira podcast, producira audio knjige ili doda profesionalne glasovne efekte svojim digitalnim projektima bez stalnog oslanjanja na tradicionalni studio za snimanje.

Indeks
- 1 Šta je VibeVoice i zašto je toliko važan za podcaste?
- 2 Kako VibeVoice funkcioniše: napredna sinteza govora i niska latencija
- 3 Dostupne verzije: modeli, parametri i preporučena upotreba
- 4 Praktična primjena: kako kreirati podcast pomoću VibeVoice-a
- 5 Kloniranje glasa pomoću umjetne inteligencije i personalizacija glasa
- 6 Prednosti za kreatore sadržaja i male projekte
- 7 Rizici, ograničenja i Microsoftova odluka u vezi s repozitorijem
- 8 Druge primjene osim podkastinga