- Izvorni omnimodalni model s tekstom, slikom, zvukom i videom, te streamingom u stvarnom vremenu.
- SOTA u 22/36 audio/video testovima i višejezičnost (119/19/10 jezika).
- Thinker–Talker arhitektura sa MoE, niskom latencijom i kontrolom sistemskih promptova.
- Preporučeno raspoređivanje sa vLLM/Transformers, Docker i službenim uslužnim programima.
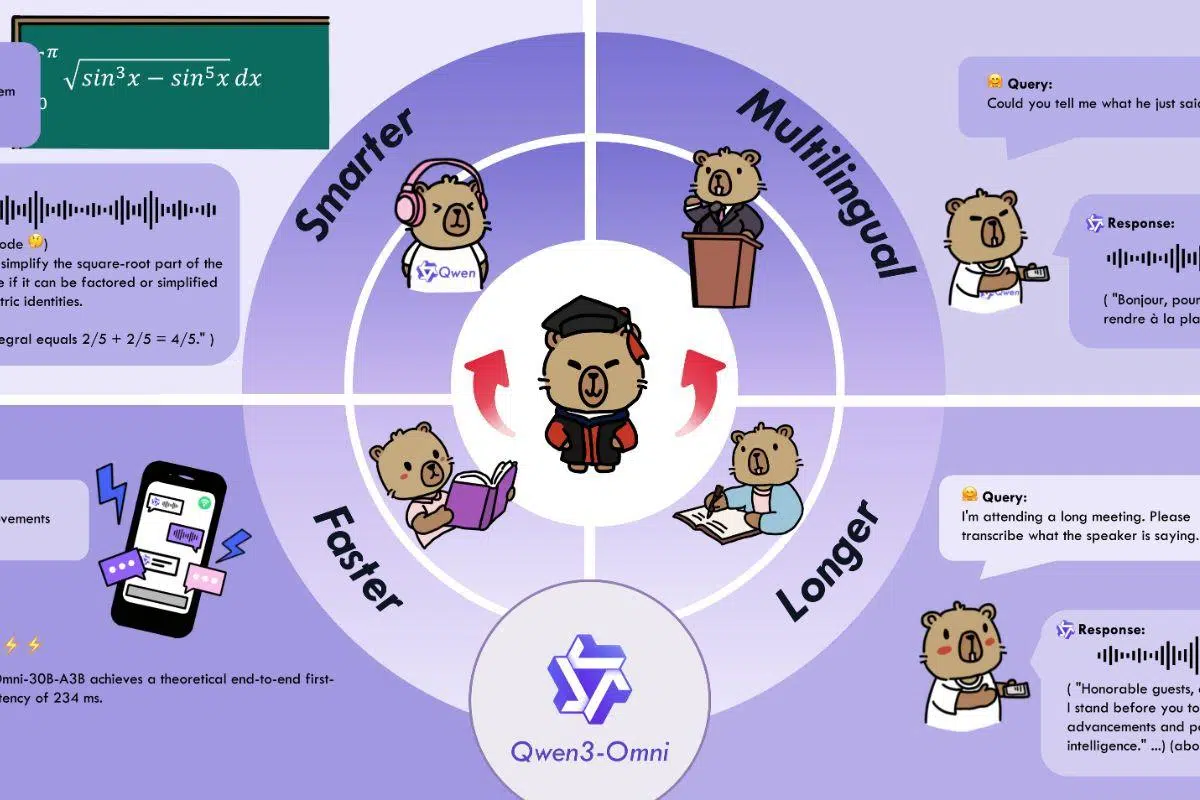
Pojava Qwen3-Omnija promijenila je pejzaž umjetne inteligencije: jedinstveni izvorni model sposoban za razumijevanje i reagiranje na tekst, slike, zvuk i video , s odgovorima u hodu, kako u pisanom tako i u govornom obliku. Ne govorimo o multimodalnim "zakrpama", već o fundamentalno dizajniranoj arhitekturi za integraciju modaliteta s niskom latencijom i fino podešenom kontrolom ponašanja.
U vrijeme kada gotovo svi testiraju chatbotove i asistente, Qwen3-Omni stiže s ambicijom: podržava 119 jezika putem teksta, prepoznaje govor na 19 i 10 jezika za razgovor , razumije duge audio zapise (do 30 minuta) i može se pohvaliti rezultatima u desetinama testova. Nadalje, njegov dizajn Mislilac-Govorac i pristup Mješavina stručnjaka imaju za cilj brzinu odgovora i kvalitet rasuđivanja u stvarnim scenarijima.
Šta je Qwen3-Omni i šta nudi?
Qwen3-Omni je porodica osnovnih, omnimodalnih i sveobuhvatnih višejezičnih modela dizajniranih za obradu teksta, slika, zvuka i videa, s izlazom i u tekstu i u prirodnom govoru. Ključ leži ne samo u raznolikosti ulaza i izlaza, već i u funkcionalnosti streaminga s fluidnim konverzacijskim okretajima i mogućnošću trenutnog odgovora.
Tim je uveo nekoliko arhitektonskih poboljšanja za performanse i efikasnost: ranu prethodnu obuku "prvo tekst" u kombinaciji sa mješovitom multimodalnom obukom i dizajn sa mješavinom stručnjaka (MoE) koji održava svoje performanse u tekstu i slici, a istovremeno poboljšava zvuk i video. S ovim poboljšanjima, model postiže SOTA u 22 od 36 audio/video benchmark testova i SOTA otvorenog koda u 32 od 36, s rezultatima uporedivim s Gemini 2.5 Pro u ASR-u, razumijevanju zvuka i govornom razgovoru.
Ključne mogućnosti i modaliteti
Qwen3-Omni je spreman za stvarne audio, vizualne i audiovizuelne aplikacije, s opsežnom višejezičnom podrškom: 119 tekstualnih jezika, 19 jezika za glasovni unos i 10 jezika za glasovni izlaz . Jezici za glasovni unos uključuju engleski, kineski, korejski, japanski, njemački, ruski, talijanski, francuski, španski, portugalski, malajski, holandski, indonezijski, turski, vijetnamski, kantonski, arapski i urdu; a izlazni jezici uključuju, između ostalih, engleski, kineski, francuski, njemački, ruski, talijanski, španski, portugalski, japanski i korejski.
Paket službenih kuharica ilustruje širinu njegove upotrebe. U audio formatu, predstavlja višejezično i dugo audio prepoznavanje govora (ASR) , prevođenje govora u tekst i govora u govor, analizu muzike (stil, ritam, žanrovi), opis zvučnih efekata i titlovanje bilo kojeg audio zapisa . Također podržava mješovitu analizu pjesama s govorom, muzikom i ambijentalnim zvukovima.
U oblasti vida, nudi "tvrdo" OCR za složene slike, detekciju i uzemljenje objekata , kontrolu kvaliteta slike, rješavanje matematičkih zadataka slike (gdje model razmišljanja blista), opis videa, navigaciju iz videa iz prvog lica i analizu prijelaza scena . U audiovizuelnim scenarijima, demonstrira kontrolu kvaliteta zvuka i videa s vremenskim usklađivanjem, vođenom interakcijom s AV ulazima i dijaloge s ponašanjem asistenta.
Kao agent, ističe se svojom sposobnošću da funkcioniše pozivanjem iz zvuka , što otvara glasovne tokove rada koji aktiviraju alate, a u izvedenim zadacima postoji Omni-Captioner za titlovanje sa velikim detaljima, što pokazuje generalizaciju osnovnog.
Mislilac-govornik Arhitektura i dizajn sa Ministarstvom obrazovanja
Jedna od ključnih razlika je podjela odgovornosti: Mislilac generira tekst (s varijacijama koje uključuju eksplicitno zaključivanje o lancu misli), a Govornik proizvodi zvuk u stvarnom vremenu . Ovo razdvajanje omogućava prirodan glasovni razgovor dok sistem održava visok nivo razumijevanja teksta i planiranja.
MoE baza podataka raspoređuje radno opterećenje među stručnjacima i oslanja se na AuT predobuku za snažne opće reprezentacije. Nadalje, korištenje višekodnog kodiranja u audio kanalu smanjuje latenciju na minimum, što je ključno za pozive ili asistente gdje je svaka stotinka sekunde važna.
Performanse i referentne vrijednosti: tekst, slika, audio i audiovizuelni sadržaj
Qwen3-Omni održava vrhunske performanse teksta i slike bez degradacije u poređenju sa Qwen modelima slične veličine fokusiranim na jedan način rada, dok u audio i audiovizuelnim performansama postavlja tempo u većini testova . U bateriji od 36 audio i audiovizuelnih benchmarkova, postiže open-source SOTA u 32 i ukupni SOTA u 22, nadmašujući Gemini 2.5 Pro i GPT-4o u nekoliko tačaka.
Neke značajne prekretnice u tekstu: u AIME25, varijanta Flash-Instruct postiže rezultat od oko 65,9; u ZebraLogic-u , Instruct dostiže 90, a u MultiPL-E postiže konkurentne brojke u odnosu na GPT-4o. U zadacima poravnanja kao što su IFEval i WritingBench, modeli Instruct i Thinking pokazuju visoke i konzistentne rezultate.
U audio testovima, ASR rezultati za kineski i engleski jezik su odlični: u WenetSpeech i LibriSpeech, značajno smanjuje stopu grešaka u riječima, sa brojkama blizu 1,22/2,48 u LibriSpeech clean/other, a u setovima poput FLEURS (višejezični), nudi vrlo niske stope. U VoiceBenchu, metrike kao što su AlpacaEval, CommonEval i WildVoice svrstavaju Qwen3-Omni u rang sa zatvorenim referentnim sistemima, a ističe se u audio rezonovanju u MMAU v05.15.25.
U audiovizuelnim aplikacijama, najčešće citirana metrika je WorldSense (približno 54,1 ), nadmašujući Gemini-2.5-Flash. Nadalje, u paketima poput DailyOmni i VideoHolmes, Thinking varijanta postiže poboljšanja u odnosu na prethodne SOTA aplikacije otvorenog koda. U čistom vidu, ističe se u MMMU, MathVista, MathVision i razumijevanju dokumenata (AI2D, ChartQA), s vrlo dobrim rezultatima u brojanju (CountBench) i razumijevanju videa (Video-MME, MLVU).
Također je izmjereno generiranje glasa s nultom brzinom: u usporedbi s porodicama poput CosyVoice i Seed-TTS, Qwen3-Omni pokazuje bolju konzistentnost sadržaja na više jezika i visoku sličnost govornika . U višejezičnom odjeljku, tabele "Konzistentnost sadržaja" i "Sličnost govornika" pokazuju da je Qwen3-Omni 30B-A3B vrlo konkurentan na kineskom i engleskom jeziku, te solidan na njemačkom, talijanskom, portugalskom, španskom, japanskom, korejskom, francuskom i ruskom jeziku. U međujezičnom TTS -u postiže bolju WER/konzistentnost na nekoliko parova (npr. zh→en, ja→en, ko→zh) u usporedbi s CosyVoice 2/3.
Dostupni modeli i za šta se svaki od njih koristi
Linija Qwen3-Omni uključuje tri glavna dijela, svaki dizajniran za specifičnu upotrebu: Instruct , Thinking i Captioner . Svi proizlaze iz iste jezgre, ali s različitim mogućnostima aktiviranim ili fino podešenim za specifične zadatke.
Qwen3-Omni-30B-A3B- Instruct sadrži Thinker i Talker, prihvata audio, video i tekst , te vraća tekst i audio. To je pravi izbor ako želite potpunu interakciju i govorne rezultate u stvarnom vremenu, a preporučuje se za glasovne ili video demonstracije .
Qwen3-Omni-30B-A3B- Razmišljanje se fokusira na Mislioca s lančanim zaključivanjem , podržavajući audio, video i tekst s tekstualnim izlazom. Korisno je za dubinsku analizu, rješavanje složenih problema, vizualnu matematiku ili radne procese gdje vam nije potreban glasovni izlaz , ali vam je potrebno najbolje strukturirano razmišljanje.
Qwen3-Omni-30B-A3B- Captioner je usavršeni derivat visokopreciznog titlovanja zvuka s niskom hiperaktivnošću . Otvorenog je koda, pokriva širok raspon zvuka s velikim detaljima i popunjava historijsku prazninu u ekosistemu otvorenog koda: pouzdani i bogati titlovi za zvuk opće namjene.
Latencija, kontrola u realnom vremenu i ponašanje
Sistem je optimizovan za trenutnu interakciju, sa vremenom odziva od približno 211 ms za audio i 507 ms za audio-video . Pored streaminga, naglasak je stavljen na prirodne konverzacijske pokrete i stabilnu reprodukciju glasa, čemu doprinose jasne uloge Mislioca (tekst) i Govornika (glas).
Za fino podešavanje, stil možete prilagoditi pomoću sistemskih uputa . U AV scenarijima gdje se video zvuk koristi kao referenca, tim predlaže sistemsku uputu koja održava razmišljanje Mislioca, a istovremeno pruža čitljiviji i konverzacijski tekst, olakšavajući Govorniku tečniji govor . Također se preporučuje da parametar `use_audio_in_video` ostane konzistentnim tokom višestrukog razgovora.
Prilikom evaluacije postoje specifične smjernice: ne postavljajte sistemski upitnik , slijedite ChatML format svakog benchmarka i, kada nema upitnika, koristite sljedeće prema zadanim postavkama: kineski ASR („请将这段中文语音转换为纯文本。“), ASR za druge jezike („Transkripcija zvuka u tekst.“), S2TT („Slušajte dati govor <izvorni_jezik>…“) i tekst pjesme („ Transkripcija teksta pjesme“… bez interpunkcije, redovi odvojeni prelomima“).
Implementacija, zahtjevi i alati
Za potpuno lokalno iskustvo, tim preporučuje Hugging Face Transformers i pregled faza softverskog inženjerstva , ali imajte na umu: budući da je MoE arhitektura, može se sporo pokretati s HF inferencijom; za produkcijske ili aplikacije s niskom latencijom , savjetuju korištenje vLLM-a ili DashScope API-ja , pa čak i pružaju Docker sliku koja uključuje okruženja za oba. Transformers kod je već spojen, ali PyPI paket još nije objavljen i mora se instalirati iz izvornog koda.
Oni pružaju uslužne programe za rukovanje zvukom i slikama/videom (base64, URL-ovi, isprepleteni unosi) i preporučuju FlashAttention 2 s Transformersima za smanjenje GPU memorije pri svakom učitavanju u float16 ili bfloat16 . S vLLM-om, FlashAttn2 je uključen, a parametri kao što su limit_mm_per_prompt (unaprijed dodjeljuje GPU memoriju) i max_num_seqs za paralelizam su detaljno opisani ; osim toga, povećanje tensor_parallel_size omogućava zaključivanje o više GPU-ova.
Postoji nekoliko korisnih savjeta za uštedu resursa: ako vam nije potreban zvuk, možete onemogućiti Talker nakon inicijalizacije, čime ćete uštedjeti otprilike 10 GB VRAM-a. A ako želite brži ispis teksta, koristite `return_audio=False` tokom generiranja. Također su navedeni minimalni teorijski zahtjevi za memoriju za BF16 s FlashAttn2: na primjer, Instruct 30B-A3B koristi otprilike 78,9 GB sa 15 sekundi videa i 144,8 GB sa 120 sekundi; Thinking koristi otprilike 68,7 GB i 131,7 GB, respektivno.
Za postavljanje lokalne web demonstracije , preporučuju pripremu vašeg vLLM okruženja (ili sporijeg Transformers okruženja), osiguranje da imate instaliran ffmpeg i korištenje njihovih skripti. Nude Docker slike "qwenllm/qwen3-omni" spremne za GPU s NVIDIA Container Toolkit-om , mapiranjem portova (npr. host 8901 → kontejner 80) i opcijom posluživanja od 0.0.0.0. Možete ponovo unijeti ili izbrisati kontejner po potrebi.
Demo verzije, API-ji i ekosistem
Ako ne želite da implementirate lokalno, možete isprobati demonstracije na Hugging Face Spaces i ModelScope Studio , sa iskustvima za Qwen3-Omni-Realtime, Instruct, Thinking i Captioner. Qwen Chat sa streamingom u realnom vremenu je također dostupan: jednostavno odaberite opciju glasovnog/video poziva u interfejsu.
Za skalabilnu integraciju s niskom latencijom, preporučeni pristup je DashScope API , koji nudi najpredvidljivije performanse. Nadalje, zajednica koordinira putem kanala poput Discorda i WeChata i objavljuje kuharice sa stvarnim zapisnicima izvršavanja koji korisnicima omogućuju reprodukciju rezultata promjenom upita ili modela.
Plan puta i kontinuirana poboljšanja
Tim radi na dodatnim funkcijama kao što su prepoznavanje govora više govornika , OCR primijenjen na video, poboljšanja proaktivnog audiovizuelnog učenja i bogatiji tokovi rada agenata . Također su naznačili da će podrška za audio izlaz u vLLM-u za Instruct model uskoro biti dostupna, čime će se završiti ciklus implementacije u realnom vremenu iz tog backenda.
Često postavljana pitanja: Podrška za izvođenje i kvantizacija
Neki korisnici su komentirali da ne mogu pokrenuti Qwen3-Omni čak ni sa uobičajenim osumnjičenima i da ne vide kvantne funkcije u Hugging Face-u ; nadalje, izvorni 16-bitni format je oko 70 GB, veličina koja je problematična za skromnije računare. Sam projekat pojašnjava da je Transformers već spojen, ali bez PyPI paketa , koji se mora instalirati iz izvornog koda, te da je vLLM preferirana opcija za inferenciju, iako će podrška za Instruct audio u vLLM-u biti objavljena u bliskoj budućnosti.
Što se tiče kvantizacije, u HF-u još uvijek nema navedenih rezerviranih mjesta za Qwen3-Omni 30B-A3B, i vrijedi imati na umu da MoE i multimodalna priroda kompliciraju trenutnu kompatibilnost s okruženjima za izvršavanje poput llama.cpp. Za one kojima je potrebno testiranje sada, službena preporuka je korištenje Docker + Transformers/vLLM iz izvornog koda ili API-ja , te praćenje repozitorija za zahtjeve za podršku i buduće kvantizacije kada budu dostupne.
Dobre prakse i upute za evaluaciju
Za reprodukciju brojeva, detaljno su opisane sljedeće smjernice: većina benchmarkova koristi pohlepno dekodiranje u Instructu bez uzorkovanja, a za Thinking se moraju poštovati parametri u generation_config.json . Broj sličica u sekundi videa je također postavljen na fps=2 tokom evaluacije, a naznačeno je da korisnički upit treba slijediti multimodalne podatke, osim ako skup podataka ne navodi drugačije.
Kada benchmark ne uključuje upit, mogu se koristiti zadani upiti (kineski ASR/ostalo, S2TT, tekstovi pjesama). Osim toga, sistemski upit ne bi trebao biti postavljen tokom evaluacije kako bi se osiguralo da su rezultati uporedivi između sistema i prolaza.
Qwen3-Omni se pozicionira kao prava omnimodalna platforma, s niskom latencijom, širokom višejezičnom podrškom, vrhunskim audio i video mogućnostima i jasnim putem implementacije korištenjem Transformersa, vLLM-a i Dockera. Za one koji traže jedinstveni model koji besprijekorno obrađuje tekst i slike bez žrtvovanja performansi, a koji također sluša, govori i razumije video , to je prijedlog koji je danas teško nadmašiti.