- La coherència de memòria cau garanteix que totes les còpies d'una mateixa dada en diferents memòria cau i en la RAM es mantinguin consistents en sistemes multinucli.
- La jerarquia de memòria cau amb un últim nivell compartit simplifica el control de coherència i redueix dreceres a la memòria principal.
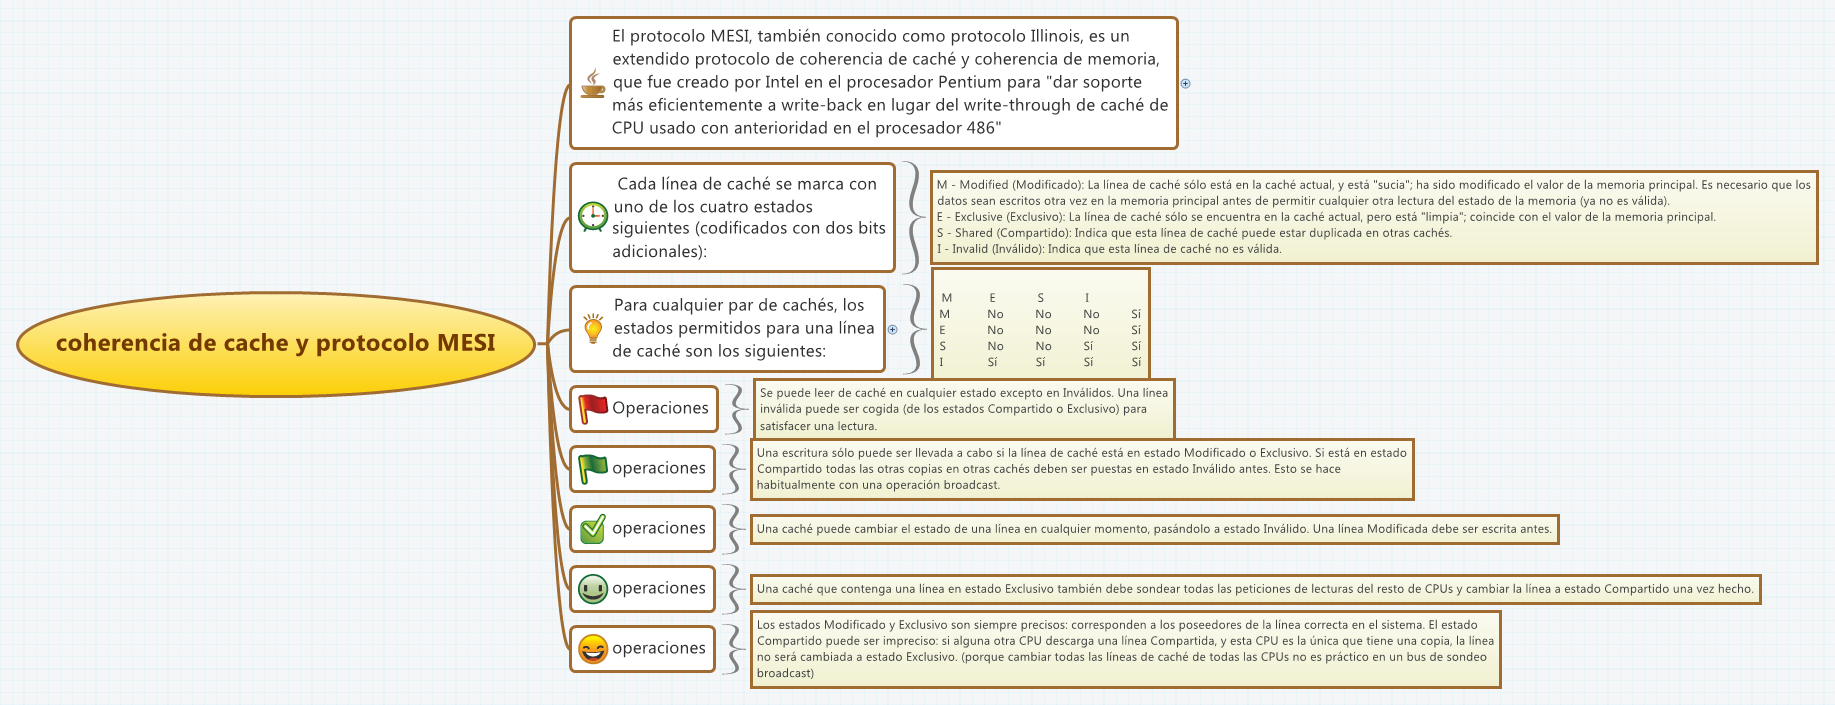
- Els protocols de coherència usen estratègies d'invalidació o actualització de còpies, recolzades en estats i bits de control per línia de memòria cau.
- El compilador i el sistema operatiu poden complementar la coherència per maquinari inserint instruccions i configurant memòria per a períodes crítics.
Quan mires un diagrama de qualsevol processador multinucli modern, sempre apareix el mateix patró: diversos nuclis, cadascun amb les seves pròpies memòries cau properes, i una memòria cau compartida d'últim nivell que actua com a punt comú abans d'arribar a la memòria RAM. Aquesta disposició no és casualitat ni un caprici dels dissenyadors, sinó una resposta directa a un problema crític en sistemes paral·lels: la coherència de memòria cau.
Sense un bon mecanisme de coherència, cada nucli podria acabar treballant amb una versió diferent i desactualitzada de les mateixes dades en memòria , cosa que en un programa real equival a errors subtils, fallades impredictibles i fins i tot penges del sistema. Per això, comprendre com es manté aquesta coherència —tant pel que fa al maquinari com al programari— és clau per entendre el rendiment i l'estabilitat de les CPU multinucli actuals.
Què és la coherència de memòria cau: la metàfora de les terminals

Imagina que diverses persones estan assegudes davant de diferents terminals, totes editant el mateix document emmagatzemat en un servidor central . Cada pantalla mostra una còpia del fitxer, i s'espera que qualsevol canvi que faci una persona es reflecteixi immediatament a les pantalles de la resta.
Perquè això funcioni, hi ha d'haver un mecanisme de sincronització que propagui els canvis del document a totes les terminals, de manera que totes vegin sempre la mateixa versió. Mentre aquest sistema funciona tot va bé: qui modifica el text sap que la resta veurà la nova versió gairebé a l'instant.
Ara pensa que aquest sistema de sincronització falla de sobte. Cada persona segueix editant convençuda que treballa sobre el document compartit, però en realitat cada terminal ha quedat amb la seva còpia local desconnectada . A partir d'aquell moment, els canvis que en fa un no arriben als altres, i el document comença a divergir sense control.
Portat al terreny de la informàtica, això és exactament el que passaria si la CPU no tingués un protocol fiable de coherència: un nucli modifica una dada en memòria, però la resta de nuclis continua llegint una versió antiga a les caixes privades . Això és terreny abonat per a errors lògics gravíssims, dades corruptes i comportaments impossibles de depurar.
La coherència de memòria cau és, per tant, el conjunt de mecanismes que garanteixen que, en un sistema multinucli, totes les còpies d'una mateixa dada repartides per les diferents memòria cau i la RAM mantinguin un estat consistent . Encara que hi hagi múltiples còpies, el sistema s'ha de comportar «com si» només n'hi hagués una.
Caixets i jerarquia de memòria en una CPU multinucli
Les cachés de la CPU són memòries petites i molt ràpides que mantenen còpies de fragments de la memòria RAM que s'utilitzen amb més freqüència . Quan el processador executa codi, en lloc d'accedir contínuament a la RAM (lenta en comparació), intenta llegir i escriure en memòria cau, cosa que redueix de manera brutal la latència.
El truc, és clar, és que les caixets no guarden la «versió oficial» de les dades, sinó només una rèplica temporal . Seguint la metàfora de les terminals, la RAM seria el document al servidor, mentre que les caixes serien les pantalles locals que mostren còpies de certes parts del fitxer.
En una CPU multinucli, el disseny es complica perquè cada nucli sol tenir les seves pròpies caixets privades de primer nivell (L1) i fins i tot de segon nivell (L2) . Per sobre, s'hi afegeix una memòria cau compartida d'últim nivell (L3, per exemple), que se situa entre els nuclis i el controlador de memòria que dóna accés a la RAM.
Aquesta memòria cau compartida s'introdueix perquè permetre que tots els nuclis accedeixin de manera directa i intensiva a la RAM provocaria conflictes d'accés, contenció al bus de memòria i un descens notable del rendiment . La memòria cau d'últim nivell actua com un «amortidor» comú que redueix els accessos a la RAM i centralitza bona part del trànsit de dades.
A més, moltes arquitectures organitzen les caixets de forma inclusiva: les línies emmagatzemades en nivells propers al processador també són presents en els nivells superiors de la jerarquia . És a dir, una línia que apareix a L1 també està a L2 i, al seu torn, a L3. Això té una conseqüència molt útil per a la coherència: només cal actualitzar correctament la memòria cau d'últim nivell per poder controlar l'estat de la resta de nivells sense haver d'anar constantment a la RAM.
Per què la memòria cau compartida d'últim nivell és clau per a la coherència
Si no existís aquesta memòria cau global d'últim nivell, cada nucli hauria de comprovar la coherència directament contra la memòria principal . Cada cop que es modifiqués una línia de memòria en una memòria cau privada, caldria verificar si altres nuclis mantenen una còpia d'aquesta mateixa línia i, en cas afirmatiu, actualitzar-la o invalidar-la a tot arreu.
En un sistema amb molts nuclis, aquesta càrrega de comprovacions suposaria una quantitat enorme de transaccions cap a la RAM , tirant per terra gran part del benefici de tenir caixets ràpides. Quan col·loqueu una memòria cau compartida entre els nuclis i la memòria, la CPU pot concentrar el control de coherència en un sol lloc intermedi.
En moltes implementacions, les caixets dels nivells superiors (més allunyats del processador) contenen còpia de les línies presents en els nivells més propers al nucli . Amb aquesta organització, el protocol de coherència només necessita assegurar-se que l'últim nivell està sincronitzat amb la memòria principal, i que els nivells privats de cada nucli estiguin sincronitzats amb el nivell immediatament superior.
Això es pot visualitzar com una mena de canell russa: la memòria cau de tercer nivell inclou el contingut que està en la de segon i primer nivell , la de segon inclou la seva i la del primer nivell, i la de primer nivell només coneix les seves pròpies línies. Així, amb controlar el «nina gran» (l'últim nivell), el sistema pot coordinar la resta de manera més eficient.
El resultat és que mantenir la coherència esdevé més econòmic en termes de disseny i de trànsit de memòria . En lloc d'obligar cada nucli a bregar permanentment amb la RAM, el protocol actua sobre la memòria cau compartida i des d'aquí gestiona quines línies s'han d'actualitzar o invalidar a les memòria cau privades.
Mètodes d'actualització: invalidació i actualització de còpies
Un punt delicat apareix quan dos o més nuclis volen accedir, gairebé al mateix temps, a la mateixa línia de dades que està replicada a diverses memòria cau . En aquest context, els sistemes de coherència solen recórrer a dues estratègies fonamentals a l'hora de tractar les escriptures.
El primer mètode es basa en la invalidació. Quan un nucli necessita escriure en una determinada línia de memòria cau, el protocol s'encarrega d' invalidar les còpies d'aquesta mateixa línia que puguin existir a la resta de memòria cau . Només el nucli que escriurà manté la línia en un estat vàlid per a lectura i escriptura; la resta, si voleu tornar a usar aquestes dades, hauran de recarregar la línia des del nivell superior (o des de la memòria) amb la versió actualitzada.
La segona estratègia consisteix a actualitzar. En aquest cas, quan un nucli modifica una línia, el sistema intenta propagar automàticament el nou contingut a les còpies existents a la resta de caixets . D'aquesta manera, totes les caixets que emmagatzemaven aquesta línia reben la versió fresca sense necessitat d'invalidar-la i recarregar-la més tard.
Cada enfocament té els seus pros i contres. La invalidació sol ser més eficient quan les escriptures són freqüents perquè evita saturar el sistema de memòria amb actualitzacions que potser els altres nuclis no necessitin immediatament. Per contra, l'actualització pot ser avantatjosa quan molts nuclis llegeixen sovint la mateixa dada que es modifica de manera relativament poc freqüent , ja que es redueix la latència en no haver de recarregar la línia després de cada invalidació.
En qualsevol cas, darrere d'ambdós mètodes s'utilitzen estats addicionals i bits de control a les línies de memòria cau. És habitual que cada línia inclogui informació sobre si el contingut coincideix o no amb el de la RAM , i si està compartida, modificada, exclusiva, reservada, etc., segons el protocol concret (MESI, MOESI, MSI, etc.). Això permet que el maquinari prengui decisions ràpides sobre què fer quan es produeix una lectura o escriptura en una línia ja replicada.
Comprovació de coherència entre caixets i memòria
Comprovar directament la coherència entre tots els nivells de memòria cau d'una CPU o GPU i la memòria principal seria un treball mastodòntic, tant en complexitat de disseny com en cost de rendiment. Per això, els sistemes moderns organitzen aquesta verificació de manera jeràrquica.
Les memòria cau més properes al processador (L1, L2) no solen estar connectades directament a la RAM, sinó al següent nivell de memòria cau. Això significa que la coherència no es valida contra la memòria principal a cada nivell, sinó respecte al nivell immediatament superior . Així es redueix el nombre d'accessos a RAM i se simplifica la lògica necessària als nivells inferiors.
Al final, la comparació entre el contingut de memòria cau i el contingut de la RAM es realitza entre la memòria cau d'últim nivell i la memòria principal . Si aquest últim nivell manté un estat correcte i coherent, i cada nivell inferior manté la seva coherència amb el superior, tota la jerarquia es manté consistent sense haver de comprovar cada línia davant de la RAM una vegada i una altra.
Quan un nucli escriu en una línia de memòria cau i canvia les dades, es marca l'estat d'aquesta línia per indicar que ja no coincideix exactament amb la còpia emmagatzemada a la memòria . A partir d'aquí, el protocol s'encarrega de coordinar l'actualització: marca les còpies corresponents a altres caixets com a reservades o invàlides i, quan correspon, escriu el nou contingut a la línia de memòria principal associada.
Aquesta organització en forma de cascada permet que els canvis es propaguin progressivament des del nucli que actualitza les dades fins a la memòria principal, passant per cada nivell de memòria cau de forma controlada. Daquesta manera, mantenir la coherència no es converteix en un coll dampolla inassumible per al processador.
Coherència per maquinari davant de coherència per programari
Fins ara hem parlat de mecanismes de coherència que s'implementen principalment en maquinari: protocols, bits d'estat, caixets compartits, etc. No obstant això, hi ha un altre enfocament que cerca desplaçar part d'aquesta complexitat al programari , concretament al compilador i al sistema operatiu.
Els esquemes de coherència basats en programari intenten reduir la necessitat de lògica addicional al xip, i ho fan mitjançant anàlisi del codi i decisions en temps de compilació . La idea és que, si el compilador pot deduir quan i com s'accedeix a certes dades compartides, podria evitar en molts casos que aquestes dades s'emmagatzemin a la memòria cau o gestionar la seva visibilitat de manera explícita.
Aquest enfocament té un avantatge clar: una part de la càrrega de treball passa dexecutar-se en temps dexecució a resoldre en temps de compilació . En lloc que el maquinari detecti i gestioni tots els conflictes en calent, el compilador intenta anticipar-los i generar un codi que eviti situacions perilloses.
La contrapartida és que l'anàlisi estàtica del codi és limitada i, per tant, els compiladors tendeixen a ser conservadors . Això vol dir que, per no arriscar-se a violar la coherència, solen prendre decisions que redueixen l'eficàcia de les caixets. Si sospiten que unes dades poden ser problemàtiques, és freqüent que n'impedeixin l'emmagatzematge en memòria cau o que forcin sincronitzacions més freqüents del que és estrictament necessari.
Per això, encara que aquests esquemes de programari són atractius en teoria, especialment per simplificar el disseny del maquinari, a la pràctica no substitueixen el suport de coherència integrat a la pròpia CPU , sinó que el complementen en alguns escenaris específics.
El paper del compilador en la coherència de memòria cau
Un element clau dels enfocaments de coherència basats en programari és el paper del compilador. El compilador pot realitzar una anàlisi profunda del codi i determinar quines estructures de dades compartides poden resultar insegures per al seu emmagatzematge en memòria cau . Sobre aquesta base, marca aquests elements de manera especial o adapta la generació de codi.
L'enfocament més simple, i també el més conservador, consisteix a evitar que les variables de dades compartides s'emmagatzemin a la memòria cau . És a dir, cada accés a aquestes variables força un accés a memòria principal oa una àrea no registrable. Això garanteix la consistència, però desaprofita moltes oportunitats de rendiment, perquè una estructura compartida pot, de fet, fer-se servir de forma privada durant certs períodes, o bé de només lectura en altres.
En realitat, el problema de coherència només apareix durant els intervals en què almenys un procés pot escriure a la variable i un altre procés pot llegir-la . Fora d'aquestes finestres crítiques, la variable es pot tractar com a ús exclusiu d'un fil o fins i tot com a constant efectiva durant una estona, cosa que permetria escorcollar-la sense problemes.
Les estratègies més avançades de compilació intenten justament identificar aquests períodes «segurs» en què la variable compartida es pot considerar no conflictiva . Per això, el compilador analitza les rutes d'execució, els possibles accessos concurrents i els patrons de sincronització (bloquejos, seccions crítiques, etc.). A partir d'aquesta anàlisi, divideix el temps de vida de la variable en fases: algunes aptes per a la memòria cau, d'altres que requereixen una gestió especial.
En els períodes crítics, en què es detecta possible accés concurrent amb escriptures, el compilador insereix instruccions addicionals al codi generat per fer complir la coherència de la memòria cau . Aquestes instruccions poden forçar buidatges de memòria cau, recàrregues des de memòria, barreres de memòria o accessos a regions marcades com a no escorcollables, segons el model de programació i l'arquitectura subjacent.
Relació entre compilador, sistema operatiu i maquinari
La frase «el compilador insereix instruccions al codi generat per fer complir la coherència de la memòria cau» pot fer pensar que el sistema operatiu llegeix aquestes instruccions com si fossin pistes d'alt nivell i, sobre aquesta base, decidís com executar el programa. En realitat, el mecanisme és diferent.
Quan el compilador afegeix aquest tipus d'instruccions, el que introduïu al binari són operacions concretes suportades per l'arquitectura o per l'entorn d'execució . Per exemple, podeu inserir instruccions de buidatge de memòria cau, barreres de memòria, instruccions especials per marcar regions com no escorcollables o trucades a serveis del sistema operatiu que configurin atributs de memòria.
El sistema operatiu no interpreta aquestes instruccions com a comentaris o hints d'alt nivell escrits pel compilador, sinó que simplement executa el codi de màquina com qualsevol altre . El que passa és que part d'aquestes instruccions estan dissenyades per interactuar amb el subsistema de memòria i amb la gestió de caixets, de manera que canvien la manera com la CPU accedeix a certes dades.
En altres paraules, el compilador fa un treball previ d'anàlisi i genera codi que, en executar-se, provoca el comportament desitjat de la memòria cau . El sistema operatiu col·labora establint atributs de memòria (zones registrables o no, polítiques d'escriptura, etc.) i proporcionant primitives de sincronització, però no està llegint instruccions especials en el sentit d'interpretar-les semànticament com ho faria un compilador.
També pot passar que el maquinari, en veure certes instruccions, activeu mecanismes específics de coherència o de sincronització . Per exemple, instruccions de tipus fence o barrier garanteixen l'ordre d'accés a memòria i forcen determinats efectes de visibilitat a través de la jerarquia de memòria cau. En aquest cas, la col·laboració és a tres bandes: el compilador decideix on col·locar aquestes instruccions, el sistema operatiu configura l'entorn d'execució, i el maquinari implementa el comportament real a nivell de memòria cau i bus de memòria.
En conjunt, tots aquests elements aconsegueixen que, encara que hi hagi múltiples còpies de les mateixes dades repartides per diferents caixets i la memòria principal, els programes paral·lels s'executin amb un model consistent de memòria . La coherència de memòria cau, lluny de ser un simple detall intern de la CPU, es converteix en una peça central perquè els sistemes multinucli funcionin de manera fiable i eficient.
Entendre com es combinen la jerarquia de memòria cau, els protocols de coherència per maquinari i les tècniques de suport per programari deixa més clar per què els dissenys de CPU modernes comparteixen una estructura tan similar, i per què una petita fallada en qualsevol d'aquests mecanismes pot desencadenar comportaments caòtics en aplicacions concurrents que depenen completament que tots els nuclis vegin el moment en què vegin el mateix.