- La monitorització de trànsit de xarxa en temps real permet anticipar errors, millorar el rendiment i reforçar la seguretat de la infraestructura IT.
- Les eines de codi obert com ara Nagios, Zabbix, Prometheus, Cacti, OpenNMS, Icinga, Netdata, LibreNMS o Observium ofereixen funcions avançades sense costos de llicència.
- La combinació de recol·lectors de mètriques, bases de dades de sèries temporals i capes de visualització com Grafana i Graphite crea solucions molt flexibles i escalables.
- Definir requisits, aplicar bones pràctiques i fer una prova de concepte és clau per triar i desplegar la plataforma de monitorització més adequada.
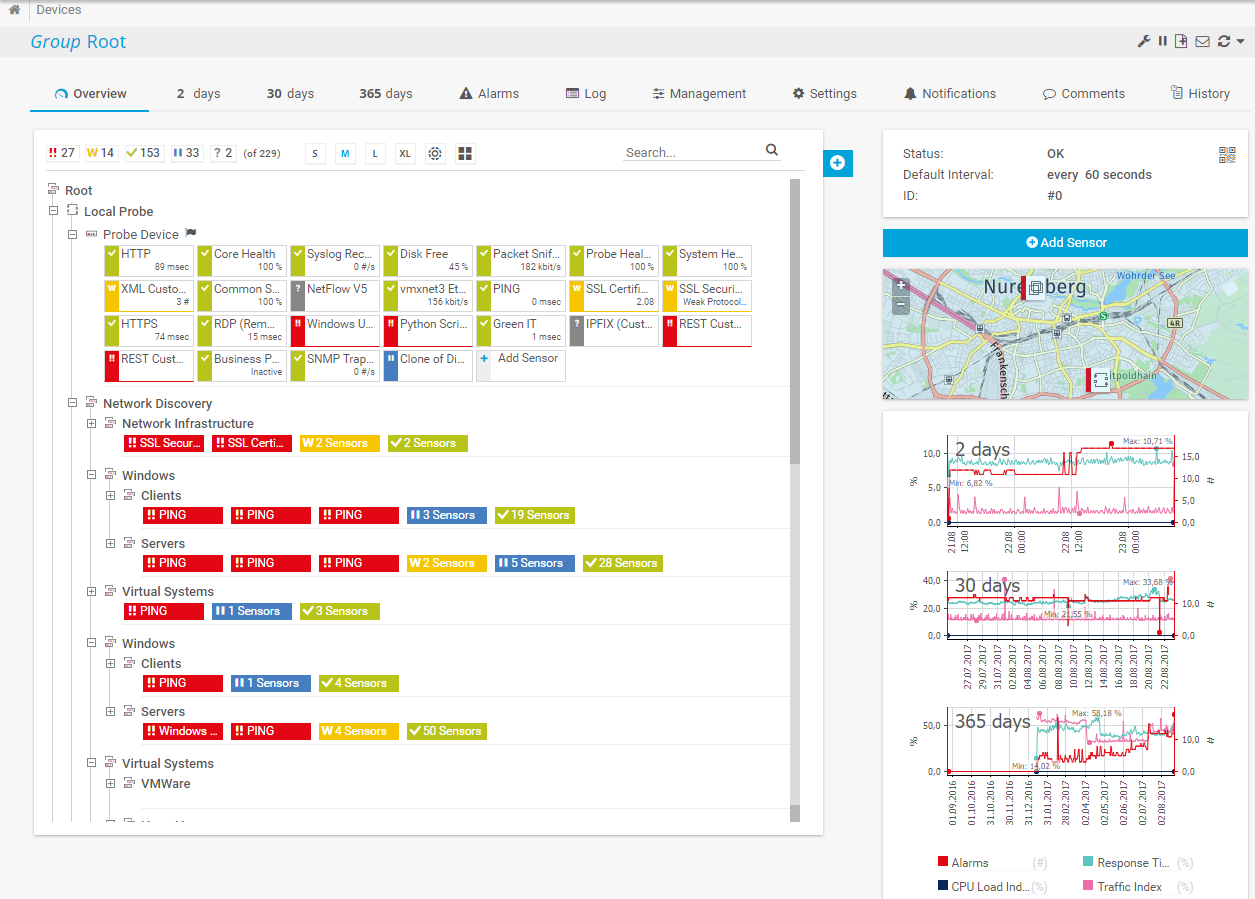
Quan la xarxa de l'empresa comença a anar lenta, cau el WiFi o el servidor crític es penja en el pitjor moment, ja no n'hi ha prou amb “reiniciar el router i creuar els dits”. Avui és clau comptar amb eines de monitorització de trànsit de xarxa de codi obert que permetin veure què està passant en temps real, anticipar-se als problemes i evitar parades costoses.
Si treballes a IT, a xarxes o t'ha tocat “fer de responsable tècnic ” a la teva empresa, segurament et sonen solucions com PRTG o SolarWinds… i també les seves llicències. La bona notícia és que hi ha un ecosistema molt madur de plataformes open source per monitoritzar dispositius, serveis i trànsit de xarxa (routers, switches, punts d'accés WiFi, servidors, contenidors, núvols públics i molt més) sense haver de pagar quotes desorbitades i amb una flexibilitat brutal.
Què és el monitoratge de trànsit de xarxa en temps real i per què és tan important
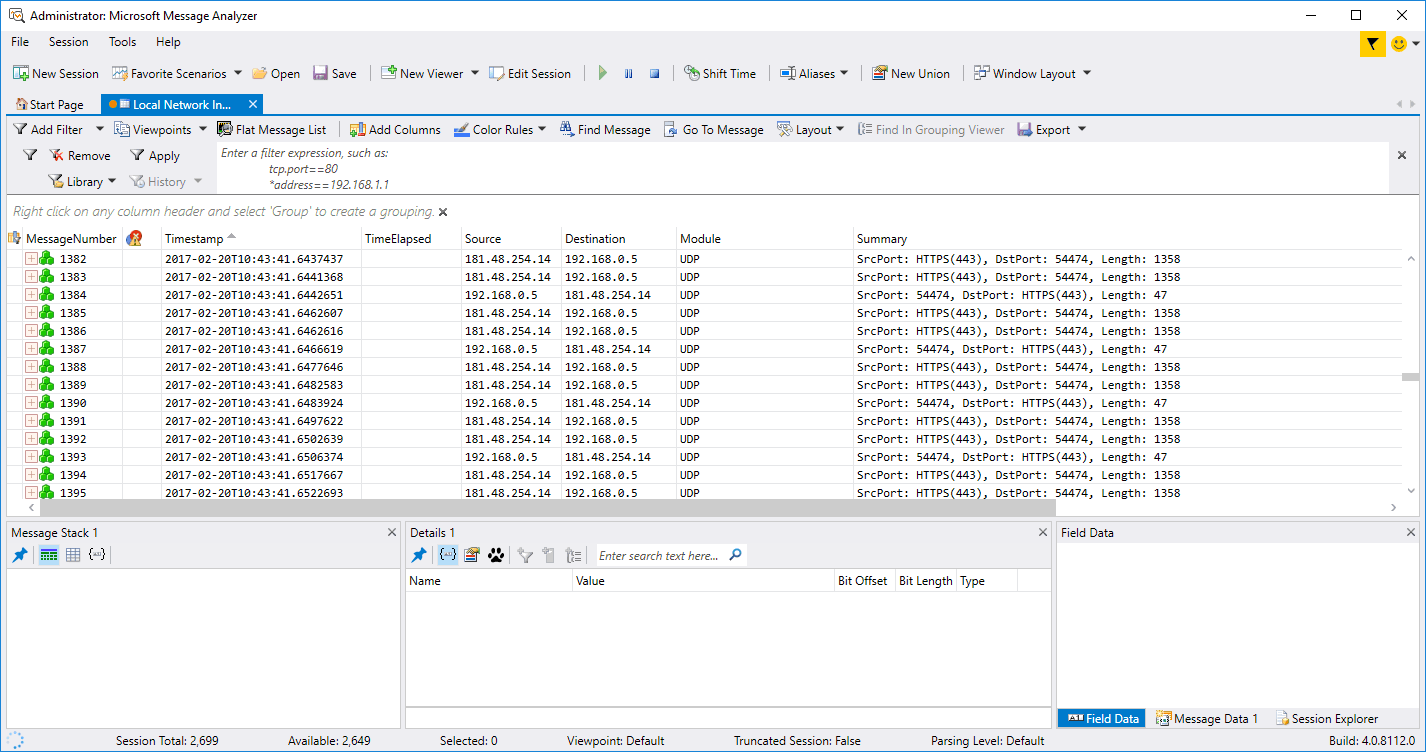
Quan parlem de monitorització de xarxa en temps real ens referim a la supervisió contínua de l'estat, rendiment i seguretat de la infraestructura IT i de comunicacions , detectant incidents just en el moment en què es produeixen. El programari va recopilant i analitzant mètriques de dispositius, sistemes i aplicacions de manera constant perquè l'equip de TI pugui reaccionar abans que el problema impacti el negoci.
Aquest tipus de solucions es recolzen en protocols com SNMP, NetFlow/sFlow, ICMP , APIs i agents específics per recollir dades de routers, switches, tallafocs, punts d'accés, servidors físics i virtuals, contenidors, serveis cloud, aplicacions web, bases de dades i pràcticament qualsevol element que formi part de la infraestructura.
L'objectiu principal és disposar de visibilitat completa sobre el trànsit, l'ús d'amplada de banda, la disponibilitat i la salut de cada component . D'aquesta manera, es poden detectar colls d'ampolla , atacs, errors de maquinari o saturacions de serveis abans que es tradueixin en caigudes, lentitud generalitzada o pèrdues d'informació.
A més de les dades en viu, moltes eines permeten emmagatzemar mètriques històriques per fer anàlisis de tendències , planificació de capacitat, comprovació de compliment de SLA/OLA, auditoria de seguretat i suport a decisions d'inversió en nous equips o enllaços.
Principals usos i beneficis del monitoratge en temps real
Un dels majors beneficis és el manteniment preventiu de la infraestructura IT i de xarxa . Tenir mètriques contínues de CPU, memòria, temperatura, estat de fonts dalimentació, errors dinterfície o pèrdua de paquets ajuda a detectar símptomes primerencs de fallada abans que hi hagi una avaria seriosa o un tall de servei.
La resposta primerenca a incidents és un altre pilar clau. Les plataformes de monitorització generen alertes personalitzables (correu, SMS, Slack, Teams, webhooks, etc.) quan un valor supera un llindar, un servei deixa de respondre o apareix un patró sospitós en el trànsit. Això redueix dràsticament el temps d'inactivitat i l'impacte d'incidents de seguretat o errors de rendiment.
En el dia a dia, la monitorització contribueix a l' optimització del rendiment global de xarxes, servidors i aplicacions. Poder veure quins enllaços estan saturats, quins serveis consumeixen més recursos o quines zones horàries disparen la càrrega ajuda a ajustar configuracions, equilibrar càrregues, redefinir polítiques de QoS i, en general, esprémer millor la tecnologia instal·lada.
Un altre aspecte cada cop més important és el compliment normatiu. Un bon sistema de monitorització facilita el control d'accessos, el seguiment de dades sensibles i la detecció d'accessos no autoritzats aportant logs i mètriques útils per a auditories i per demostrar compliment de requisits reguladors o contractuals.
Per acabar, des d'una perspectiva de negoci, aquestes solucions es converteixen en eines de suport a la decisió : informes periòdics, panells executius, anàlisi històrica d'incidents i disponibilitat, comparatives entre seus o proveïdors de núvol… tot això ajuda a justificar inversions, negociar amb tercers i prioritzar projectes IT.
Avantatges específics del programari de monitorització de codi obert
El primer avantatge evident de les eines open source és la rendibilitat: no hi ha llicències d'ús tancades ni costos per dispositiu tan agressius com en moltes plataformes comercials. Això no vol dir que tot sigui gratuït (sempre hi ha costos d'infraestructura, suport o formació), però l'estalvi en llicències deixa marge per invertir en altres àrees crítiques.
El segon gran punt fort és el suport de la comunitat i la capacitat d'innovació . Projectes com Nagios, Zabbix, Prometheus, LibreNMS o Netdata compten amb comunitats molt actives que desenvolupen plugins, integracions, panells i millores constants, a més de corregir errors i tancar vulnerabilitats amb rapidesa.
També destaca la transparència del codi i la confiança : en ser programari obert, qualsevol pot auditar com es processen i emmagatzemen les dades, revisar la seguretat del sistema i adaptar el codi font a necessitats concretes. Això redueix el risc de portes del darrere ocultes i facilita complir polítiques internes de seguretat.
Un altre punt clau és evitar el bloqueig del proveïdor. Amb solucions obertes és més fàcil migrar entre eines o combinar-les (per exemple, fer servir Prometheus per a mètriques d'aplicacions, Zabbix per a dispositius de xarxa i Grafana com a capa de visualització unificada), sense quedar lligat de per vida al roadmap d'una sola empresa.
Òbviament, les eines de codi obert solen exigir cert nivell tècnic per a instal·lació, configuració i manteniment , però a canvi ofereixen una flexibilitat i potència que competeixen de tu a tu amb moltes solucions comercials, especialment en entorns on es valora la personalització i la integració amb sistemes existents.
Top d'eines de monitorització de codi obert per a xarxes i infraestructura
Hi ha desenes de projectes madurs orientats al monitoratge de xarxa, servidors, aplicacions i entorns cloud. A continuació es presenta una visió global de les eines open source més rellevants per a trànsit de xarxa i observabilitat , segons diverses anàlisis tècniques i comparatives especialitzades.
Una de les referències clàssiques és Nagios Core , un motor de monitorització i alerta altament robust. Funciona com a base per a múltiples projectes Nagios i s'encarrega de programar revisions, processar resultats, gestionar esdeveniments i generar alertes. La seva arquitectura modular permet ampliar capacitats mitjançant APIs i plugins personalitzats, i el seu ecosistema és enorme, amb integracions per a gairebé qualsevol tipus de dispositiu o servei.
Un altre gegant al món open source és Zabbix , molt orientat a la supervisió d'infraestructures de TI a gran escala. És especialment potent per recopilar i analitzar mètriques de dispositius de xarxa (ús d'amplada de banda, estat d'interfícies, enllaços, pèrdua de paquets, temperatura, CPU, memòria, etc.), ja sigui mitjançant SNMP o amb agents propis. Permet definir llindars, fluxos d'escalat d'alertes, horaris, canals de notificació i una lògica d'esdeveniments molt granulars.
En l'àmbit d'aplicacions natives cloud i dades de sèrie temporal destaca Prometheus . Aquesta solució utilitza un model de dades dimensional, identificat per nom de mètrica i etiquetes clau-valor, i es recolza en el llenguatge de consulta PromQL per crear gràfics, taules, regles d'alerta i consultes complexes. Les vostres dades s'emmagatzemen de forma eficient en memòria i disc local, cosa que fa que instàncies individuals siguin molt autònomes, i s'integra de forma natural amb Grafana per a la part visual.
Per als que busquen una solució lleugera, amb focus en temps reals molt reduïts i mínima latència, Netdata és una opció molt interessant. S'instal·la com a agent a cada servidor o dispositiu Linux, recull mètriques de sistema i aplicacions, emmagatzema les dades al mateix node (sense dependència de bases de dades externes per al curt termini) i ofereix panells automatitzats amb visualitzacions molt detallades del rendiment, recolzant-se fins i tot en models d'aprenentatge automàtic per detectar anomalies.
Eines especialitzades en xarxes i visualització de trànsit
Més enllà de les plataformes generalistes, hi ha eines open source que apunten directament al monitoratge de trànsit de xarxa i gràfics de rendiment , especialment útils quan el focus és veure l'amplada de banda, els fluxos i la salut dels enllaços.
Una de les més populars és Cacti , centrada en la creació de gràfics de xarxa i en la gestió d'errors per a monitorització operativa. Utilitza RRDTool per emmagatzemar dades i generar gràfics, ofereix plantilles per automatitzar l'alta de dispositius i suporta múltiples mètodes d'adquisició de dades. Els seus plugins (THold, SysLog, MacTrack, entre d'altres) permeten tenir llindars, integració amb Syslog, seguiment d'adreces MAC i monitoritzar dispositius en temps real.
Una altra plataforma molt potent és OpenNMS Horizon , considerada una de les primeres solucions de supervisió de serveis de xarxa totalment open source a nivell empresarial. Suporta monitorització de xarxes locals i distribuïdes, ofereix inventari, gestió de fallades, recopilació remota de dades, correlació d'alarmes, supervisió de serveis de negoci i monitorització de trànsit. Tot es gestiona des d'una interfície web intuïtiva amb panells personalitzables.
En un terreny similar, Icinga es posiciona com a evolució moderna del model de Nagios, amb una interfície web molt cuidada i un enfocament fort al monitoratge de xarxa, rendiment d'interfícies, ús d'amplada de banda, errors, càrrega de CPU i memòria, a més de salut del maquinari. Icinga suporta revisions SNMP, mètriques específiques per proveïdor i recepció de traps SNMP, integrant-se amb Logstash per gestionar esdeveniments procedents de múltiples dispositius.
Per als qui necessiten una visió molt detallada de dispositius de xarxa, interfícies i trànsit, projectes com LibreNMS i Observium resulten especialment útils. Tots dos es recolzen fortament en SNMP i protocols de descobriment (CDP, LLDP, OSPF, BGP, ARP, etc.) per descobrir automàticament la xarxa, generar mapes i presentar mètriques de rendiment amb gràfics clars , llindars configurables i sistemes d'alertes flexibles.
Visualització avançada amb Grafana i Graphite
A molts desplegaments complexos se separa la capa de recopilació de mètriques de la capa de visualització. Dos projectes clau en aquest enfocament són Grafana i Graphite , tots dos de codi obert i molt estesos en entorns corporatius.
Grafana és una plataforma multiplataforma extensible mitjançant plugins, dissenyada per crear panells de visualització de dades totalment personalitzades. Permet connectar múltiples fonts de dades (Prometheus, Graphite, InfluxDB, MySQL, proveïdors cloud, etc.) i representar les mètriques a histogrames, mapes geogràfics, mapes de calor, gràfics de línies, taules i molts altres tipus de visualitzacions. Suporta anotacions en temps real, panells dinàmics i definició d'alertes amb notificacions a diferents canals.
Graphite se centra en la captura i grafificació de mètriques de sèries temporals. Pot instal·lar-se en maquinari senzill o al núvol, i resulta ideal per monitoritzar rendiment de llocs web, serveis empresarials, servidors i mètriques de xarxa . Molts equips opten per serveis gestionats basats en Graphite (com MetricFire) que afegeixen emmagatzematge en clúster, etiquetatge de dades, integracions addicionals i alertes multicanal, mentre segueixen aprofitant la potència de Graphite i, sovint, de Grafana per al frontal.
En un desplegament típic, els sistemes de xarxa i servidors envien mètriques a Graphite oa un col·lector compatible (per exemple, mitjançant protocols com StatsD), ia continuació es construeixen dashboards a Grafana per oferir una vista unificada de l'estat de tota la infraestructura: des del trànsit de cada interfície fins a la latència de consultes o l'ús de CPU per.
Altres solucions de monitorització de codi obert rellevants
L'ecosistema de monitorització open source és molt ampli i cobreix necessitats específiques com ara descobriment automàtic, supervisió de processos, pipelins d'observabilitat o recollida de mètriques des d'entorns molt heterogenis.
Per exemple, Checkmk és una plataforma altament escalable capaç de monitoritzar des de petits entorns fins a grans empreses. Inclou gestió avançada d'agents, descobriment automàtic de xarxes, visualitzacions interactives, potents sistemes d'alertes, informes de SLA, anàlisi de registres i esdeveniments, així com API per estendre'n la funcionalitat. S'ofereix en diferents edicions (RAW gratuïta, Enterprise, Cloud i MSP), adaptant-se a diferents mides i models de servei.
M/Monit se centra en la supervisió i autoreparació de sistemes Unix i Linux. Supervisa processos, ús de CPU i memòria, interfícies de xarxa i pot reaccionar automàticament davant d'errors executant accions correctives. També permet monitoritzar arrencada de serveis, escanejar fitxers i directoris a la recerca de canvis no autoritzats i comprovar connexions de xarxa a servidors locals o remots.
A l'àmbit del desxifrat de topologies de xarxa i mètriques, Pandora FMS destaca com a solució tot en un, amb monitorització de xarxa, UX, núvol, servidors i aplicacions, inventari, gestió de logs i panells personalitzables. Podeu detectar interfícies de xarxa automàticament, crear mapes, mostrar estadístiques en temps real sobre colls d'ampolla i oferir informes molt complets.
Per a arquitectures modernes de microserveis i multinúvols, Sensu es planteja com una mena de canalització d'observabilitat centralitzada que unifica diferents eines de monitorització. Ofereix comprovacions d'estat, mètriques de rendiment personalitzades, gestió de logs, gestió de problemes de xarxa i alertes multicanal amb deduplicació. A més, suporta autoreparació en executar reinicis de serveis o scripts personalitzats quan detecta problemes.
Agents, col·leccionistes i eines auxiliars
A més de les grans plataformes, hi ha eines més lleugeres la funció principal de les quals és recollir i enviar mètriques de sistemes, sensors i aplicacions cap a bases de dades o sistemes de monitorització principals.
Un exemple destacat és Telegraf , un agent escrit a Go, sense dependències externes, capaç de funcionar mitjançant un sistema de plugins molt ampli. Amb més de 300 plugins dentrada i sortida, Telegraf pot extreure mètriques i esdeveniments de piles tecnològiques molt diverses i enviar les dades a sistemes com InfluxDB, Graphite, OpenTSDB, Datadog, Llibret i altres. Els seus búfers en memòria garanteixen que les mètriques no es perdin encara que el backend principal estigui temporalment caigut.
Una altra peça important en moltes arquitectures és l'ús d' exporters i col·leccionistes específics (per exemple, a l'ecosistema de Prometheus, amb exporters per a bases de dades, servidors web, sistemes de cues, etc.), que permeten exposar mètriques en un format estàndard sense haver de reescriure cada aplicació.
Combinant agents com Telegraf, exporters especialitzats i plataformes de sèries temporals i visualització, és possible construir solucions molt completes per a monitorització de xarxa, servidors, aplicacions i núvols , completament basades en programari lliure o amb mínims components comercials quan es desitja suport oficial.
Aquest enfocament modular té l'avantatge que cada organització pot seleccionar només les peces que necessiteu , integrar-les amb els seus sistemes existents (ticketing, CMDB, SIEM, etc.) i evolucionar l'arquitectura a mesura que l'entorn creix o canvia cap a contenidors, Kubernetes o serveis serverless.
Com triar la millor eina de monitorització de xarxa de codi obert
Abans de llançar-se a instal·lar la primera eina popular convé definir amb claredat què es vol monitoritzar : només la xarxa física (routers, switches, APs), també servidors, màquines virtuals, contenidors, aplicacions o fins i tot experiència d'usuari i serveis cloud. Aquesta priorització permet acotar el ventall d'opcions i triar solucions que encaixin bé amb el cas principal.
Cal valorar les funcionalitats clau que es necessiten: informes, alertes, visualització de dades, emmagatzematge d'històriques, integració amb sistemes de tercers, API, suport per a protocols concrets (SNMP, NetFlow, WMI, API cloud, etc.). Per exemple, Prometheus és ideal quan calen mètriques personalitzades i regles d'alerta complexes; Cacti brilla en mostrar gràfics de trànsit de xarxa; Checkmk aporta visualització interactiva i informes de SLA molt complets.
La facilitat dús i configuració és un altre factor determinant. Eines com Zabbix, Netdata o Checkmk solen oferir assistents de configuració i panells més amigables, mentre que solucions molt flexibles poden exigir més feina inicial. Convé provar la interfície de descobriment de xarxa, la creació de hosts i serveis i la configuració d'alertes abans de prendre una decisió.
Pel que fa a seguretat, és imprescindible que la plataforma suporti xifrat, autenticació robusta i control d'accessos per rols . Algunes, com ara OpenNMS, Icinga o Prometheus, permeten afegir mòduls o configuracions avançades per endurir la seguretat, segmentar l'accés a dades i complir estàndards interns o normatius; a més, és recomanable complementar amb bones pràctiques de configuració avançada de tallafocs a servidors.
Finalment, és molt recomanable fer una prova de concepte (POC) amb 2 o 3 eines finalistes , desplegar-les en un entorn controlat, monitoritzar un subconjunt representatiu de la infraestructura i avaluar el rendiment, facilitat d'ús, qualitat de les alertes i capacitat d'integració amb les eines ja existents (sistemes de tiquets, CI/CD, missatgeria, etc.).
Bones pràctiques per a un monitoratge de xarxa eficaç
Un cop triada la plataforma, l'èxit depèn en gran part de com es dissenyi el desplegament. Un primer pas essencial és documentar i mapejar la xarxa : quins dispositius hi ha, on són, quins enllaços usen, quins serveis crítics donen suport i quines dependències hi ha entre ells. Això facilitarà definir què i com es monitoreja. Per entendre millor topologies i tipus de xarxes, consulta xarxes informàtiques: tipus i exemples.
Convé triar un o diversos protocols estàndard de comunicació perquè els dispositius enviïn informació a l'eina: SNMP per a equips de xarxa, agents per a servidors, exportadors Prometheus per a serveis concrets, syslog per a esdeveniments, etc. Com més homogeni sigui lenfocament, més fàcil resultarà mantenir-lo a llarg termini.
També és important definir línies base de comportament : valors normals de latència, ample de banda, CPU, memòria, connexions concurrents, etc. Això permet configurar llindars realistes i detectar anomalies amb més precisió, evitant tant les falses alarmes com la manca d'avisos davant d'incidents reals.
La configuració de panells de control clars i orientats a cada rol (operació 24×7, xarxa, sistemes, adreça, etc.) ajuda a reduir el temps de diagnòstic. Un NOC necessitarà vistes resumides i alertes en temps real; un administrador de xarxa, detall d'interfícies, errors i cues; un CIO, disponibilitat i SLA de serveis crítics.
Per acabar, és essencial definir una política d'escalat d'alertes : qui rep quin tipus d'avís, a través de quin canal i amb quina prioritat; què es fa fora dhorari laboral; què es considera incident més gran i com es coordina la resposta entre equips. Les millors eines del món perden efectivitat si ningú no atén les alarmes o si no hi ha un pla clar d'actuació.
Tenint en compte totes aquestes peces, les solucions de monitorització de trànsit de xarxa de codi obert permeten construir entorns súper robusts, amb visibilitat d'extrem a extrem, suport a la presa de decisions i una base sòlida per millorar la seguretat, disponibilitat i rendiment de qualsevol infraestructura, des d'una petita empresa fins a una gran corporació distribuïda.