- Model omnimodal nadiu amb text, imatge, àudio i vídeo, i streaming en temps real.
- SOTA a 22/36 benchmarks d'àudio/vídeo i multilingüe (119/19/10 idiomes).
- Arquitectura Thinker-Talker amb MoE, baixa latència i control per system prompts.
- Desplegament recomanat amb vLLM/Transformers, Docker i utilitats oficials.
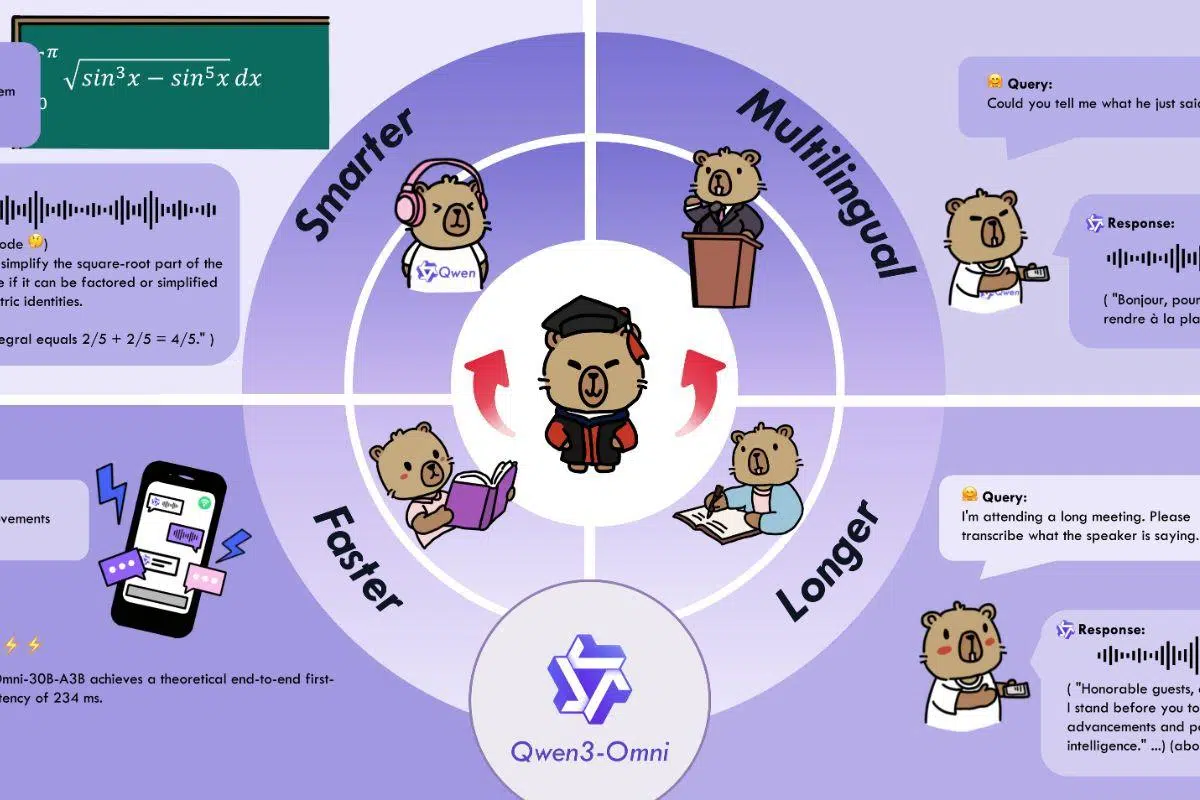
L'arribada de Qwen3-Omni ha mogut fitxa al tauler de la IA: un únic model nadiu capaç d'entendre i respondre en text, imatge, àudio i vídeo , amb respostes al vol tant escrites com parlades. No parlem de pegats multimodals, sinó d'una arquitectura pensada de base per integrar modalitats amb baixa latència i control fi del comportament.
En un moment en què gairebé tothom prova chatbots i assistents, Qwen3-Omni arriba amb ambició: suporta 119 idiomes per text, reconeix veu en 19 i parla en 10 , entén àudio llarg (fins a 30 minuts) i presumeix de mesuraments de referència en desenes de benchmarks. A més, el disseny Thinker–Talker i un enfocament Mixture of Experts apunten a velocitat de resposta i qualitat de raonament en escenaris reals.
Què és Qwen3‑Omni i què aporta
Qwen3‑Omni és una família de models fundacionals “omnimodals” i multilingües d'extrem a extrem, dissenyats per processar text, imatges, àudio i vídeo amb sortida tant en text com en veu natural. La clau no és només la varietat d'entrades i sortides, sinó el funcionament en streaming amb torns de conversa fluids i la capacitat de contestar immediatament.
L'equip ha introduït diverses millores arquitectòniques per a performance i eficiència: preentrenament primerenc “text-primer” combinat amb entrenament multimodal mixt, i un disseny amb MoE (Mixture of Experts) que manté el tipus en text i imatge mentre impulsa àudio i audiovisual. Amb això, el model arriba a SOTA a 22 de 36 benchmarks d'àudio/vídeo i SOTA open‑source a 32 de 36, amb resultats comparables a Gemini 2.5 Pro en ASR, comprensió d'àudio i conversa per veu.
Capacitats clau i modalitats
Qwen3‑Omni arriba preparat per a casos reals d‟àudio, visió i audiovisual, amb suport multilingüe ampli: 119 idiomes en text, 19 idiomes d‟entrada de veu i 10 idiomes de sortida de veu . Entre les llengües d'entrada de veu s'inclouen anglès, xinès, coreà, japonès, alemany, rus, italià, francès, espanyol, portuguès, malai, holandès, indonesi, turc, vietnamita, cantonès, àrab i urdú; i en sortida, entre d'altres, anglès, xinès, francès, alemany, rus, italià, espanyol, portuguès, japonès i coreà.
La suite de galetes oficials il·lustra l'amplitud d'usos. En àudio, es mostra reconeixement de veu (ASR) multilingüe i d'àudio llarg , traducció veu-a-text i veu-a-veu, anàlisi de música (estil, ritme, gèneres), descripció d'efectes sonors i captioning de qualsevol àudio . També admet anàlisi mixta de pistes amb veu, música i ambient.
En visió hi ha OCR "dur" per a imatges complexes, detecció i grounding d'objectes , QA sobre imatges, resolució de matemàtiques en imatge (on brilla el model de Thinking), descripció de vídeo, navegació basada en vídeo en primera persona i anàlisi de transicions d'escena . A escenaris audiovisuals, demostra QA audio-vídeo amb alineament temporal, interacció guiada amb entrades AV i diàlegs amb comportament d'assistent.
Com a agent, destaca la capacitat de function calling a partir d'àudio , cosa que obre workflows de veu que activen eines, i en tasques derivades existeix un Omni-Captioner per subtitular amb gran detall, que evidencia la capacitat de generalització del fundacional.
Arquitectura Thinker-Talker i disseny amb MoE
Una de les idees diferencials és separar responsabilitats: el Thinker genera el text (amb variants amb raonament explícit tipus chain-of-thought), i el Talker produeix àudio en temps real. Aquest desacoblament permet mantenir una conversa natural amb veu mentre el sistema conserva un alt nivell de comprensió i planificació en text.
La base MoE reparteix la càrrega entre experts i es recolza en un preentrenament AuT per a representacions generals potents. A més, l'ús d'una codificació multicodi al canal d'àudio redueix la latència al mínim, cosa clau per a trucades o assistents on cada centèsima de segon compte.
Rendiment i benchmarks: text, visió, àudio i audiovisual
Qwen3‑Omni manté prestacions capdavanteres en text i imatge sense degradar respecte a models Qwen de la mateixa mida enfocats en una sola manera, mentre que en àudio i audiovisual marca el ritme en la majoria de proves . A la bateria de 36 benchmarks d'àudio i audiovisual aconsegueix SOTA open‑source en 32 i SOTA total en 22, superant en diversos punts Gemini 2.5 Pro i GPT‑4o.
Algunes fites destacades en text: a AIME25 la variant Flash‑Instruct ronda el 65,9; a ZebraLogic l'Instruct arriba al 90, ia MultiPL‑E arriba a xifres competitives davant de GPT‑4o. En tasques d'alineament com ara IFEval i WritingBench, els models Instruct i Thinking mostren puntuacions altes i consistents.
En àudio, els resultats a ASR per a xinès i anglès són excel·lents: a WenetSpeech i LibriSpeech redueix la taxa d'error de paraula de forma notable, amb xifres properes a l'1,22/2,48 a LibriSpeech clean/other, i en conjunts com FLEURS (multilingüe) ofereix taxes molt baixes. A VoiceBench, mètriques com AlpacaEval, CommonEval i WildVoice situen Qwen3‑Omni a l'alçada de sistemes tancats de referència, i en raonament sobre àudio destaca a MMAU v05.15.25.
En audiovisual, la dada que més se cita és WorldSense ≈54,1 , per sobre de Gemini‑2.5‑Flash; a més, en conjunts com DailyOmni i VideoHolmes, la variant Thinking aconsegueix millores respecte a previs SOTA open‑source. En visió pura, brilla en MMMU, MathVista, MathVision i comprensió de documents (AI2D, ChartQA), amb molt bons números a counting (CountBench) i en comprensió de vídeo (Video‑MME, MLVU).
La generació de veu zero‑shot també està mesurada: davant de famílies com CosyVoice i Seed‑TTS, Qwen3‑Omni registra millor consistència de contingut en diversos idiomes i alta similitud de locutor . A la part multilingüe, la taula de “Content Consistency” i “Speaker Similarity” mostra Qwen3‑Omni 30B‑A3B molt competitiu en xinès i anglès, i sòlid en alemany, italià, portuguès, espanyol, japonès, coreà, francès i rus. En cross-lingual TTS , obté millors WER/consistències en diversos parells (ex., zh→en, ja→en, ko→zh) comparat amb CosyVoice 2/3.
Models disponibles i per a què serveix cadascun
La línia Qwen3‑Omni inclou tres peces principals, cadascuna pensada per a un tipus d'ús: Instruct , Thinking i Captioner . Totes parteixen del mateix tronc però amb diferents capacitats activades o afinades per a tasques concretes.
Qwen3‑Omni‑30B‑A3B‑ Instruct conté Thinker i Talker, accepta àudio, vídeo i text i torna text i àudio. És l'indicat si vols interacció completa i resultats parlats en temps real, i és el que es recomana per a donem amb veu o vídeo.
Qwen3‑Omni‑30B‑A3B‑ Thinking se centra en el Thinker amb raonament en cadena , suporta àudio, vídeo i text amb sortida textual. És útil per a anàlisis exhaustives, resolució de problemes complexos, matemàtiques en imatge o fluxos on no necessites sortida de veu però sí el millor pensament estructurat.
Qwen3-Omni-30B-A3B- Captioner és un derivat afinat en subtitulat d'àudio d'alta precisió i baixa al·lucinació. Està obert, cobreix àudios arbitraris amb gran detall i tanca una bretxa històrica a l'ecosistema open‑source: captions fiables i rics per a àudio generalista.
Latència, temps real i control del comportament
El sistema està optimitzat per a interacció instantània, amb xifres de ≈211 ms en àudio i ≈507 ms en àudio-vídeo . A més del streaming, s'emfatitza la naturalitat en els torns de conversa i l'estabilitat en el lliurament de veu, cosa que contribueix al rol clar entre Thinker (text) i Talker (veu).
Per filar fi, podeu personalitzar l'estil amb system prompts . En escenaris AV on l'àudio del vídeo fa de consulta, l'equip proposa un prompt de sistema que manté el raonament del Thinker i un text més llegible i conversacional, facilitant que el Talker vocalitzi de forma fluida . També se suggereix mantenir coherent el paràmetre use_audio_in_video al llarg d'una conversa multi-torns.
En avaluació, hi ha guies específiques: no establir system prompt , seguir el format ChatML de cada benchmark i, quan no hi hagi prompt, utilitzar els següents per defecte: ASR xinès (“请将这段中文语音转换为纯文本。”), ASR altres idiomes (“Transcribe the audio into into <source_language> speech …”), i lletres de cançons (“ Transcribe the song lyrics” … sense puntuació, línies separades per salts»).
Desplegament, requisits i eines
Per a una experiència completa local, l'equip recomana Hugging Face Transformers i revisar les fases de l'enginyeria de programari , però compte: en ser arquitectura MoE, pot anar lent amb HF en inferència; per a producció o baixa latència , aconsellen utilitzar vLLM o l'API DashScope , i fins i tot proporcionen una imatge Docker que inclou entorns per a tots dos. El codi de Transformers ja està fusionat, però el paquet PyPI encara no s'ha publicat i cal instal·lar-lo des de font.
Proveeixen utilitats per manejar àudio i imatge/vídeo (base64, URLs, entrades intercalades), i recomanen FlashAttention 2 amb Transformers per reduir memòria GPU sempre que carreguis en float16 o bfloat16 . Amb vLLM, FlashAttn2 ve inclòs, i es detallen paràmetres com limit_mm_per_prompt (preassigna memòria a GPU) i max_num_seqs per a paral·lelisme; a més, pujar tensor_parallel_size permet inferència multi-GPU.
Hi ha detalls útils per estalviar recursos: si no necessites àudio, pots desactivar el Talker després d'inicialitzar, estalviant ~10 GB de VRAM. I si vols resultats de text més veloços, fes servir return_audio=False en la generació. També es proporcionen valors teòrics mínims de memòria per a BF16 amb FlashAttn2: per exemple, l'Instruct 30B‑A3B ronda ~78,9 GB amb vídeo de 15 s i ~144,8 GB amb 120 s; el Thinking baixa a ~68,7 GB i ~131,7 GB respectivament.
Per aixecar un demo web local, recomanen preparar l'entorn de vLLM (o Transformers, més lent), assegurar que tens ffmpeg i fer servir els seus scripts. Ofereixen imatges Docker “qwenllm/qwen3‑omni” llistes per a GPU amb NVIDIA Container Toolkit , mapeig de ports (ex. amfitrió 8901 → contenidor 80) i la indicació de servir a 0.0.0.0. Es pot tornar al contenidor o eliminar-lo quan toqueu.
Donem, API i ecosistema
Si no vols desplegar en local, pots provar donem a Hugging Face Spaces i ModelScope Studio , amb experiències per Qwen3-Omni-Realtime, Instruct, Thinking i el Captioner. També està disponible Qwen Xat amb streaming en temps real: només cal triar l'opció de trucada de veu/vídeo a la interfície.
Per integrar a escala i amb baixa latència, la via recomanada és l' API de DashScope , que ofereix el rendiment més predictible. A més, la comunitat es coordina per canals com Discord i WeChat , i publiquen cookbooks amb logs reals d'execució que permeten reproduir resultats canviant prompts o models.
Full de ruta i millores en curs
L'equip treballa en funcions addicionals com ara reconeixement de veu multiparlant , OCR aplicat a vídeo, millores en aprenentatge proactiu audiovisual i fluxos d'agents més rics. També han indicat que el suport de sortida d'àudio a vLLM per al model Instruct arribarà ben aviat, cosa que tancarà el cercle del desplegament realtime des d'aquest backend.
Preguntes habituals: suport en runtimes i quantització
Algun usuari ha comentat que no pot córrer Qwen3‑Omni encara amb els “sospitosos habituals” i que no veu quants a Hugging Face ; a més, el format nadiu de 16 bits ronda els 70 GB, una mida complicada per a equips modestos. El propi projecte aclareix que Transformers ja està mergeat però sense paquet PyPI , que cal instal·lar des de font, i que vLLM és l'opció preferent per a inferència, si bé el suport d'àudio d'Instruct a vLLM s'alliberarà a curt termini.
Sobre quantització, encara no es llisten placeholders preparats en HF per a Qwen3‑Omni 30B‑A3B, i convé recordar que la naturalesa MoE i multimodal complica la compatibilitat immediata amb runtimes com anomena.cpp. Per a qui necessiti provar ja, la recomanació oficial és fer servir Docker + Transformers/vLLM des de font o l' API , i vigilar el repo per als PR de suport i futures quants quan estiguin llistes.
Bones pràctiques d'avaluació i prompts
De cara a reproduir els números, es detallen pautes: a la majoria de benchmarks s'usa greedy decoding a Instruct sense mostreig, i per a Thinking cal respectar els paràmetres del generation_config.json . També es fixa el vídeo a fps=2 en avaluació, i s'indica que el prompt d'usuari ha d'anar després de les dades multimodals llevat que el conjunt especifiqui el contrari.
Quan un benchmark no inclou prompt, es poden fer servir els proposats per defecte (ASR xinès/altres, S2TT, lletres de cançons). A més, no cal establir system prompt en avaluació, perquè els resultats siguin comparables entre sistemes i execucions.
Qwen3‑Omni es posiciona com una plataforma omnimodal real, amb latència continguda, cobertura multilingüe àmplia, resultats capdavanters en àudio i audiovisual i una ruta de desplegament clara mitjançant Transformers, vLLM i Docker. Per a qui busqui un únic model que raoni bé en text i imatge sense perdre força i que, a més, escolti, parli i entengui vídeo , és una proposta difícil d'igualar avui dia.