- Základní rozlišení mezi fází trénování modelu a fází inference pro generování komerční hodnoty.
- Analýza architektur nasazení: od centralizovaného cloudového zpracování k edge computingu (Edge AI).
- Vyhodnocení technických hardwarových požadavků, zejména důležitosti VRAM v GPU pro provádění modelů.
- Optimalizační strategie, jako je kvantizace a použití modelů malých jazyků (SLM), pro zlepšení provozní efektivity.

Když mluvíme o umělé inteligenci, většina lidí si představí masivní procesy učení a superpočítače zpracovávající biliony datových bodů. Existuje však část procesu, kde se odehrává skutečná magie pro podnikání: inference. V podstatě se jedná o okamžik, kdy se umělá inteligence přestane učit a začne pracovat, aplikuje vše, co se naučila, k řešení problémů reálného světa a k rozhodování na základě dat, která nikdy předtím neviděla.
V dnešní době se firmy posunuly od pouhého vnímání umělé inteligence jako laboratorního experimentu k základní součásti svého každodenního provozu. Nejde už jen o vytvoření co nejvýkonnějšího modelu, ale o to, jak jej spolehlivě, bezpečně a především ziskově provozovat, a přesunout tak pracovní zátěž z teorie do aktivní produkce v hybridních prostředích.

Trénování vs. inference: Není to totéž
Aby se předešlo nejasnostem, je důležité jasně rozlišovat mezi těmito dvěma fázemi. Trénink je pro umělou inteligenci jako školní léta; je to intenzivní proces, kdy model analyzuje historická data a popisky, aby našel vzory. Ve velkých datových centrech se používají výkonné hardwarové akcelerátory , jako jsou GPU nebo TPU , a doba odezvy není prioritou, protože proces může trvat dny nebo týdny.
Inference je naproti tomu finální test aplikovaný v reálném čase. Je to proces provádění, kdy model přijímá vstup (fotografii, text nebo údaj ze senzoru) a vrací okamžitý výsledek. V této fázi se latence stává kritickou a klíčová je efektivita. Zatímco školení pokládá základy, inference je to, co generuje přímou ekonomickou hodnotu pro organizaci.
Strategie nasazení: Cloud, On-premises a Edge
Neexistuje jediný způsob, jak provádět inferenci. V závislosti na naléhavosti a objemu dat si firmy vybírají z několika přístupů. Dávková inference je ideální pro rozsáhlé, neurgentní úkoly, jako je finanční analýza přes noc nebo rozsáhlá kategorizace dokumentů, kde se data zpracovávají v cloudu a výsledky se vracejí později.

Pak tu máme inferenci v reálném čase , nezbytnou pro chatboty nebo systémy pro detekci podvodů, kde musí odpověď dorazit v milisekundách. Ačkoli cloud zůstává dominantní možností díky své škálovatelnosti, začíná se projevovat jeho omezení v důsledku latence sítě a vysokých nákladů na šířku pásma při zpracování terabajtů dat.
A právě zde přichází na řadu edge inference neboli Edge AI . Zpracováním dat přímo na zařízení (senzoru IoT, robotovi nebo chytrém telefonu) se dosahuje extrémně nízké latence a výrazně většího soukromí, protože citlivé informace nemusí putovat na vzdálený server. To je zásadní v odvětvích, kde může být zpoždění v řádu milisekund kritické, jako je autonomní řízení nebo telechirurgie.
Inference rostlin a Průmysl 4.0
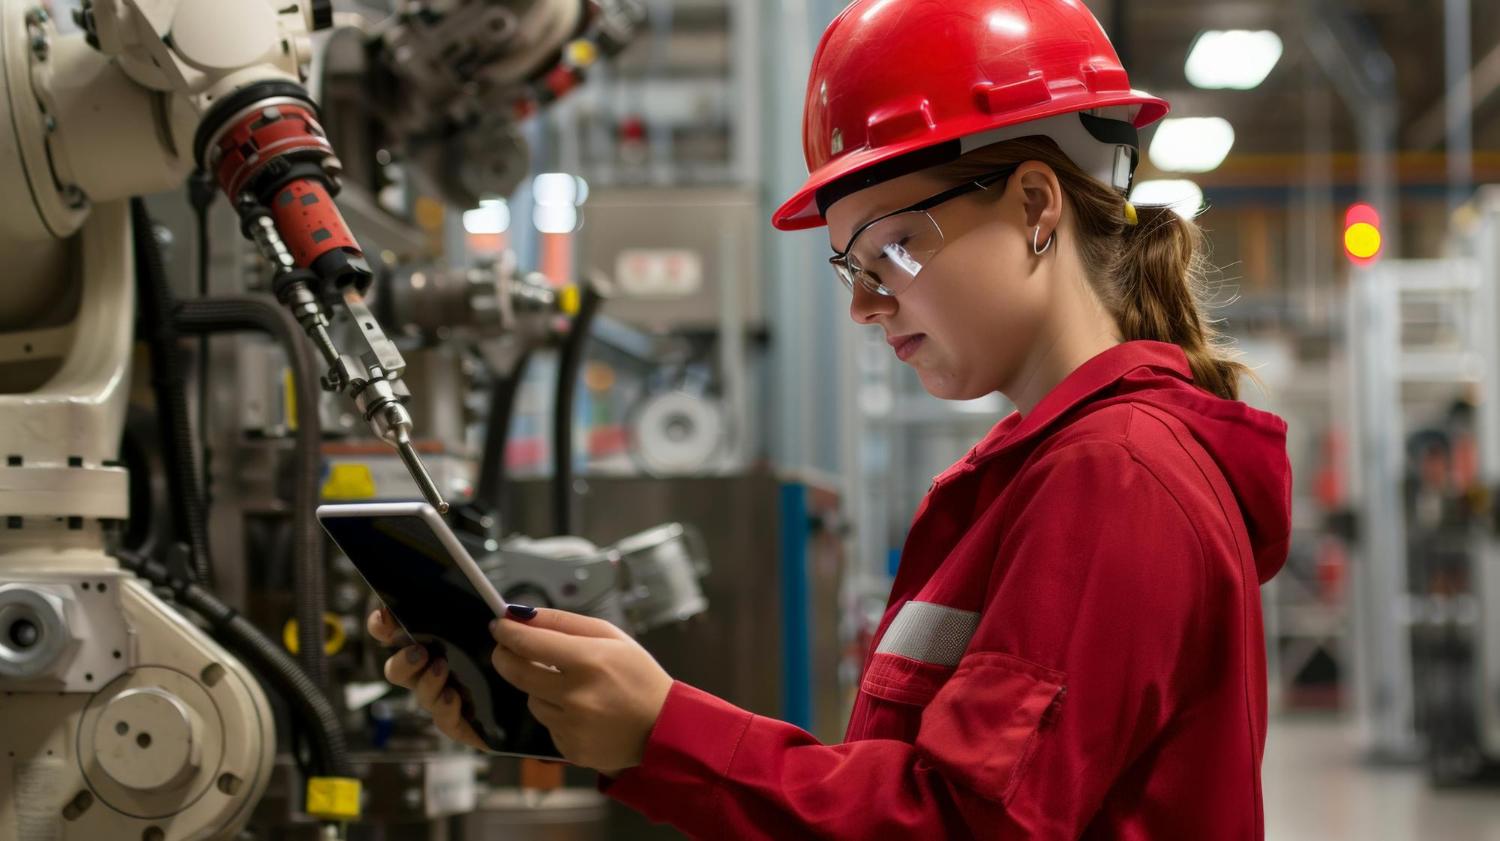
Ve výrobním sektoru je inferenční technologie skutečným klenotem. Umožňuje strojům činit inteligentní rozhodnutí okamžitě, aniž by se musely spoléhat na internetové připojení. To se promítá do kontroly kvality v reálném čase , kdy se detekují vadné díly na montážní lince dříve, než se stanou zbytečným nákladem.

Dále tvoří základ prediktivní údržby . Modely umělé inteligence analyzují stav zařízení v reálném čase a poskytují včasná varování dříve, než dojde k poruše, čímž zabraňují zastavení výroby, které by stálo tisíce eur. V potravinářském a elektronickém průmyslu to zajišťuje, že konečný produkt vždy splňuje nejpřísnější standardy kvality.
Technické požadavky a optimalizace modelu
Pokud se společnost rozhodne spouštět inferenci lokálně, klíčový je hardware. GPU jsou nezbytné kvůli své paralelní architektuře. Nejdůležitějším faktorem není jen hrubý výkon, ale i VRAM (videopaměť); pokud se model vejde výhradně do VRAM, doba odezvy prudce vzroste. Jinak se systém spoléhá na konvenční RAM, což vše značně zpomaluje.
Aby tyto modely fungovaly na omezeném počtu zařízení, používají se optimalizační techniky. Kvantizace snižuje přesnost vah modelu (například z 32 na 4 bity), čímž se soubor výrazně zmenší a zrychlí, aniž by se snížila přílišná přesnost. Na druhou stranu LoRA (Low-Rank Adaptation) umožňuje adaptovat velké modely na specifické úlohy bez nutnosti přetrénovat celý model, což je mnohem levnější a rychlejší.

Stále více se prosazují i modely s malým jazykem programování (SLM) . Na rozdíl od masivních LLM jsou SLM navrženy tak, aby byly efektivní a lehké, což z nich činí perfektní doplněk pro edge hardware. Pro řešení fragmentace hardwaru se používá WebAssembly (Wasm) , který umožňuje AI běžet téměř nativní rychlostí na jakémkoli zařízení bez ohledu na jeho procesor.
Nástroje pro správu, bezpečnost a provoz
Přesun umělé inteligence do produkčního prostředí znamená, že už to není jen hra, ale kritická pracovní zátěž. Mnoho společností již působí v hybridních nebo multicloudových prostředích , což vyžaduje implementaci přísných kontrol směrování a zabezpečení. Řízení se nyní zaměřuje na vrstvy prompts, tokenů a API, kde je správa zabezpečení ve vývojových prostředích umělé inteligence klíčová pro prevenci úniků dat.
Pro ty, kteří chtějí experimentovat s lokální inferencí, je k dispozici několik velmi výkonných nástrojů. LM Studio je vynikající volbou pro uživatele, kteří hledají jednoduché grafické rozhraní a kompatibilitu s modely Hugging Face. Pro vývojáře je Ollama klíčovým nástrojem, protože je open source a umožňuje velmi efektivně využívat lokální umělou inteligenci na vašem počítači prostřednictvím kontejnerů Docker.

Existují i další zajímavé alternativy, jako je Llama.cpp pro širokou podporu hardwaru, nebo Jan pro ty, kteří upřednostňují 100% offline prostředí. Existují dokonce i aplikace pro chytré telefony, jako je PocketPal, které vám přinášejí inferenci přímo do kapsy a dokazují, že umělá inteligence již k užitečnosti nutně nepotřebuje superpočítač.
Trend je jasný: umělá inteligence se posouvá směrem k distribuovanému modelu. Budoucnost nespočívá v jediném centralizovaném mozku v cloudu, ale v inteligentní inferenční síti rozprostřené napříč datovými centry a lokálními zařízeními. Tato hybridní architektura umožňuje rovnováhu mezi výpočetním výkonem, potřebou okamžitých reakcí a ochranou soukromí firemních dat.
