- Architektonické rozdíly mezi CPU a GPU, které umožňují masivní paralelní výpočty.
- Strategie nasazení cloudu s využitím standardních, spotových a flexibilních modelů zřizování.
- Kritická technická kritéria pro výběr hardwaru na základě VRAM, šířky pásma a latence.
- Pokročilé programovací a globální orchestrační systémy pro optimalizaci využití clusterů umělé inteligence.

Když mluvíme o surovém výkonu pro přesun hor dat, nelze nezmínit zásadní roli, kterou hrají grafické procesory. Ačkoli byly původně navrženy tak, aby videohry vypadaly neuvěřitelně, dnes jsou hlavním motorem umělé inteligence a masivní analýzy dat, což umožňuje úkoly, které dříve trvaly týdny, dokončit během několika hodin.
Přesun těchto úloh do cloudu znamenal pro vývojáře a datové vědce zásadní změnu. Už není nutné utrácet jmění za hardware, který rychle zastarává; místo toho si můžeme pronajmout výpočetní kapacitu přizpůsobenou našim skutečným potřebám, škálovat zdroje podle projektu a optimalizovat každou korunu investovanou do infrastruktury.

CPU vs. GPU: Jaký je skutečný rozdíl?
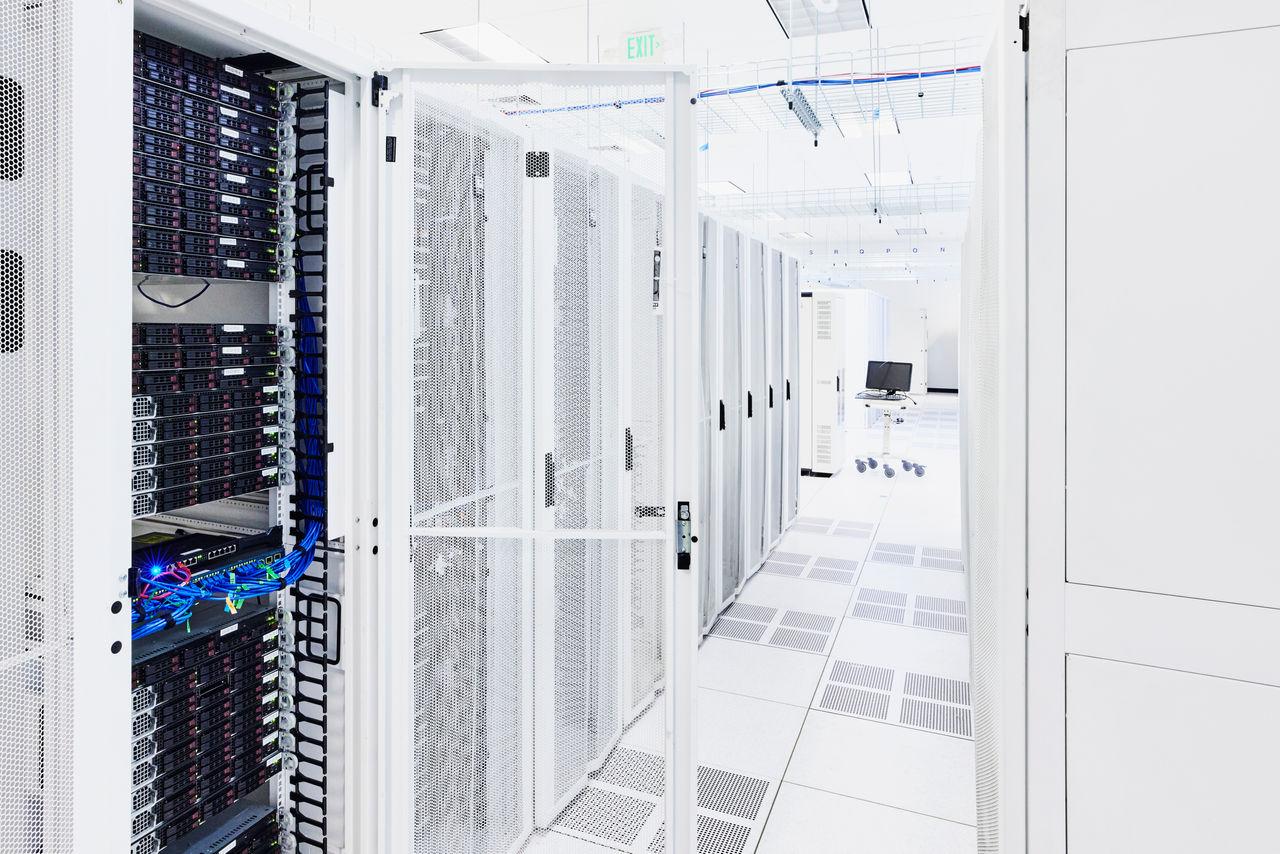
Jednoduše řečeno, CPU je jako vysoce inteligentní dirigent, který dokáže všechno, ale zpracovává úlohy jeden po druhém. Naproti tomu GPU je jako armáda tisíců pracovníků specializovaných na provádění stejných matematických operací znovu a znovu, ale současně. To je základ toho, čemu říkáme paralelní výpočty.
Zatímco CPU zvládá složitou logiku a řízení systému, GPU vyniká ve zpracování matic a vykreslování obrazu. Díky stovkám nebo tisícům jader , podobně jako vícejádrová architektura CPU , ale v masivním měřítku, dokáže provádět více podmnožin úlohy současně – což je nezbytné pro trénování neuronových sítí nebo zpracování terabajtů dat bez pádu systému.
Dávková správa úloh a správa úloh v reálném čase
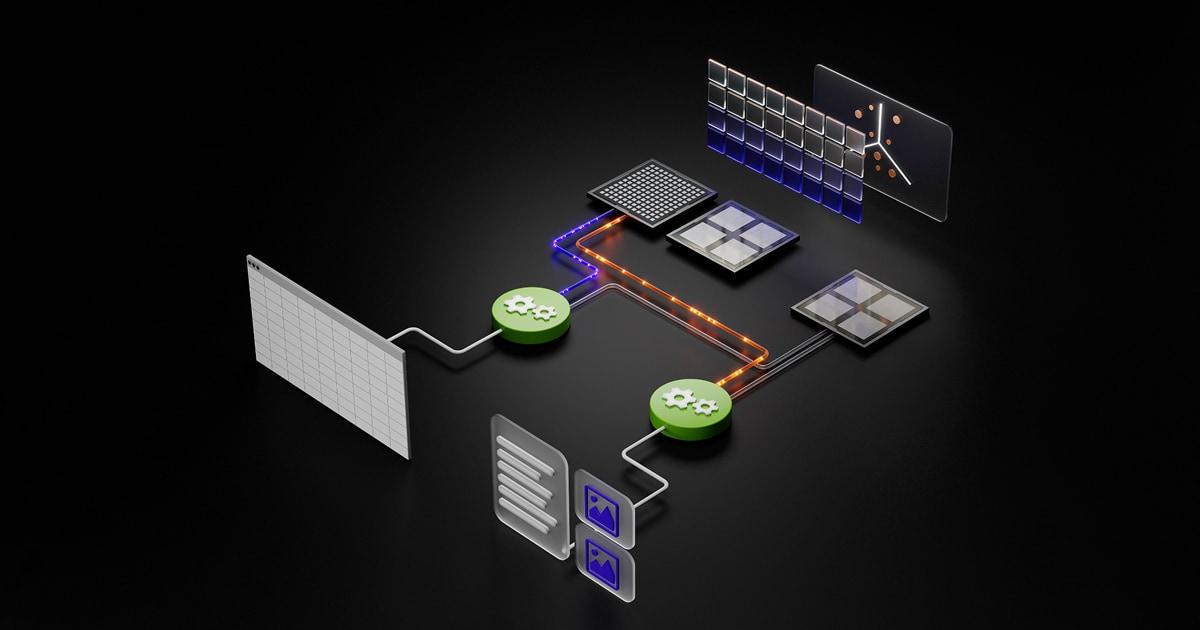
V cloudovém ekosystému existují dva hlavní způsoby, jak tyto úkoly provádět. Dávkové zpracování je ideální pro úlohy, které nevyžadují okamžitou odezvu, jako je předzpracování dat nebo masivní inference. Cílem je zde maximalizovat efektivitu a celkový výkon systému tím, že se úlohy mohou akumulovat a spouštět, když jsou k dispozici zdroje.
Na druhou stranu je zpracování v reálném čase klíčové pro aplikace, které potřebují reagovat okamžitě, jako jsou generativní chatboti s umělou inteligencí nebo rozpoznávání obličejů. V těchto případech je absolutní prioritou nízká latence a vysoká dostupnost, což zajišťuje, že si koncový uživatel nevšimne žádných zpoždění, zatímco model zpracovává informace.
Pro nastavení takového projektu je plánování požadavků zásadní. Od výběru správného stroje až po instalaci ovladačů (která může být automatická nebo manuální pomocí vlastních obrazů) každý krok ovlivňuje, zda bude proces hladký, nebo zda bude představovat technickou komplikaci.
Modely spotřeby a optimalizace nákladů
Ne všechny virtuální stroje jsou si rovny a ani všechny nestojí stejně. Pro ty, kteří chtějí ušetřit peníze, jsou lákavou volbou spotové virtuální stroje , které nabízejí obrovské slevy, i když s sebou nesou riziko, že si je cloud kdykoli vezme zpět. Jsou ideální pro úlohy odolné vůči chybám, kde jsou prioritou náklady.
Pokud potřebujete něco stabilnějšího, ale se slevou, existují flexibilní spouštěcí virtuální počítače , které umožňují přístup k prostředkům GPU za snížené ceny výměnou za několikadenní zpoždění před zahájením práce. Pro kritické projekty jsou k dispozici standardní on-demand provisioning nebo plánované rezervace , které zaručují, že hardware bude k dispozici přesně tehdy, když ho potřebujete.

Pokročilou technikou pro maximalizaci rozpočtu je regionální arbitráž nákladů . Využití cenových rozdílů v různých geografických oblastech nebo plánování „podle slunce“ umožňuje týmům v Asii, Evropě a Americe střídat se v používání clusterů a dosáhnout tak téměř 100% využití hardwaru.
Jak vybrat správnou grafickou kartu pro váš případ použití

Nejde o výběr nejdražší karty, ale o tu, která nejlépe vyhovuje danému úkolu. V trénování modelů velkých jazyků (LLM) je hlavním úzkým hrdlem videopaměť (VRAM) . Pokud vám dojde VRAM, budete muset zmenšit velikost dávek, což výrazně zvýší dobu provádění a celkové náklady.
- Školení umělé inteligence: Vyžaduje vysoký výkon ve smíšené přesnosti (FP16/BF16) a velkou paměť VRAM pro zpracování gradientů a stavů optimalizátoru.
- Inference v reálném čase: Zde jsou klíčem k prevenci výpadků produkce síťová latence a stabilita softwarového zásobníku.
- Data Science: Hledá se rovnováha mezi CPU, RAM a GPU, protože velká část čištění dat je stále sekvenční úkol.
- 3D rendering a vizuální efekty: Pro rychlý pohyb složitých textur a geometrií jsou kriticky závislé na šířce pásma paměti.
- Vědecké výpočty: Upřednostňují přesnost FP32 nebo FP64 a přesnou reprodukovatelnost výsledků prostřednictvím pevných verzí ovladačů.
Je nezbytné sledovat tok dat v systému . Mít ultravýkonnou grafickou kartu je zbytečné, pokud je procesor nebo úložiště pomalé; v takovém případě bude grafická karta většinu času nečinná a čeká na data, což se nazývá nedostatečné využití zdrojů.
Pokročilá orchestrace a budoucnost výpočetní techniky
S růstem klastrů již nefunguje jednoduché plánování „první dovnitř, první ven“. Přední společnosti zavádějí víceúrovňové hierarchie plánování , které rozdělují úlohy na základě umístění dat, obchodních priorit a uhlíkové stopy regionu.

Inovace, jako je přepínání CPU/GPU v reálném čase, umožňují systému za chodu rozhodovat, který procesor je pro každé vlákno nejefektivnější. To řeší globální nedostatek hardwaru optimalizací každého dostupného taktu, což umožňuje generativní umělé inteligenci a digitálním dvojčatům rozvíjet se, aniž by je blokoval nedostatek čipů.
Použití Kubernetes s technologií Dynamic Resource Allocation (DRA) a Multi-Instance GPU (MIG) umožňuje rozdělit jednu fyzickou grafickou kartu do více virtuálních instancí. To demokratizuje přístup k vysoce výkonným výpočtům a umožňuje více uživatelům sdílet stejnou GPU, aniž by se vzájemně rušili.
Jediný způsob, jak se vyhnout plýtvání penězi za cloud computing, je mít jasnou strategii, která kombinuje správný hardware, chytrý platební model a flexibilní orchestraci. Od výběru VRAM až po nasazení spotových instancí má každé technické rozhodnutí přímý dopad na rychlost inovací a ziskovost jakéhokoli pokročilého výpočetního projektu.
