- Kritická zranitelnost v NLTK (CVE-2026-0848) umožňuje vzdálené spuštění kódu a ovlivňuje systémy umělé inteligence a zpracování přirozeného jazyka.
- Běžné chyby instalace a konfigurace Pythonu (cesta, verze, prostředí) způsobují selhání importu a problémy s knihovnami.
- Ekosystém PyPI utrpěl vydání tisíců škodlivých balíčků, což zdůrazňuje rizika v dodavatelském řetězci softwaru.
- Kombinace osvědčených bezpečnostních postupů, aktualizací knihoven a důsledné správy závislostí je nezbytná pro snížení těchto rizik.
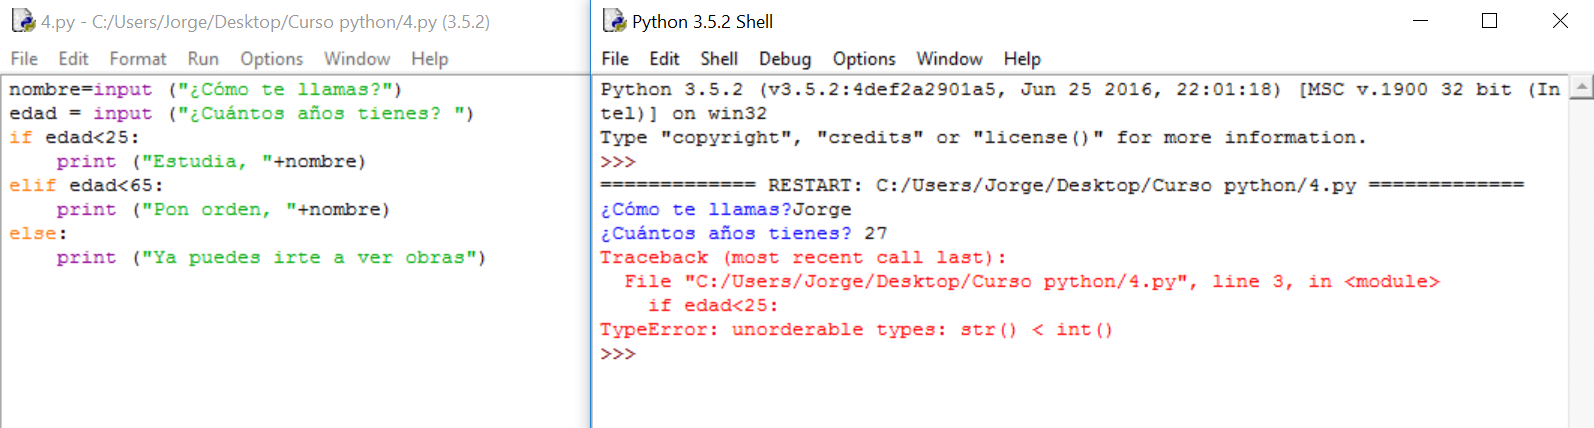
Když mluvíme o chybě v knihovně Pythonu , nemáme na mysli jen jednu chybu, která naruší fungování skriptu: v mnoha případech se může stát přímým vstupním bodem pro útoky, frustrující problémy s instalací nebo dokonce velkou bolestí hlavy kvůli jednoduché, špatně napsané závislosti. Python je praktický a všudypřítomný, což znamená, že jakýkoli zádrhel, ať se zdá jakkoli malý, může mít obrovský dopad na umělou inteligenci, zpracování přirozeného jazyka a webové vývojářské projekty.
V poslední době se objevily případy sahající od kritických zranitelností zahrnujících vzdálené spuštění kódu až po škodlivé balíčky skryté v oficiálním indexu Pythonu a zdánlivě absurdní chyby v knihovnách tak neškodných, jako je ovladač jasu obrazovky. To vše vykresluje obraz, kdy pouhá instalace závislosti a zapomenutí na ni nestačí: musíme pochopit, co se děje „pod kapotou“, jak jsou knihovny distribuovány a jaké osvědčené postupy nás mohou ušetřit vážných problémů.
Kritická chyba v NLTK: zranitelnost CVE-2026-0848
Jedním z nejvýraznějších případů je kritická chyba v knihovně NLTK , která je v ekosystému Pythonu dobře známá pro své použití v úlohách zpracování přirozeného jazyka . Pod identifikátorem CVE-2026-0848 byla popsána zranitelnost, která přímo ovlivňuje prostředí, kde se používají systémy pro analýzu textu, a obecně aplikace založené na umělé inteligenci a NLP.
Tato zranitelnost umožňuje vzdálené spuštění kódu (RCE) , což znamená, že útočník může vynutit libovolné spuštění vlastního kódu na počítači s NLTK. Z hlediska kybernetické bezpečnosti se jedná o jeden z nejzávažnějších scénářů, které mohou u široce používaného softwaru nastat, protože nejenže dochází k úniku dat, ale může také poskytnout efektivní kontrolu nad napadeným systémem.
Znepokojivé je, že NLTK zůstává standardní závislostí v nesčetných projektech, zejména v kontextu, kdy je umělá inteligence integrována do nejrůznějších služeb. To znamená, že mnoho produkčních prostředí, notebooků, API a systémů strojového učení může být odhaleno, aniž by si jejich vývojáři byli plně vědomi skutečného rizika, které tato zranitelnost představuje.
Vzestup zpracování přirozeného jazyka vedl k tomu, že jsme obklopeni aplikacemi, které neustále spotřebovávají text: virtuální asistenti, klasifikační systémy, analýza názorů a mnoho dalšího. Ve všech těchto případech se zranitelnost v široce používané knihovně Pythonu může stát klíčovým prvkem útoku na dodavatelský řetězec nebo širšího narušení infrastruktury.
V konečném důsledku není explozivní kombinace RCE s populární knihovnou, jako je NLTK, jen technickým problémem; je to také připomínka toho, že slepá důvěra v závislosti může mít velmi vysokou cenu, pokud se s ní nezachází opatrně.
Kde je chyba a jak se zneužívá?
Problém v chybě CVE-2026-0848 pramení ze způsobu, jakým knihovna NLTK zpracovává určité externí zdroje . Za určitých podmínek může knihovna načítat soubory bez řádného ověření jejich původu nebo obsahu, což vytváří nebezpečnou zranitelnost v datovém toku aplikace.
V praxi to znamená, že soubor manipulovaný útočníkem může být NLTK považován za legitimní zdroj. Pokud aplikace těmto externím zdrojům důvěřuje bez dalších filtrů, mohl by se škodlivý kód vložený do tohoto souboru spustit přímo v systému a spotřebovat data.
Tento scénář nevyžaduje žádné dramatické nastavení: v mnoha současných prostředích – jako jsou API, interaktivní poznámkové bloky, automatizované analytické služby nebo kanály strojového učení – jsou data přijímána a zpracovávána automaticky. Pokud je jeden ze zdrojů těchto dat ohrožen, může útočník tuto zranitelnost v knihovně Pythonu zneužít k vložení svého datového zatížení, aniž by kdokoli musel stisknout tlačítko nebo cokoli ručně spustit.
Navíc je mnoho z těchto systémů nasazeno na serverech s širokými oprávněními a přístupem k citlivým zdrojům . To znamená, že zneužití zranitelnosti RCE (Real-Time Enterprise) prostřednictvím NLTK (Network Linked Key) je více než jen postrach: může vést ke krádeži dat, modifikaci modelu, sabotáži interních procesů nebo implementaci zadních vrátek pro následné útoky.
Jádrem problému je, že při práci s knihovnami, které „dělají všechno za nás“, se často přehlíží ověření externích zdrojů . Pokud předpokládáme, že závislost je bezpečná, aniž bychom auditovali, jak nakládá se zdroji, které jí poskytujeme, riskujeme, že se z užitečné funkce stane ideální vektor útoku.
Proč je tato zranitelnost dnes tak relevantní
Kontext, ve kterém se objevuje chyba CVE-2026-0848, činí její potenciální dopad obzvláště citlivým. Využívání knihoven pro NLP a umělou inteligenci prudce vzrostlo a NLTK, navzdory vzniku modernějších alternativ, zůstává zakořeněna v mnoha projektech, tutoriálech, vzdělávacích repozitářích a produkčních systémech.
Tento typ zranitelnosti představuje velmi specifické riziko: důvěryhodná knihovna by se mohla stát slabým článkem útoku v dodavatelském řetězci. Jinými slovy, útočník by se nemusel zaměřit přímo na naši aplikaci, ale spíše na mezilehlou komponentu, kterou všichni používají a které si téměř nikdo nevšimne, dokud se něco nepokazí.
Toto jsme již viděli u jiných ekosystémů: JavaScript a npm, Ruby a RubyGems a samozřejmě samotný PyPI v ekosystému Pythonu . Vzor se opakuje: čím více důvěřujeme repozitáři a čím více automatizujeme instalaci balíčků, tím atraktivnější se stává pro ty, kteří chtějí nasazovat systémy ve velkém měřítku.
Skutečnost, že zranitelnost NLTK umožňuje vzdálené spuštění kódu, znásobuje její závažnost. Nemluvíme o chybě, která „pouze“ uniká informace nebo způsobuje pády; jedná se o vektor, který může poskytnout úplnou kontrolu nad postiženým strojem se všemi důsledky, které to má v produkčním prostředí, datové infrastruktuře nebo podnikových sítích.
Proto, ačkoli okamžité řešení zahrnuje aktualizovat NLTK na opravenou verziZákladní debata se více týká bezpečnostní kultury a toho, jak zacházíme se závislostmi: auditování, izolace, omezování oprávnění a kontrola nad rámec jednoduchých pip install posun.
Zmírnění a osvědčené postupy pro selhání knihoven Pythonu
Prvním krokem ke zmírnění zranitelnosti, jako je CVE-2026-0848, je poměrně jednoduchý: nainstalujte verzi NLTK, která obsahuje opravu , nebo pokud se tak nestane, přestaňte používat postižené verze. Aktualizace knihoven je minimálním opatřením, abyste se zbytečně nevystavovali již zdokumentovaným zranitelnostem.
Nicméně, zastavit se u toho nestačí. Tyto typy incidentů zdůrazňují potřebu přehodnotit, jak v našich aplikacích nakládáme s externími zdroji . Kdykoli jsou načítány soubory, modely, korpusy nebo jakýkoli jiný typ dat zvenčí, je nezbytné ověřit jejich původ, formát a obsah, aby se minimalizoval manévrovací prostor útočníka.
Další doporučenou vrstvou ochrany je spouštět nejcitlivější procesy v izolovaných prostředích, jako jsou kontejnery nebo virtuální počítače . Pokud kód, který zpracovává text a modely NLP, běží v prostředí s velmi omezenými oprávněními, bude mít i zneužití RCE mnohem kontrolovanější dopad, bez přímého přístupu ke zbytku infrastruktury.
Pomáhá také striktně omezit platné zdroje dat a kanály, kterými se data dostávají do našich systémů. Čím jasnější je, která API, trasy nebo repozitáře jsou autorizovány, tím obtížnější bude pro škodlivý zdroj infiltrovat tok dat, aniž by vzbudil podezření nebo spustil bezpečnostní upozornění.
Nakonec je vhodné integrovat tato opatření do širšího bezpečnostního přístupu v celém životním cyklu vývoje : statická analýza kódu, kontroly závislostí, pravidelné audity balíčků a monitorování známých zranitelností v knihovnách, které denně používáme. Cílem není stát se posedlým, ale spíše se vyhnout práci naslepo.
Typické chyby při práci s knihovnami Pythonu: případ screen_brightness_control
Ne všechny problémy související s python knihovna Toto jsou kritické zranitelnosti. Často se setkáváme s mnohem běžnějšími chybami, které nicméně mohou projekt zastavit nebo způsobit zbytečné plýtvání hodinami. Jednoduchým příkladem je případ knihovny. screen_brightness_control, používaný ke správě jasu obrazovky z Pythonu.
Vývojář pracující na analytickém programu na svém počítači s použitím Kód Visual Studio, narazil na Pylanceovu zprávu: „import „screen_brightness_control“ se nepodařilo vyřešit“ přímo na čáře import screen_brightness_control as sbcToto bylo doslovně zkopírováno z oficiální dokumentace. Python a samotná knihovna byly aktuální, ale vývojové prostředí trvalo na tom, že modul neexistuje.
Tento typ chyby obvykle souvisí s problémy, jako jsou špatně nakonfigurovaná virtuální prostředí , instalace v jiných cestách, než jaké používá interpret, nebo nesrovnalosti mezi verzí Pythonu, ve které se kód spouští, a verzí použitou k instalaci balíčku. Ačkoli se tento konkrétní případ nakonec „magicky“ vyřešil sám, aniž by kdokoli věděl, co se změnilo, s největší pravděpodobností to bylo způsobeno nastavením prostředí nebo cesty.
Pokud se setkáte s takovým problémem, je vhodné zkontrolovat základní aspekty, jako je například to, který interpret Pythonu Visual Studio Code používá, a zda je balíček skutečně nainstalován v daném prostředí pomocí pip show screen_brightness_controlnebo pokud na stejném systému existuje několik verzí Pythonu.
Kromě anekdoty tyto chyby ilustrují, že ačkoliv se Python snadno učí , interakce mezi IDE, virtuálními prostředími a správci balíčků může generovat matoucí chyby. A především, že problém mnohokrát nespočívá ani v kódu, ani v knihovně, ale v konfiguraci prostředí.
Běžné chyby při instalaci Pythonu, které ovlivňují knihovny
Ještě předtím, než se dostanou k instalaci knihovny, se mnoho uživatelů setkává s problémy s instalací samotného Pythonu , které pak ovlivňují používání případných dalších balíčků. Tyto chyby jsou obzvláště časté u těch, kteří s programováním začínají, a jakmile otevřou terminál, se setkávají se záhadnými zprávami.
Soubor Python.exe nebyl nalezen.
Jednou z nejčastějších chyb ve Windows je zpráva, že soubor „python.exe“ nelze nalézt při pokusu o spuštění Pythonu z příkazového řádku. To je obvykle způsobeno tím, že systém nemá v proměnné prostředí PATH uvedenou cestu ke spustitelnému souboru, takže neví, kde má interpret hledat.
Řešení je hotové ručně přidat instalační cestu Pythonu k proměnným prostředí systému. Chcete-li to provést, přejděte do pokročilého nastavení systému, otevřete sekci „Proměnné prostředí“, vyhledejte proměnnou PATH v sekci systémových proměnných a upravte ji tak, aby zahrnovala adresář, kde se nachází. python.exe (například C:\\PythonXX\\(nahrazením „XX“ odpovídající verzí).
Jakmile jsou změny uloženy, je důležité zavřít a znovu otevřít příkazový řádek , aby se nová hodnota PATH projevila. Od té chvíle by měl být systém schopen najít spustitelný soubor Pythonu při spuštění odpovídajícího příkazu.
Matoucí chybové hlášky během instalace
Dalším častým problémem jsou vágní chybové zprávy , které se zobrazují během instalace Pythonu nebo při pokusu o konfiguraci určitých komponent. Někdy jsou způsobeny závislostmi operačního systému, jindy nedostatečnými oprávněními nebo konflikty s nesprávně odinstalovanými předchozími verzemi.
Pokud chyba není zřejmá, nejrozumnějším postupem je nahlédnout do oficiální dokumentace Pythonu , která zahrnuje řadu běžných případů, často kladených otázek a podrobných řešení. Přímé přecházení na fóra bez předchozího prostudování těchto informací může diagnózu dále zkomplikovat.
Je také důležité ověřit, zda stahujete správný instalační program z oficiálních webových stránek Pythonu a nikoli ze zdrojů třetích stran, protože používání neoficiálních instalačních programů může vést k problémům s kompatibilitou, podivným verzím nebo dokonce k bezpečnostním rizikům.
Nevhodná verze Pythonu
Je docela běžné, že při sledování tutoriálu nebo práci na konkrétním projektu je vyžadována určitá verze Pythonu a bez vědomí si to uživatel nainstaluje jinou verzi. To může vést k nekompatibilitě s určitými knihovnami nebo skripty, které používají funkce nebo syntaxi zavedenou nebo odebranou mezi verzemi.
Aby se tyto problémy minimalizovaly, je dobrý nápad uveďte přesnou verzi které chcete použít při vytváření prostředí nebo spouštění příkazů. Pokud například potřebujete pracovat s Pythonem 3.8, můžete si vytvořit virtuální prostředí pomocí něčeho jako python3.8 -m venv mi_entornočímž se zajistí, že knihovny jsou nainstalovány a spuštěny ve správné verzi.
V prostředích, kde koexistuje několik verzí (například Python 3.8 a 3.11), je důležité mít jasno v tom, který binární soubor se v daném okamžiku používá, ať už prostřednictvím aliasů, správců verzí nebo nástrojů specifických pro použitou distribuci.
Nesprávně nakonfigurovaná cesta
Správná konfigurace cesty (PATH) ovlivňuje nejen hlavní spustitelný soubor Pythonu, ale také to, jak systém vyhledává skripty, doplňkové nástroje a binární soubory nainstalované s knihovnami.
Pokud je proměnná PATH nedbale upravena nebo je Python nainstalován na nekonvenční místa bez aktualizace, mohou nastat zdánlivě nevysvětlitelné problémy: příkazy, které přestanou fungovat, knihovny, které „zmizí“, nebo skripty, které běží s verzemi odlišnými od očekávaných.
Chcete-li zkontrolovat aktivní cestu, můžete ve Windows spustit echo %PATH% Z příkazového řádku zkontrolujte, zda je součástí instalační složky Pythonu. Na jiných systémech, jako je Linux nebo macOS, použijte echo $PATHDůsledné úpravy těchto cest jsou nezbytné pro zajištění toho, aby se Python a jeho knihovny chovaly tak, jak by měly.
V profesionálním prostředí je také často vhodné spoléhat se na virtuální prostředí a nástroje pro správu verzí , aby se zapouzdřily závislosti a nespoléhalo se tolik na globální konfiguraci systému.
Škodlivé balíčky v PyPI a útocích na dodavatelský řetězec
Kromě chyb instalace a ojedinělých zranitelností existuje zásadní problém, který ovlivňuje celý ekosystém: důvěra ve správce balíčků, jako jsou PyPI, npm a RubyGems. Python není výjimkou a v posledních letech byly do oficiálního indexu přidány tisíce škodlivých balíčků.
V jednom konkrétním incidentu byl Python Package Index (PyPI) nucen odstranit přibližně 3 653 škodlivých balíčků krátce poté, co byla zjištěna bezpečnostní zranitelnost, která s nimi souvisela. Tyto balíčky obsahovaly neautorizované verze knihoven, jako je CuPy, a dalších legitimních projektů, které byly zkopírovány nebo zosobněny.
Problém pramení ze skutečnosti, že mnoho vývojářů používá PyPI jako přímý zdroj pro integraci knihoven třetích stran do svých projektů, často bez důkladné kontroly importovaného kódu. Systém se silně spoléhá na důvěru v autory knihoven a samotné repozitáře a tuto důvěru mohou zneužít útočníci.
Tento typ útoku se často spoléhá na techniky, jako je například překlepyTo zahrnuje nahrávání balíčků s názvy velmi podobnými názvům populárních knihoven, s využitím překlepů nebo zmatků v názvech. Pokud vývojář zadá identifikátor v souboru pip installMůže se stát, že si nainstalujete poškozenou verzi, aniž byste si to uvědomili.
Mezi škodlivými balíčky detekovanými v rámci této operace byly nalezeny falešné verze CupyJak cupy-cuda112 (CuPy pro CUDA 11.2), který byl nahrán 25. února 2021 a následující den odstraněn díky politice odezvy stanovené v PEP 541. V tomto případě jeden z oficiálních projektových manažerů, Kenichi Maehashi, po zjištění problému spustil poplach.
Motivace a skutečné dopady těchto útoků
Zajímavé na tomto incidentu je, že účet zodpovědný za nahrání podezřelých balíčků používal název „RemindSupplyChainRisks“ , což naznačuje, že cílem mohlo být spíše upozornit na bezpečnostní rizika ve vývojovém řetězci než provést rozsáhlý škodlivý útok.
Komentáře k některým z těchto balíčků dokonce obsahovaly varování, že účelem je zvýšit povědomí o vysokém riziku slepé důvěry v dodavatelský řetězec softwaru. Skutečné záměry však nebyly zcela jasné, částečně proto, že autor zůstal v anonymitě a zanechal neaktivní e-mailovou adresu.
Ee W. Durbin III, ředitel infrastruktury Python Software Foundation, vyjádřil určité pochybnosti o užitečnosti pozastavení problematického účtu a poznamenal, že je triviální vytvořit nový profil a pokračovat v nahrávání balíčků pod jinou identitou. To zdůrazňuje jednu z hlavních výzev veřejných repozitářů: omezenou kontrolu nad tím, kdo co publikuje.
Chování samotného škodlivého kódu v rámci balíčku cupy-cuda112 Nebylo to nijak zvlášť sofistikované: v podstatě odeslán požadavek GET na IP adresu v Tokiu (101.32.99.28) včetně názvu balíčku. Neprováděl destruktivní akce ani nenasazoval propracovanější datové zátěže, což posiluje hypotézu, že by se mohlo jednat spíše o „důkaz konceptu“ než o plně škodlivý útok.
Přesto skutečnost, že někdo může nahrát tisíce balíčků najednou, že si tyto balíčky mohou stáhnout legitimní uživatelé a že kód lze spustit na jejich systémech, jasně ukazuje, že oblast útoku ekosystému Pythonu je velmi široká. A že jakékoli selhání, ať už v designu, dohledu nebo bezpečnostní kultuře, může mít značné důsledky.
Praktické lekce pro vývojáře a technické týmy
Jak kritické zranitelnosti, jako je CVE-2026-0848 v NLTK, tak i škodlivé balíčky detekované v PyPI nebo zdánlivě neškodné chyby instalace, ukazují stejným směrem: nestačí umět programovat v Pythonu , musíte také pochopit, jak je kód distribuován, jak jsou instalovány závislosti a jaké důsledky má každé návrhové rozhodnutí.
Pro každý tým pracující profesionálně s Pythonem je klíčové stanovit jasné zásady správy závislostí : kontrolovat povolené knihovny, kontrolovat jejich původ, monitorovat známé zranitelnosti a vyhýbat se začleňování balíčků od neznámých autorů bez minimálního auditu kódu.
Je také nezbytné integrovat bezpečnost do životního cyklu vývoje softwaru : od fáze návrhu až po nasazení, včetně automatizovaného testování k detekci nezabezpečených verzí, analýzy složení softwaru (SCA) a pravidelných kontrol běhových prostředí.
Na individuální úrovni se vyplatí věnovat čas důkladnému pochopení fungování PIP, virtuálních prostředí a proměnných prostředí . Tento základ výrazně snižuje pravděpodobnost výskytu frustrujících chyb, jako jsou nevyřešené importy, konflikty verzí nebo fiktivní instalace, které nikdo nedokáže identifikovat.
V prostředí, kde se Python používá pro všechno od malých osobních skriptů až po kritické systémy umělé inteligence, produkční backendy a nástroje pro obchodní analýzu, je předpoklad, že knihovny „prostě fungují“, bez ohledu na bezpečnost, stále více luxusem, který si již nemůžeme dovolit. Pečlivější a uvědomělejší přístup k instalaci, aktualizaci a kontrole závislostí může být rozdílem mezi robustním prostředím a systémem plným zadních vrátek, o kterých nikdo neví.

Přijetí tohoto přístupu nejen pomáhá vyhnout se zranitelnostem nebo malwaru, ale také zlepšuje celkovou kvalitu projektů: méně podivných selhání, méně času stráveného nefunkčními instalacemi a větší jistota, že kód běžící na našich serverech dělá přesně to, co má, a nic víc.