- Přechod od asistentů kódu k autonomním agentům schopným plánovat a provádět složité pracovní postupy.
- Zásadní význam behaviorálního testování a lidského dohledu, aby se zabránilo generování neefektivního nebo nejistého kódu.
- Potřeba rozdělit složité úkoly na mikrocíle, aby se maximalizovala efektivita umělé inteligence a vyhnulo se architektonickým chybám.

Pravděpodobně jste si všimli, že svět vývoje softwaru prochází radikální transformací. Už nemluvíme jen o návrzích automatického doplňování, které nám ušetří psaní řádku, ale o skutečné revoluci zvané agentické programování . V podstatě se přesouváme od asistenta, který nám šeptá odpověď, k digitálnímu dodavateli schopnému autonomně plánovat, psát a ladit kód, spravovat soubory a spouštět příkazy v terminálu, zatímco my dohlížíme na architekturu.
Ačkoli se na sociálních sítích často tvrdí, že SaaS si dnes může kdokoli nastavit během odpoledne, aniž by věděl, jak programovat, realita je taková, že technická znalost zůstává určujícím faktorem. Agenti jsou mocným nástrojem pro zvýšení produktivity, ale bez inženýra, který zná úskalí, může být výsledkem chaotický zmatek neefektivního kódu nebo, co je horší, kód plný bezpečnostních zranitelností . Je to posun v myšlení: programátor se nyní chová spíše jako dirigent orchestru než jako hudebník hrající každou notu.

Z čeho přesně se skládá agentní tok?
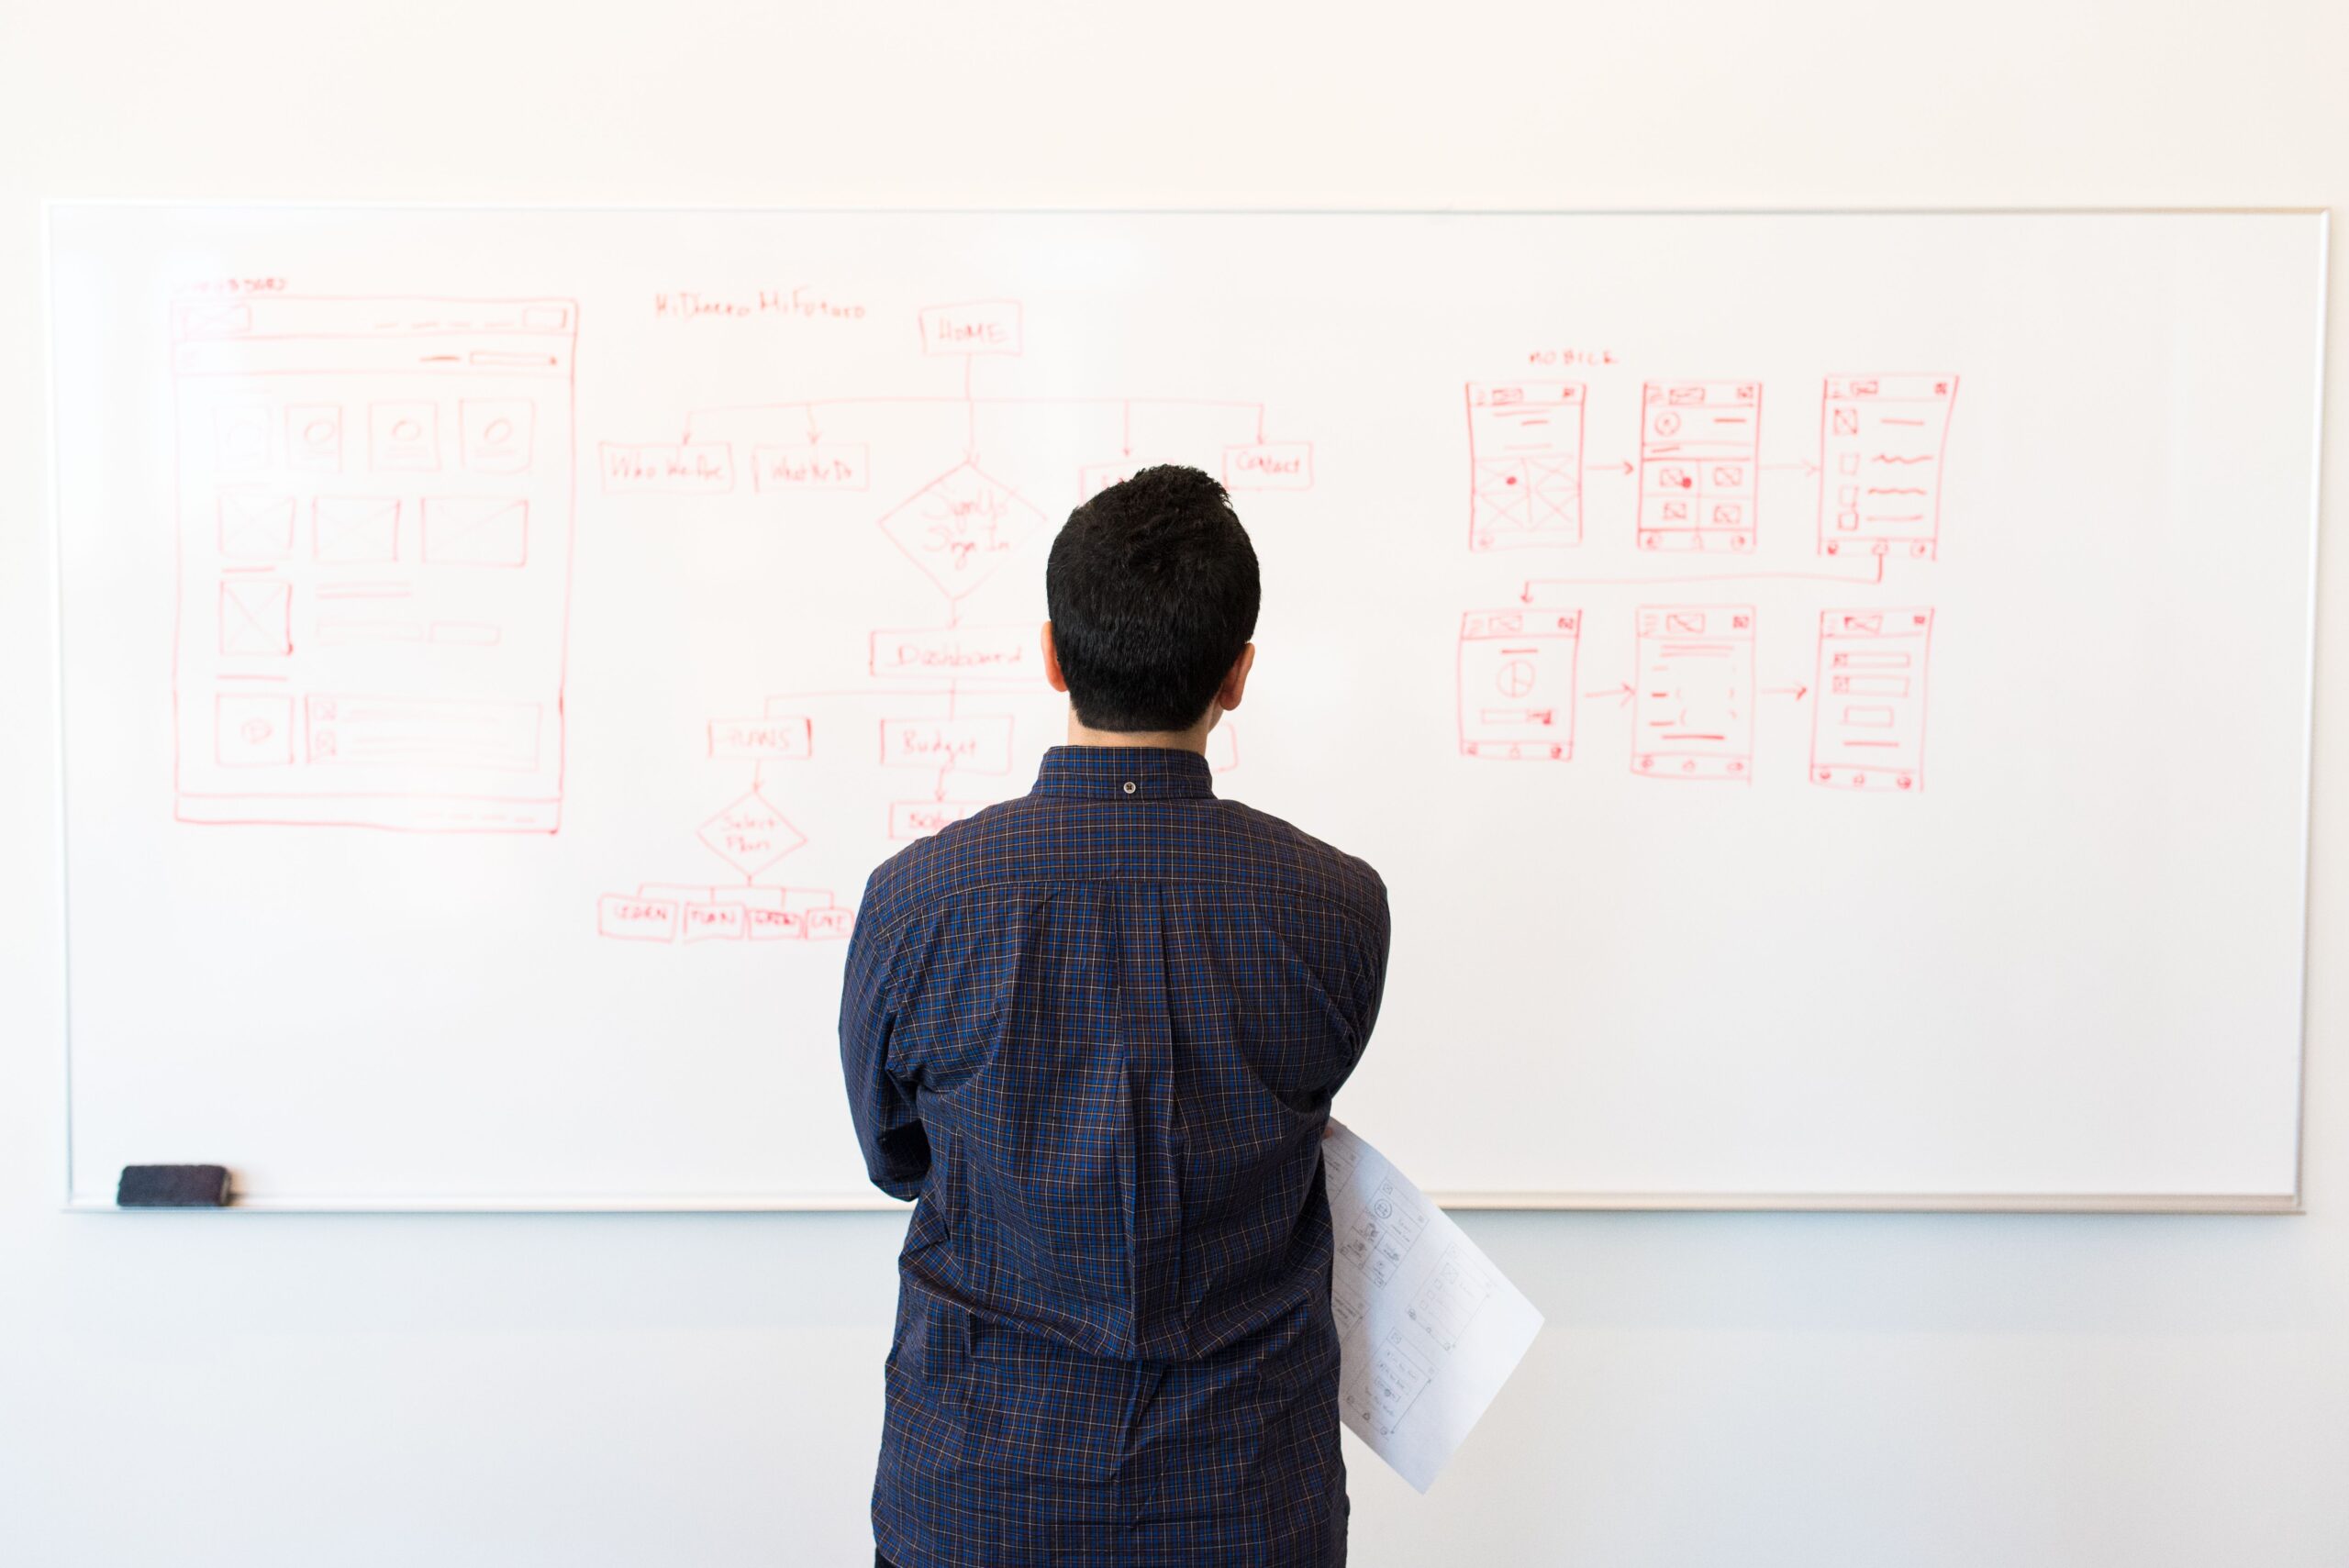
Na rozdíl od konvenčních chatbotů pracují kódovací agenti na hlubších úrovních vývojového stacku. Mohou se pohybovat v souborovém systému , spravovat závislosti a uvažovat o celých repozitářích. Pokud agent napíše funkci, která vyvolá chybu, nečeká, až mu uživatel sdělí, co se stalo; může si přečíst chybovou zprávu , analyzovat problém a automaticky použít opravu.
Pro využití těchto možností se objevily koncepty jako Model Context Protocol (MCP) , které umožňují umělé inteligenci propojit se s externími nástroji (jako je Notion nebo databáze) a zároveň využívat konfigurační soubory, jako jsou AGENTS.md nebo CLAUDE.md. Tyto dokumenty fungují jako trvalý návod k použití, který agenta instruuje o pravidlech projektu, jak spouštět testy a jaké stylistické konvence dodržovat, aby se zabránilo improvizaci.

Poučení získaná na bojišti
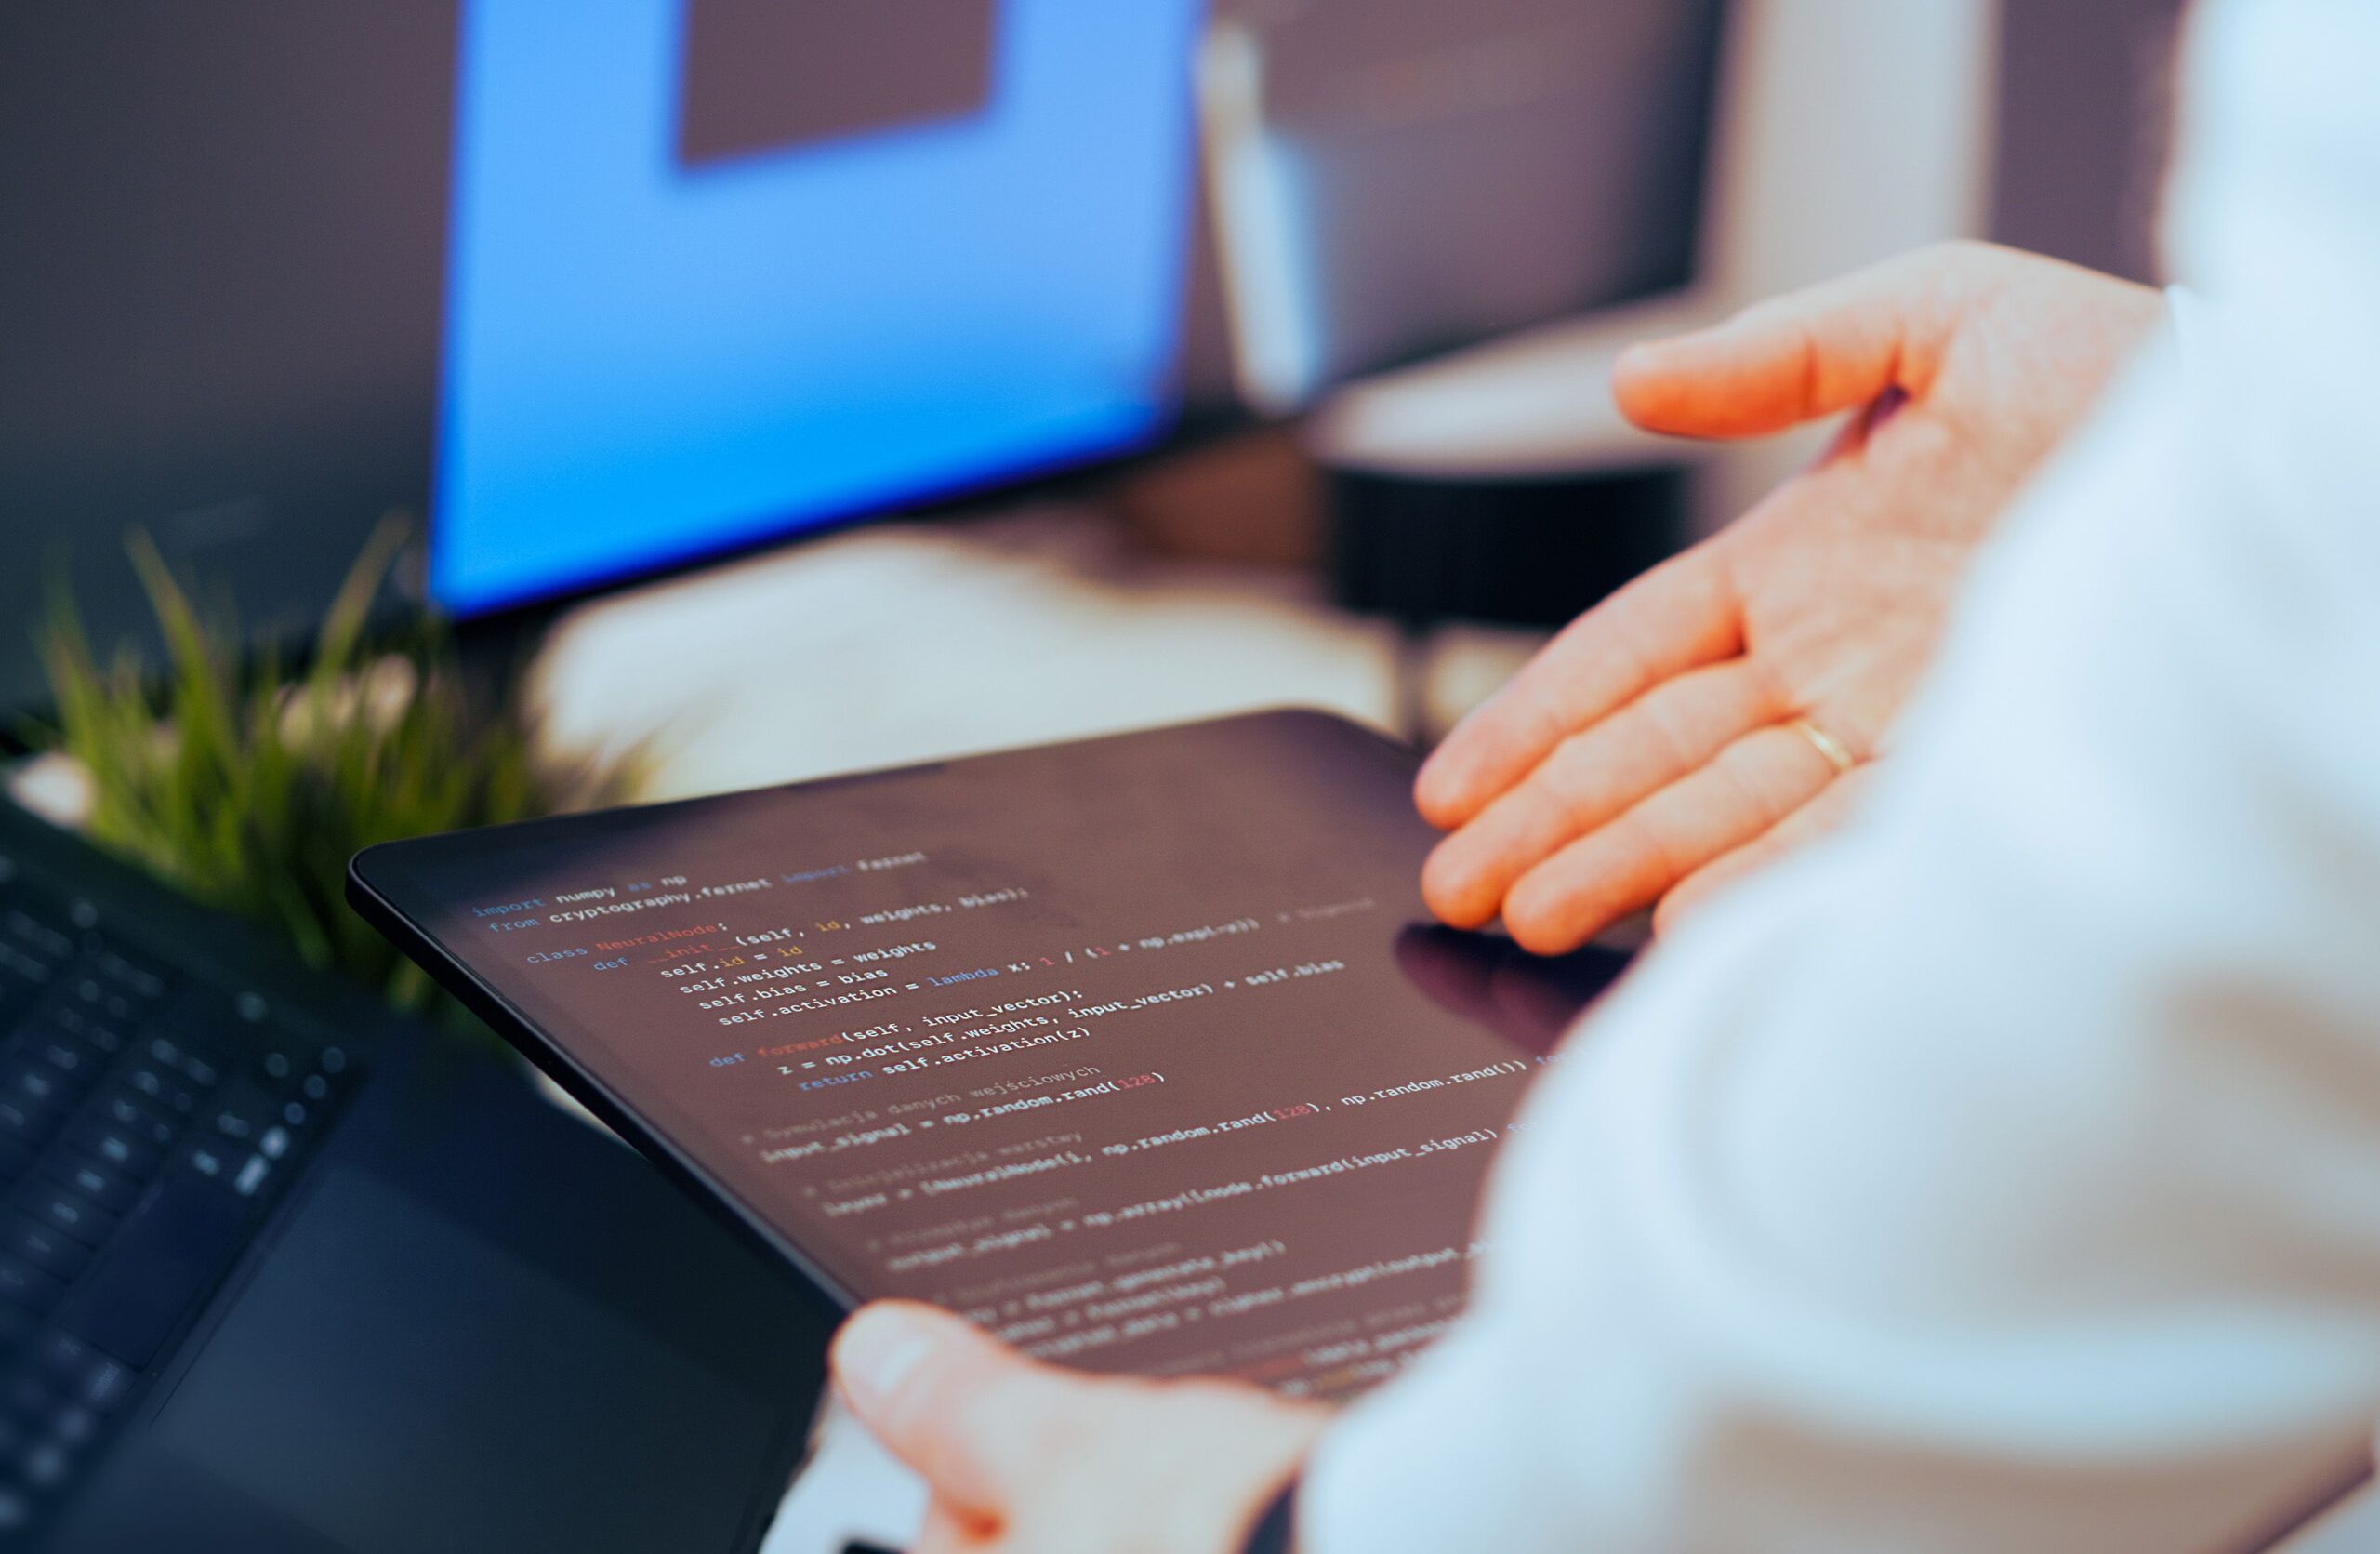
Když náklady na generování kódu klesnou prakticky na nulu, musí se změnit strategie vývoje. Jedním z klíčů je implementace pro učení ; už nemá smysl trávit týdny leštěním teoretické specifikace, pokud dokážete vydat rychlý prototyp, který odhalí problémy, o kterých jste si ani nemysleli. V tomto prostředí je přestavba často konkurenční výhodou: můžete vyzkoušet bláznivé experimenty a bez výčitek svědomí je zahodit.
Tato rychlost však má svou cenu. Protože je kód „levný“, existuje riziko generování toho, co někteří nazývají odpadkovým kódem neboli „slopem“ . Abychom se tomu vyhnuli, je nezbytné investovat čas do end-to-end testování . Nemusíme testovat, jak umělá inteligence úkol provádí, ale spíše to, zda se konečný produkt chová podle očekávání. Testy se stávají behaviorální smlouvou, která nám dává svobodu regenerovat kód bez obav z poškození všeho.
Meze autonomie: kde umělá inteligence selhává
Není to jen slunce a duha. Zkušenosti z praxe ukazují, že produktové výzvy (vágní pokyny typu „vytvořte mi profilovou stránku“) často ve složitých projektech dramaticky selhávají. Agenti mají tendenci optimalizovat odpověď tak, aby splňovala nejnovější výzvu, přičemž ztrácejí ze zřetele celkovou architekturu nebo ignorují kritické požadavky, jako je jedinečnost pole v databázi, jednoduše proto, že test selhal a oni se rozhodli ho přeskočit.

Další slabinou je zvládání vysoce specifických scénářů infrastruktury . Například při nasazení úložných klientů se složitými protokoly, jako je SSE-C, na Google Cloud Storage se agenti mohou zaseknout v chybových smyčkách nebo se pokusit bez povolení downgradovat verzi knihovny. Zde hraje klíčovou roli znalost domény : expert může agenta během několika minut dovést k řešení, zatímco někdo bez zkušeností může strávit dny sledováním, jak se umělá inteligence zasekává v začarovaném kruhu.
Pokročilé strategie pro inženýry
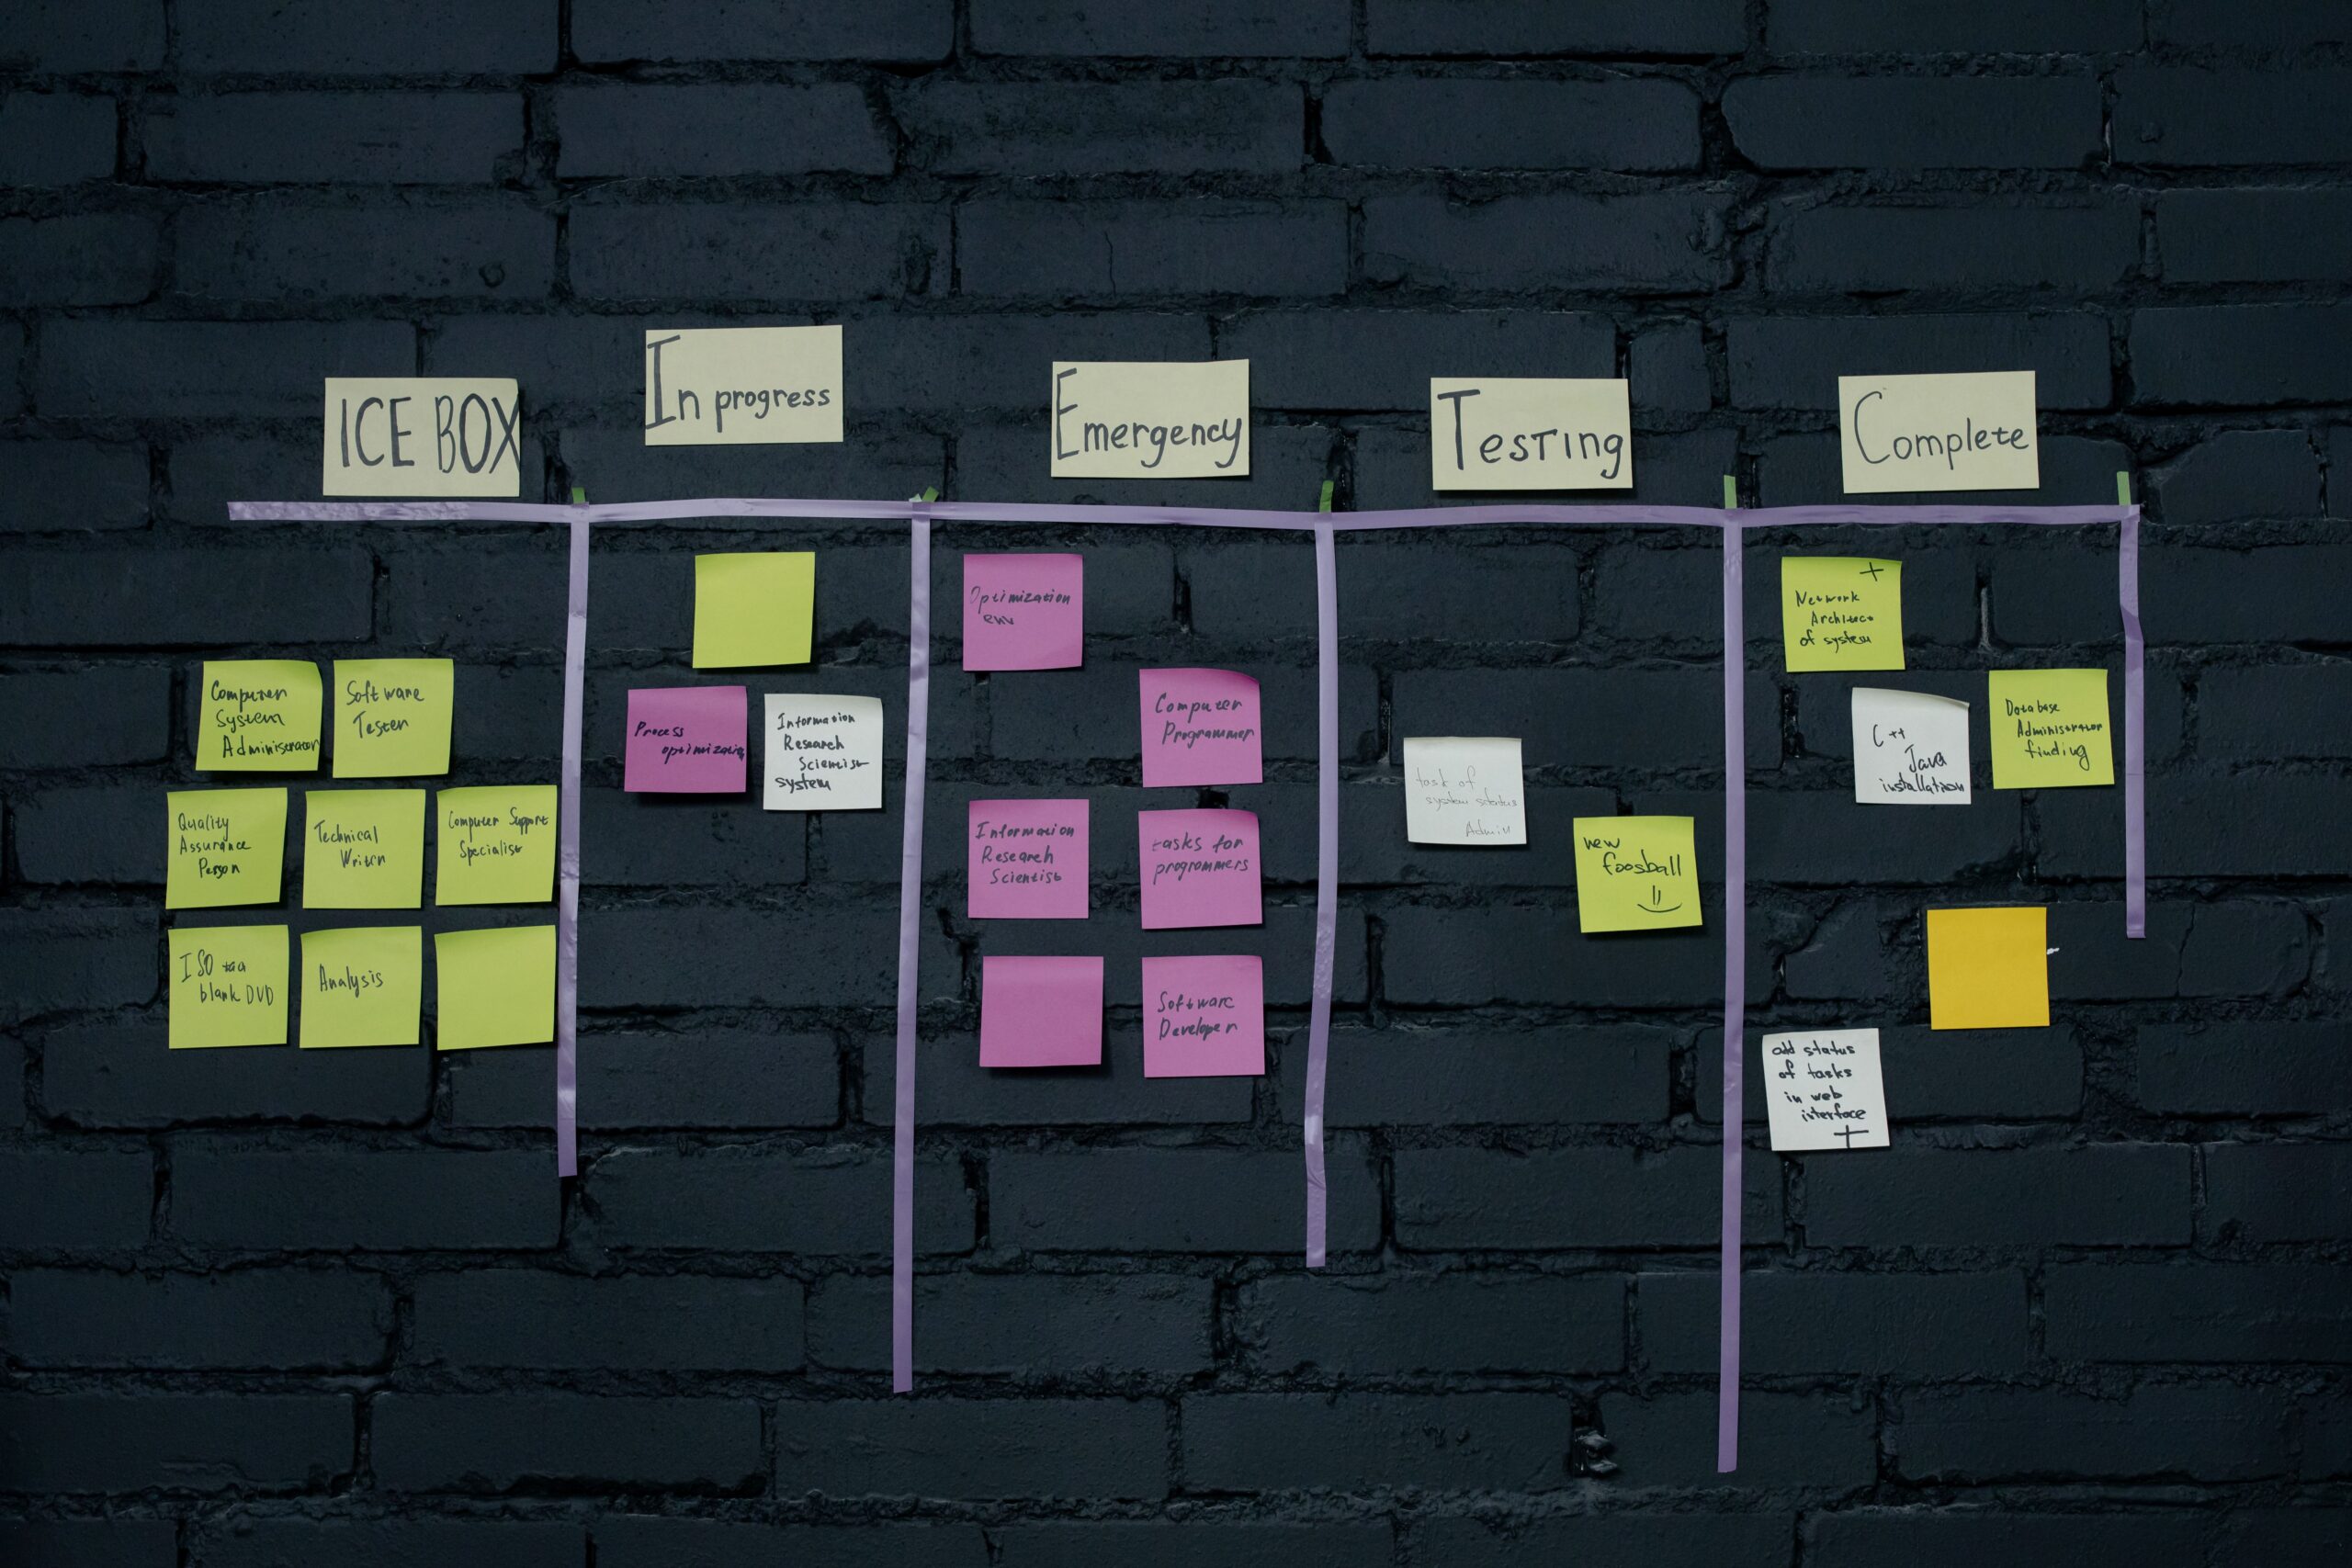
Aby se předešlo vyhoření, ideálním přístupem je rozdělit úkoly na malé, zvládnutelné části. Příliš velké úkoly generují nepoužitelné výsledky, zatímco ty, které jsou příliš malé, způsobují, že režie převažuje nad přínosy. Jednou z účinných technik je použití specializovaných subagentů : jeden se věnuje výhradně webovému výzkumu a druhý kontrole typů, čímž se zabrání zahlcení hlavního kontextu irelevantními informacemi.
Dále je klíčové rozvíjet technický úsudek neboli dobré oko . Ve světě, kde umělá inteligence chrlí kód rychlostí blesku, je jediným zdrojem okamžité zpětné vazby samotný vývojář. Znalost detekce zápachu kódu a předvídání bezpečnostních zranitelností (jako jsou útoky XSS při vykreslování URL) je to, co odlišuje uživatele nástrojů od skutečného softwarového inženýra.
Optimalizace kontextu a nástrojů
Správa kontextu je klíčová. Protože LLM mají omezené okno, je vhodné použít kompresi kontextu (shrnující konverzaci) nebo restartovat chat pro nesouvisející úkoly. Standard llms.txt je také velmi užitečný , protože poskytuje hustou a efektivní dokumentaci, takže umělá inteligence nemusí číst hlučné HTML stránky.
Pokud jde o nástroje, v tomto ohledu jsou na špici možnosti jako Cursor nebo Claude Code , které umožňují bezproblémovou integraci s IDE. Možnost spouštět kód v izolovaných prostředích, jako jsou kontejnery Docker, umožňuje režim YOLO (běh bez manuálního závazku), což urychluje dodání, pokud je následně dodržována přísná disciplína kontroly kódu.
Agentové programování programátora neodstraňuje, spíše povyšuje jeho roli v oblasti orchestrace a návrhu systémů. Zatímco rychlost implementace exponenciálně roste, odpovědnost za údržbu, bezpečnost a architekturu leží na lidech více než kdykoli předtím. Kombinace silné technické intuice se schopností delegovat mechanickou implementaci na autonomní agenty v konečném důsledku vytváří v moderním vývoji nepřekonatelnou konkurenční výhodu.
