- Cache-kohærens sikrer, at alle kopier af de samme data i forskellige cacher og i RAM forbliver ensartede på multi-core systemer.
- Cachehierarkiet med et delt sidste niveau forenkler konsistenskontrol og reducerer direkte adgang til hovedhukommelsen.
- Kohærensprotokoller bruger kopiugyldiggørelses- eller opdateringsstrategier, understøttet af tilstande og kontrolbits pr. cachelinje.
- Compileren og operativsystemet kan supplere hardwarekonsistens ved at indsætte instruktioner og konfigurere hukommelse i kritiske perioder.
Når man ser på et diagram over enhver moderne multi-core processor, ses det samme mønster altid: flere kerner, hver med sine egne nærliggende caches, og en delt cache på sidste niveau, der fungerer som et fælles punkt, før den når RAM. Denne ordning er ikke tilfældig eller et indfald fra designernes side, men en direkte reaktion på et kritisk problem i parallelle systemer: cache-kohærens.
Uden en robust konsistensmekanisme kan hver kerne ende med at arbejde med en forskellig og forældet version af de samme data i hukommelsen , hvilket i et virkeligt program kan resultere i subtile fejl, uforudsigelige fejl og endda systemnedbrud. Derfor er det vigtigt at forstå, hvordan denne konsistens opretholdes – både på hardware- og softwareniveau – for at forstå ydeevnen og stabiliteten af moderne multi-core CPU'er.
Hvad er cache-kohærens: terminalmetaforen

Forestil dig flere personer, der sidder foran forskellige terminaler og alle redigerer det samme dokument, der er gemt på en central server . Hver skærm viser en kopi af filen, og eventuelle ændringer, som én person foretager, forventes at blive afspejlet med det samme på alles skærme.
For at dette kan fungere, skal der være en synkroniseringsmekanisme, der udbreder dokumentændringer til alle terminaler, så alle altid ser den samme version. Så længe dette system fungerer, er alt fint: den, der ændrer teksten, ved, at alle andre vil se den nye version næsten øjeblikkeligt.
Forestil dig nu, at synkroniseringssystemet pludselig fejler. Hver person fortsætter med at redigere, overbevist om, at de arbejder på det delte dokument, men i virkeligheden har hver terminal sin egen afkoblede lokale kopi . Fra det øjeblik når ændringer foretaget af én person ikke de andre, og dokumentet begynder at divergere ukontrolleret.
Inden for datalogi er det præcis, hvad der ville ske, hvis CPU'en manglede en pålidelig konsistensprotokol: én kerne ændrer data i hukommelsen, men de andre kerner fortsætter med at læse en ældre version fra deres private caches . Dette skaber grobund for alvorlige logiske fejl, beskadigede data og fejlfindingsadfærd.
Cache-kohærens er derfor det sæt af mekanismer, der sikrer, at alle kopier af de samme data, der er fordelt på tværs af de forskellige cacher og RAM, opretholder en ensartet tilstand i et multi-core system . Selv hvis der findes flere kopier, skal systemet opføre sig "som om" der kun var én.
Caches og hukommelseshierarki i en multi-core CPU
CPU-cacher er små, meget hurtige hukommelser, der indeholder kopier af ofte brugte RAM-stykker . Når processoren udfører kode, forsøger den at læse fra og skrive til cachen i stedet for kontinuerligt at tilgå (forholdsvis langsomt) RAM, hvilket drastisk reducerer latenstiden.
Tricket er selvfølgelig, at cacher ikke gemmer den "officielle version" af dataene, men kun en midlertidig replika . I overensstemmelse med terminalmetaforen ville RAM være dokumentet på serveren, mens cacher ville være de lokale skærme, der viser kopier af bestemte dele af filen.
I en multi-core CPU bliver designet mere komplekst, fordi hver kerne typisk har sine egne private niveau 1 (L1) og endda niveau 2 (L2) caches . Ovenover disse tilføjes en delt niveau 3 cache (for eksempel), placeret mellem kernerne og hukommelsescontrolleren, der giver adgang til RAM.
Denne delte cache introduceres, fordi det at tillade alle kerner direkte og intensiv adgang til RAM ville forårsage adgangskonflikter, spændingskonflikter på hukommelsesbussen og et betydeligt fald i ydeevnen . Cachen på sidste niveau fungerer som en fælles "buffer", der reducerer RAM-adgang og centraliserer en stor del af datatrafikken.
Derudover organiserer mange arkitekturer cacher inkluderende: linjer gemt på niveauer tæt på processoren findes også på højere niveauer i hierarkiet . Det vil sige, at en linje, der vises på L1, også findes på L2 og dermed på L3. Dette har en meget nyttig konsekvens for konsistens: blot at opdatere cachen på det laveste niveau korrekt er nok til at kontrollere tilstanden af de andre niveauer uden konstant at skulle tilgå RAM.
Hvorfor delt caching på sidste niveau er nøglen til konsistens
Uden denne globale cache på sidste niveau skulle hver kerne kontrollere konsistens direkte mod hovedhukommelsen . Hver gang en hukommelseslinje i en privat cache blev ændret, ville det være nødvendigt at kontrollere, om andre kerner har en kopi af den samme linje, og i så fald opdatere eller ugyldiggøre den overalt.
I et system med mange kerner ville denne arbejdsbyrde af kontroller resultere i et enormt antal transaktioner til RAM , hvilket ville ophæve en stor del af fordelen ved at have hurtige caches. Ved at placere en delt cache mellem kernerne og hukommelsen kan CPU'en koncentrere kohærenskontrollen på et enkelt mellemliggende sted.
I mange implementeringer indeholder cachen på højere niveauer (længere fra processoren) kopier af de linjer, der findes i niveauerne tættere på kernen . Med denne organisering behøver kohærensprotokollen kun at sikre, at det sidste niveau er synkroniseret med hovedhukommelsen, og at de private niveauer i hver kerne er synkroniseret med niveauet umiddelbart over det.
Dette kan visualiseres som en slags russisk rededukke: cachen på tredje niveau indeholder indholdet af andet og første niveau , det andet niveau indeholder sit eget indhold og indholdet af det første niveau, og det første niveau kender kun sine egne linjer. Ved at kontrollere den "store dukke" (det sidste niveau) kan systemet således koordinere resten mere effektivt.
Resultatet er, at det bliver mere økonomisk at opretholde konsistens med hensyn til design og hukommelsestrafik . I stedet for at tvinge hver kerne til konstant at håndtere RAM, fungerer protokollen på den delte cache og styrer derfra, hvilke linjer der skal opdateres eller ugyldiggøres i de private caches.
Opdateringsmetoder: ugyldiggørelse og opdatering af kopier
Et kritisk problem opstår, når to eller flere kerner næsten samtidigt ønsker at tilgå den samme datalinje, der replikeres på tværs af flere cacher . I denne sammenhæng anvender konsistenssystemer typisk to grundlæggende strategier, når de håndterer skrivninger.
Den første metode er baseret på ugyldiggørelse. Når en kerne skal skrive til en specifik cachelinje, ugyldiggør protokollen eventuelle kopier af den samme linje, der måtte findes i de andre cacher . Kun den kerne, der skal skrive, holder linjen i en læse- og skriveaktiveret tilstand; de andre, hvis de vil bruge disse data igen, skal genindlæse linjen fra det højere niveau (eller fra hukommelsen) med den opdaterede version.
Den anden strategi involverer opdatering. I dette tilfælde, når en kerne ændrer en linje, forsøger systemet automatisk at udbrede det nye indhold til eksisterende kopier i de andre cacher . På denne måde modtager alle cacher, der har gemt den linje, den opdaterede version uden at skulle ugyldiggøre og genindlæse den senere.
Hver tilgang har sine fordele og ulemper. Ugyldiggørelse er normalt mere effektiv, når der skrives hyppigt, fordi det undgår at mætte hukommelsessystemet med opdateringer, som andre kerner muligvis ikke har brug for med det samme. Omvendt kan opdatering være fordelagtig, når mange kerner ofte læser de samme data, der ændres relativt sjældent , da det reducerer latenstid ved ikke at skulle genindlæse linjen efter hver ugyldiggørelse.
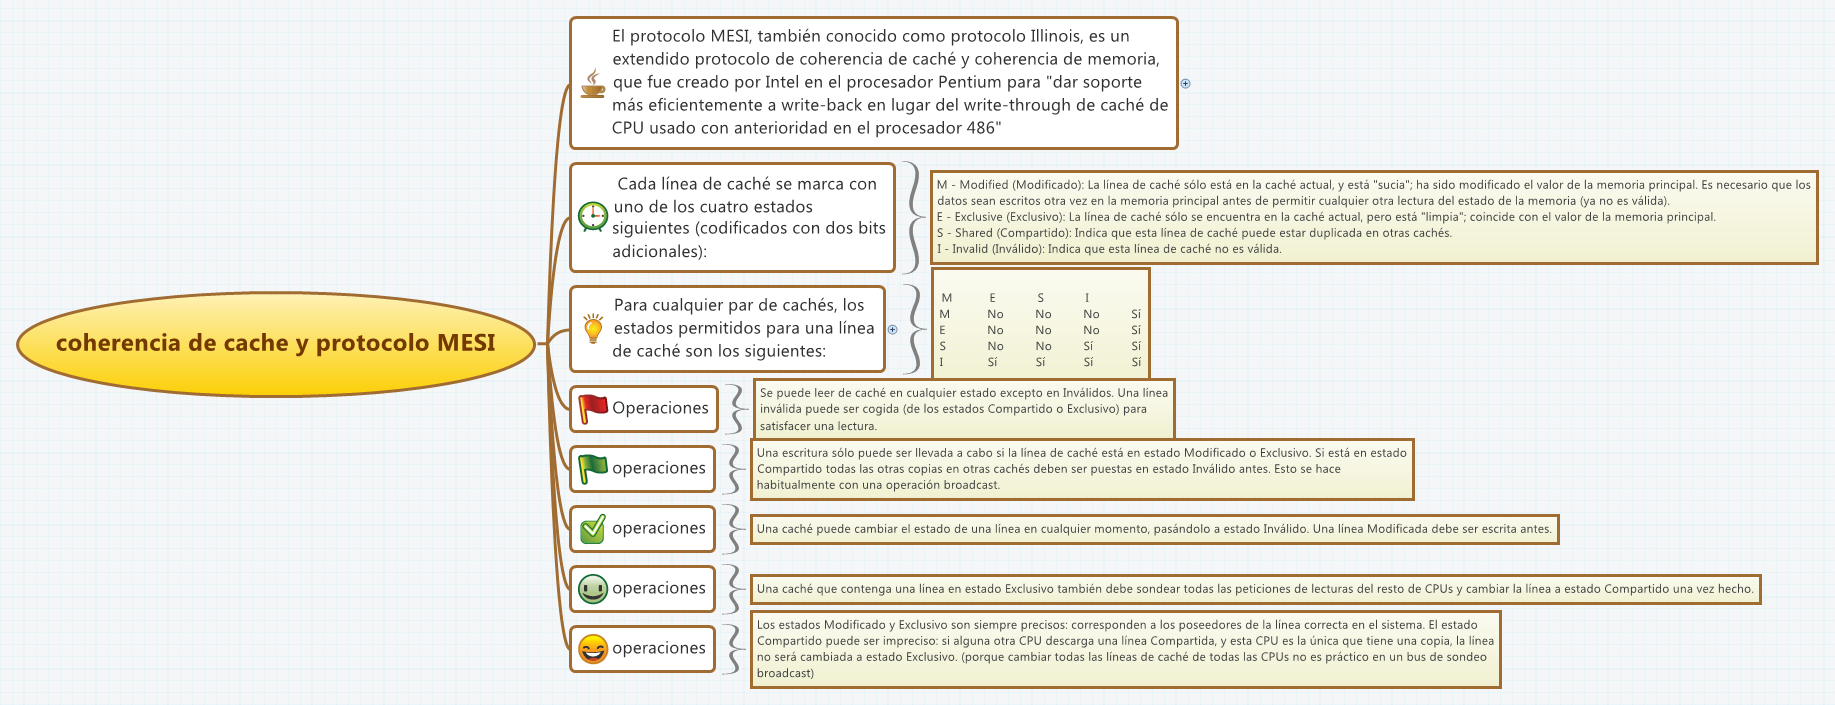
I begge tilfælde bruger begge metoder yderligere tilstande og kontrolbits i cachelinjerne. Hver linje indeholder typisk information om, hvorvidt dens indhold matcher indholdet i RAM , og om den er delt, ændret, eksklusiv, reserveret osv., afhængigt af den specifikke protokol (MESI, MOESI, MSI osv.). Dette gør det muligt for hardwaren at træffe hurtige beslutninger om, hvad der skal gøres, når en læse- eller skriveoperation finder sted på en allerede replikeret linje.
Kontrol af overensstemmelse mellem cacher og hukommelse
Direkte verifikation af konsistensen mellem alle cacheniveauer i en CPU eller GPU og hovedhukommelsen ville være en enorm opgave, både med hensyn til designkompleksitet og ydelsesomkostning. Derfor organiserer moderne systemer denne verifikation hierarkisk.
De cacher, der er tættest på processoren (L1, L2), er normalt ikke forbundet direkte til RAM, men til det næste cacheniveau. Det betyder, at konsistensen ikke valideres mod hovedhukommelsen på hvert niveau, men snarere mod det umiddelbart højere niveau . Dette reducerer antallet af RAM-adgange og forenkler den logik, der kræves på lavere niveauer.
I sidste ende udføres sammenligningen mellem cacheindhold og RAM-indhold mellem cachen på sidste niveau og hovedhukommelsen . Hvis dette sidste niveau opretholder en korrekt og konsistent tilstand, og hvert lavere niveau opretholder sin konsistens med det ovenover, forbliver hele hierarkiet konsistent uden at skulle kontrollere hver linje mod RAM gentagne gange.
Når en kerne skriver til en cachelinje og ændrer dens data, markeres linjens tilstand for at indikere, at den ikke længere præcist matcher den kopi, der er gemt i hukommelsen . Derfra koordinerer protokollen opdateringen: den markerer de tilsvarende kopier i andre cacher som reserverede eller ugyldige, og når det er relevant, skriver den det nye indhold til den tilhørende hovedhukommelseslinje.
Denne kaskadestruktur tillader ændringer at udbrede sig progressivt fra kernen, som opdaterer dataene, til hovedhukommelsen og passere gennem hvert cacheniveau på en kontrolleret måde. På denne måde bliver opretholdelse af konsistens ikke en uoverstigelig flaskehals for processoren.
Hardwarekohærens versus softwarekohærens
Indtil videre har vi diskuteret konsistensmekanismer, der primært implementeres i hardware: protokoller, statusbits, delte caches osv. Der er dog en anden tilgang, der søger at flytte noget af denne kompleksitet til software , specifikt til compileren og operativsystemet.
Softwarebaserede konsistensordninger forsøger at reducere behovet for yderligere logik på chippen ved at analysere kode og træffe beslutninger under kompilering . Ideen er, at hvis compileren kan udlede, hvornår og hvordan bestemte delte data tilgås, kan den i mange tilfælde forhindre, at disse data caches, eller eksplicit administrere deres synlighed.
Denne tilgang har en klar fordel: en del af arbejdsbyrden skifter fra løsning under kørsel til løsning under kompilering . I stedet for at hardwaren registrerer og håndterer alle konflikter undervejs, forsøger compileren at forudse dem og generere kode, der undgår farlige situationer.
Ulempen er, at statisk kodeanalyse er begrænset, og derfor har compilere en tendens til at være konservative . Det betyder, at de for at undgå at krænke konsistensen ofte træffer beslutninger, der reducerer caches effektivitet. Hvis de har mistanke om, at nogle data kan være problematiske, forhindrer de ofte, at de caches eller gennemtvinger synkroniseringer oftere end strengt nødvendigt.
Derfor, selvom disse softwareordninger er attraktive i teorien, især til forenkling af hardwaredesign, erstatter de i praksis ikke den kohærensunderstøttelse, der er integreret i selve CPU'en , men supplerer den snarere i nogle specifikke scenarier.
Compilerens rolle i cache-konsistens
Et centralt element i softwarebaserede konsistenstilgange er compilerens rolle. Compileren kan udføre en dybdegående analyse af koden og bestemme, hvilke delte datastrukturer der kan være usikre til caching . Baseret på dette markerer den disse elementer på en særlig måde eller tilpasser kodegenereringen.
Den enkleste, og også den mest konservative, tilgang er at forhindre, at delte datavariabler caches . Det vil sige, at hver adgang til disse variabler tvinger adgang til hovedhukommelsen eller et ikke-cachebart område. Dette garanterer konsistens, men går glip af mange ydeevnemuligheder, fordi en delt struktur faktisk kan bruges privat i bestemte perioder eller skrivebeskyttet i andre.
I virkeligheden opstår konsistensproblemet kun i intervaller, hvor mindst én proces kan skrive til variablen, og en anden proces kan læse den . Uden for disse kritiske perioder kan variablen behandles som værende udelukkende til brug for en enkelt tråd eller endda som en effektiv konstant i et stykke tid, hvilket giver mulighed for at cache den uden problemer.
De mest avancerede kompileringsstrategier forsøger at identificere de "sikre" perioder, hvor den delte variabel kan betragtes som ikke-konfliktfyldt . For at gøre dette analyserer compileren udførelsesstier, potentielle samtidige adgange og synkroniseringsmønstre (låse, kritiske sektioner osv.). Baseret på denne analyse opdeler den variablens levetid i faser: nogle er egnede til caching, andre kræver særlig håndtering.
I kritiske perioder, når der registreres samtidig adgang med skrivninger, indsætter compileren yderligere instruktioner i den genererede kode for at håndhæve cache-konsistens . Disse instruktioner kan fremtvinge cache-skylninger, hukommelsesgenindlæsninger, hukommelsesbarrierer eller adgang til områder markeret som ikke-cachebare, afhængigt af programmeringsmodellen og den underliggende arkitektur.
Forholdet mellem compiler, operativsystem og hardware
Udtrykket "compileren indsætter instruktioner i den genererede kode for at håndhæve cache-konsistens" kan få en til at tro, at operativsystemet læser disse instruktioner, som om de var hints på højt niveau , og baseret på det beslutter, hvordan programmet skal udføres. I virkeligheden er mekanismen noget anderledes.
Når compileren tilføjer disse typer instruktioner, introducerer den specifikke operationer i den binære fil, der understøttes af arkitekturen eller runtime-miljøet . For eksempel kan den indsætte instruktioner til at tømme cache, hukommelsesbarrierer, særlige instruktioner til at markere regioner som ikke-cachebare eller kald til operativsystemtjenester, der konfigurerer hukommelsesattributter.
Operativsystemet fortolker ikke disse instruktioner som "kommentarer" eller "hints" på højt niveau skrevet af compileren; det udfører blot maskinkoden som enhver anden . Nogle af disse instruktioner er dog designet til at interagere med hukommelsesundersystemet og cachestyringen og dermed ændre, hvordan CPU'en tilgår bestemte data.
Med andre ord udfører compileren en indledende analyse og genererer kode, der, når den udføres, producerer den ønskede cache-adfærd . Operativsystemet samarbejder ved at etablere hukommelsesattributter (cachebare eller ikke-cachebare områder, skrivepolitikker osv.) og levere synkroniseringsprimitiver, men det "læser" ikke specielle instruktioner i den forstand, at det fortolker dem semantisk, som en compiler ville gøre.
Det kan også ske, at hardwaren, når den ser bestemte instruktioner, aktiverer specifikke kohærens- eller synkroniseringsmekanismer . For eksempel garanterer hegns- eller barriereinstruktioner rækkefølgen af hukommelsesadgang og håndhæver bestemte synlighedseffekter på tværs af cachehierarkiet. I dette tilfælde er der et trevejssamarbejde: compileren bestemmer, hvor disse instruktioner skal placeres, operativsystemet konfigurerer udførelsesmiljøet, og hardwaren implementerer den faktiske adfærd på cache- og hukommelsesbusniveau.
Sammen sikrer alle disse elementer, at parallelle programmer kører med en ensartet hukommelsesmodel, selv med flere kopier af de samme data fordelt på tværs af forskellige cacher og hovedhukommelse . Cache-kohærens er langt fra at være en simpel intern CPU-detalje, men bliver en central komponent for, at multi-core-systemer kan fungere pålideligt og effektivt.
En forståelse af, hvordan cachehierarki, hardwarekohærensprotokoller og softwaresupportteknikker kombineres, gør det tydeligere, hvorfor moderne CPU-design deler en så lignende struktur, og hvorfor en lille fejl i en af disse mekanismer kan udløse kaotisk adfærd i samtidige applikationer , der er helt afhængige af, at alle kerner ser de samme data på det rigtige tidspunkt.