- Analyse af hardwarefunktionerne i både Raspberry Pi 4 og den kraftfulde Model 5.
- Udforskning af eksterne acceleratorer såsom AI HAT+ 2 for at optimere generativ inferens.
- Sammenligning mellem brugen af lokale kvantiserede modeller og understøttelse i eksterne API-infrastrukturer.
- Implementeringsmetoder ved hjælp af værktøjer som Ollama, llama.cpp og Python-miljøer.
Hvis du nogensinde har drømt om at have en smart assistent i JARVIS-stil kørende i dit eget hjem, uden at være afhængig af skyen og med fuldstændig privatliv, har du sikkert spekuleret på, om et lille board som Raspberry Pi kan klare det. Det korte svar er ja, selvom oplevelsen varierer meget afhængigt af, om du bruger den grundlæggende hardware eller beslutter dig for at tilføje ekstra kraft med specialiserede acceleratorer.
Kørsel af omfattende sprogmodeller (LLM) på edge computing gør det muligt at behandle data direkte på enheden. Dette eliminerer ikke kun månedlige gebyrer for cloud-tjenester, men sikrer også, at dine data forbliver i dit hjem – afgørende for dem, der værdsætter hjemmenetværks- og IoT-sikkerhed og ønsker at eksperimentere med AI uden eksterne begrænsninger.

Hardware og funktioner: Fra Pi 4 til Pi 5
Til at begynde med er det vigtigt at forstå, at ikke alle boards er skabt lige. På en Raspberry Pi 4 er det muligt at køre letvægtsmodeller, men ydeevnen er beskeden. Ved hjælp af værktøjer som Ollama kan du indlæse modeller som tinydolphin , som giver dig mulighed for at chatte via terminalen. Selvom den indledende opstartsproces kan tage et par minutter, og maskinen kan tage lidt tid om at "tænke", før den svarer, gør den det med en hastighed, der er acceptabel til simple opgaver , når den først begynder at skrive.
Med Raspberry Pi 5 forbedres situationen takket være dens mere kraftfulde ARM-arkitektur. Her bliver RAM den kritiske faktor; 8 GB RAM- versionen anbefales kraftigt . For at optimere pladsen anvendes kvantiseringsteknikker (såsom int4 eller 4-bit) , som reducerer modellens størrelse, så den kan passe i hukommelsen uden at ofre for meget nøjagtighed.
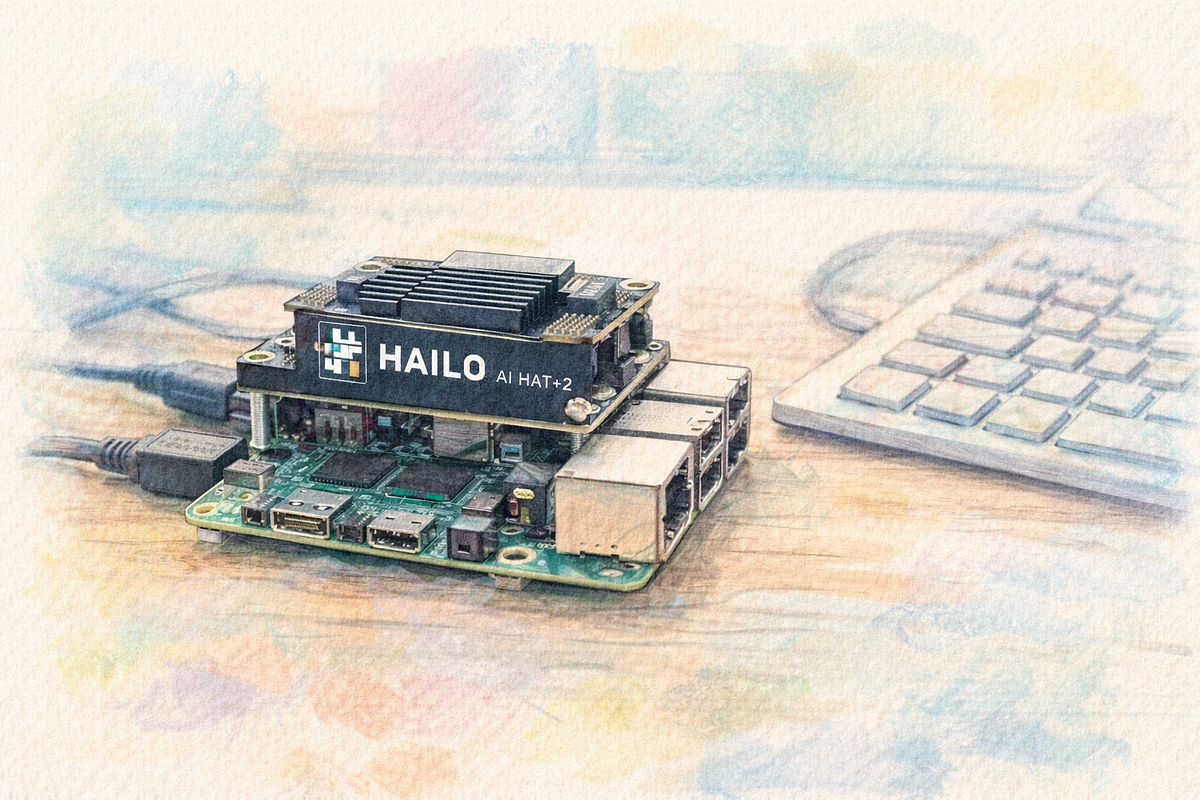
Til de mest krævende brugere er Raspberry Pi AI HAT+ 2 ankommet . Denne tilføjelse er banebrydende og integrerer Hailo-10H acceleratoren . Mens den tidligere HAT fokuserede på computer vision (objektdetektion eller scenesegmentering), er den nye model specifikt designet til at bygge bro over kløften inden for generativ AI og tilbyder 40 TOPS inferensydelse og 8 GB RAM dedikeret udelukkende til acceleratoren.

Teknisk implementering og software
Hvis du beslutter dig for at gå den rene softwarevej på en Pi 5, call.cpp Det er standardværktøjet. Modeller i GGUF-format (såsom Orca-Mini-3B) kan indlæses via Python-bindinger. Arbejdsgangen involverer oprettelse af et virtuelt miljø og installation af llama-cpp-python og konfigurere et script til at administrere processortråde og brugerprompter. For at overvåge, at boardet ikke går ned, er det meget nyttigt at bruge mprof, som giver dig mulighed for at analysere den maksimale RAM-hukommelse, der forbruges under udførelsen.
For dem, der køber AI HAT+ 2, bliver arkitekturen mere robust. Den ideelle fremgangsmåde er at installere Hailo-kernedriveren og dens tilhørende runtime. Af praktiske årsager anbefales det at konfigurere hailo-ollama som en systemtjeneste (systemd), der starter automatisk, når bundkortet tændes, og eksponerer en Ollama-kompatibel API på port 8000.
For at undgå altid at skulle håndtere kommandolinjen, kan du installere Åbn WebUIDenne webgrænseflade forvandler Raspberry Pi til en professionel chatserver, der er tilgængelig fra enhver browser på det lokale netværk. Konfiguration af OLLAMA_BASE_URL Korrekt, vi har en flydende grænseflade, der kommunikerer med Hailo-hardwaren, hvilket tillader brugen af modeller som f.eks. Qwen2 eller Qwen2.5-koder til lokal programmering og oversættelsesopgaver.
Anbefalede modeller og optimering
Det er afgørende at være realistisk: en model med 1 til 7 milliarder parametre, der kører på en Raspberry Pi, vil ikke kunne konkurrere med en GPT-4 eller en Claude, der har milliarder af parametre, inden for generel viden. Små modeller er dog fremragende, hvis de finjusteres . AI HAT+ 2 tillader brugen af LoRA (Low-Rank Adaptation) , hvilket betyder, at du kan tilpasse modellen til en meget specifik opgave uden at skulle omtræne hele systemet.
- TinyDolphin: Ideel til Raspberry Pi 4 på grund af dens meget lave strømforbrug.
- Orca-Mini-3B: En solid balance til Pi 5 ved hjælp af llama.cpp.
- Qwen2 / Qwen2.5: Optimeret til Hailo-10H-økosystemet, ideel til kodning og chat.
- VLM'er (Vision-Language Models): Kan beskrive billeder taget af Pi'ens kamera i realtid.
Hvis den lokale ydeevne forbliver utilstrækkelig til en produktionsapplikation, findes der et hybridalternativ. Du kan udvikle lokalt, men delegere inferens til eksterne API'er som SiliconFlow . Dette giver dig mulighed for at beholde logikken på Raspberry Pi, men få øjeblikkelige svar via skyen, til ekstremt lave omkostninger pr. million tokens, hvilket forhindrer enheden i at overophede eller blive langsommere.
Opsætning af en AI-node i kanten kræver tålmodighed, især med kerneafhængigheder på distributioner som Ubuntu Server. Brug af de officielle Raspberry Pi-repositories er ofte mere stabilt end at kompilere alt fra bunden. Selvom økosystemet stadig føles noget umodent, og der er uoverensstemmelser mellem GenAI-pakkeversioner og den officielle dokumentation, er slutresultatet et stille, privat og meget alsidigt system, der forvandler boardet til en selvstændig hjerne til hjemmeautomation.
