- LiteRT ersetzt TensorFlow Lite als Googles universelles Framework für die Ausführung von KI auf Mobilgeräten, Desktop-Computern und IoT-Geräten.
- Es optimiert die Inferenz durch die Nutzung von NPU, GPU und CPU und erzielt so Geschwindigkeitsverbesserungen von bis zu 100x im Vergleich zu herkömmlichen CPUs.
- LiteRT-LM ist spezialisiert auf die Orchestrierung von LLMs und generativen Modellen wie Gemma und verbessert so das Speichermanagement und den lokalen Kontext.
- Es bietet volle Kompatibilität mit PyTorch, JAX und TensorFlow und ermöglicht so die reibungslose Konvertierung von Modellen in das .tflite-Format.

Generative künstliche Intelligenz macht einen unglaublichen Sprung nach vorn, und es geht nicht mehr nur darum, Daten in die Cloud zu senden und auf eine Antwort zu warten. Der Clou ist nun, alles direkt auf dem Endgerät auszuführen , sei es ein Mobiltelefon oder ein Edge-Gerät, sodass die Nutzererfahrung unmittelbar ist und vor allem die Datensicherheit nicht von externen Servern abhängt.
In diesem Kontext tritt LiteRT in Erscheinung, Googles neuer Standard, der das etablierte TensorFlow Lite ablösen soll. Es handelt sich nicht um eine einfache Anpassung, sondern um eine universelle Infrastruktur , die es Entwicklern ermöglicht, leistungsstarke KI-Modelle auf jeder Plattform – von der Smartwatch bis zum Windows-PC – bereitzustellen und so die verfügbare Hardware optimal zu nutzen.

Was ist LiteRT und warum ist es so bahnbrechend?
LiteRT ist im Wesentlichen der Nachfolger von TensorFlow Lite und wurde entwickelt, um die Herausforderungen der Hardwarefragmentierung zu bewältigen. Während sich traditionelles maschinelles Lernen auf einfache Aufgaben wie die Bilderkennung konzentrierte, erfordert GenAI ein deutlich aggressiveres Ressourcenmanagement . Dieses Framework ermöglicht reproduzierbare und effiziente Inferenz, unabhängig davon, ob es sich um ein Android-, iOS-, macOS-, Linux-Gerät oder sogar eine Webanwendung handelt.
Für Gründer von Startups oder Entwickler von Technologieprodukten bedeutet dies einen kompletten Paradigmenwechsel. Durch die lokale Ausführung von Modellen wird die Latenz drastisch reduziert und wiederkehrende Kosten für Drittanbieter-APIs entfallen, sodass Anwendungen auch ohne Internetverbindung einwandfrei funktionieren.
Die Beschleunigungs-Engine: CPU-, GPU- und NPU-Leistung

Die wahre Stärke von LiteRT liegt in seiner Fähigkeit, die maximale Leistung aus jedem Chip herauszuholen. Dank einer Engine namens ML Drift kann das System die GPU-Beschleunigung über verschiedene APIs wie Metal, OpenCL, OpenGL und WebGPU steuern. Unter Android priorisiert die Laufzeitumgebung sogar automatisch OpenCL, sofern verfügbar, und greift nur im Notfall auf OpenGL zurück.
LiteRT glänzt jedoch vor allem durch seine NPU (Neural Processing Unit). Dank der Zusammenarbeit mit Qualcomm ermöglicht der QNN-Beschleuniger Geschwindigkeitssteigerungen, die in bestimmten Szenarien bis zu 100-mal schneller sind als die einer CPU und sogar 10-mal schneller als die einer GPU. Dadurch wird KI von einem langsamen Experiment zu einem praktikablen Produktionswerkzeug.
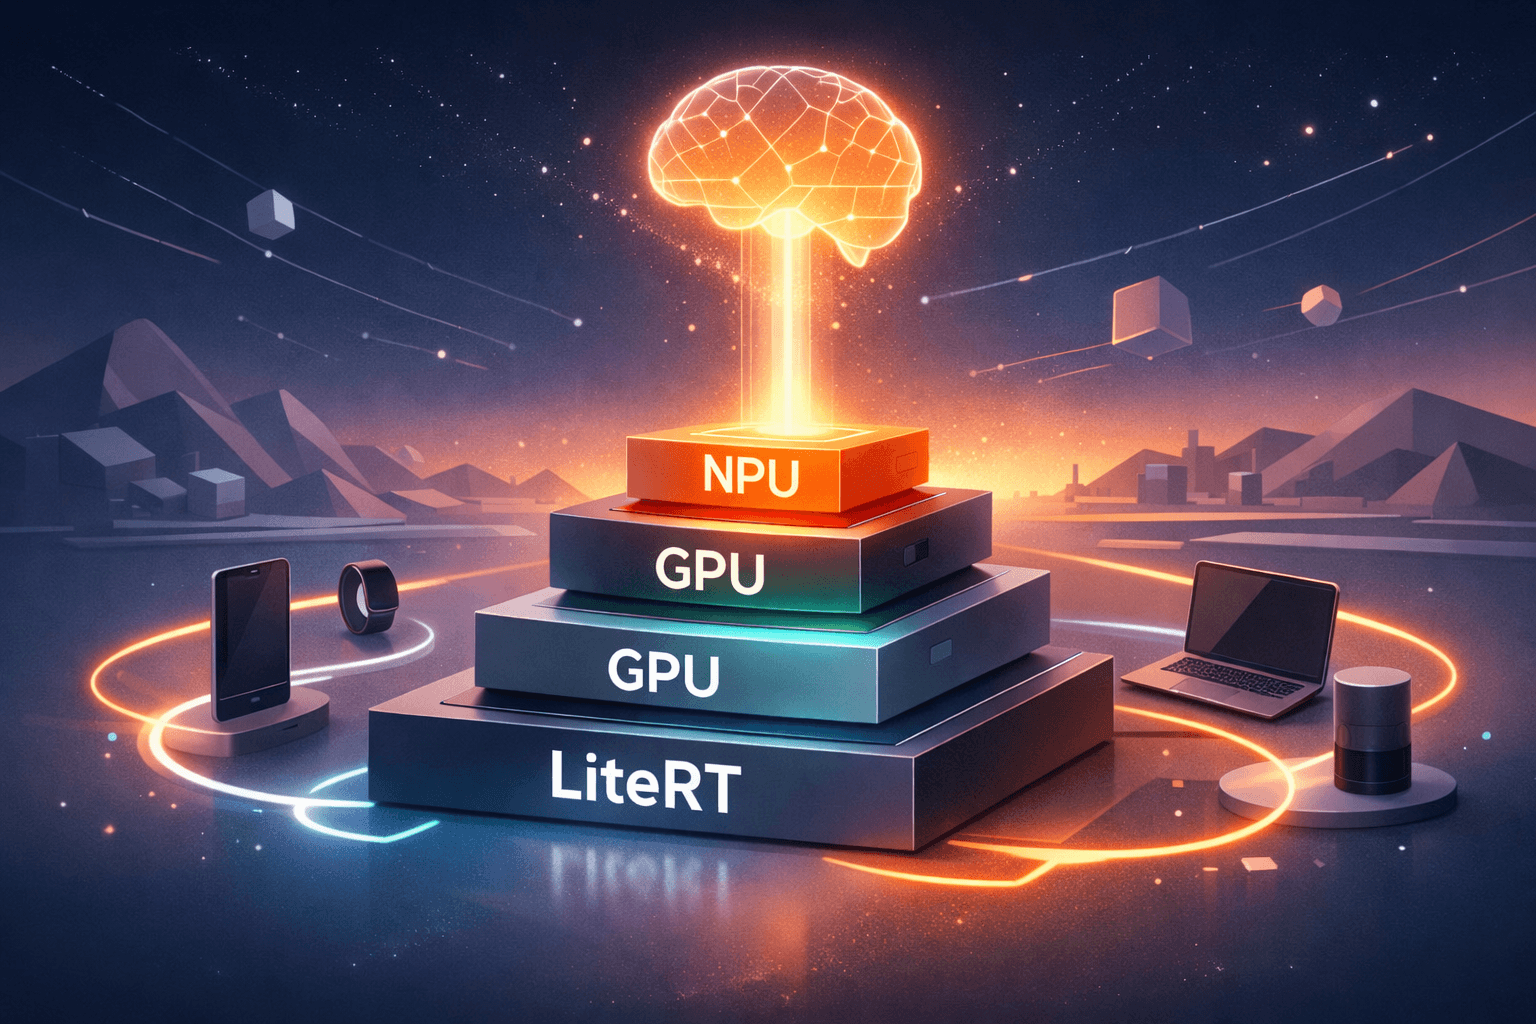
LiteRT-LM: Orchestrierung von generativer KI und LLMs
Bei großen Sprachmodellen (LLMs) wird es kompliziert, da es sich nicht um einfache Modelle, sondern um komplexe Verarbeitungsketten handelt. Hier kommt LiteRT-LM ins Spiel , eine spezialisierte Orchestrierungsschicht, die Speicher, Puffer und Kontext effizient verwaltet. Dieselbe Technologie steckt auch hinter Gemini Nano auf der Pixel Watch und in Chrome.

Um Programmierern die Arbeit zu erleichtern, hat Google die LiteRT Torch Generative API integriert. Dieses Tool ermöglicht die einfache Konvertierung von PyTorch-basierten Modellen und sorgt dafür, dass offene Modelle wie Gemma extrem schnell auf dem Gerät ausgeführt werden können. In realen Benchmarks hat LiteRT nachweislich die Geschwindigkeit von Prefill und Dekodierung gegenüber llama.cpp übertroffen, indem es die Hardware besser nutzt.
Technische Innovationen: Zero-Copy- und asynchrone Ausführung
Einer der häufigsten Engpässe bei mobiler KI ist der Datenaustausch zwischen CPU und Beschleuniger. LiteRT löst dieses Problem durch Zero-Copy-Pufferverwaltung , wodurch unnötige Datenredundanz im Speicher verhindert wird. Das Modell liest die Informationen quasi direkt von ihrem Speicherort, wodurch Aufgaben wie die Hintergrundsegmentierung bis zu doppelt so schnell ausgeführt werden.
Darüber hinaus ermöglicht die neue CompiledModel-API die asynchrone Ausführung von Inferenzprozessen. Dadurch friert die Anwendung nicht ein, während die KI die Daten verarbeitet, was die Benutzerfreundlichkeit verbessert. Das System evaluiert die Hardware in Echtzeit und wählt den optimalen Beschleuniger aus, ohne dass Entwickler für jeden Chip spezifischen Code schreiben müssen.
Rahmenflexibilität und strategische Umsetzung
Das Beste daran ist, dass Sie nicht auf eine einzige Programmiersprache beschränkt sind. LiteRT ist kompatibel mit PyTorch, JAX und TensorFlow . Falls Sie bereits eine Trainingspipeline eingerichtet haben, müssen Sie diese nicht verwerfen; Sie können Ihre Modelle in das .tflite- Format konvertieren und auf jedem unterstützten Betriebssystem bereitstellen.
Für Unternehmen erfordert die Implementierung eine klare Strategie. Das Modell allein genügt nicht; es muss mit individueller Softwareentwicklung und einer Cloud-Computing-Infrastruktur kombiniert werden, damit die KI bei Bedarf skalierbar ist. Darüber hinaus wird Cybersicherheit bei der Integration von KI in Endgeräte entscheidend , da unbedingt sichergestellt werden muss, dass sensible Daten niemals die Hardware des Nutzers verlassen.
Die Anwendung dieses Standards ermöglicht die Entwicklung autonomer Agenten, die in Echtzeit reagieren und so die Abhängigkeit von teuren Servern verringern. Unternehmen, die heute lokale Inferenz integrieren , erzielen im Vergleich zu solchen, die weiterhin ausschließlich auf die Cloud setzen, einen deutlichen Wettbewerbsvorteil hinsichtlich Kosten, Datenschutz und Reaktionsgeschwindigkeit.

Index