- Vergleichende Analyse zwischen den fortschrittlichsten proprietären Modellen und der neuen Generation von Modellen mit offenem Gewichtsbereich.
- Lokale Bereitstellungsstrategien unter Verwendung von Tools wie Ollama, LM Studio und spezifischen Bibliotheken für C#.
- Technische Kriterien für die Auswahl der Quantisierung und des Modells entsprechend dem VRAM und der Entwicklungsaufgabe.
Als Programmierer haben Sie wahrscheinlich schon bemerkt, wie rasant sich Code-Assistenten weiterentwickeln. Was gestern noch Standard war, ist heute überholt, und die Tatsache, dass sich die Tools wöchentlich ändern, kann überwältigend sein. Angesichts stetig steigender monatlicher Abonnementsgebühren und der permanenten Unsicherheit darüber, wo unsere Daten landen, ist die Installation von KI auf dem eigenen Computer für alle, die volle Kontrolle und Privatsphäre wünschen, zur intelligentesten Option geworden.
Es geht nicht nur darum, ein paar Euro im Monat zu sparen, sondern darum, API-Abhängigkeiten zu beseitigen und zu verhindern, dass der vertrauliche Code Ihres Unternehmens auf den Servern großer Technologiekonzerne landet. Ob Sie nun eine Unterstützung für die Verwaltung des Tailwind-Frontends suchen oder eine leistungsstarke Lösung benötigen, die ein komplettes Monorepo verwalten kann – das aktuelle Ökosystem bietet Optionen, die in vielen Fällen mit den teuersten kostenpflichtigen Modellen auf dem Markt mithalten können.
Die Modelllandschaft: Proprietäre Modelle vs. Open-Weights
Wenn es um leistungsstarke Systeme geht, ist der Markt recht uneinheitlich. Auf der einen Seite stehen proprietäre Modelle wie die Claude-Familie von Anthropic. Claude Sonnet 4.6 hat sich dank seiner ausgewogenen Kombination aus Geschwindigkeit und Genauigkeit als idealer Begleiter im Alltag etabliert, während Claude Opus 4.8 die optimale Lösung für umfangreiche Refactorings und komplexe Systemarchitekturen darstellt und sich durch seine Fähigkeit auszeichnet, Fehler selbst zu erkennen, bevor er eine Antwort akzeptiert.
OpenAI setzt weiterhin auf Rechenleistung und Terminaldominanz mit GPT-5.5 , das unschlagbar ist, wenn Ihr Workflow auf Skripten und Konsolenautomatisierung basiert. Allerdings neigt es mitunter zu einer höheren Rate an Fehlalarmen als seine Konkurrenten. Google hingegen feiert mit Gemini 3.1 Pro ein Comeback . Das Programm integriert Deep Reasoning und bietet einen sehr attraktiven Preis, der es ideal für alle macht, die visuelles Design und Programmierung kombinieren.
Doch was wirklich spannend ist, sind die Entwicklungen im Open-World-Bereich. Modelle wie GLM-5 haben neue Maßstäbe gesetzt, sich an die Spitze des Marktes für Open-Weights-Modelle gesetzt und ermöglichen es ganzen Teams, ein Flaggschiffmodell ohne API-Anbindung zu nutzen. Hinzu kommt Kimi K2.5 , ein Gigant, der das Konzept des Agentenschwarms einführt . Bis zu hundert Subagenten können parallel an der Lösung einer technischen Aufgabe arbeiten und so die Ausführungszeiten in großen Projekten drastisch reduzieren.
So richten Sie Ihre lokale KI-Umgebung ein
Um diese Modelle auf Ihrem eigenen Rechner auszuführen, benötigen Sie keine besonderen Kenntnisse im Bereich der Bereitstellung. Die einfachste und beliebteste Option ist Ollama , das als Modellmanager fungiert und es Ihnen ermöglicht, Versionen wie Llama 3 oder Gemma mit einem einzigen Befehl herunterzuladen und auszuführen. Wenn Sie eine visuellere Oberfläche und Werkzeuge zum Testen verschiedener Quantisierungen bevorzugen, ist LM Studio die richtige Wahl, da es die Speicherverwaltung und das Herunterladen von Dateien im GGUF-Format vereinfacht.
Für Entwickler, die KI direkt in ihre Anwendungen integrieren möchten, gibt es weitere technische Ansätze. Im .NET-Ökosystem kann man beispielsweise OllamaSharp verwenden, um über HTTP mit dem lokalen Server zu kommunizieren, oder, wenn man die volle Kontrolle wünscht, LlamaSharp . Letztere Bibliothek ermöglicht es, Modellgewichte direkt in die Anwendung zu laden und die Anzahl der an die GPU gesendeten Schichten anzupassen, um die Leistung basierend auf der verfügbaren Hardware zu optimieren.
Hardware- und VRAM-Optimierung
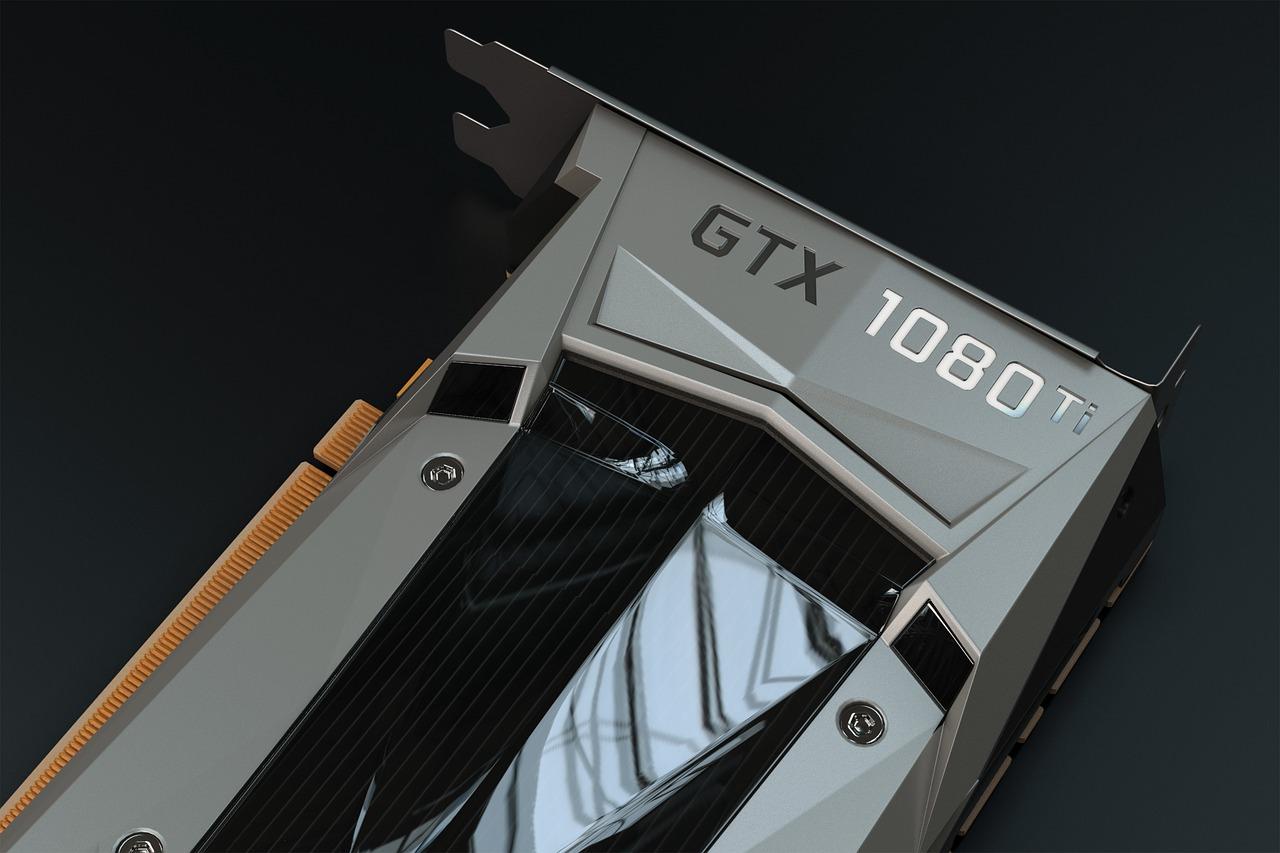
Ein häufiger Fehler ist die Auswahl eines Modells allein anhand der technischen Daten, ohne den Videospeicher zu berücksichtigen. Bei einer Grafikkarte wie der 16 GB RTX 5070 Ti ist die Modellgröße entscheidend. Ist sie zu groß für den Videospeicher, lagert das System Ressourcen in den Arbeitsspeicher aus, wodurch die GPU nicht ausreichend ausgelastet wird , die Reaktionszeiten drastisch sinken und die CPU-Auslastung sprunghaft ansteigt.
Der Schlüssel liegt in der Quantisierung, üblicherweise mit dem Buchstaben Q abgekürzt. Eine Quantisierung von 4 Bit ist in der Regel optimal, da sie die Modellgröße deutlich reduziert, ohne die Antwortqualität wesentlich zu beeinträchtigen. Es ist entscheidend, genügend Speicher für den Kontext freizuhalten . Wird der VRAM ausschließlich mit dem Modell belegt, reicht der Speicherplatz nicht aus, damit die KI die übergebenen Dateien speichern kann. Dies führt zu Kapazitätsfehlern oder inkonsistenten Antworten.
Kriterien für die Auswahl des richtigen Modells
Es gibt kein perfektes Modell, sondern für jede Aufgabe das passende. Wenn Ihr Ziel reines Programmieren ist, suchen Sie nach programmierorientierten Modellen, die Ihre Programmiersprache gut verstehen, sei es JavaScript, TypeScript oder Rust. Ein solches Modell schreibt nicht nur Funktionen, sondern kann auch Fehler erklären und Dateien bearbeiten, ohne die bestehende Projektlogik zu beeinträchtigen.
- Zum Chatten und Schreiben: Wählen Sie Varianten Anweisen, die darauf abgestimmt sind, Befehle zu befolgen und natürliche Gespräche zu führen.
- Zur Dokumentenanalyse: Priorisieren Sie Modelle mit einem breites Kontextfenster und semantische Suchwerkzeuge, um zu verhindern, dass KI Daten fälscht.
- Für Bildverarbeitung und Frontend: Multimodale Modelle sind unerlässlich, wenn Sie KI benötigen, um Screenshots oder Diagramme zu analysieren und in CSS/HTML-Code umzuwandeln.
- Zur Automatisierung: Suchen Sie nach Modellen, die Folgendes unterstützen JSON-strukturierte Ausgaben und Funktionsaufrufe.
Um herauszufinden, welches Gerät am besten für Sie geeignet ist, empfiehlt sich ein Vergleichstest. Nehmen Sie zwei Modelle, geben Sie ihnen dieselben fünf Anweisungen und bewerten Sie deren Genauigkeit, Klangqualität und Geschwindigkeit . Letztendlich ist nicht das Modell mit dem höchsten Testergebnis das beste, sondern dasjenige, das in Ihrem tatsächlichen Arbeitsablauf am besten abschneidet.
Das lokale KI-Ökosystem ist mittlerweile so weit entwickelt, dass die Unterschiede zu proprietären Modellen für viele Entwicklungsaufgaben kaum noch relevant sind. Durch die Kombination von Tools wie Ollama oder Cursor mit offenen Modellen wie GLM-5 oder Qwen kann jeder Programmierer einen erstklassigen Assistenten nutzen, ohne seine Privatsphäre zu gefährden oder hohe Abonnementgebühren zu zahlen. Gleichzeitig behält er die volle Kontrolle über die Ausführung und den Einsatz seiner Projekte.