- Architektonische Unterschiede zwischen CPU und GPU, die massives paralleles Rechnen ermöglichen.
- Cloud-Bereitstellungsstrategien unter Verwendung von Standard-, Spot- und flexiblen Bereitstellungsmodellen.
- Kritische technische Kriterien für die Hardwareauswahl basierend auf VRAM, Bandbreite und Latenz.
- Fortschrittliche Programmier- und globale Orchestrierungssysteme zur Optimierung des Einsatzes von KI-Clustern.

Wenn es um die Rechenleistung für die Verarbeitung riesiger Datenmengen geht, kommt man an der fundamentalen Rolle von Grafikprozessoren (GPUs) nicht vorbei. Ursprünglich für die beeindruckende Grafik von Videospielen entwickelt, sind sie heute der Motor künstlicher Intelligenz und massiver Datenanalyse und ermöglichen es, Aufgaben, die früher Wochen dauerten, in nur wenigen Stunden zu erledigen.
Die Verlagerung dieser Workloads in die Cloud hat die Arbeitswelt für Entwickler und Data Scientists grundlegend verändert. Es ist nicht mehr nötig, ein Vermögen für Hardware auszugeben, die schnell veraltet; stattdessen können wir Rechenleistung mieten, die genau auf unsere Bedürfnisse zugeschnitten ist, die Ressourcen je nach Projekt skalieren und jeden in die Infrastruktur investierten Cent optimal nutzen.

CPU vs. GPU: Was ist der wirkliche Unterschied?
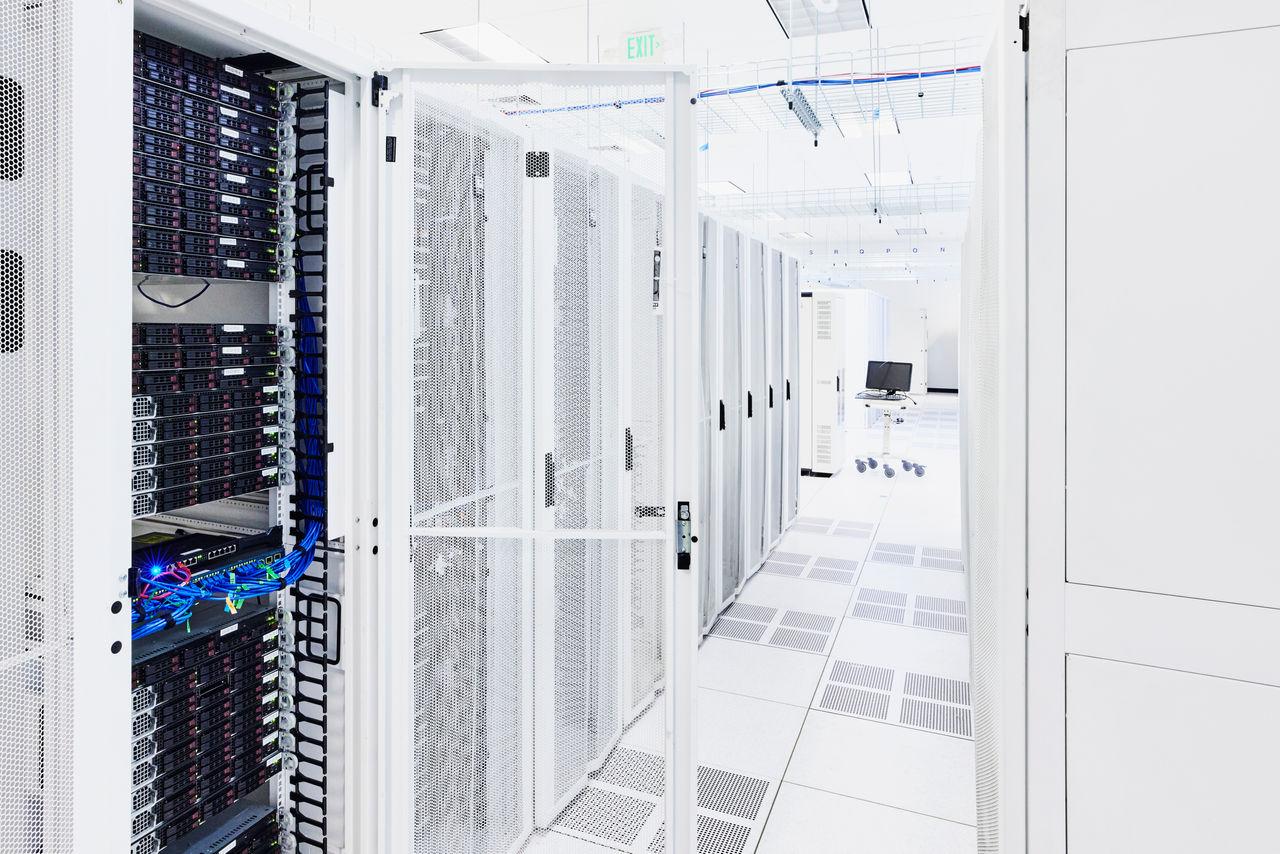
Vereinfacht gesagt, ist die CPU wie ein hochintelligenter Dirigent, der alles kann, aber Aufgaben nacheinander abarbeitet. Die GPU hingegen ist wie eine Armee von Tausenden von Prozessoren, die darauf spezialisiert sind, dieselbe mathematische Operation immer wieder, aber gleichzeitig, auszuführen. Dies ist die Grundlage dessen, was wir Parallelrechnen nennen.
Während die CPU komplexe Logik und Systemsteuerung übernimmt, glänzt die GPU bei Matrixverarbeitung und Bildrendering. Dank ihrer Hunderten oder Tausenden von Kernen , ähnlich einer Mehrkern-CPU-Architektur , jedoch in massivem Umfang, kann sie mehrere Teilaufgaben gleichzeitig ausführen – unerlässlich für das Training neuronaler Netze oder die Verarbeitung von Terabytes an Daten ohne Systemabsturz.
Stapel- und Echtzeit-Auftragsverwaltung
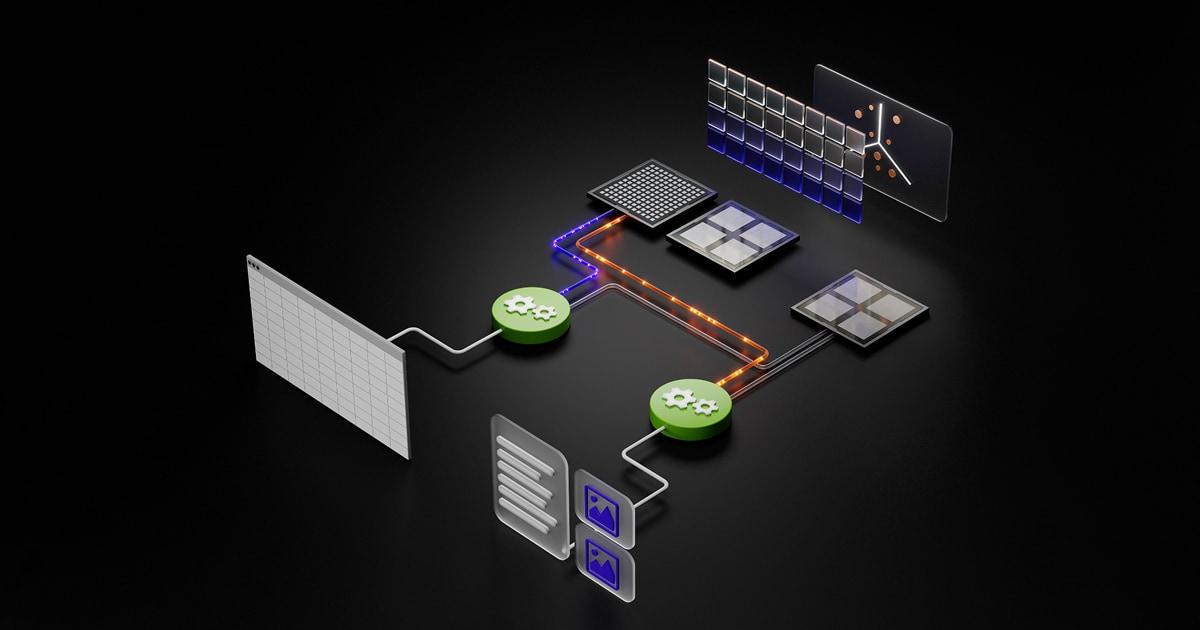
Im Cloud-Ökosystem gibt es zwei Hauptmethoden zur Ausführung dieser Aufgaben. Die Stapelverarbeitung eignet sich ideal für Jobs, die keine sofortige Antwort erfordern, wie z. B. Datenvorverarbeitung oder umfangreiche Inferenz. Hierbei geht es darum, die Effizienz und die Gesamtleistung des Systems zu maximieren , indem Jobs gesammelt und ausgeführt werden, sobald Ressourcen verfügbar sind.
Andererseits ist Echtzeitverarbeitung entscheidend für Anwendungen, die sofort reagieren müssen, wie beispielsweise generative KI-Chatbots oder Gesichtserkennungssysteme. In diesen Fällen haben geringe Latenz und hohe Verfügbarkeit absolute Priorität, um sicherzustellen, dass der Endnutzer keine Verzögerungen bemerkt, während das Modell die Informationen verarbeitet.
Für die Umsetzung eines solchen Projekts ist eine sorgfältige Planung der Anforderungen unerlässlich. Von der Auswahl der richtigen Maschine bis zur Treiberinstallation ( die automatisch oder manuell mithilfe benutzerdefinierter Images erfolgen kann) beeinflusst jeder Schritt, ob der Prozess reibungslos verläuft oder zu technischen Problemen führt.
Verbrauchsmodelle und Kostenoptimierung
Virtuelle Maschinen sind nicht alle gleich, und auch die Kosten variieren. Für alle, die Geld sparen möchten, sind Spot-VMs eine verlockende Option mit hohen Rabatten. Allerdings besteht das Risiko, dass die Cloud sie jederzeit zurückfordert. Sie eignen sich ideal für ausfallsichere Anwendungen, bei denen die Kosten im Vordergrund stehen.
Benötigen Sie eine stabilere, aber kostengünstigere Lösung? Dann sind flexible Startup-VMs eine Option . Diese ermöglichen den Zugriff auf GPU-Ressourcen zu reduzierten Preisen, allerdings mit einer kurzen Wartezeit bis zum Arbeitsbeginn. Für unternehmenskritische Projekte stehen Ihnen die Standard-Bereitstellung auf Abruf oder geplante Reservierungen zur Verfügung. So ist die Hardware genau dann verfügbar, wenn Sie sie benötigen.

Eine fortgeschrittene Technik zur Budgetoptimierung ist die regionale Kostenarbitrage . Durch die Ausnutzung von Preisunterschieden in verschiedenen geografischen Gebieten oder durch die Anwendung von „Follow-the-Sun“-Planung können Teams in Asien, Europa und Amerika die Cluster abwechselnd nutzen und so eine nahezu 100%ige Hardwareauslastung erreichen.
Wie Sie die richtige GPU für Ihren Anwendungsfall auswählen

Es geht nicht darum, die teuerste Grafikkarte zu wählen, sondern diejenige, die am besten für die jeweilige Aufgabe geeignet ist. Beim Training großer Sprachmodelle (LLM) ist der Videospeicher (VRAM) der Hauptengpass. Wenn der VRAM nicht ausreicht, müssen die Batchgrößen reduziert werden, was die Ausführungszeiten und die Gesamtkosten erheblich erhöht.
- KI-Training: Es erfordert hohe Rechenleistung in gemischter Präzision (FP16/BF16) und einen großzügigen VRAM zur Verarbeitung von Gradienten und Optimiererzuständen.
- Echtzeit-Inferenz: Hierbei sind Netzwerklatenz und Stabilität des Software-Stacks entscheidend, um Produktionsausfälle zu vermeiden.
- Datenwissenschaft: Es wird ein ausgewogenes Verhältnis zwischen CPU, RAM und GPU angestrebt, da ein Großteil der Datenbereinigung immer noch eine sequentielle Aufgabe ist.
- 3D-Rendering und visuelle Effekte: Sie sind entscheidend auf Speicherbandbreite angewiesen, um komplexe Texturen und Geometrien schnell zu übertragen.
- Wissenschaftliche Berechnungen: Sie priorisieren die Genauigkeit nach FP32 oder FP64 und die exakte Reproduzierbarkeit der Ergebnisse durch feste Treiberversionen.
Es ist unerlässlich, den Datenfluss des Systems zu überwachen . Eine extrem leistungsstarke GPU ist nutzlos, wenn die CPU oder der Speicher langsam sind; in diesem Fall verbringt die GPU die meiste Zeit im Leerlauf und wartet auf Daten, was als Ressourcenunterauslastung bezeichnet wird.
Fortschrittliche Orchestrierung und die Zukunft des Rechnens
Mit dem Wachstum von Clustern reicht die einfache „First-In-First-Out“-Planung nicht mehr aus. Führende Unternehmen implementieren daher mehrstufige Planungshierarchien , die Aufträge anhand des Datenstandorts, der Geschäftspriorität und des CO₂-Fußabdrucks der Region verteilen.

Innovationen wie die Echtzeit -Umschaltung zwischen CPU und GPU ermöglichen es dem System, in Echtzeit zu entscheiden, welcher Prozessor für jeden Thread am effizientesten ist. Dies begegnet dem globalen Hardwaremangel, indem jeder verfügbare Taktzyklus optimiert wird und generative KI sowie digitale Zwillinge weiterentwickelt werden können, ohne durch fehlende Chips ausgebremst zu werden.
Durch den Einsatz von Kubernetes mit dynamischer Ressourcenzuweisung (DRA) und Multi-Instance-GPU-Technologie (MIG) kann eine einzelne physische Grafikkarte in mehrere virtuelle Instanzen aufgeteilt werden. Dies demokratisiert den Zugang zu Hochleistungsrechnern und ermöglicht es mehreren Benutzern, dieselbe GPU gemeinsam zu nutzen, ohne sich gegenseitig zu beeinträchtigen.
Nur eine klare Strategie, die die richtige Hardware, ein intelligentes Zahlungsmodell und flexible Orchestrierung kombiniert, lässt sich bei Cloud Computing vermeiden. Von der VRAM-Auswahl bis zur Bereitstellung von Spot-Instanzen beeinflusst jede technische Entscheidung direkt die Innovationsgeschwindigkeit und die Rentabilität jedes fortschrittlichen Computing-Projekts.
