- Cache-Kohärenz gewährleistet, dass alle Kopien derselben Daten in verschiedenen Caches und im RAM auf Mehrkernsystemen konsistent bleiben.
- Die Cache-Hierarchie mit einer gemeinsam genutzten letzten Ebene vereinfacht die Konsistenzkontrolle und reduziert direkte Zugriffe auf den Hauptspeicher.
- Kohärenzprotokolle verwenden Kopierinvalidierungs- oder Aktualisierungsstrategien, die durch Zustände und Steuerbits pro Cache-Zeile unterstützt werden.
- Der Compiler und das Betriebssystem können die Hardwarekonsistenz ergänzen, indem sie Anweisungen einfügen und den Speicher für kritische Zeiträume konfigurieren.
Betrachtet man ein Diagramm eines modernen Mehrkernprozessors, zeigt sich stets dasselbe Muster: mehrere Kerne, jeder mit eigenem Cache, und ein gemeinsamer L1-Cache, der als Zwischenspeicher vor dem Zugriff auf den Arbeitsspeicher dient. Diese Anordnung ist kein Zufall und keine Laune der Entwickler, sondern eine direkte Antwort auf ein kritisches Problem in parallelen Systemen: die Cache-Kohärenz.
Ohne einen robusten Konsistenzmechanismus könnte jeder Kern mit einer anderen und veralteten Version derselben Daten im Speicher arbeiten , was in realen Programmen zu subtilen Fehlern, unvorhersehbaren Ausfällen und sogar Systemabstürzen führen kann. Daher ist das Verständnis, wie diese Konsistenz – sowohl auf Hardware- als auch auf Softwareebene – aufrechterhalten wird, entscheidend für das Verständnis der Leistungsfähigkeit und Stabilität moderner Mehrkernprozessoren.
Was ist Cache-Kohärenz: die Terminal-Metapher

Stellen Sie sich mehrere Personen vor, die an verschiedenen Terminals sitzen und alle dasselbe Dokument bearbeiten, das auf einem zentralen Server gespeichert ist . Jeder Bildschirm zeigt eine Kopie der Datei an, und Änderungen, die eine Person vornimmt, sollen sich sofort auf den Bildschirmen aller anderen widerspiegeln.
Damit dies funktioniert, ist ein Synchronisierungsmechanismus erforderlich , der Dokumentänderungen an alle Endgeräte weitergibt, sodass alle stets dieselbe Version sehen. Solange dieses System funktioniert, ist alles in Ordnung: Wer den Text ändert, weiß, dass alle anderen die neue Version nahezu sofort sehen werden.
Stellen Sie sich nun vor, das Synchronisierungssystem fällt plötzlich aus. Jeder bearbeitet das Dokument weiter, überzeugt davon, am gemeinsamen Dokument zu arbeiten, doch in Wirklichkeit verfügt jedes Terminal über eine eigene, voneinander getrennte lokale Kopie . Von diesem Moment an erreichen Änderungen einer Person die anderen nicht mehr, und das Dokument beginnt sich unkontrolliert zu verändern.
Im Bereich der Informatik würde genau dies passieren, wenn der CPU ein zuverlässiges Konsistenzprotokoll fehlte: Ein Kern ändert Daten im Speicher, während die anderen Kerne weiterhin eine ältere Version aus ihren privaten Caches lesen . Dies schafft ideale Voraussetzungen für schwerwiegende logische Fehler, Datenbeschädigung und unerwünschtes Verhalten.
Cache-Kohärenz bezeichnet daher die Mechanismen, die in einem Mehrkernsystem sicherstellen, dass alle Kopien derselben Daten, die über die verschiedenen Caches und den Arbeitsspeicher verteilt sind, einen konsistenten Zustand beibehalten . Selbst wenn mehrere Kopien existieren, muss sich das System so verhalten, als gäbe es nur eine.
Caches und Speicherhierarchie in einer Mehrkern-CPU
CPU-Caches sind kleine, sehr schnelle Speicher, die Kopien häufig genutzter RAM-Abschnitte enthalten . Wenn der Prozessor Code ausführt, greift er nicht ständig auf den (vergleichsweise langsamen) RAM zu, sondern liest und schreibt Daten aus dem Cache, wodurch die Latenz drastisch reduziert wird.
Der Clou ist natürlich, dass Caches nicht die „offizielle Version“ der Daten speichern, sondern nur eine temporäre Kopie . Um bei der Terminal-Metapher zu bleiben: Der Arbeitsspeicher (RAM) wäre das Dokument auf dem Server, während die Caches die lokalen Bildschirme wären, die Kopien bestimmter Teile der Datei anzeigen.
Bei Mehrkernprozessoren wird der Aufbau komplexer, da jeder Kern typischerweise über eigene private Level-1- (L1) und sogar Level-2- (L2) Caches verfügt . Darüber hinaus befindet sich beispielsweise ein gemeinsamer Level-3-Cache zwischen den Kernen und dem Speichercontroller, der den Zugriff auf den Arbeitsspeicher (RAM) ermöglicht.
Dieser gemeinsam genutzte Cache wird eingeführt, da der direkte und intensive Zugriff aller Kerne auf den Arbeitsspeicher zu Zugriffskonflikten, Engpässen auf dem Speicherbus und einem erheblichen Leistungsabfall führen würde . Der Last-Level-Cache dient als gemeinsamer „Puffer“, der die Arbeitsspeicherzugriffe reduziert und einen Großteil des Datenverkehrs zentralisiert.
Viele Architekturen organisieren Caches zudem inklusiv: Zeilen, die in prozessornahen Ebenen gespeichert sind, befinden sich auch in höheren Hierarchieebenen . Das heißt, eine Zeile, die in L1 vorkommt, ist auch in L2 und somit auch in L3 vorhanden. Dies hat einen sehr nützlichen Vorteil für die Datenkonsistenz: Es genügt, den Cache der untersten Ebene korrekt zu aktualisieren, um den Zustand der anderen Ebenen zu steuern, ohne ständig auf den Arbeitsspeicher zugreifen zu müssen.
Warum Last-Level-Shared-Caching der Schlüssel zur Konsistenz ist
Ohne diesen globalen Last-Level-Cache müsste jeder Kern die Konsistenz direkt im Hauptspeicher prüfen . Jedes Mal, wenn eine Speicherzeile im privaten Cache geändert würde, müsste geprüft werden, ob andere Kerne eine Kopie derselben Zeile besitzen, und diese gegebenenfalls überall aktualisieren oder ungültig machen.
In einem System mit vielen Kernen würde diese Prüflast zu einer enormen Anzahl von RAM-Transaktionen führen und den Vorteil schneller Caches weitgehend zunichtemachen. Durch die Nutzung eines gemeinsamen Caches zwischen Kernen und Speicher kann die CPU die Kohärenzsteuerung an einem einzigen Zwischenspeicherort konzentrieren.
In vielen Implementierungen enthalten die Caches höherer Ebenen (weiter vom Prozessor entfernt) Kopien der Zeilen der Ebenen näher am Kern . Dank dieser Struktur muss das Kohärenzprotokoll lediglich sicherstellen, dass die letzte Ebene mit dem Hauptspeicher synchronisiert ist und dass die privaten Ebenen jedes Kerns mit der unmittelbar darüber liegenden Ebene synchronisiert sind.
Man kann sich das wie eine russische Matrjoschka vorstellen: Der Cache der dritten Ebene enthält die Inhalte der zweiten und ersten Ebene , die zweite Ebene enthält ihre eigenen Inhalte und die der ersten Ebene, und die erste Ebene kennt nur ihre eigenen Zeilen. Indem das System die „große Puppe“ (die letzte Ebene) steuert, kann es die übrigen Ebenen effizienter koordinieren.
Das Ergebnis ist, dass die Aufrechterhaltung der Konsistenz hinsichtlich Design und Speichernutzung effizienter wird . Anstatt jeden Kern zu zwingen, ständig auf den Arbeitsspeicher zuzugreifen, arbeitet das Protokoll mit dem gemeinsamen Cache und steuert von dort aus, welche Zeilen in den privaten Caches aktualisiert oder ungültig gemacht werden sollen.
Aktualisierungsmethoden: Ungültigmachung und Aktualisierung von Kopien
Ein kritisches Problem entsteht, wenn zwei oder mehr Kerne nahezu gleichzeitig auf dieselbe Datenzeile zugreifen möchten, die über mehrere Caches repliziert ist . In diesem Fall verwenden Konsistenzsysteme typischerweise zwei grundlegende Strategien für die Verarbeitung von Schreibvorgängen.
Die erste Methode basiert auf der Ungültigmachung. Wenn ein Kernel in eine bestimmte Cache-Zeile schreiben muss, ungültig macht das Protokoll alle Kopien derselben Zeile in den anderen Caches . Nur der Kernel, der schreiben möchte, hält die Zeile les- und schreibfähig; die anderen Kernel müssen die Zeile, wenn sie diese Daten erneut verwenden möchten, aus dem übergeordneten Cache (oder aus dem Speicher) mit der aktualisierten Version neu laden.
Die zweite Strategie besteht in der Aktualisierung. Wenn der Kernel in diesem Fall eine Zeile ändert, versucht das System, den neuen Inhalt automatisch an bestehende Kopien in den anderen Caches weiterzugeben . Dadurch erhalten alle Caches, die diese Zeile gespeichert haben, die aktualisierte Version, ohne dass sie später ungültig gemacht und neu geladen werden müssen.
Beide Ansätze haben ihre Vor- und Nachteile. Die Ungültigmachung ist in der Regel effizienter bei häufigen Schreibvorgängen, da sie eine Überlastung des Speichersystems durch Aktualisierungen vermeidet, die andere Kerne möglicherweise nicht sofort benötigen. Umgekehrt kann die Aktualisierung vorteilhaft sein, wenn viele Kerne häufig dieselben Daten lesen, die relativ selten geändert werden , da sie die Latenz reduziert, weil die Zeile nach jeder Ungültigmachung nicht neu geladen werden muss.
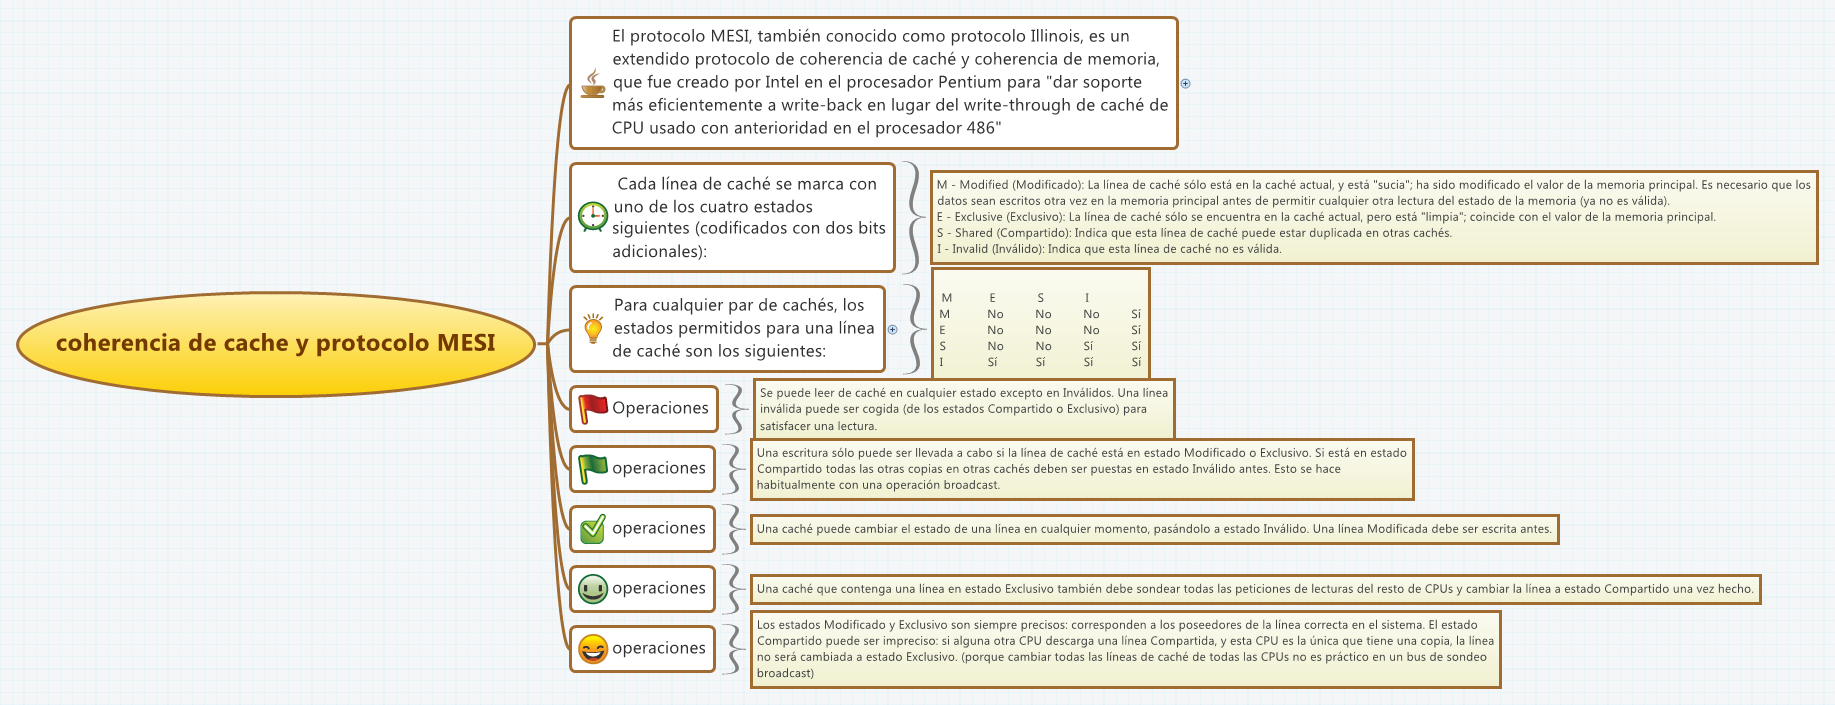
Beide Methoden nutzen zusätzliche Zustände und Steuerbits in den Cache-Zeilen. Jede Zeile enthält typischerweise Informationen darüber, ob ihr Inhalt mit dem des Arbeitsspeichers übereinstimmt und ob sie – abhängig vom verwendeten Protokoll (MESI, MOESI, MSI usw.) – gemeinsam genutzt, modifiziert, exklusiv, reserviert usw. ist. Dadurch kann die Hardware schnell entscheiden, wie bei einem Lese- oder Schreibvorgang auf einer bereits replizierten Zeile vorzugehen ist.
Überprüfung der Konsistenz zwischen Caches und Arbeitsspeicher
Die direkte Überprüfung der Konsistenz zwischen allen Cache-Ebenen einer CPU oder GPU und dem Hauptspeicher wäre eine Mammutaufgabe, sowohl hinsichtlich der Komplexität des Designs als auch des Leistungsaufwands. Daher organisieren moderne Systeme diese Überprüfung hierarchisch.
Die dem Prozessor am nächsten liegenden Caches (L1, L2) sind üblicherweise nicht direkt mit dem Arbeitsspeicher (RAM), sondern mit der nächsthöheren Cache-Ebene verbunden. Das bedeutet, dass die Datenkonsistenz nicht auf jeder Ebene anhand des Hauptspeichers, sondern anhand der jeweils darüberliegenden Ebene überprüft wird . Dadurch wird die Anzahl der RAM-Zugriffe reduziert und die Logik auf den unteren Ebenen vereinfacht.
Letztendlich erfolgt der Vergleich zwischen Cache- und RAM-Inhalten zwischen dem L1-Cache und dem Hauptspeicher . Wenn der L1-Cache einen korrekten und konsistenten Zustand beibehält und jede darunterliegende Ebene konsistent mit der darüberliegenden ist, bleibt die gesamte Hierarchie konsistent, ohne dass jede Zeile wiederholt mit dem RAM abgeglichen werden muss.
Wenn ein Kernel in eine Cache-Zeile schreibt und deren Daten ändert, wird der Zustand dieser Zeile markiert, um anzuzeigen, dass sie nicht mehr exakt mit der im Speicher abgelegten Kopie übereinstimmt . Anschließend koordiniert das Protokoll die Aktualisierung: Es markiert die entsprechenden Kopien in anderen Caches als reserviert oder ungültig und schreibt gegebenenfalls den neuen Inhalt in die zugehörige Hauptspeicherzeile.
Diese kaskadierende Organisation ermöglicht es, Änderungen schrittweise vom Kernel, der die Daten aktualisiert, zum Hauptspeicher weiterzuleiten und dabei jede Cache-Ebene kontrolliert zu durchlaufen. Dadurch wird die Aufrechterhaltung der Datenkonsistenz nicht zu einem unüberwindbaren Engpass für den Prozessor.
Hardware-Kohärenz versus Software-Kohärenz
Bisher haben wir Konsistenzmechanismen besprochen, die hauptsächlich in Hardware implementiert sind: Protokolle, Statusbits, gemeinsam genutzte Caches usw. Es gibt jedoch einen anderen Ansatz, der darauf abzielt, einen Teil dieser Komplexität in die Software zu verlagern , insbesondere in den Compiler und das Betriebssystem.
Softwarebasierte Konsistenzmechanismen versuchen, den Bedarf an zusätzlicher On-Chip-Logik zu reduzieren, indem sie Code analysieren und Entscheidungen zur Kompilierzeit treffen . Die Idee ist, dass der Compiler, wenn er ableiten kann, wann und wie auf bestimmte gemeinsam genutzte Daten zugegriffen wird, in vielen Fällen verhindern kann, dass diese Daten zwischengespeichert werden, oder ihre Sichtbarkeit explizit steuern kann.
Dieser Ansatz bietet einen klaren Vorteil: Ein Teil der Arbeitslast verlagert sich von der Laufzeit- zur Kompilierzeit . Anstatt dass die Hardware alle Konflikte ad hoc erkennt und behebt, versucht der Compiler, diese vorherzusehen und Code zu generieren, der gefährliche Situationen vermeidet.
Der Nachteil besteht darin, dass die statische Codeanalyse begrenzt ist und Compiler daher tendenziell konservativ arbeiten . Um Konsistenzverletzungen zu vermeiden, treffen sie häufig Entscheidungen, die die Effektivität von Caches verringern. Bei Verdacht auf problematische Daten verhindern sie oft deren Zwischenspeicherung oder erzwingen häufigere Synchronisierungen als unbedingt notwendig.
Obwohl diese Softwarelösungen theoretisch attraktiv sind, insbesondere zur Vereinfachung des Hardware-Designs, ersetzen sie in der Praxis nicht die in die CPU integrierte Kohärenzunterstützung , sondern ergänzen diese lediglich in bestimmten Szenarien.
Die Rolle des Compilers bei der Cache-Konsistenz
Ein Schlüsselelement softwarebasierter Konsistenzansätze ist die Rolle des Compilers. Dieser kann den Code eingehend analysieren und feststellen, welche gemeinsam genutzten Datenstrukturen möglicherweise unsicher für das Caching sind . Darauf basierend kennzeichnet er diese Elemente speziell oder passt die Codegenerierung an.
Der einfachste und zugleich konservativste Ansatz besteht darin, zu verhindern, dass gemeinsam genutzte Datenvariablen zwischengespeichert werden . Das heißt, jeder Zugriff auf diese Variablen erzwingt einen Zugriff auf den Hauptspeicher oder einen nicht zwischenspeicherbaren Bereich. Dies gewährleistet zwar Konsistenz, lässt aber viele Leistungspotenziale ungenutzt, da eine gemeinsam genutzte Struktur in bestimmten Zeiträumen tatsächlich privat und in anderen Zeiträumen schreibgeschützt verwendet werden kann.
Tatsächlich tritt das Konsistenzproblem nur in Zeiträumen auf, in denen mindestens ein Prozess in die Variable schreiben und ein anderer Prozess sie lesen kann . Außerhalb dieser kritischen Zeiträume kann die Variable so behandelt werden, als stünde sie ausschließlich einem einzelnen Thread zur Verfügung oder sei sogar für eine gewisse Zeit eine effektive Konstante, sodass sie problemlos zwischengespeichert werden kann.
Die fortschrittlichsten Kompilierungsstrategien versuchen, jene „sicheren“ Zeiträume zu identifizieren, in denen die gemeinsam genutzte Variable als konfliktfrei betrachtet werden kann . Dazu analysiert der Compiler Ausführungspfade, potenzielle gleichzeitige Zugriffe und Synchronisationsmuster (Sperren, kritische Abschnitte usw.). Basierend auf dieser Analyse unterteilt er die Lebensdauer der Variable in Phasen: einige eignen sich für das Caching, andere erfordern eine spezielle Behandlung.
In kritischen Phasen, in denen gleichzeitige Zugriffe und Schreibvorgänge erkannt werden, fügt der Compiler zusätzliche Anweisungen in den generierten Code ein, um die Cache-Konsistenz zu gewährleisten . Diese Anweisungen können je nach Programmiermodell und zugrundeliegender Architektur Cache-Flushes, Speicherneuladungen, Speicherbarrieren oder den Zugriff auf als nicht cachefähig markierte Bereiche erzwingen.
Beziehung zwischen Compiler, Betriebssystem und Hardware
Die Formulierung „Der Compiler fügt Anweisungen in den generierten Code ein, um die Cache-Konsistenz zu gewährleisten“ könnte den Eindruck erwecken, das Betriebssystem interpretiere diese Anweisungen wie übergeordnete Hinweise und entscheide darauf basierend, wie das Programm ausgeführt wird. Tatsächlich ist der Mechanismus jedoch etwas anders.
Wenn der Compiler diese Arten von Anweisungen hinzufügt, fügt er dem Binärcode spezifische Operationen hinzu, die von der Architektur oder der Laufzeitumgebung unterstützt werden . Beispielsweise kann er Anweisungen zum Leeren des Caches, Speichersperren, spezielle Anweisungen zum Markieren von Bereichen als nicht zwischenspeicherbar oder Aufrufe von Betriebssystemdiensten einfügen, die Speicherattribute konfigurieren.
Das Betriebssystem interpretiert diese Anweisungen nicht als vom Compiler geschriebene, hochrangige „Kommentare“ oder „Hinweise“, sondern führt den Maschinencode wie jeden anderen aus . Einige dieser Anweisungen sind jedoch so konzipiert, dass sie mit dem Speichersubsystem und der Cache-Verwaltung interagieren und somit die Art und Weise verändern, wie die CPU auf bestimmte Daten zugreift.
Anders ausgedrückt: Der Compiler führt eine Voranalyse durch und generiert Code, der bei der Ausführung das gewünschte Cache-Verhalten erzeugt . Das Betriebssystem unterstützt dies, indem es Speicherattribute (cachefähige oder nicht cachefähige Bereiche, Schreibrichtlinien usw.) festlegt und Synchronisierungsprimitive bereitstellt. Es „liest“ jedoch keine speziellen Anweisungen im Sinne einer semantischen Interpretation, wie sie ein Compiler vornehmen würde.
Es kann auch vorkommen, dass die Hardware beim Empfang bestimmter Anweisungen spezifische Kohärenz- oder Synchronisationsmechanismen aktiviert . Beispielsweise gewährleisten Fence- oder Barrier-Anweisungen die Reihenfolge des Speicherzugriffs und erzwingen bestimmte Sichtbarkeitseffekte innerhalb der Cache-Hierarchie. In diesem Fall findet eine dreiseitige Zusammenarbeit statt: Der Compiler entscheidet, wo diese Anweisungen platziert werden, das Betriebssystem konfiguriert die Ausführungsumgebung und die Hardware implementiert das eigentliche Verhalten auf Cache- und Speicherbusebene.
Zusammen gewährleisten all diese Elemente, dass parallele Programme auch dann mit einem konsistenten Speichermodell laufen , wenn mehrere Kopien derselben Daten auf verschiedene Caches und den Hauptspeicher verteilt sind . Cache-Kohärenz ist somit weit mehr als nur ein internes CPU-Detail; sie ist eine zentrale Komponente für den zuverlässigen und effizienten Betrieb von Mehrkernsystemen.
Das Verständnis dafür, wie Cache-Hierarchie, Hardware-Kohärenzprotokolle und Software-Unterstützungstechniken zusammenwirken, macht deutlicher, warum moderne CPU-Designs eine so ähnliche Struktur aufweisen und warum ein kleiner Fehler in einem dieser Mechanismen chaotisches Verhalten in gleichzeitig laufenden Anwendungen auslösen kann , die vollständig darauf angewiesen sind, dass alle Kerne die gleichen Daten zum richtigen Zeitpunkt sehen.