- Enamikku RAID-süsteemi katastroofe süvendab rutakas tegutsemine esimestel minutitel pärast riket.
- Iga RAID-tase haldab andmeid ja pariteeti erinevalt, mis määrab tegeliku riski ja taastamisstrateegia.
- Professionaalne sekkumine ühendab endas ketta kloonimise, virtuaalse massiivi rekonstrueerimise ja täiustatud loogilise analüüsi tehnikad.
- RAID ei asenda varukoopiaid: ennetamine ja korrapärane reageerimine on andmete salvestamise võtmeks.
Kui RAID-süsteem peaks rikki minema, on esimesed minutid kriitilise tähtsusega. Nn "kuldsel tunnil" pärast riket tekib enamik inimlikke vigu, mis muudavad parandatava probleemi pöördumatuks katastroofiks. Pimesi ketaste vahetamine, pidevad taaskäivitused või taastamiskatsed ilma viga teadmata on tavaliselt kiireim tee andmete täieliku kadumiseni.
Miks on RAID-i taastamine nii delikaatne?
Paljudes kriitilistes intsidentides ei ole andmekadu põhjustatud mitte esialgsest riistvararikkest, vaid esimese tunni jooksul tehtud rutakatest toimingutest . See periood on kriitilise tähtsusega: ketta asukoht võib muutuda, initsialiseerimisprotsess võib käivituda ekslikult, taastamine võib olla sunnitud või süsteem võib käivituda sama salvestusmassiivi mittetäielikust varukoopiast ja see, mis oli kunagi keeruline, kuid hallatav probleem, muutub peaaegu lahendamatuks mõistatuseks.
Kõige levinumad riskiolukorrad hõlmavad ketaste vales järjekorras vahetamist (RAID 0, 1, 5, 6, 10 jne puhul), kontrolleri asendamist teise mudeliga ilma konfiguratsiooni kloonimata või dokumenteerimata, ketaste sundimist "võrku" ilma tegelikku olekut analüüsimata, valede köidete initsialiseerimist või lõpetamata ümberehituste käivitamist, mis rikuvad veelgi massiivi sisemist struktuuri.
Eriti ohtlikud on ka varukoopiate taastamine otse kahjustatud süsteemile , VMware Storage'i vMotion-tüüpi salvestusmigratsioonid ebastabiilse massiiviga ja kõik toimingud, mis kirjutavad potentsiaalselt taastatavat teavet sisaldavatele ketastele uusi RAID-konfiguratsiooni metaandmeid.
RAID-massiiv on enamiku füüsiliste serverite, NAS-ide ja SAN-süsteemide alus ning pole alati kohe selge, et probleem pärineb massiivist endast. Seetõttu on kahtluse korral kõige targem tegutsemisviis peatada kõik kettale kirjutamised , dokumenteerida olukord üksikasjalikult ja enne edasiste muudatuste tegemist pöörduda andmete taastamise spetsialistide poole.
Tüüpilised inimlikud vead ja põhilised head tavad
Kui RAID-süsteem läheb halvenenud olekusse, üks või mitu ketast lakkab töötamast või NAS ei käivitu, on instinktiivne reaktsioon tavaliselt proovida asju "kuni midagi toimib". See lähenemisviis peaaegu alati süvendab probleemi, sest iga toiming jätab ketastele jälje ja võib üle kirjutada pariteedi, metaandmed või kasutajaandmed, mis on endiselt puutumatud.
Kõige sagedasemate vigade hulgas, mis taastamist raskendavad, on sellised toimingud nagu uue RAID-i konfigureerimine sama kontrolleri ja ketaste abil , nende ketaste sisestamine teise salvestusruumi, et "näha, kas see need ära tunneb", või kettapesade füüsilise järjekorra muutmine. Suurel protsendil juhtudest kirjutavad need toimingud üle algse konfiguratsiooni, hävitavad pariteediribad ja vähendavad drastiliselt õnnestumise võimalusi.
Teine levinud halb tava on juhtunu mittesalvestamine. Keerulise rikke korral on oluline kronoloogiliselt logida kõik sündmused : voolukatkestused, süsteemiteated , kettavahetus, taastamiskatsed, püsivara värskendused jne. See teave aitab hiljem spetsialiseerunud tehnikutel puslet kokku panna.
Sama oluline on dokumenteerida ja säilitada iga ketta täpne asukoht massiivis . Kettapesade "silma järgi" vahetamine või väidetavalt surnud ketaste äraviskamine on hoolimatu: kui RAID-i on hiljem vaja laboris uuesti kokku panna, võib teadmine, milline ketas millises pesas oli, ja kõigi originaalketaste (isegi asendatud) olemasolu olla määrava tähtsusega.
Üldreeglina tuleks RAID-i rikke korral võtta järgmised toimingud: peatada arvuti, mitte midagi ümber konfigureerida, hoida kõik kettad märgistatud , koguda juhtumi kohta võimalikult palju teavet ja kui andmed on olulised, võtta enne katsetamise jätkamist ühendust professionaalse taastamisteenusega.
Kuidas spetsialistid RAID-süsteemi taastamist käsitlevad
RAID-andmete taastamisele spetsialiseerunud ettevõtted töötavad väga struktureeritud protseduuride järgi , sest iga tehniline otsus peab minimeerima edasise kahju riski . Tüüpilise juhtumi puhul, kus on kaalul mitu ketast ja terabaiti andmeid, võib iga improviseeritud samm olla kulukas.
Väga illustreeriv reaalse maailma näide on RAID-massiiv, mis koosneb kaheteistkümnest kettast ja umbes 12 TB andmetest. Varundamist ei olnud õigesti hallatud, seega oli ainus toimiv lahendus võtta ühendust professionaalse RAID-andmete taastamise ettevõttega . Olukord oli kiireloomuline; toimingud pidid jätkuma nii kiiresti kui võimalik ja massiiv oli juba jõudnud kriitilisse olekusse pärast seda, kui kaks ketast ümberkonfigureerimise käigus rikki läksid.
Sellistel juhtudel kloonivad spetsialistid tavaliselt kõik töötavad kettad ja töötavad alati koopiate, mitte originaalidega. Samal ajal püüavad nad füüsiliselt kahjustatud kettaid võimalikult palju parandada, kas laborisekkumise (puhasruumid, peade vahetamine, doonorelektroonika jne) või täiustatud osalise lugemise tehnikate abil.
12 TB ketta puhul oli suurimaks probleemiks see, et RAID-i ümberkonfigureerimine oli alanud enne teist riket , seega oli kontroller uued pariteediväärtused juba osaliselt ümber arvutanud. Suhteline eelis seisnes selles, et teine ketas rikkis protsessi algstaadiumis, seega oli suur osa vanast loogilisest struktuurist veel taastatav.
Pärast ühe kahjustatud ketta taastamist ja täieliku koopia loomist oli väljakutseks massiivi loogilise struktuuri käsitsi rekonstrueerimine : ketta järjekord, plokkide suurus, pariteedi jaotus, võimalikud muudatused protsessi keskel... See töö, mille analüüs võib võtta mitu päeva, võimaldas meil taastada umbes 90% andmetest, mida antud asjaolusid arvestades peetakse RAID-i taastamisel kõrgeks edukuse määraks.
Professionaalsed teenused: mida nad tavaliselt pakuvad ja kuidas nad toimivad
RAID-andmete taastamisele spetsialiseerunud ettevõtted pakuvad tavaliselt kiiret ja tasuta diagnostikat , eriti kriitiliste serverite või tootmis-NAS-seadmete jaoks. Mõnel juhul kohustuvad nad probleemi hindama mõne tunni jooksul, esitama teostatavusaruande ja fikseeritud hinnapakkumise ning järgima poliitikat „taastamiseta tasu ei ole”.
Tüüpiline teenus algab siis, kui klient küsib tasuta hinnapakkumist oma RAID-i taastamiseks . Selles algfaasis kogutakse teavet massiivi tüübi (RAID 0, 1, 5, 6, 10, JBOD jne), ketaste arvu, failisüsteemi (nt ext4, Btrfs, XFS, HFS+, NTFS…), kaasatud riistvara (Synology NAS, QNAP, kaubamärgi serverid, SAN-massiivid…) kohta ning antakse üksikasjalik kirjeldus sümptomite ja seni võetud meetmete kohta.
Kui uuring on vastu võetud, korraldab ettevõte tavaliselt seadmete või ketaste tasuta äraveo , märkides ära täpsed pakkimisjuhised: kasutage antistaatilist või polsterdatud pakendit, asetage seade jäigasse karpi lööke summutava materjaliga, takistage ketaste liikumist transportimise ajal ja märgistage taotluse number.
Laboris tagasi olles teevad tehnikud iga ketta füüsilise ja loogilise diagnostika , loovad võimaluse korral bitthaaval kujutisi, hindavad sektorite seisukorda ja otsustavad, kuidas RAID-i virtuaalselt rekonstrueerida. Alles seejärel esitatakse lõplik hinnapakkumine, mis sisaldab taastatavate andmete hinnangulist protsenti ja ligikaudset teostusaega.
Kui klient heaks kiidab, algab tegelik taastamisprotsess. Pärast ketaste stabiliseerimist ja RAID-i seadistamist kontrollitud keskkonnas genereerivad spetsialistid ligipääsetavate failide loendi. Selle hetkeni pole klient tavaliselt midagi maksnud . Ainult siis, kui loend on rahuldav, kopeeritakse andmed uuele andmekandjale (väline kõvaketas, asendus-NAS jne) ja saadetakse kliendile tagasi, peaaegu alati koos saatmiskuludega.
Põhitõed: kuidas RAID seestpoolt töötab
RAID-süsteem on lihtsalt öeldes füüsiliste ketaste kogum, mis esitatakse operatsioonisüsteemile ühe loogilise üksusena . Võti peitub andmete levitamises ja potentsiaalselt ketaste vahelises paarsuses, et saavutada jõudlust, mahtu, rikketaluvust või nende kombinatsiooni.
RAID-tehnoloogia võimaldab andmeid jaotada ribadena või plokkidena , mis kirjutatakse paralleelselt mitmele kettale, kiirendades juurdepääsu edastuste kombineerimise kaudu. Lisaks talletatakse teatud tasemetel redundantseid andmeid (paarsust), et rikkis kettalt andmeid uuesti arvutada ilma teenuse katkemiseta, eeldusel, et massiivi konstruktsioonis määratud rikkepiiranguid ei ületata.
Teine oluline eelis on paljudes süsteemides ketaste hot swap'i võimalus . See tähendab, et vigase ketta saab füüsiliselt eemaldada ja asendada ilma serverit või salvestusmassiivi välja lülitamata, võimaldades kontrolleril taastada kadunud andmed uuel kettal taustal, samal ajal kui süsteem jätkab töötamist.
Ühte ja kõigile stsenaariumidele sobivat „täiuslikku RAID-taset” pole olemas. Igal tasemel on prioriteediks erinev tasakaal jõudluse, turvalisuse ja kasutatava mahutavuse vahel . Seetõttu on enne mis tahes parandus- või taastamistoimingute tegemist oluline mõista, mis tüüpi RAID on konfigureeritud.
Kui midagi läheb valesti, suudab RAID ise andmed tavaliselt taastada, kui planeeritud rikketaluvus on täidetud. Kui aga järjest tekib mitu füüsilist, loogilist või inimlikku probleemi, võib massiiv kaotada sidususe ja muutuda võimetuks iseseisvalt taastuma, mis nõuab eksperdi sekkumist.
Levinumad RAID-tasemed ja nende omadused
Iga RAID-tase haldab andmete jaotust ja pariteeti ketaste vahel erinevalt , mille tulemuseks on väga selged erinevused käitumises rikke korral. Nende erinevuste mõistmine aitab hinnata rikke tegelikku riski ja eduka taastamise tõenäosust.
RAID 0, mis on tuntud oma suure jõudluse poolest, jaotab andmed ribadena vähemalt kahele kettale ilma üleliigset teavet salvestamata. See tähendab, et ühe ketta kadumine toob kaasa kogu köite kadumise , kuna iga faili osad on hajutatud kõigile ketastele. Selle peamine eelis on kiirus, kuid andmeturbe seisukohast on see väga haavatav.
RAID 1 ehk peegeldamine hoiab andmetest identseid koopiaid kahel kettal . Kui üks peaks rikki minema, jätkab teine sujuvat tööd. See on lihtne, usaldusväärne ja pakub head lugemiskiirust, kuigi see ohverdab kasutatavat mahtu, kuna saadaolev ruum on võrdne ühe kettaga paaris. Taastamisel muudab vähemalt ühe ketta puutumatus asjad tavaliselt palju lihtsamaks.
Samuti on olemas tänapäeval vähem levinud RAID-tasemed nagu RAID 3 ja RAID 4, mis ühendavad andmekettad spetsiaalse pariteedikettaga . RAID 3 puhul on juurdepääs andmekettadele samaaegne ja pariteedikettast saab potentsiaalne pudelikael, samas kui RAID 4 võimaldab igale andmekettale sõltumatumat juurdepääsu, parandades jõudlust teatud töökoormuste korral.
RAID 5 on ilmselt kõige laialdasemalt kasutatav RAID-konfiguratsioon serveri- ja NAS-keskkondades. See jaotab andmed ribadena mitmele kettale ja põimib pariteediplokke kõigi ketaste vahel , ilma et üks ketas oleks sellele funktsioonile ainuomaselt eraldatud. See konfiguratsioon võimaldab andmete taastamist asenduskettale ühe rikke korral, eeldusel, et taastamisprotsessi käigus ei teki teist riket.
RAID 6 viib turvalisuse sammu võrra edasi, salvestades iga andmekogumi kohta kaks pariteediplokki , mis võimaldab tal taluda kuni kahe ketta samaaegset riket ilma andmete kadumiseta. See nõuab pariteedi jaoks rohkem kettaruumi ja suuremat arvutusvõimsust, kuid pakub vastutasuks palju suuremat veamarginaali aheldatud rikete korral, mis on suurte massiivide puhul väga väärtuslik funktsioon.
Lisaks neile "klassikalistele" RAID-tasemetele on olemas ka kombinatsioonid nagu RAID 10 (peegeldamine + triibutamine), RAID 50 või 60 ning lineaarsed või JBOD-konfiguratsioonid, kus kettad lihtsalt liidetakse suureks köiteks ilma tegeliku koondamiseta. Ühelgi neist juhtudest ei asenda RAID hästi disainitud varundussüsteemi.
Tüüpilised RAID-süsteemi tõrked ja millal taastamine muutub keeruliseks
RAID-süsteemidel on õigustatult hea maine oma vastupidavuse poolest, kuid need pole probleemide suhtes immuunsed. Praktikas esinevad füüsilised, loogilised ja inimlikud vead , mis on sageli omavahel seotud ja viivad keeruliste taastamisolukordadeni.
Loogilisest vaatenurgast on üks tõsisemaid takistusi pariteediribade kadumine või riknemine . Kui metaandmed, mis näitavad andmete ja pariteedi jaotust ketaste vahel, halvenevad, ei saa RAID enam teavet ise taastada ning nende ribade käsitsi või poolautomaatselt leidmiseks ja taastamiseks on vaja välist sekkumist.
Riistvara osas näitab statistika, et väike protsent (umbes 2–3%) mis tahes infrastruktuuri ketastest võib igal aastal füüsiliselt rikki minna. Paljude ketastega massiivis tähendab see, et vähemalt ühe rikke tõenäosus pole tühine. Mehaanilised rikked, voolutõusud, vigane püsivara, äärmuslikud temperatuurid või halva kvaliteediga komponendid on füüsiliste rikete tavalised põhjused.
Probleemid süvenevad, kui ümberehituse ajal tekib teine tõrge, eriti RAID 5 või paljude ketastega konfiguratsioonide puhul. Kui samal ajal, kui süsteem taastab andmeid rikkis kettalt, hakkab teisel kettal tekkima tõsiseid vigu, võib massiiv muutuda halvenenud seisukorrast täiesti ligipääsmatuks. Kui rikki läheb rohkem kettaid kui oodatav tolerants , ei ole RAID-i sisemine loogika enam piisav ja tuleb kasutada täiustatud taastamistehnikaid.
Inimlik eksimus viib kokteili lõpule: juba hoiatusi andva ketta asendamise edasilükkamine, kontrolleri häirete ignoreerimine, süsteemide vale sulgemine korduvate voolukatkestuste korral , ebapiisavate draiverite installimine , pideva taaskäivitamise sundimine või hooldusprotseduuride rakendamine ilma hiljutiste varukoopiateta on tegevused, mis suurendavad oluliselt andmete kadumise ohtu.
Spetsialiseeritud tarkvara kasutamine: praktiline näide R-Studio abil
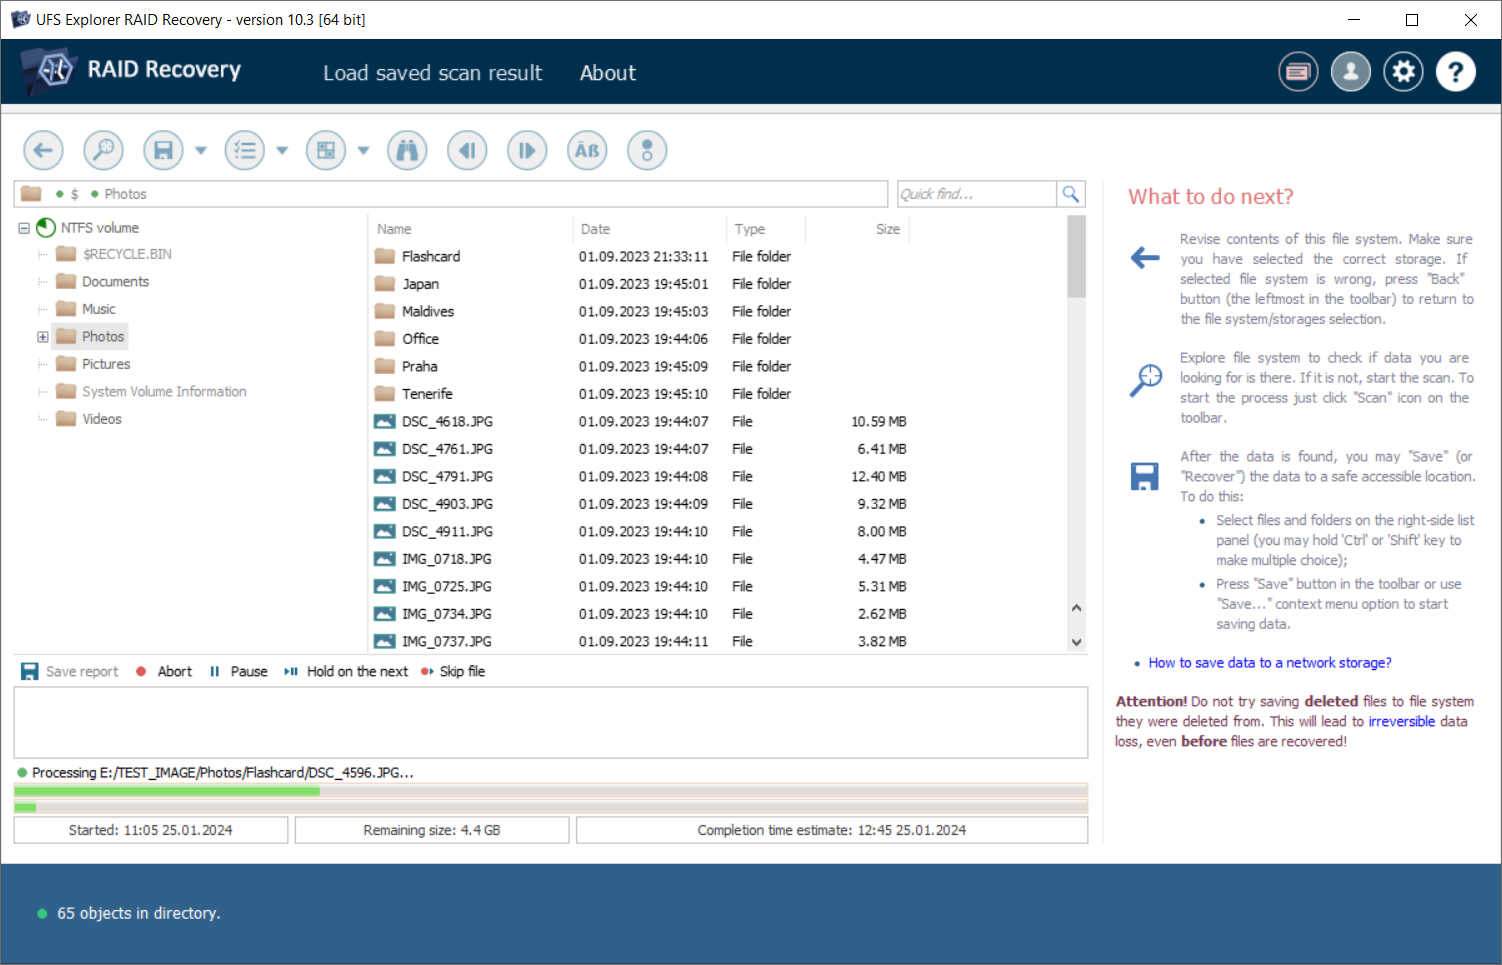
Kui RAID-ile pole enam algse kontrolleri kaudu ligipääs, on üheks tehniliseks võimaluseks massiivi virtuaalne taastamine spetsiaalse tarkvara abil . Tööriistad nagu R-Studio võimaldavad tuvastada endiselt järjepidevaid RAID-e justkui tavaliste köidetena ja tõsisematel juhtudel luua virtuaalseid RAID-e ketastest või kettakujutistest.
Tööpõhimõte hõlmab virtuaalse RAID-massiivi loomist füüsiliste ketaste või nende koopiate põhjal , sisestades käsitsi parameetreid, nagu ketaste arv, ploki suurus, algnihe, RAID-i tüüp (0, 1, 4, 5, 6, 10, JBOD, ZFS RAIDZ, RAIDZ2 jne) ja ketaste järjekord. Kui tarkvara tuvastab kehtiva failisüsteemi, esitatakse see virtuaalne RAID-massiiv navigeeritava köitena, kust saab faile loetleda ja taastada.
Näiteks lihtsa RAID 5 massiivi puhul, millel on kolm ketast, 64 KB plokid ja asünkroonne vasakpariteed, tuleks lihtsalt valida kolm ketast õiges järjekorras , määrata ploki suurus, määrata sobiv nihe ja lasta tööriistal partitsioon tuvastada. Sealt saate avada köite, uurida kaustu, eelvaadata faile (eriti suuri) ja kontrollida, kas struktuur on õigesti paigaldatud.
Keerukamates konfiguratsioonides, näiteks 4KB plokkide ja kohandatud pariteedimustriga RAID 5 puhul, tuleb plokkide järjekorra tabel käsitsi määratleda . See hõlmab iga andme- või pariteediploki sisestamist rida-realt, millisel kettal see asub, tagades järjestuse järjepidevuse. Tarkvara annab teile märku, kui see tuvastab tabelis vastuolusid, et need saaks enne muudatuste rakendamist parandada.
Oluline ettevaatusabinõu on see, et need virtuaalsed RAID-id on tarkvara sees puhtalt loogilised objektid : nad ei kirjuta midagi algsetele ketastele, millelt nad loodi. See võimaldab teil katsetada erinevate parameetrite kombinatsioonidega, kuni leiate sellise, mis taastab failisüsteemi õigesti, ilma et peaksite edasisi kahjustusi ohtu seadma.
Juhtudel, kui füüsiline ketas puudub, võimaldavad mõned tööriistad selle asendada "puuduva kettaga" või tühja ruumiplokiga, simuleerides halvenenud RAID-i käitumist. Sellegipoolest peavad failide taastamise usaldusväärsuse tagamiseks kõik parameetrid olema õiged; üks vale ploki suurus või valesti arvutatud nihe võib ekstraheeritud faile rikkuda, seega on tehnilise oskusteabe olulisus suur.
RAID-tüübid ja nende käitumine andmete kadumise korral
Lisaks klassikalistele RAID-tasemetele toetavad tänapäeva RAID-süsteemid laia valikut hübriid- ja lineaarseid konfiguratsioone . Igaüks neist pakub pärast kriitilist tõrget andmete taastamisel erinevaid väljakutseid.
RAID 0 (puhas triibutamine) massiivis fragmenteeritakse andmed väikesteks rühmadeks, mis kirjutatakse järjestikku kõigile massiivi ketastele. Kogumaht on kõigi ketaste summa, kuid igasugust redundantsust ei esine . Kui üks ketastest rikki läheb, muutub kogu köide kasutuskõlbmatuks ja ainus taastamisvõimalus hõlmab täiustatud tehnikaid, mis püüavad taastada seda, mida saab allesjäänud ketastelt teha.
RAID 1 säilitab peeglis igal kettal olevatest andmetest alati identsed koopiad . See lihtsus on taastamisprotsessides suureks eeliseks, sest kui üks ketastest jääb terveks, saab selle andmetele otse juurde pääseda, nagu oleks see iseseisev ketas, või saab selle sisu kopeerida uuele draivile ja hiljem peegli uuesti luua.
RAID-tasemetel nagu RAID 4 ja RAID 5, kus pariteet jaotub erinevalt, on kasutatav maht tavaliselt kõigi ketaste summa miinus ühe ketase maht. Vajadus ketta andmeid matemaatiliselt pariteedi põhjal rekonstrueerida on see, mis raskendab taastamist, kui tõrked esinevad järjest ja kaob rohkem kettaid, kui disain lubab.
Lineaarsed ehk JBOD (Just a Bunch Of Disks ehk lihtsalt hunnik kettaid) konfiguratsioonid grupeerivad mitu sama või erineva suurusega ketast üheks suuremaks loogiliseks üksuseks ilma andmeid paralleelselt jagamata. Need ei paku olulisi jõudluse parandusi ega koondamist: kui mõni ketas rikki läheb, kaob juurdepääs kogu köitele . Sellistel juhtudel hõlmab taastamine iga ketta kallal töötamist ja sisu käsitsi taastamist kahjustamata segmentidest.
Kõik need stsenaariumid rõhutavad, et olenemata salvestustehnoloogiate edukusest on välised ja kontrollitud varukoopiad endiselt olulised . RAID vähendab või kõrvaldab seisakuid teatud tõrgete korral, kuid see ei kaitse juhusliku kustutamise, loogilise rikkumise, pahavara rünnakute ega konfiguratsioonivigade eest, mis hävitavad teavet failisüsteemi tasandil.
Olulised näpunäited riskide minimeerimiseks ja andmete kaitsmiseks
Esimene soovitus, olgugi kui ilmselge see ka ei tundu, on regulaarse varunduspoliitika järgimine , mis ei tugine RAID-ile endale. See hõlmab servereid, tööjaamu, nutitelefone, NAS-süsteeme ja kõiki muid seadmeid, kus väärtuslikke andmeid hoitakse. Ainult sel viisil saab tõsise rikke korral teenuse taastada ilma kohtuekspertiisi abil tehtud taastamise edukusele lootmata.
Kui intsident ikkagi juhtub ja kasutatavat varukoopiat pole, on kõige targem tegutsemisviis vältida isetegemise parandamise katseid ilma sammude ja nende võimalike tagajärgede selge mõistmiseta. Enne failisüsteemi parandamise tööriistade käivitamist, automaatsete taastamiste alustamist või draivide vahetamist lahtrite vahel on soovitatav konsulteerida andmete taastamise spetsialistidega ja selgitada neile olukorda üksikasjalikult.
Samuti on oluline pöörata tähelepanu rikke varajastele märkidele : kettad, mis hakkavad näitama ümberjaotatud sektoreid, kontrollerid, mis genereerivad hoiatusi, süsteemilogid I/O hoiatustega, salvestusmassiivid, mis märgistavad massiivi halvenenuks... Nende sümptomite ignoreerimine laiskuse või teenuse peatamise hirmu tõttu on tavaliselt palju tõsisema ja kulukama rikke eelmäng.
Lõpuks, kui andmed on väärtuslikud, on kasulik eelnevalt leida usaldusväärne andmete taastamise pakkuja . Kui aeg kätte jõuab, lühendab otsene kontakt reageerimisaega, võimaldab teil saada algusest peale täpsed juhised ja suurendab tõenäosust, et taastatakse võimalikult palju andmeid.
Lugematute juhtumite kogemused näitavad, et sobiva RAID-disaini, usaldusväärsete varukoopiate, rahuliku reageerimise riketele ja vajadusel spetsialistide toe kombinatsioon on see, mis teeb tõelise vahe kontrollitud hirmutamise ja katastroofilise andmekao vahel.