- VIF võimaldab tuvastada multikollineaarsust regressioonimudelites, olles kriitiline, kui väärtused ületavad 5 läve.
- C#-keeles rakendamine nõuab andmete standardiseerimist, et tagada numbriline stabiilsus ja vältida täpsusvigu.
- Puhas koodidisain peaks jõudluse optimeerimiseks eraldama välised ressursid, andmete oleku ja käitumisloogika.
Kui olete sattunud andmeanalüüsi maailma, olete kindlasti kokku puutunud multikollineaarsuse peavaluga. Põhimõtteliselt tekib see siis, kui teie sõltumatud muutujad on liiga tihedalt seotud, mis võib põhjustada teie regressioonimudeli talitlushäireid ja anda ebausaldusväärseid tulemusi. Selle kaose korrastamiseks tuleb mängu dispersiooni inflatsioonitegur (VIF) – peamine tööriist probleemi põhjustavate muutujate tuvastamiseks.
Kuigi võimsad teegid eksisteerivad sellistes programmeerimiskeeltes nagu R või Python, nõuab selle kontseptsiooni rakendamine C# -s põhjalikku arusaamist aluseks olevast matemaatikast ja sellest, kuidas koodi hooldatavuse tagamiseks struktureerida. Asi pole ainult funktsioonide kaupa käivitamises, vaid programmeerimisloogika korraldamises nii, et tarkvara oleks loetav ja tõhus, takistades koodil meenutamast krüptilist tähtede segu.

VIF-i ja multikollineaarsuse mõistmine
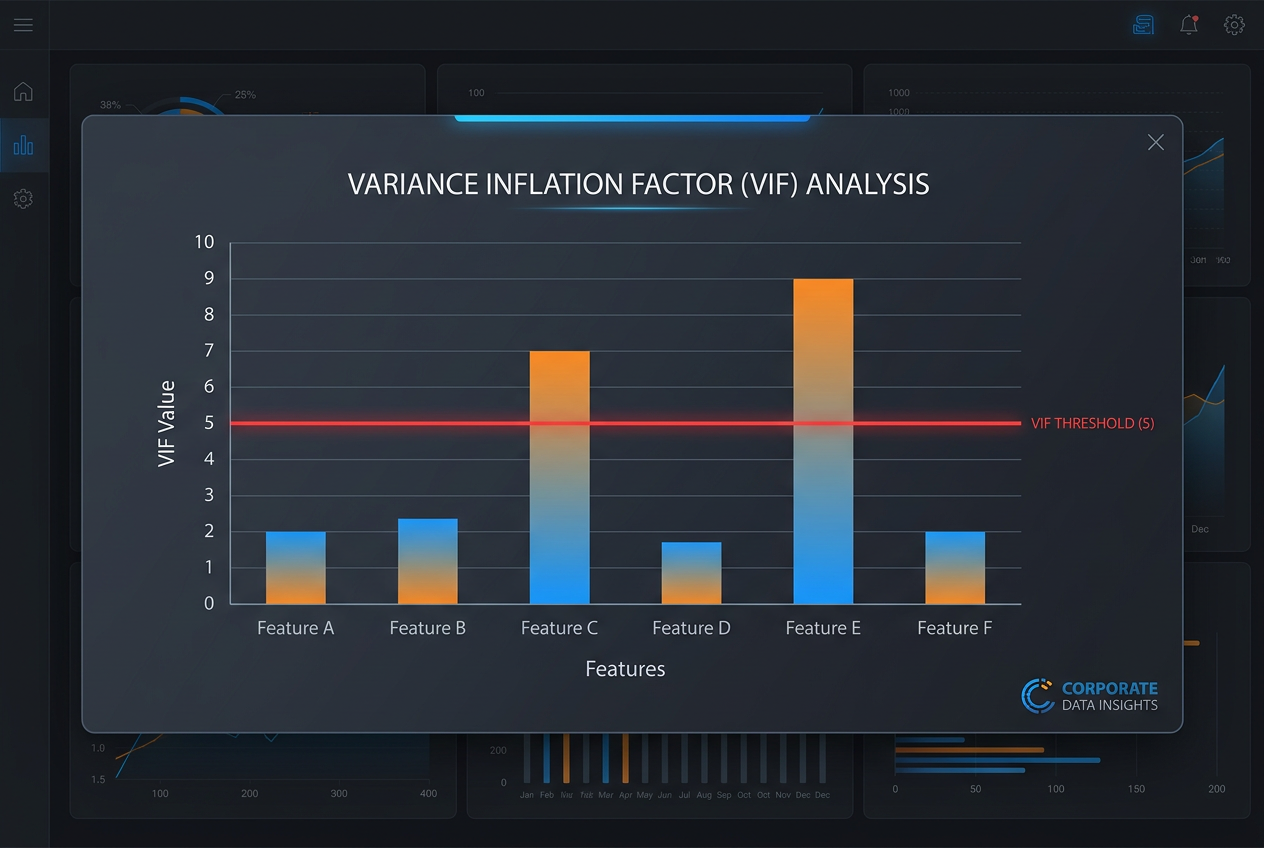
Dispersiooni inflatsioonitegur (VIF) on mõõt, mis näitab, kui palju hinnangulise koefitsiendi dispersioon suureneb selle korrelatsiooni tõttu mudeli teiste muutujatega. Lihtsamalt öeldes, kui muutujal on väga kõrge VIF , tähendab see, et suur osa selle teabest on juba kaetud teiste muutujatega, mis põhjustab standardvigade hüppelist suurenemist ja muudab väga raskeks kindlaks teha, milline muutuja tulemust tegelikult mõjutab.
Paljude analüütikute rusikareegel on, et kui VIF-i väärtus on suurem kui 5 , on tegemist multikollineaarsusega. Äärmuslikumates olukordades on väärtus üle 10 selge märk sellest, et muutujat tuleks mudeli puhastamiseks ja numbrilise stabiilsuse parandamiseks üle vaadata või andmestikust eemaldada.
Tehniline ja loogiline teostus C#-s
Disainimaatriksi konkreetse muutuja VIF-i arvutamiseks käsitletakse seda muutujat sõltuva muutujana ja teostatakse lineaarne regressioon, kasutades kõiki teisi sõltumatuid muutujaid ennustajatena. Tulemuseks on määramiskordaja R² ja VIF arvutatakse valemi 1 / (1 – R²) abil.
C# programmeerimisel on oluline pöörata tähelepanu numbrilisele stabiliseerimisele . Parim tava on standardiseerida disainimaatriksi veerud, määrates keskmiseks 0 ja standardhälbeks 1. See on ülioluline väga erineva skaalaga andmete või mittelineaarsete teisenduste korral, kuna see hoiab ära programmi krahhi kümnendmurdude täpsusvigade tõttu.
Puhta koodi kujundamise põhimõtted
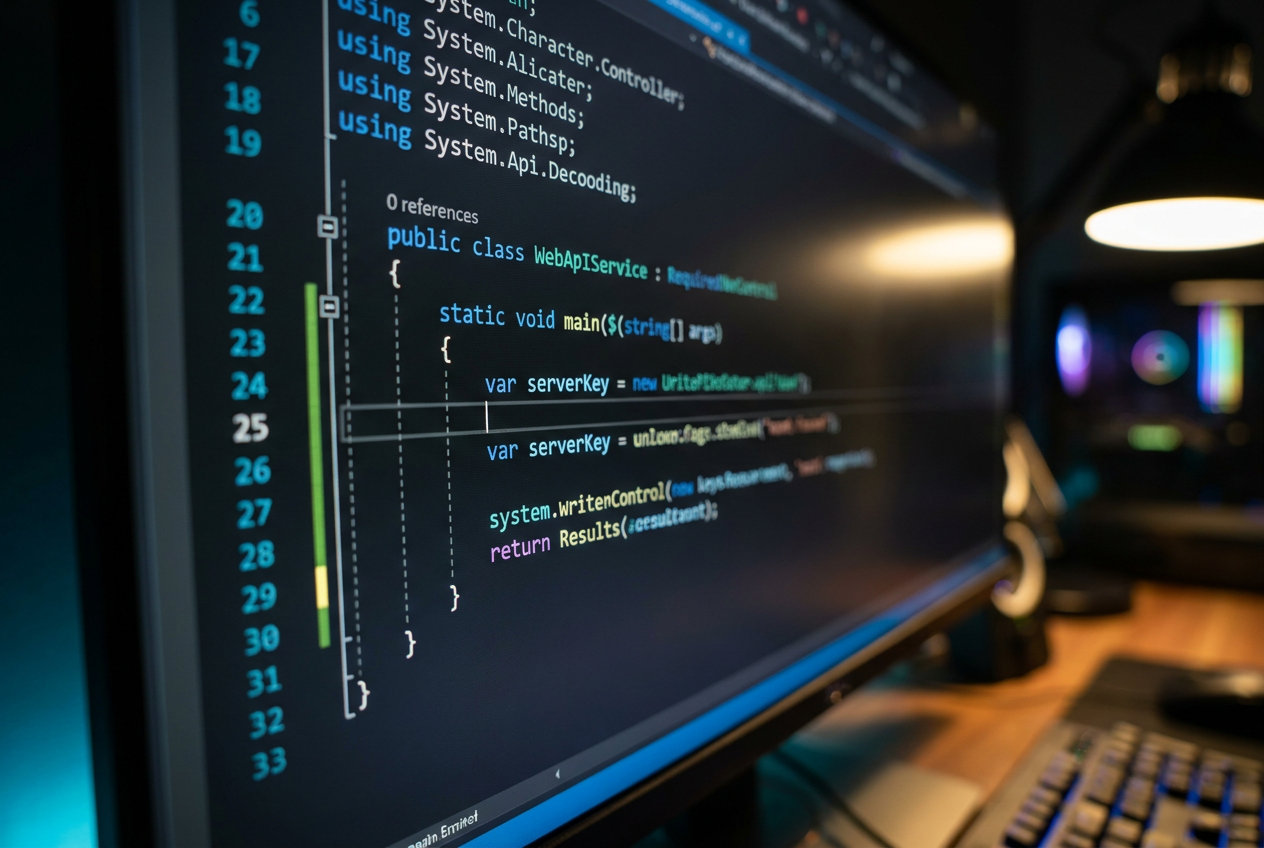
Lisaks valemile endale on C#-s koodi kirjutamise viis väga oluline. Levinud viga on objektide loomine, mis teevad asju, milleks nad pole loodud; näiteks "Pall" klassil on meetod "Viska()", mis ei ole loogiline, kuna pall ei viska ennast ise. Kood peaks lugema nagu hästi kirjutatud laused , kus subjekt sooritab objektiga sidusa toimingu.
- Välised ressursid: Neid tuleks käsitleda eraldi abstraktsioonitasandil, ideaalis sõltuvussüstimise kaudu.
- Staatus ja andmed: Andmekeskne kood peaks järgima objektorienteeritud programmeerimise (OOP) põhimõtteid.
- Käitumine: Loogika ja algoritmid peaksid toimima puhaste funktsioonidena, võttes parameetriteks andmeid ja ressursse.
Projekti korraldamiseks on soovitatav hierarhia, mis algab nimeruumist, liigub keerukuse kasvades staatiliste klasside kaudu edasi ja lõpeb tavaliste klassidega. Eelistatav on grupeerida seotud klassid samasse faili, kui neil on sama eesmärk, see aitab kompilaatoril binaarfaili optimeerida ja parandab käitusaja jõudlust vahemälu ja protsessori registrite parema haldamise kaudu.
Alternatiivid ja andmete visualiseerimine
Kuigi C# on rakendamiseks robustne, kasutatakse kiirete otsingukeskkondade jaoks sageli selliseid tööriistu nagu R. Selles keeles võimaldavad sellised teegid nagu "car" VIF-i peaaegu kohest arvutamist. Kui väärtused on saadud, on ideaalne mitte tugineda ainult numbritele, vaid kasutada tulpdiagramme multikollineaarsuse allikate visuaalseks tuvastamiseks.
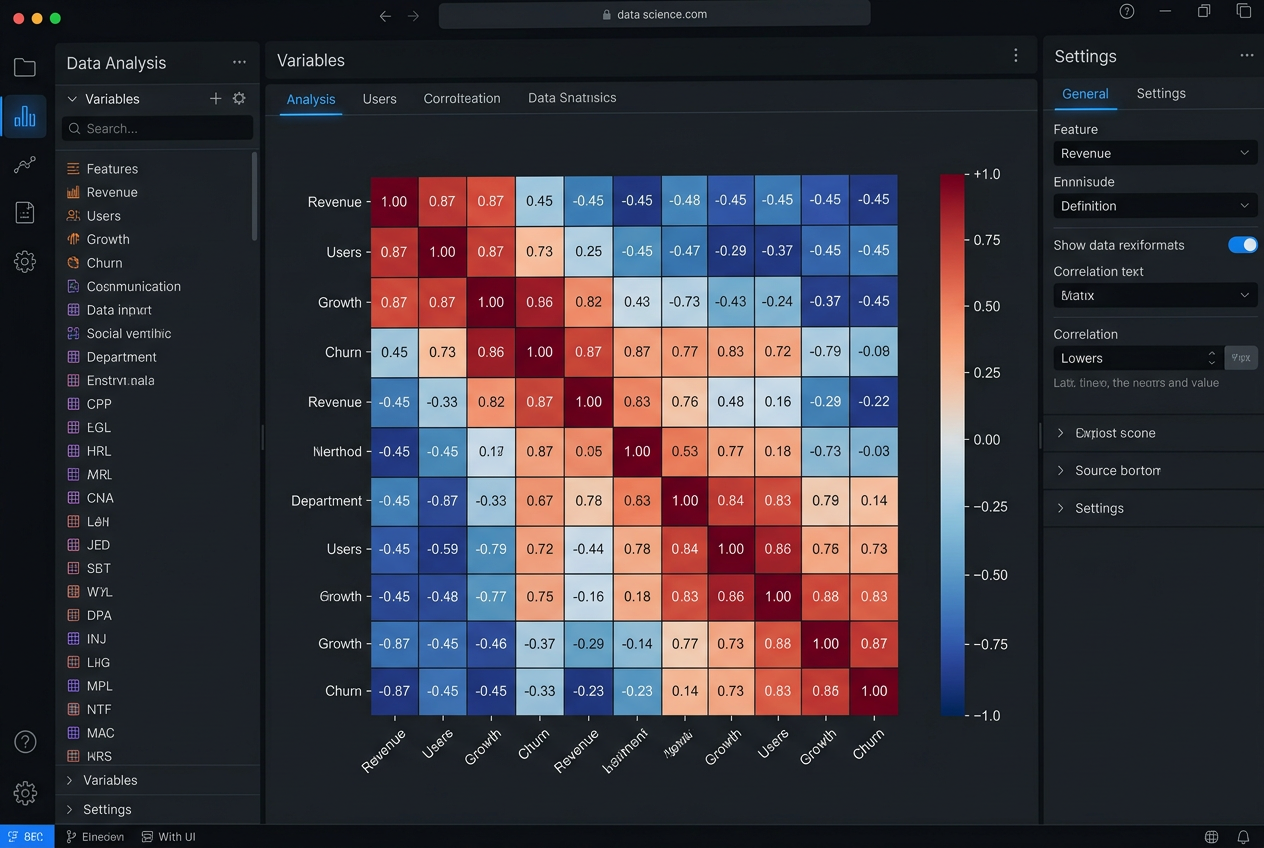
Analüüsi täiendamine korrelatsioonimaatriksiga on ülioluline samm. Muutujate omavahelise seose visualiseerimine värvide abil võimaldab meil mõista mitte ainult VIF-probleemi olemasolu, vaid ka täpselt, milline muutujate paar konflikti põhjustab. See statistilise analüüsi ja visualiseerimise kombinatsioon tagab, et lõplik mudel on täpne ja mitte lihtsalt kaardimaja.
Nõuetekohane VIF-i haldus koos ühel vastutusel põhineva tarkvaraarhitektuuri ja standardiseeritud andmestruktuuriga võimaldab luua C# analüüsitööriistu, mis on nii võimsad kui ka hõlpsasti hooldatavad. Andmete koondamise kõrvaldamise ja ühtsete disainipõhimõtete rakendamise abil muudame krüpteeritud koodi professionaalseks lahenduseks, mis on võimeline keerulisi regressioone täieliku usaldusväärsusega käsitlema.