- Tehisintellekt muudab failihaldust, automatiseerides klassifitseerimist, strateegiliste andmete ekstraheerimist ja autentsuse kontrollimist.
- Sellised tehnoloogiad nagu IDP, arvutinägemine ja NLP võimaldavad vähendada inimlike vigade arvu ja optimeerida regulatiivset vastavust kriitilistes sektorites.
- Võime analüüsida keerulisi mustreid ja avastada keerukaid pettusi muudab dokumendihalduse konkurentsi- ja turvaeeliseks.
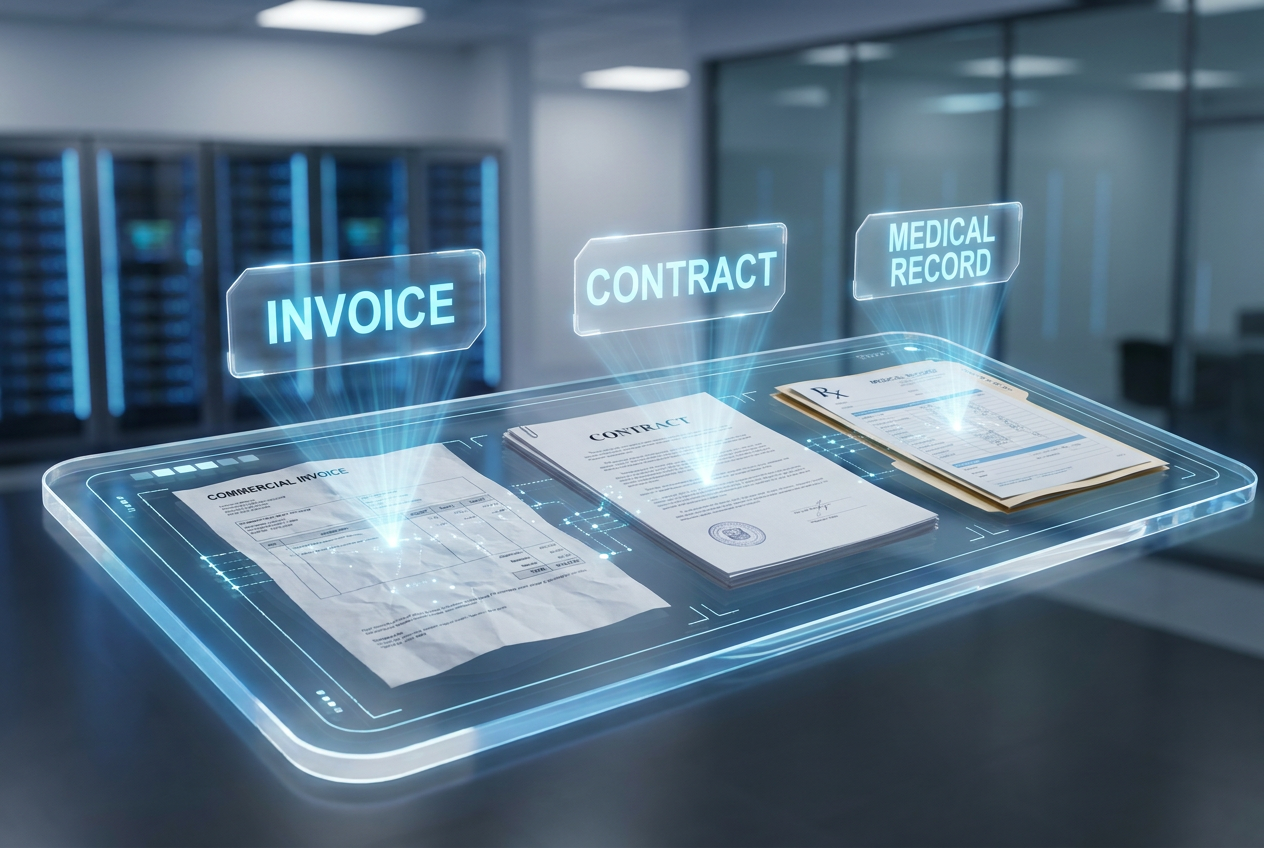
Ettevõtete infohaldus ei ole enam lihtsalt dokumentide arhiveerimine või PDF-ide salvestamine jagatud kausta. Andmete plahvatusliku kasvu tõttu on organisatsioonid uppunud struktureerimata failide merre , kus konkreetse teabe leidmine võib muutuda tõeliseks odüsseiaks. Siin tulebki mängu tehisintellekt arhiveerimises ja dokumendihalduses , mis mitte ainult ei ulatu appi, vaid muudab täielikult mängureegleid, muutes dokumentide kaose strateegiliseks ressursiks.
Nutikate tuvastus- ja analüüsisüsteemide rakendamine võimaldab ettevõtetel lõpetada aja raiskamise korduvatele ja tüütutele ülesannetele. Enam pole vaja, et ekspert iga lepingut käsitsi loeks või iga arvet üle vaataks; nüüd saavad masinad tänu masinõppe algoritmidele ja arvutinägemisele aru dokumendi sisust, selle eesmärgist ja võimalikest riskidest – kõik sekundi murdosa jooksul ja täpsusega, mis paneb inimsilma häbisse.

Nutikas dokumentide klassifikatsioon
Failide liigitamine on enamat kui lihtsalt sildistamine; see hõlmab äridokumentide automaatset kategoriseerimist ressursside optimeerimiseks ja kriitiliste vigade vältimiseks. Varem oli see protsess pudelikaelaks, mis nõudis keerukat programmeerimist või tüütut käsitsitööd. Tänapäeval skannib tehisintellekt iga sissetulevat faili ja paigutab selle eelnevalt määratletud kategooriatesse, saates selle sujuvaks töötlemiseks otse sobivasse töövoogu.
Selle toimimiseks kasutab tehisintellekt põhimõisteid, nagu üksuste identifitseerimine (nimed, kuupäevad või numbrid), riskikategooria määramine (näiteks avalikud või konfidentsiaalsed dokumendid) ja püsiv märgistamine. Viimane on oluline, et teised turbetööriistad teaksid, kuidas failiga ümber käia. Lisaks võimaldab kontekstualiseerimine tehisintellektil dokumenti selle elutsükli jooksul mõista, saavutades üle 95% täpsuse, tuginedes mitte ainult märksõnadele, vaid ka teksti tegelikule tähendusele.

Identiteedi kontrollimine ja pettuste ennetamine
Turvasektoris on tehisintellekt teinud isikut tõendavate dokumentide kontrollimisel tohutu hüppe, saades KYC (tunne oma klienti) ja AML (rahapesu tõkestamise) protsesside keskmeks. Arvutinägemise ja pildianalüüsi abil suudavad süsteemid tuvastada peaaegu nähtamatuid muudatusi, näiteks manipuleeritud hologramme, võltsitud vesimärke või mikrokirja ebakõlasid, mis enamikule inimestele märkamatuks jääksid.
Üks selle tugevamaid külgi on võime võidelda digitaalse pettusega. Tehisintellekt analüüsib pikslitasandil anomaaliaid, et tuvastada Photoshopi retušeerimist või näo muutmist (sügavvõltsingud). Lisaks võrdleb biomeetriline näotuvastuse abil dokumendifotot kasutaja reaalajas videoga, kasutades passiivset või aktiivset elusoleku tuvastamist, et tagada dokumendi esitaja füüsiline kohalolek, mitte lihtsalt mask või foto.

Juhtimistehnoloogiad: IDP, NLP ja OCR
Kõige selle liikumapanev jõud on intelligentne dokumenditöötlus (IDP), mis ühendab mitu tehnoloogiat, et andmetest reaalset väärtust ammutada. Täiustatud OCR ei loe enam lihtsalt tähti; see tõlgendab konteksti täpsuse tagamiseks , teisendades pildid või füüsilised dokumendid struktureeritud andmeteks. Samal ajal võimaldab loomuliku keele töötlemine (NLP) masinal mõista teksti semantikat, hõlbustades mustrite ja anomaaliate tuvastamist.
- Azure'i tehisintellekti otsing: Teenus, mis võimaldab teha sügavaid semantilisi otsinguid tohututes struktureerimata andmemahtudes, ideaalne õigus- või personaliosakondadele.
- Keelemudelid (LLM-id): Tööriistad nagu GPT-4, Claude või Gemini suudavad korraga kokku võtta mitu faili ja vastata keerukatele küsimustele allika sisu kohta.
- Käitumise analüüs: Süsteemid, mis jälgivad kasutaja suhtlust dokumendiga, et tuvastada võimalikud pettuse tunnused.
Reaalsed rakendused erinevates sektorites
Nende tööriistade mitmekülgsus võimaldab peaaegu igal sektoril neist kasu saada. Finantssektoris automatiseeritakse maksed ja laenude valideerimine reaalajas andmete ekstraheerimise abil. Õigussektoris analüüsib tehisintellekt lepinguid, et tuua esile riskantsed klauslid või rikkumised, sujuvamaks muutes e-avalikustamise protsessi, filtreerides tuhandeid dokumente sekunditega.
Tervishoiusektor kasutab tehisintellekti meditsiiniliste andmete digitaliseerimiseks ja kindlustusnõuete automatiseerimiseks , vältides tundlike andmete kadumist. Samal ajal võimaldab personalijuhtimise valdkonnas ettevõtte ressursiplaneerimise (ERP) ja personalitarkvara integreerimine CV-sid oskuste järgi automaatselt liigitada, et leida ideaalne kandidaat ilma sadade profiilide läbivaatamist vajamata. Logistikas vähendab saatelehtede ja arvete tuvastamine drastiliselt tegevusvigu ja optimeerib tarneahelat.

Süsteemi rakendamine ja väljakutsed
Sellise süsteemi juurutamiseks ei piisa ainult tarkvara installimisest; tuleb tuvastada probleemsed kohad, näiteks aeganõudvad protsessid. Oluline on määratleda mõõdetavad eesmärgid ning tagada lahenduse skaleeritavus ja vastavus sellistele eeskirjadele nagu GDPR ja CCPA, kuna isikuandmete käitlemine on tundlik valdkond.
Kõik ei lähe libedalt, sest sellega kaasneb märkimisväärseid väljakutseid. Treeningandmete kallutatus võib teatud demograafiliste rühmade puhul viia ebaõiglaste tulemusteni, mistõttu on mitmekesiste andmekogumite kasutamine ülioluline. Lisaks arendavad petised pidevalt oma taktikat, sundides tehisintellekti mudeleid pidevalt ümber õppima, et vältida vananemist.
Nende võimaluste integreerimine võimaldab andmete kadumise ennetamise (DLP) tööriistadel töötada kirurgilise täpsusega. Kui tehisintellekt märgistab faili kõrge riskiga konfidentsiaalseks , saab turvasüsteem automaatselt blokeerida selle väljumise ettevõtte võrgust. See muudab dokumendihalduse tõeliseks küberturvalisuse kilbiks, mis tagab tundliku teabe täieliku jälgitavuse.
Semantilise analüüsi, arvutinägemise ja generatiivsete mudelite lähenemine loob ökosüsteemi, kus teavet enam lihtsalt ei talletata, vaid seda aktiivselt hallatakse. Failitüübi tuvastamise ja valideerimise automatiseerimise abil ei vähenda organisatsioonid mitte ainult kulusid ja aega, vaid kaitsevad ka oma infrastruktuuri pettuste eest ning annavad võimaluse teha otsuseid reaalsete ja struktureeritud andmete põhjal.
