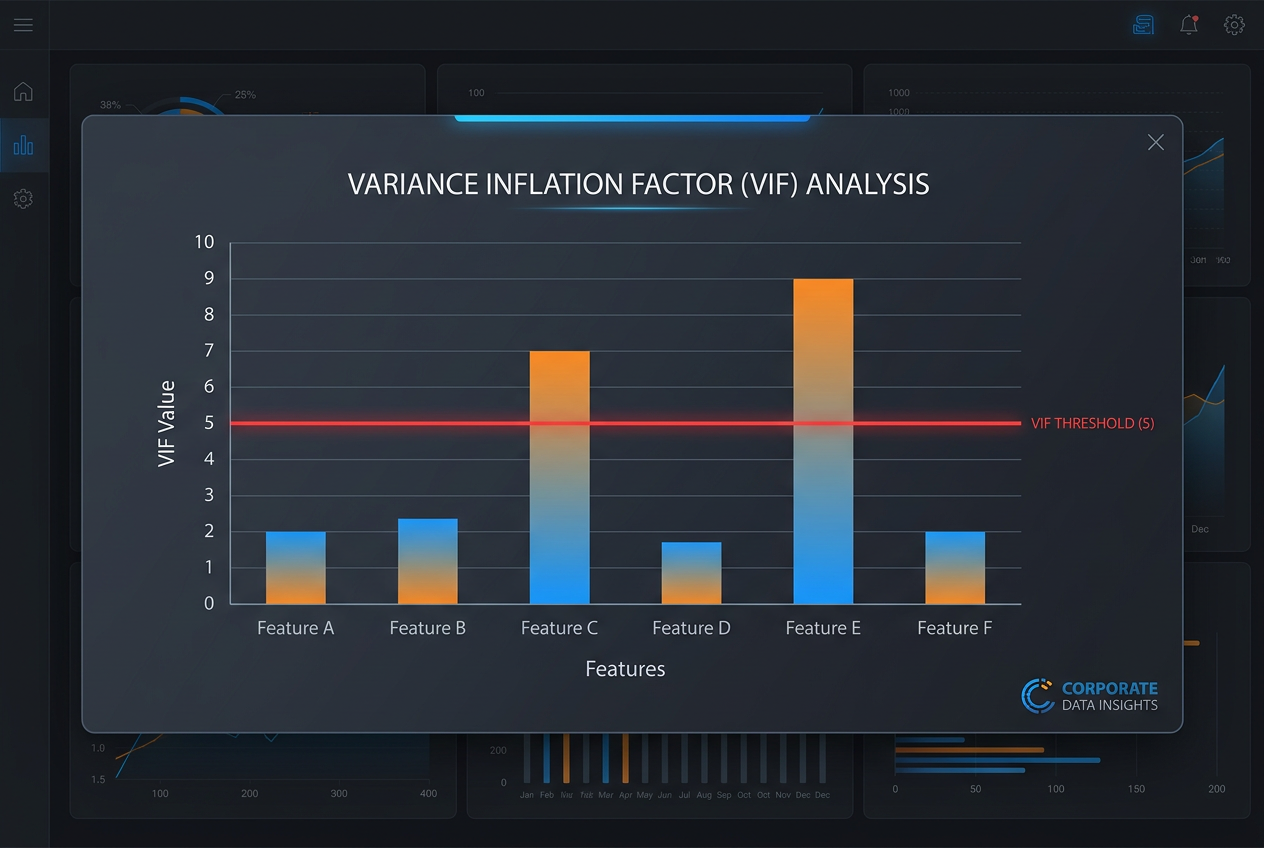
- Le VIF permet la détection de la multicolinéarité dans les modèles de régression, étant critique lorsque les valeurs dépassent le seuil de 5.
- L'implémentation en C# nécessite une normalisation des données afin de garantir la stabilité numérique et d'éviter les erreurs de précision.
- Une conception de code propre doit séparer les ressources externes, l'état des données et la logique comportementale afin d'optimiser les performances.
Si vous vous êtes déjà aventuré dans le monde de l'analyse de données, vous avez certainement rencontré le problème de la multicolinéarité. Concrètement, elle survient lorsque vos variables indépendantes sont trop étroitement corrélées, ce qui peut entraîner un dysfonctionnement de votre modèle de régression et produire des résultats peu fiables. Pour mettre de l'ordre dans ce chaos, le facteur d'inflation de la variance (VIF) entre en jeu : un outil essentiel pour identifier les variables à l'origine du problème.
Bien que de puissantes bibliothèques existent pour des langages comme R ou Python, la mise en œuvre de ce concept en C# exige une solide compréhension des mathématiques sous-jacentes et de la structuration du code pour une maintenance aisée. Il ne s'agit pas simplement d'implémenter des fonctions au hasard, mais d' organiser la logique de programmation afin que le logiciel soit lisible et performant, évitant ainsi que le code ne ressemble à un amas de lettres cryptiques.

Comprendre le VIF et la multicolinéarité
Le facteur d'inflation de la variance (VIF) mesure l'augmentation de la variance d'un coefficient estimé due à sa corrélation avec d'autres variables du modèle. Autrement dit, un VIF très élevé pour une variable signifie qu'une grande partie de son information est déjà masquée par d'autres variables, ce qui fait exploser les erreurs standard et rend très difficile l'identification de la variable ayant réellement une influence sur le résultat.
De nombreux analystes considèrent généralement qu'une valeur VIF supérieure à 5 indique une multicolinéarité préoccupante. Dans des cas plus extrêmes, une valeur supérieure à 10 signale clairement la nécessité de revoir ou de supprimer la variable de l'ensemble de données afin d' assainir le modèle et d'améliorer sa stabilité numérique.
Implémentation technique et logique en C#
Pour calculer le VIF d'une variable spécifique dans une matrice de plan d'expérience, on traite cette variable comme s'il s'agissait de la variable dépendante et on effectue une régression linéaire en utilisant toutes les autres variables indépendantes comme prédicteurs. Le résultat est le coefficient de détermination R², et le VIF se calcule à l'aide de la formule 1 / (1 – R²).
Lors de la programmation en C#, il est crucial de veiller à la stabilisation numérique . Une bonne pratique consiste à normaliser les colonnes de la matrice de conception, en fixant la moyenne à 0 et l'écart type à 1. Ceci est essentiel lors de la manipulation de données sur des échelles très différentes ou soumises à des transformations non linéaires, car cela évite les plantages du programme dus à des erreurs de précision décimale.
Principes de conception de code propre
Au-delà de la formule elle-même, la façon dont on écrit le code en C# fait toute la différence. Une erreur fréquente consiste à créer des objets qui font des choses pour lesquelles ils ne sont pas conçus ; par exemple, une classe « Ball » possédant une méthode « Throw() », ce qui n’a aucun sens puisqu’une balle ne se lance pas toute seule. Le code doit se lire comme des phrases bien construites , où le sujet effectue une action cohérente sur un objet.
- Ressources externes : Elles devraient être gérées à un niveau d'abstraction distinct, idéalement par le biais de l'injection de dépendances.
- État et données : Le code centré sur les données doit suivre les principes de la programmation orientée objet (POO).
- Comportements: La logique et les algorithmes doivent fonctionner comme des fonctions pures, prenant les données et les ressources comme paramètres.
Pour organiser le projet, une hiérarchie est suggérée : elle commence par l’espace de noms, se poursuit par les classes statiques à mesure que la complexité augmente, et se termine par les classes dynamiques. Il est préférable de regrouper les classes apparentées dans un même fichier si elles partagent la même problématique ; cela aide le compilateur à optimiser le binaire et améliore les performances d’exécution grâce à une meilleure gestion du cache et des registres du processeur.
Alternatives et visualisation des données
Bien que C# soit robuste pour la mise en œuvre, des outils comme R sont souvent utilisés dans des environnements d'exploration rapide. Dans ce langage, des bibliothèques telles que « car » permettent un calcul quasi instantané du VIF. Une fois les valeurs obtenues, il est préférable de ne pas se fier uniquement aux chiffres, mais d'utiliser des graphiques à barres pour identifier visuellement les sources de multicolinéarité.
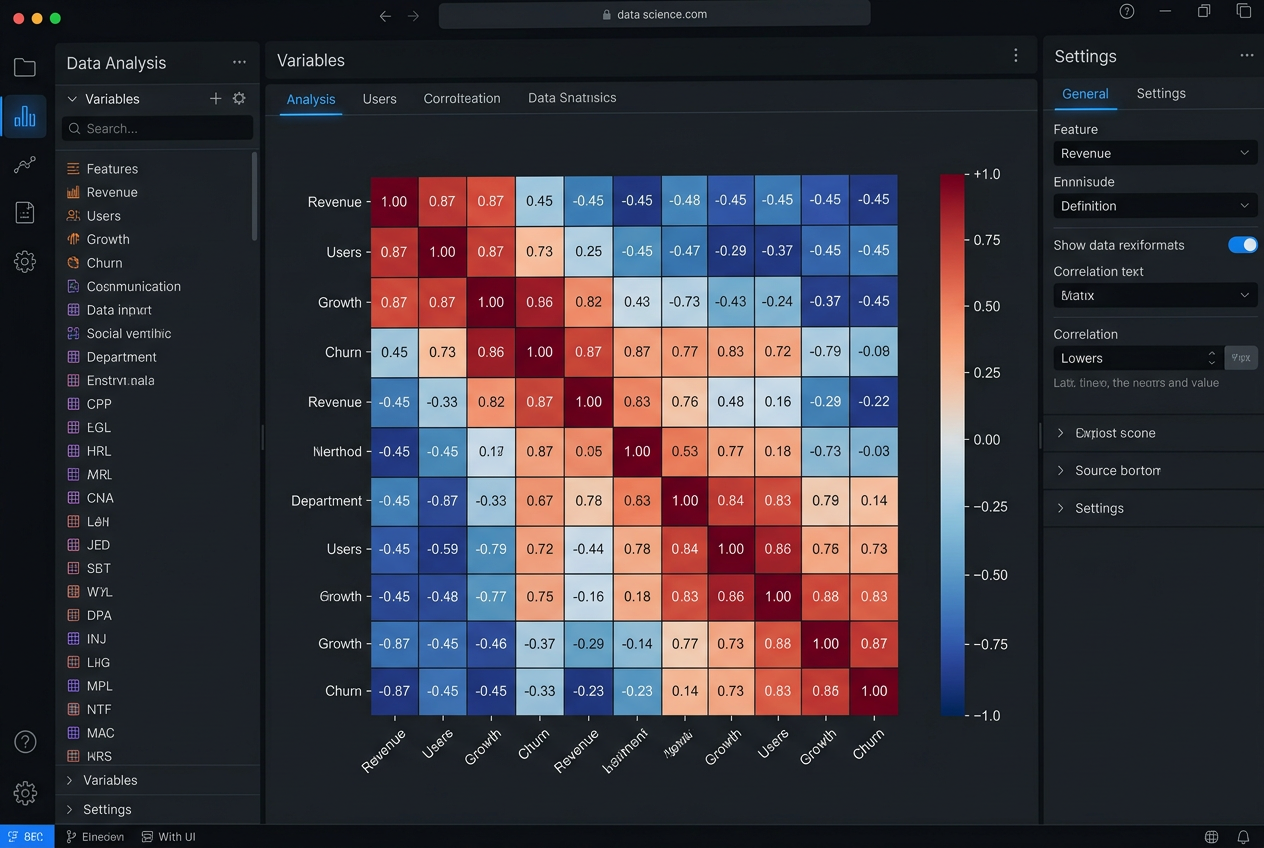
L'ajout d'une matrice de corrélation à l'analyse est une étape cruciale. Visualiser les relations entre les variables à l'aide de couleurs permet de comprendre non seulement l'existence d'un problème de VIF, mais aussi d'identifier précisément la paire de variables à l'origine du conflit. Cette combinaison d' analyse statistique et de visualisation garantit la fiabilité du modèle final et évite qu'il ne s'agisse d'un château de cartes.
Une gestion rigoureuse des VIF, associée à une architecture logicielle basée sur le principe de responsabilité unique et une structure de données standardisée, permet de créer des outils d'analyse C# à la fois performants et faciles à maintenir. En éliminant la redondance des données et en appliquant des principes de conception cohérents , nous transformons un code complexe en une solution professionnelle capable de gérer des régressions complexes avec une fiabilité absolue.