- VibeVoice est un modèle TTS de Microsoft capable de générer un son long, expressif et multilocuteur, idéal pour les podcasts et les livres audio.
- Son architecture combine des analyseurs de la parole, un modèle de langage étendu et la diffusion pour obtenir des voix naturelles même dans des enregistrements audio d'une durée allant jusqu'à 90 minutes.
- Elle permet des réponses quasi instantanées avec de légères variations, mais nécessite une utilisation responsable en raison des risques de clonage vocal et de deepfakes.
- Il a été publié en tant que framework de recherche open source, bien que Microsoft ait temporairement limité l'accès au dépôt en raison de préoccupations liées à une utilisation abusive.

L'arrivée de VibeVoice de Microsoft révolutionne la création de podcasts et de contenus audio longs grâce à l'intelligence artificielle. Ce modèle de synthèse vocale open source génère des voix hyperréalistes et permet de réaliser des conversations à plusieurs intervenants d'une durée allant jusqu'à 90 minutes, sans coupures ni perte de qualité.
L'objectif de VibeVoice est de fournir à tous un studio d'enregistrement virtuel capable de produire des podcasts, des livres audio ou des narrations de qualité professionnelle depuis un ordinateur. Il suffit d'un script et de quelques connaissances techniques de base pour configurer le modèle ; l'IA se charge du reste : intonation, naturel, variations de voix et continuité audio.
Qu'est-ce que VibeVoice et pourquoi est-ce si important pour les podcasts ?
Ce modèle repose sur la technologie TTS (Text-to-Speech), c'est-à-dire qu'il transforme directement le texte en parole , avec une fluidité et des nuances très proches de la parole humaine. VibeVoice a été initialement lancé en versions 1.5B et 7B de paramètres , conçues pour optimiser la qualité et la capacité à générer de longs flux audio sans consommer excessivement de ressources.
L'un de ses principaux atouts réside dans sa capacité à enregistrer en continu jusqu'à 90 minutes d'audio , en préservant la constance de la voix et de l'intonation. Ceci le rend particulièrement utile pour les podcasts complets, les chapitres de livres audio ou les longs épisodes de contenu éducatif, qui nécessitaient auparavant plusieurs séances d'enregistrement avec des comédiens de doublage.
De plus, VibeVoice est conçu pour gérer jusqu'à quatre voix différentes dans un seul enregistrement audio , permettant ainsi de simuler des interviews, des tables rondes, des dialogues entre personnages ou des épisodes narrés par différents comédiens de doublage. Cette capacité multi-intervenants est essentielle pour rendre les podcasts basés sur l'IA plus dynamiques et captivants.
Comment fonctionne VibeVoice : synthèse vocale avancée et faible latence
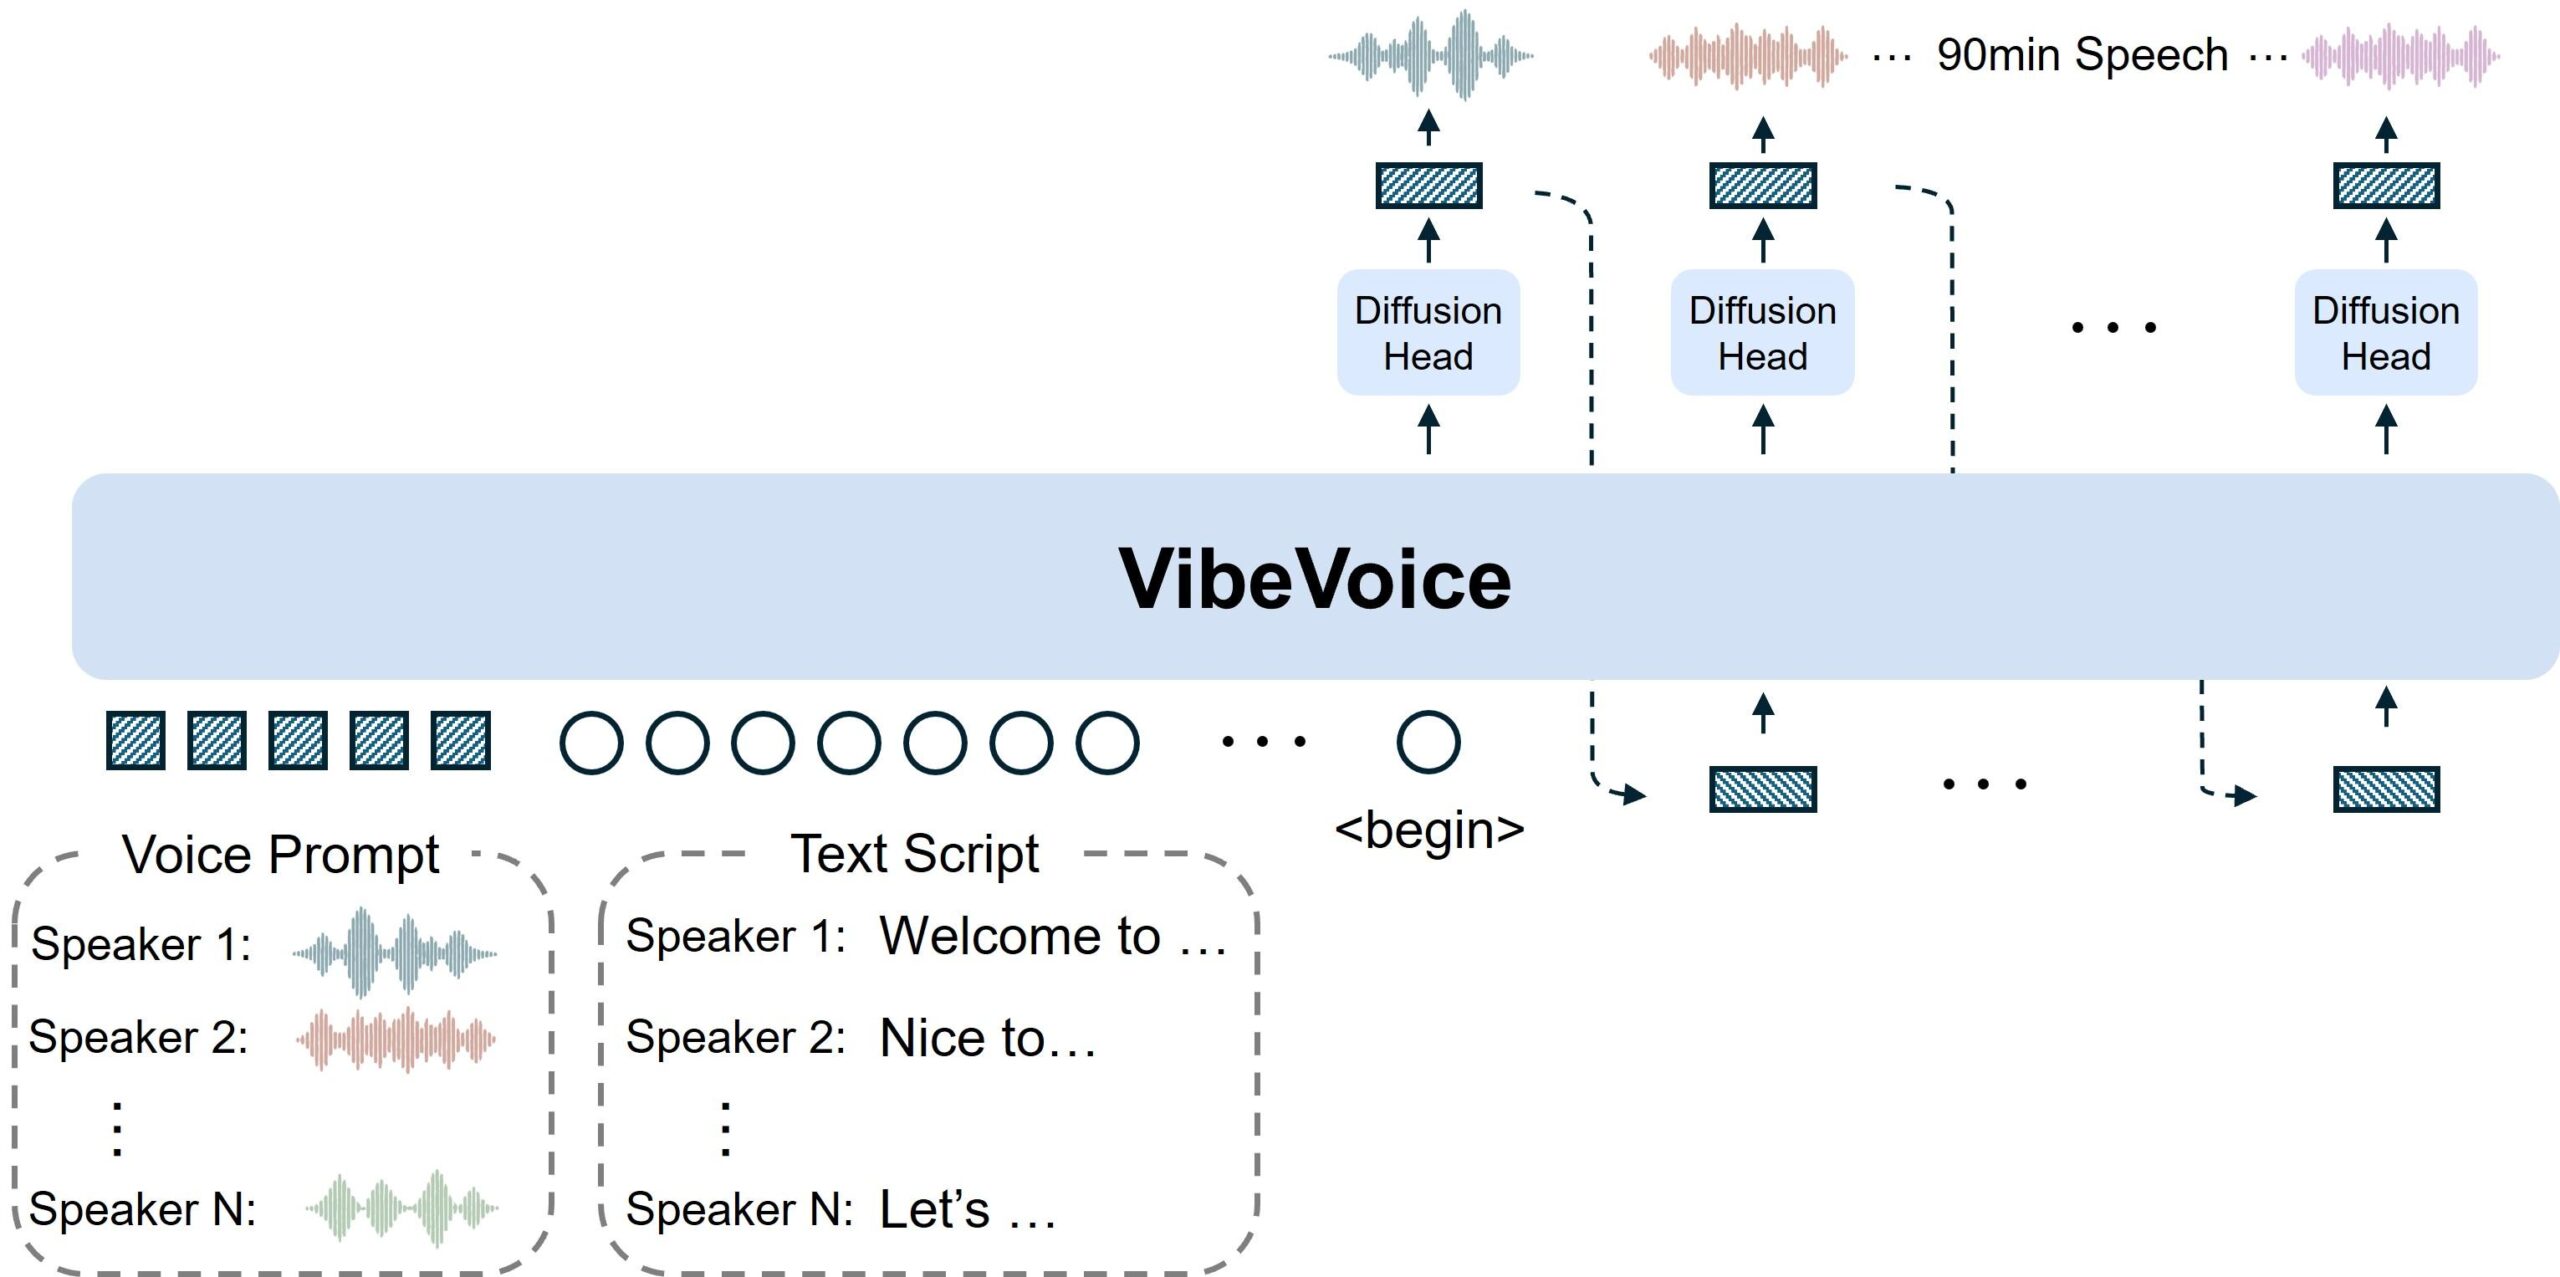
Au-delà de son nom accrocheur, la particularité de VibeVoice réside dans son architecture technique conçue pour les longs enregistrements audio et les conversations . Microsoft combine plusieurs composants pour un rendu vocal naturel, une adaptation au texte et une génération quasi instantanée.
Le système utilise des analyseurs de parole acoustiques et sémantiques continus fonctionnant à une fréquence très basse, autour de 7,5 Hz. Cela signifie qu'il condense les informations audio en moins d'« étapes » par seconde que d'autres modèles, préservant ainsi la fidélité sonore tout en réduisant considérablement le coût de calcul lors du traitement de longues séquences.
À cette représentation compressée s'ajoute un modèle de langage étendu (LLM) qui interprète le contenu du script, le déroulement de la conversation et identifie l'interlocuteur à chaque instant. Il comprend ainsi s'il s'agit d'une question, d'une réponse, d'une remarque ironique ou d'un changement de sujet, et adapte la voix en conséquence.
Enfin, une tête de diffusion est utilisée pour restituer les détails acoustiques avec une grande précision : timbre, texture vocale, respirations subtiles et autres nuances. Cette combinaison LLM + diffusion garantit un rendu audio homogène, expressif et agréable à écouter, même pendant de longues périodes.
Parallèlement, Microsoft a lancé une variante spécifique appelée VibeVoice-Realtime-0.5B , conçue pour des réponses extrêmement rapides : ce modèle peut commencer à émettre de la voix environ 300 millisecondes après la réception du texte. Autrement dit, quasiment en temps réel, idéal pour les agents vocaux, les assistants conversationnels ou les applications où la latence doit être minimale.
Versions disponibles : modèles, paramètres et utilisations recommandées
Au sein de l'écosystème VibeVoice, plusieurs versions ont été introduites avec différentes tailles et orientations de modèles , conçues à la fois pour les applications audio longues et interactives.
D'une part, nous avons les principales variantes à 1.5 milliard et 7 milliards de paramètres , conçues pour gérer des contenus volumineux tels que des podcasts complets, des émissions de radio simulées, des chapitres de livres audio ou des cours audio. Un nombre plus élevé de paramètres permet une meilleure capture des nuances et une gestion plus fine des dialogues complexes, mais augmente également les exigences matérielles.
En revanche, la version VibeVoice-Realtime-0.5B privilégie la rapidité de réponse à la taille du modèle. Bien qu'elle ne possède « que » 0,5 milliard de paramètres , un nombre modeste comparé à des géants comme ChatGPT ou Gemini, c'est précisément ce qui lui permet de générer jusqu'à 90 minutes d'audio en continu tout en conservant une voix claire et une intonation stable.
Cette variante en temps réel est particulièrement intéressante pour les agents vocaux, les chatbots, les assistants virtuels et toute application où l'utilisateur attend une réponse vocale immédiate de l'IA, et non un simple message textuel. Avec une latence proche de 300 ms, l'expérience est très similaire à une conversation avec un interlocuteur humain.
Dans tous les cas, le modèle est destiné à être utilisé dans des environnements locaux ou de recherche , puisque Microsoft a initialement décidé de le publier en tant que projet open source, accessible depuis GitHub et des plateformes comme Hugging Face, ce qui permet à la communauté de le tester, de l'adapter et de créer des outils à partir de celui-ci.
Applications pratiques : comment créer un podcast avec VibeVoice
L'une des applications phares de VibeVoice est sans conteste la création de podcasts sans avoir recours à des comédiens de doublage . Pour tous ceux qui ont des idées, des scripts ou du contenu écrit, mais qui n'osent pas se mettre devant un micro, ce modèle représente une formidable opportunité.
Le processus de production d'un podcast avec VibeVoice repose généralement sur la préparation d'un script bien structuré : introduction, blocs de contenu, interviews potentielles (réelles ou fictives), transitions et conclusion. Plus le texte est clair, mieux le modèle peut saisir les variations de ton, les pauses et le rôle de chaque intervenant.
Ensuite, à l'aide d'outils basés sur ce modèle (scripts, interfaces graphiques ou intégrations avec d'autres applications), chaque partie du texte est attribuée à l'un des intervenants disponibles . On peut, par exemple, utiliser une voix pour le présentateur, une autre pour un invité régulier, une autre encore pour les questions du public et une quatrième pour les notes informatives ou les séquences sponsorisées.
Le modèle génère un flux audio continu tout en respectant l'ordre du script, les transitions vocales et le rythme de la conversation. Le résultat peut ensuite être peaufiné dans un logiciel de montage audio classique : ajout de musique de fond, d'effets sonores, de transitions, ou ajustements mineurs de volume et d'égalisation.
Grâce à la possibilité de générer jusqu'à 90 minutes de contenu sans perte de cohérence , nous pouvons créer un épisode complet en une seule fois : il n'est pas nécessaire d'enregistrer par petits blocs ni de s'inquiéter de la fatigue vocale, des erreurs de diction ou du bruit de fond, autant de problèmes qui, dans une cabine physique, sont un véritable casse-tête.
Clonage vocal par IA et personnalisation vocale
L'une des avancées les plus subtiles et pourtant les plus puissantes de cette technologie est le « clonage vocal », ou clonage vocal assisté par l'IA . Il fait appel à des techniques de synthèse basées sur l'apprentissage profond qui permettent de reproduire le timbre, les intonations et les nuances d'une voix spécifique.
En pratique, ces systèmes analysent les caractéristiques uniques de la voix cible, telles que le timbre, les formants, le rythme de la parole et les schémas prosodiques (pauses, accents, intonation interrogative, etc.). À partir de quelques secondes d'échantillon seulement, ils sont capables de générer une voix synthétique qui ressemble fortement à l'originale.
VibeVoice permet , semble-t-il, d'obtenir des simulations très précises à partir de seulement 10 secondes d'audio original , capturant avec une grande fidélité l'impact émotionnel et la texture de la voix. Pour un podcast, cela ouvre des perspectives intéressantes, comme le maintien de l'identité vocale de la marque même après l'arrêt de l'enregistrement, ou la création de personnages récurrents dotés d'une voix caractéristique.
Cependant, cette capacité comporte des risques éthiques très sérieux et la nécessité de détecter les contenus audio synthétiques :
C’est pourquoi Microsoft souligne que VibeVoice est lancé dans un cadre de recherche et avec des avertissements clairs : il ne doit pas être utilisé pour l’usurpation d’identité, la fraude, la manipulation ou les campagnes de désinformation. Un usage responsable est un élément essentiel de cet écosystème.
Avantages pour les créateurs de contenu et les petits projets
Avec un ordinateur capable d'exécuter le modèle et un peu de temps pour écrire les scripts, il est possible de convertir de longs textes en audio de qualité professionnelle en quelques minutes. Cela s'applique aux podcasts informatifs, aux bulletins d'information, aux récits de fiction, aux romans-feuilletons, ou même aux manuels techniques narrés.
C'est également une aide précieuse pour recycler les contenus écrits existants : articles de blog, newsletters, fils de discussion sur les réseaux sociaux ou rapports peuvent être transformés en épisodes audio qui élargissent la portée du message et offrent une solution plus pratique pour ceux qui préfèrent écouter plutôt que lire.
Un autre avantage réside dans la constance de la qualité au fil du temps . Alors qu'un comédien de doublage humain peut moduler son énergie, son intonation ou sa clarté selon les jours, l'IA maintient un niveau constant, ce qui facilite la production en série : plusieurs épisodes enregistrés en une seule prise conserveront la même présence et le même style vocal.
Dans le domaine de l'éducation, VibeVoice est idéal pour les cours audio, les lectures guidées et les ressources accessibles aux personnes malvoyantes ou à celles qui préfèrent apprendre en écoutant tout en effectuant d'autres tâches. La possibilité de générer des versions audio de leçons ou de documents longs offre une multitude d'opportunités.
Risques, limitations et décision de Microsoft concernant le dépôt
En revanche, l'intelligence artificielle capable d' imiter la voix humaine et de générer un discours réaliste soulève de sérieuses questions d'éthique et de sécurité. Le risque d'utilisation malveillante est bien réel, et les grandes entreprises technologiques en sont de plus en plus conscientes.
Dans le texte de lancement, Microsoft indique clairement que VibeVoice ne doit pas être utilisé pour la création de deepfakes, l'usurpation d'identité ou des activités illégales . Son utilisation est également formellement interdite dans le cadre de la désinformation ou de la fraude, car son réalisme pourrait facilement tromper des auditeurs non avertis.
Bien que la voix générée soit très convaincante, les créateurs du modèle soulignent qu'elle ne restitue pas encore toutes les subtilités d'une voix humaine : la respiration, les micro-variations émotionnelles, certaines pauses naturelles et les changements de rythme sont plus riches chez une personne que dans une IA. Cette « imperfection » peut aider, en partie, à détecter qu'il s'agit d'une voix synthétique, mais la frontière devient de plus en plus floue.
Suite à la publication du projet en tant que cadre de recherche open source , Microsoft a constaté des cas d'utilisation du modèle non conformes à son objectif initial et aux principes d'utilisation responsable. En conséquence, l'entreprise a annoncé avoir été contrainte de désactiver temporairement le dépôt jusqu'à ce qu'elle puisse garantir que ces utilisations non autorisées cessent définitivement.
Ce communiqué souligne que l'utilisation responsable de l'IA est un principe fondamental pour Microsoft , et que l'entreprise préfère suspendre et examiner l'outil plutôt que de le maintenir, car il pourrait faciliter des abus graves. Malgré cela, la documentation, les démonstrations et les ressources techniques ont déjà contribué à inspirer la communauté et à faire progresser le domaine de la synthèse vocale.
Autres applications au-delà du podcasting
Bien que l'attention médiatique se soit principalement portée sur les podcasts, VibeVoice ouvre la voie à un large éventail d'applications dans le domaine de l'audio généré par l'IA. Nombre d'entre elles s'intègrent également aux stratégies de contenu numérique et d'automatisation.
L'un des exemples les plus flagrants est celui des livres audio et des histoires narrées , où il est crucial de disposer de voix expressives capables de captiver l'attention pendant des dizaines de minutes. La présence de plusieurs locuteurs permet à chaque personnage d'avoir sa propre voix, améliorant considérablement l'expérience d'écoute par rapport à un narrateur unique.
Dans le domaine des agents vocaux et des assistants conversationnels, la version temps réel de VibeVoice est idéale. Un bot qui répond avec un délai de seulement 300 ms paraît beaucoup plus naturel qu'un bot qui met plusieurs secondes à parler, ce qui rend les interactions avec le service client, les chatbots ou les interfaces vocales bien plus fluides.
Un autre domaine très intéressant est celui du contenu automatisé : résumés d’actualités, mises à jour du marché, rapports périodiques ou même lectures et notifications par e-mail peuvent être générés sans intervention humaine, tout en conservant un ton cohérent avec l’image de marque.
Enfin, il existe des applications plus expérimentales, comme la création de dialogues fictifs, d'interviews simulées ou de programmes de divertissement entièrement conçus par l'IA . Dans ce cas, des modèles de langage pour l'écriture de scénarios sont combinés à VibeVoice pour le doublage, donnant naissance à des formats qui relevaient encore récemment de la science-fiction.
Dans son ensemble, VibeVoice se distingue comme un acteur clé de la nouvelle vague de l'audio généré par IA , capable de combiner voix naturelles, conversations à plusieurs participants, extraits audio très longs et réponses quasi instantanées. Utilisé de manière responsable et dans le respect des principes éthiques établis, il peut devenir un outil incroyablement puissant pour quiconque souhaite lancer ou développer un podcast, produire des livres audio ou ajouter des voix off professionnelles à ses projets numériques sans avoir systématiquement recours à un studio d'enregistrement traditionnel.

Sommaire
- 1 Qu'est-ce que VibeVoice et pourquoi est-ce si important pour les podcasts ?
- 2 Comment fonctionne VibeVoice : synthèse vocale avancée et faible latence
- 3 Versions disponibles : modèles, paramètres et utilisations recommandées
- 4 Applications pratiques : comment créer un podcast avec VibeVoice
- 5 Clonage vocal par IA et personnalisation vocale
- 6 Avantages pour les créateurs de contenu et les petits projets
- 7 Risques, limitations et décision de Microsoft concernant le dépôt
- 8 Autres applications au-delà du podcasting