- La cohérence du cache garantit que toutes les copies des mêmes données dans différents caches et dans la RAM restent cohérentes sur les systèmes multicœurs.
- La hiérarchie de cache avec un dernier niveau partagé simplifie le contrôle de la cohérence et réduit les accès directs à la mémoire principale.
- Les protocoles de cohérence utilisent des stratégies d'invalidation ou de mise à jour des copies, prises en charge par des états et des bits de contrôle par ligne de cache.
- Le compilateur et le système d'exploitation peuvent renforcer la cohérence matérielle en insérant des instructions et en configurant la mémoire pour les périodes critiques.
Lorsqu'on examine le schéma d'un processeur multicœur moderne, on retrouve systématiquement la même configuration : plusieurs cœurs, chacun doté de ses propres caches, et un cache de dernier niveau partagé servant de point d' accès commun avant la mémoire vive. Cette organisation n'est ni fortuite ni le fruit du hasard, mais une réponse directe à un problème critique des systèmes parallèles : la cohérence des caches.
Sans un mécanisme de cohérence robuste, chaque cœur pourrait se retrouver à utiliser une version différente et obsolète des mêmes données en mémoire , ce qui, dans un programme réel, se traduit par des erreurs subtiles, des pannes imprévisibles, voire des plantages système. Par conséquent, comprendre comment cette cohérence est maintenue, tant au niveau matériel que logiciel, est essentiel pour appréhender les performances et la stabilité des processeurs multicœurs modernes.
Qu’est-ce que la cohérence du cache : la métaphore du terminal ?

Imaginez plusieurs personnes assises devant différents terminaux, modifiant toutes le même document stocké sur un serveur central . Chaque écran affiche une copie du fichier, et toute modification apportée par une personne doit être immédiatement visible sur les écrans des autres.
Pour que cela fonctionne, un mécanisme de synchronisation est nécessaire afin de diffuser les modifications apportées aux documents sur tous les terminaux, pour que chacun voie toujours la même version. Tant que ce système est opérationnel, tout se déroule sans problème : quiconque modifie le texte sait que la nouvelle version sera visible quasi instantanément pour tous les autres utilisateurs.
Imaginez maintenant que le système de synchronisation tombe soudainement en panne. Chacun continue de modifier le document, persuadé de travailler sur le document partagé, mais en réalité, chaque terminal se retrouve avec sa propre copie locale, déconnectée . Dès lors, les modifications apportées par une personne ne sont plus répercutées sur les autres, et le document commence à diverger de manière incontrôlable.
En informatique, c'est précisément ce qui se produirait si le processeur était dépourvu d'un protocole de cohérence fiable : un cœur modifie des données en mémoire, tandis que les autres cœurs continuent de lire une version antérieure depuis leurs caches privés . Ceci crée un terrain propice aux erreurs logiques graves, à la corruption des données et aux comportements difficiles à déboguer.
La cohérence du cache désigne donc l'ensemble des mécanismes qui garantissent que, dans un système multicœur, toutes les copies d'une même donnée réparties entre les différents caches et la RAM conservent un état cohérent . Même en présence de plusieurs copies, le système doit se comporter comme s'il n'y en avait qu'une seule.
Hiérarchie des caches et de la mémoire dans un processeur multicœur
Les caches du processeur sont de petites mémoires très rapides qui stockent des copies des blocs de RAM fréquemment utilisés . Lorsque le processeur exécute du code, au lieu d'accéder continuellement à la RAM (relativement lente), il tente de lire et d'écrire dans le cache, réduisant ainsi considérablement la latence.
L'astuce, bien sûr, est que les caches ne stockent pas la « version officielle » des données, mais seulement une réplique temporaire . Pour reprendre la métaphore du terminal, la RAM correspondrait au document sur le serveur, tandis que les caches seraient les écrans locaux affichant des copies de certaines parties du fichier.
Dans un processeur multicœur, la conception se complexifie car chaque cœur possède généralement ses propres caches privés de niveau 1 (L1) et même de niveau 2 (L2) . À cela s'ajoute un cache de niveau 3 partagé (par exemple), situé entre les cœurs et le contrôleur mémoire qui assure l'accès à la RAM.
Ce cache partagé est introduit car permettre à tous les cœurs d'accéder directement et intensivement à la RAM entraînerait des conflits d'accès, une contention sur le bus mémoire et une baisse significative des performances . Le cache de dernier niveau agit comme un tampon commun qui réduit les accès à la RAM et centralise une grande partie du trafic de données.
De plus, de nombreuses architectures organisent les caches de manière inclusive : les lignes stockées dans les niveaux proches du processeur sont également présentes dans les niveaux supérieurs de la hiérarchie . Autrement dit, une ligne présente dans L1 se trouve aussi dans L2, et ainsi de suite jusqu’à L3. Ceci a une conséquence très utile pour la cohérence : la simple mise à jour correcte du cache de plus bas niveau suffit à contrôler l’état des autres niveaux sans avoir à accéder constamment à la RAM.
Pourquoi la mise en cache partagée de dernier niveau est essentielle à la cohérence
Sans ce cache global de dernier niveau, chaque cœur devrait vérifier la cohérence directement avec la mémoire principale . À chaque modification d'une ligne mémoire dans un cache privé, il faudrait vérifier si d'autres cœurs conservent une copie de cette même ligne et, le cas échéant, la mettre à jour ou l'invalider partout.
Dans un système multicœur, cette charge de travail liée aux vérifications engendrerait un nombre considérable d'accès à la RAM , annulant ainsi une grande partie des avantages liés à la rapidité des caches. En plaçant un cache partagé entre les cœurs et la mémoire, le processeur peut centraliser le contrôle de cohérence dans un emplacement intermédiaire unique.
Dans de nombreuses implémentations, les caches de niveau supérieur (plus éloignés du processeur) contiennent des copies des lignes présentes dans les niveaux plus proches du cœur . Grâce à cette organisation, le protocole de cohérence doit seulement garantir que le dernier niveau est synchronisé avec la mémoire principale et que les niveaux privés de chaque cœur sont synchronisés avec le niveau immédiatement supérieur.
On peut se représenter cela comme une sorte de poupée russe : le cache de troisième niveau contient le contenu des deuxième et premier niveaux , le deuxième niveau contient son propre contenu ainsi que celui du premier niveau, et le premier niveau ne connaît que ses propres lignes. Ainsi, en contrôlant la « grande poupée » (le dernier niveau), le système peut coordonner les autres de manière plus efficace.
Il en résulte que le maintien de la cohérence devient plus économique en termes de conception et de trafic mémoire . Au lieu de contraindre chaque cœur à interagir constamment avec la RAM, le protocole opère sur le cache partagé et gère à partir de là les lignes à mettre à jour ou à invalider dans les caches privés.
Méthodes de mise à jour : invalidation et mise à jour des copies
Un problème critique se pose lorsque deux cœurs ou plus souhaitent accéder, de manière quasi simultanée, à la même ligne de données répliquée sur plusieurs caches . Dans ce contexte, les systèmes de cohérence utilisent généralement deux stratégies fondamentales pour la gestion des écritures.
La première méthode repose sur l'invalidation. Lorsqu'un noyau doit écrire dans une ligne de cache spécifique, le protocole invalide toutes les copies de cette même ligne présentes dans les autres caches . Seul le noyau qui va écrire conserve la ligne en état de lecture et d'écriture ; les autres, s'ils souhaitent réutiliser ces données, devront recharger la ligne depuis un niveau supérieur (ou depuis la mémoire) avec la version mise à jour.
La seconde stratégie consiste à effectuer une mise à jour. Dans ce cas, lorsqu'un noyau modifie une ligne, le système tente de propager automatiquement le nouveau contenu aux copies existantes dans les autres caches . Ainsi, tous les caches ayant stocké cette ligne reçoivent la version mise à jour sans qu'il soit nécessaire de les invalider et de les recharger ultérieurement.
Chaque approche présente des avantages et des inconvénients. L'invalidation est généralement plus efficace lorsque les écritures sont fréquentes, car elle évite de saturer le système de mémoire avec des mises à jour dont d'autres cœurs n'ont pas forcément besoin immédiatement. À l'inverse, la mise à jour peut s'avérer avantageuse lorsque de nombreux cœurs lisent fréquemment les mêmes données, lesquelles sont modifiées relativement rarement , car elle réduit la latence en évitant de recharger la ligne après chaque invalidation.
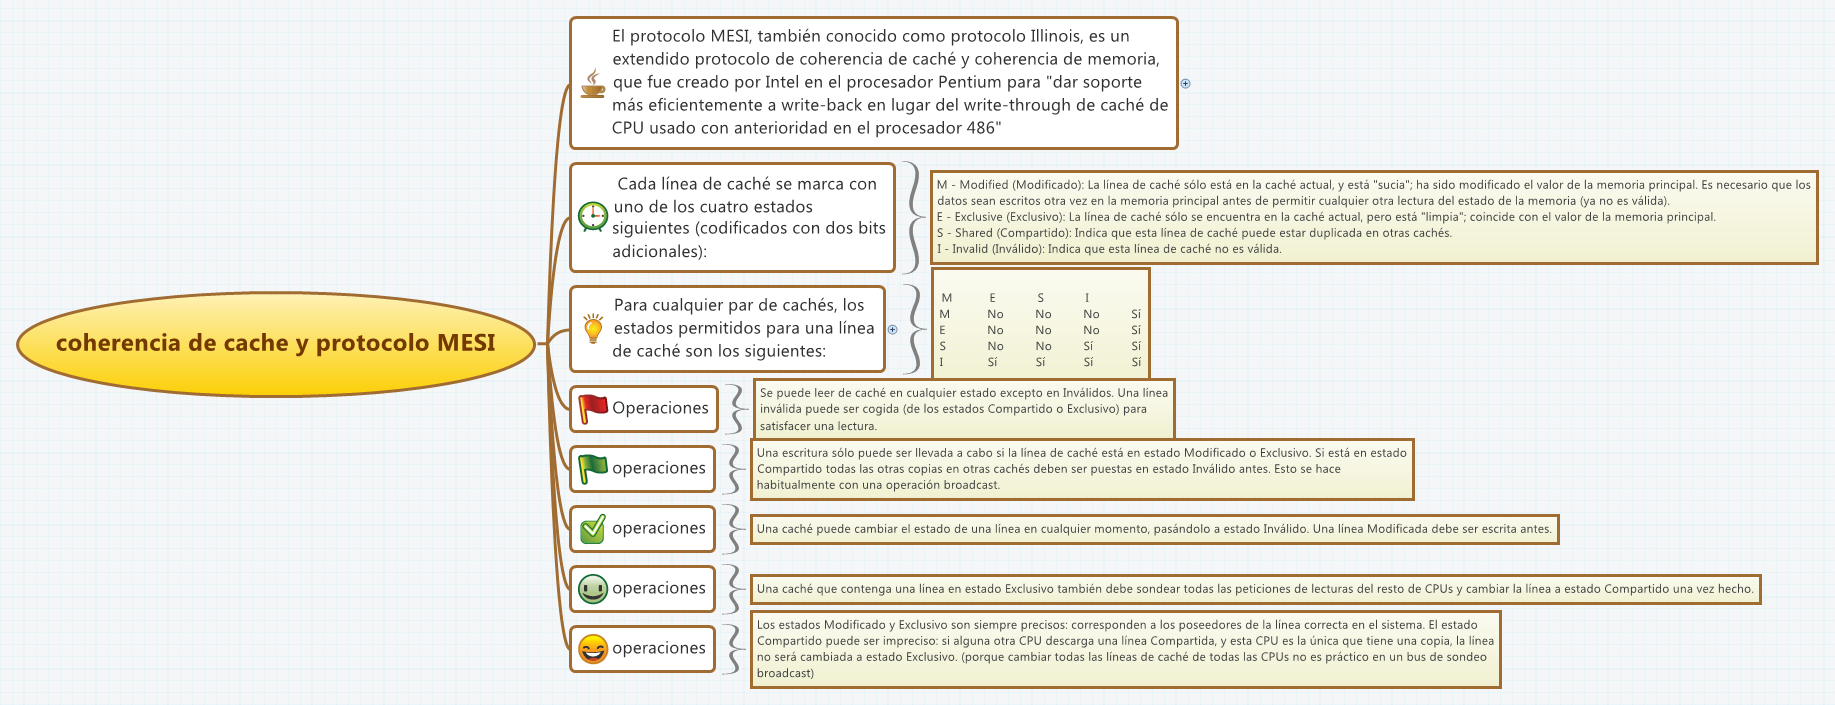
Dans les deux cas, les deux méthodes utilisent des états et des bits de contrôle supplémentaires dans les lignes de cache. Chaque ligne contient généralement des informations indiquant si son contenu correspond à celui de la RAM , et si elle est partagée, modifiée, exclusive, réservée, etc., selon le protocole spécifique (MESI, MOESI, MSI, etc.). Cela permet au matériel de décider rapidement de la marche à suivre lorsqu'une opération de lecture ou d'écriture a lieu sur une ligne déjà répliquée.
Vérification de la cohérence entre les caches et la mémoire
Vérifier directement la cohérence entre tous les niveaux de cache d'un processeur ou d'un GPU et la mémoire principale serait une tâche colossale, tant en termes de complexité de conception que de coût en performances. C'est pourquoi les systèmes modernes organisent cette vérification de manière hiérarchique.
Les caches les plus proches du processeur (L1, L2) ne sont généralement pas connectés directement à la RAM, mais au niveau de cache immédiatement supérieur. Ainsi, la cohérence n'est pas vérifiée par rapport à la mémoire principale à chaque niveau, mais par rapport au niveau immédiatement supérieur . Cela réduit le nombre d'accès à la RAM et simplifie la logique requise aux niveaux inférieurs.
En définitive, la comparaison entre le contenu du cache et celui de la RAM s'effectue entre le cache de dernier niveau et la mémoire principale . Si ce dernier niveau conserve un état correct et cohérent, et si chaque niveau inférieur maintient sa cohérence avec le niveau supérieur, l'ensemble de la hiérarchie reste cohérent sans qu'il soit nécessaire de vérifier chaque ligne par rapport à la RAM de manière répétée.
Lorsqu'un noyau écrit dans une ligne de cache et modifie ses données, l'état de cette ligne est marqué pour indiquer qu'elle ne correspond plus exactement à la copie stockée en mémoire . Le protocole coordonne alors la mise à jour : il marque les copies correspondantes dans les autres caches comme réservées ou invalides et, le cas échéant, écrit le nouveau contenu dans la ligne de mémoire principale associée.
Cette organisation en cascade permet aux modifications de se propager progressivement du noyau, qui met à jour les données, à la mémoire principale, en passant par chaque niveau de cache de manière contrôlée. Ainsi, le maintien de la cohérence ne constitue pas un goulot d'étranglement insurmontable pour le processeur.
Cohérence matérielle versus cohérence logicielle
Jusqu'à présent, nous avons abordé les mécanismes de cohérence principalement implémentés au niveau matériel : protocoles, bits d'état, caches partagés, etc. Cependant, il existe une autre approche qui vise à transférer une partie de cette complexité au logiciel , et plus précisément au compilateur et au système d'exploitation.
Les mécanismes de cohérence logicielle visent à réduire le besoin de logique embarquée supplémentaire en analysant le code et en prenant des décisions lors de la compilation . L'idée est que si le compilateur peut déduire quand et comment certaines données partagées sont consultées, il peut, dans de nombreux cas, empêcher la mise en cache de ces données ou gérer explicitement leur visibilité.
Cette approche présente un avantage indéniable : une partie de la charge de travail passe de la résolution à l’exécution à la résolution à la compilation . Au lieu que le matériel détecte et gère tous les conflits à la volée, le compilateur tente de les anticiper et de générer un code qui évite les situations dangereuses.
L'inconvénient est que l'analyse statique du code est limitée, et par conséquent, les compilateurs ont tendance à être conservateurs . Cela signifie que, pour éviter les violations de cohérence, ils prennent souvent des décisions qui réduisent l'efficacité des caches. S'ils soupçonnent que certaines données pourraient poser problème, ils empêchent fréquemment leur mise en cache ou imposent des synchronisations plus fréquentes que nécessaire.
Par conséquent, bien que ces schémas logiciels soient attrayants en théorie, notamment pour simplifier la conception matérielle, en pratique ils ne remplacent pas le support de cohérence intégré au processeur lui-même , mais le complètent plutôt dans certains scénarios spécifiques.
Le rôle du compilateur dans la cohérence du cache
Un élément clé des approches de cohérence logicielle réside dans le rôle du compilateur. Ce dernier peut analyser en profondeur le code et identifier les structures de données partagées potentiellement dangereuses pour la mise en cache . En fonction de cette identification, il marque ces éléments de manière spécifique ou adapte la génération de code.
L'approche la plus simple, et aussi la plus prudente, consiste à empêcher la mise en cache des variables de données partagées . Autrement dit, chaque accès à ces variables implique un accès à la mémoire principale ou à une zone non cachable. Ceci garantit la cohérence, mais représente une perte de performances considérable, car une structure partagée peut être utilisée de manière privée à certains moments, ou en lecture seule à d'autres.
En réalité, le problème de cohérence ne se pose que pendant les intervalles où au moins un processus peut écrire dans la variable et un autre processus peut la lire . En dehors de ces périodes critiques, la variable peut être considérée comme étant réservée à l'usage exclusif d'un seul thread, voire comme une constante de fait pendant un certain temps, ce qui permet de la mettre en cache sans problème.
Les stratégies de compilation les plus avancées visent à identifier les périodes « sûres » durant lesquelles la variable partagée ne présente aucun conflit . Pour ce faire, le compilateur analyse les chemins d'exécution, les accès concurrents potentiels et les schémas de synchronisation (verrous, sections critiques, etc.). À partir de cette analyse, il divise la durée de vie de la variable en phases : certaines adaptées à la mise en cache, d'autres nécessitant un traitement particulier.
Lors des périodes critiques, lorsqu'un accès concurrent avec écriture est détecté, le compilateur insère des instructions supplémentaires dans le code généré afin de garantir la cohérence du cache . Ces instructions peuvent forcer le vidage du cache, le rechargement de la mémoire, la mise en place de barrières mémoire ou l'accès à des zones marquées comme non cachables, selon le modèle de programmation et l'architecture sous-jacente.
Relation entre le compilateur, le système d'exploitation et le matériel
L'expression « le compilateur insère des instructions dans le code généré pour garantir la cohérence du cache » pourrait laisser penser que le système d'exploitation interprète ces instructions comme des indications de haut niveau et décide, sur cette base, de l'exécution du programme. En réalité, le mécanisme est quelque peu différent.
Lorsque le compilateur ajoute ces types d'instructions, il introduit dans le binaire des opérations spécifiques prises en charge par l'architecture ou l'environnement d'exécution . Par exemple, il peut insérer des instructions de vidage du cache, des barrières mémoire, des instructions spéciales pour marquer des régions comme non mises en cache, ou des appels aux services du système d'exploitation qui configurent les attributs de mémoire.
Le système d'exploitation n'interprète pas ces instructions comme des « commentaires » ou des « indications » de haut niveau rédigés par le compilateur ; il exécute simplement le code machine comme n'importe quel autre . Cependant, certaines de ces instructions sont conçues pour interagir avec le sous-système de mémoire et la gestion du cache, modifiant ainsi la façon dont le processeur accède à certaines données.
Autrement dit, le compilateur effectue une analyse préliminaire et génère du code qui, une fois exécuté, produit le comportement de cache souhaité . Le système d'exploitation collabore en définissant les attributs de mémoire (zones pouvant être mises en cache ou non, politiques d'écriture, etc.) et en fournissant des primitives de synchronisation, mais il ne « lit » pas les instructions spéciales au sens où il les interprète sémantiquement comme le ferait un compilateur.
Il peut également arriver que le matériel, à la réception de certaines instructions, active des mécanismes de cohérence ou de synchronisation spécifiques . Par exemple, les instructions de barrière garantissent l'ordre d'accès à la mémoire et imposent certains effets de visibilité au sein de la hiérarchie du cache. Dans ce cas, une collaboration tripartite s'opère : le compilateur détermine l'emplacement de ces instructions, le système d'exploitation configure l'environnement d'exécution et le matériel implémente le comportement effectif au niveau du cache et du bus mémoire.
Ensemble, ces éléments garantissent que, même avec de multiples copies des mêmes données réparties entre différents caches et la mémoire principale, les programmes parallèles s'exécutent avec un modèle de mémoire cohérent . La cohérence du cache, loin d'être un simple détail interne du processeur, devient un élément central pour le fonctionnement fiable et efficace des systèmes multicœurs.
Comprendre comment la hiérarchie du cache, les protocoles de cohérence matérielle et les techniques de support logiciel se combinent permet de mieux comprendre pourquoi les conceptions de processeurs modernes partagent une structure si similaire, et pourquoi une petite défaillance dans l'un de ces mécanismes peut déclencher un comportement chaotique dans les applications concurrentes qui dépendent entièrement du fait que tous les cœurs voient les mêmes données au bon moment.