- Différences architecturales entre le CPU et le GPU permettant le calcul massivement parallèle.
- Stratégies de déploiement cloud utilisant des modèles de provisionnement standard, spot et flexible.
- Critères techniques critiques pour la sélection du matériel en fonction de la VRAM, de la bande passante et de la latence.
- Systèmes de programmation avancée et d'orchestration globale pour optimiser l'utilisation des clusters d'IA.

Lorsqu'on évoque la puissance brute nécessaire au traitement de masses de données, il est impossible de passer sous silence le rôle fondamental des processeurs graphiques (GPU). Conçus initialement pour sublimer les graphismes des jeux vidéo, ils constituent aujourd'hui le moteur principal de l'intelligence artificielle et de l'analyse massive de données, permettant d'accomplir en quelques heures des tâches qui prenaient auparavant des semaines.
Le passage au cloud a révolutionné le travail des développeurs et des data scientists. Plus besoin d'investir des sommes astronomiques dans du matériel rapidement obsolète : nous pouvons désormais louer une puissance de calcul adaptée à nos besoins réels, moduler les ressources en fonction du projet et optimiser chaque centime investi dans l'infrastructure.

Processeur vs carte graphique : quelle est la véritable différence ?
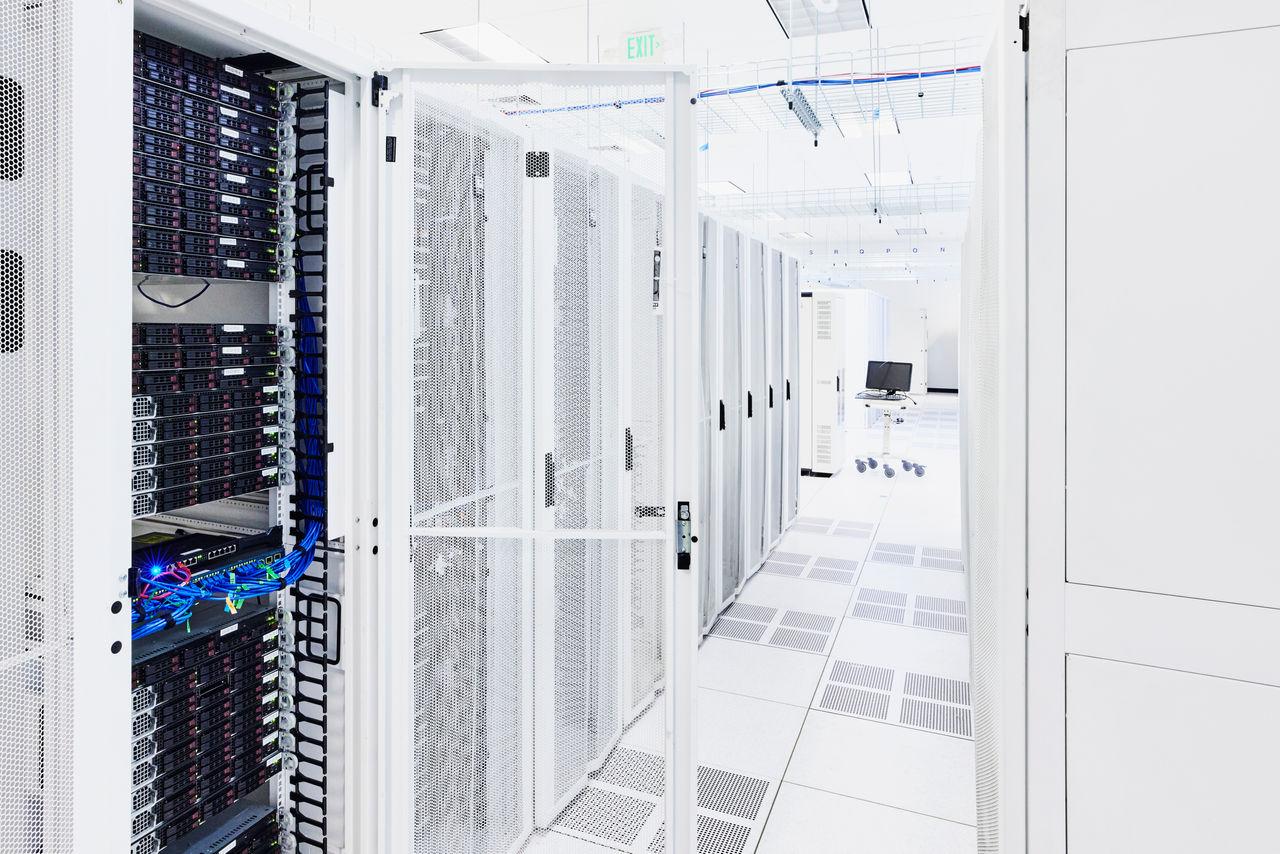
En résumé, le processeur (CPU) est comparable à un chef d'orchestre extrêmement intelligent, capable de tout faire, mais qui traite les tâches les unes après les autres. À l'inverse, le processeur graphique (GPU) est comme une armée de milliers d'ordinateurs spécialisés dans l'exécution simultanée et répétée de la même opération mathématique. C'est le principe du calcul parallèle.
Tandis que le processeur gère la logique complexe et le contrôle du système, le processeur graphique excelle dans le traitement matriciel et le rendu d'images. Grâce à ses centaines, voire ses milliers de cœurs , comparables à une architecture multicœur mais à une échelle bien plus importante, il peut exécuter simultanément de multiples sous-ensembles d'une tâche — un atout essentiel pour l'entraînement des réseaux neuronaux ou le traitement de téraoctets de données sans plantage du système.
Gestion des tâches par lots et en temps réel
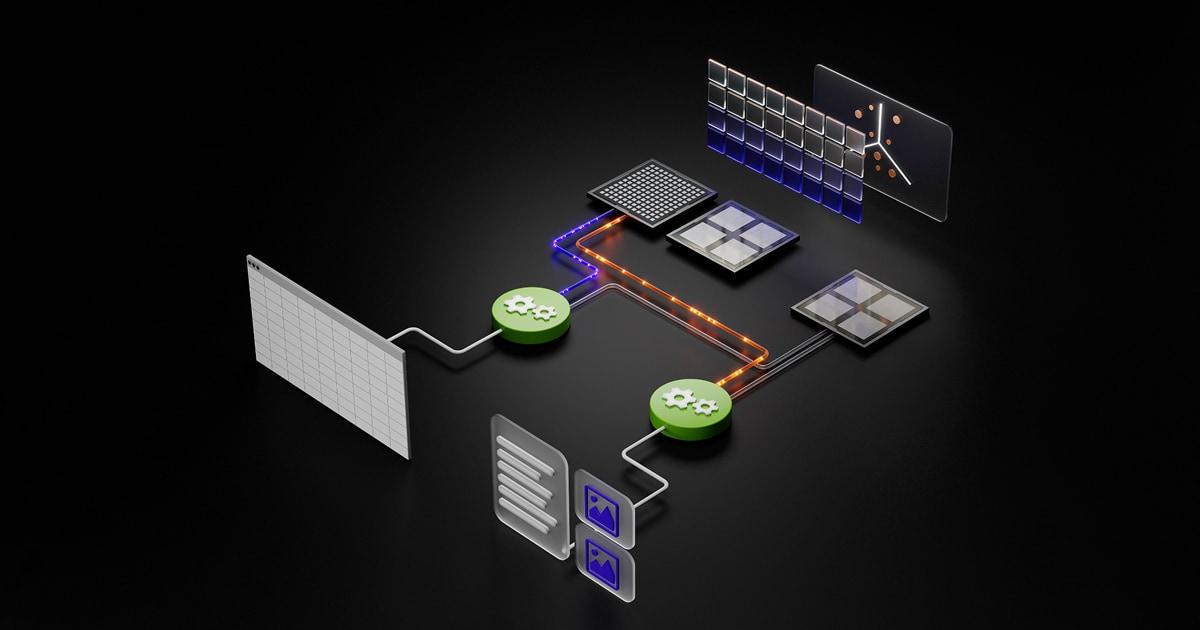
Dans l'écosystème du cloud, deux méthodes principales permettent d'effectuer ces tâches. Le traitement par lots est idéal pour les travaux ne nécessitant pas de réponse immédiate, comme le prétraitement des données ou l'inférence massive. L'objectif est alors d'optimiser l'efficacité et les performances globales du système en permettant aux tâches de s'accumuler et de s'exécuter lorsque des ressources sont disponibles.
En revanche, le traitement en temps réel est essentiel pour les applications qui doivent répondre instantanément, comme les chatbots d'IA générative ou la reconnaissance faciale. Dans ces cas, la priorité absolue est la faible latence et la haute disponibilité, afin que l'utilisateur final ne perçoive aucun délai pendant le traitement des informations par le modèle.
Pour mener à bien un projet de ce type, il est essentiel de bien définir les besoins. Du choix de la machine adéquate à l'installation des pilotes (automatique ou manuelle à l'aide d'images personnalisées), chaque étape détermine le bon déroulement du projet ou s'il s'agit d'un véritable casse-tête technique.
Modèles de consommation et optimisation des coûts
Toutes les machines virtuelles ne se valent pas, et leur coût varie également. Pour ceux qui cherchent à faire des économies, les machines virtuelles Spot constituent une option intéressante, offrant des remises importantes, malgré le risque qu'elles soient récupérées par le cloud à tout moment. Elles sont idéales pour les tâches critiques où le coût est primordial.
Si vous avez besoin d'une solution plus stable à moindre coût, des machines virtuelles de démarrage flexibles sont disponibles. Elles permettent d'accéder aux ressources GPU à prix réduit, moyennant un délai de quelques jours avant le démarrage. Pour les projets critiques, vous pouvez opter pour le provisionnement à la demande standard ou les réservations planifiées , qui garantissent la disponibilité du matériel au moment précis où vous en avez besoin.

Une technique avancée pour optimiser le budget est l'arbitrage des coûts régionaux . En tirant parti des variations de prix selon les zones géographiques ou en utilisant une planification « follow the sun », les équipes d'Asie, d'Europe et des Amériques peuvent utiliser les clusters à tour de rôle, atteignant ainsi un taux d'utilisation du matériel proche de 100 %.
Comment choisir le bon GPU pour votre cas d'utilisation

Il ne s'agit pas de choisir la carte la plus chère, mais celle qui convient le mieux à la tâche. Lors de l'entraînement de grands modèles de langage (LLM) , la mémoire vidéo (VRAM) constitue le principal goulot d'étranglement. Si la VRAM vient à manquer, il faudra réduire la taille des lots, ce qui augmentera considérablement les temps d'exécution et les coûts globaux.
- Entrenamiento de IA: Il nécessite une puissance élevée en précision mixte (FP16/BF16) et une VRAM généreuse pour gérer les gradients et les états de l'optimiseur.
- Inférence en temps réel : Ici, la latence du réseau et la stabilité de la pile logicielle sont essentielles pour éviter les interruptions de production.
- Science des données : On recherche un équilibre entre le processeur, la RAM et le GPU, car une grande partie du nettoyage des données reste une tâche séquentielle.
- Rendu 3D et effets visuels : Ils dépendent crucialement de la bande passante mémoire pour déplacer rapidement des textures et des géométries complexes.
- Calculs scientifiques : Ils privilégient la précision FP32 ou FP64 et la reproductibilité exacte des résultats grâce à des versions de pilotes fixes.
Il est essentiel de surveiller le flux de données du système . Disposer d'un GPU ultra-puissant est inutile si le CPU ou le stockage est lent ; dans ce cas, le GPU passera la majeure partie de son temps inactif, en attente de données, ce qui est appelé sous-utilisation des ressources.
Orchestration avancée et avenir de l'informatique
À mesure que les clusters se développent, la simple planification « premier arrivé, premier servi » devient obsolète. Les entreprises leaders mettent en œuvre des hiérarchies de planification multiniveaux qui répartissent les tâches en fonction de l'emplacement des données, des priorités métier et de l'empreinte carbone de la région.

Des innovations telles que la commutation CPU/GPU en temps réel permettent au système de déterminer instantanément le processeur le plus performant pour chaque thread. Ceci pallie la pénurie mondiale de matériel en optimisant chaque cycle d'horloge disponible, permettant ainsi à l'IA générative et aux jumeaux numériques de progresser sans être freinés par un manque de puces.
L'utilisation de Kubernetes avec l'allocation dynamique des ressources (DRA) et la technologie GPU multi-instance (MIG) permet de diviser une seule carte graphique physique en plusieurs instances virtuelles. Ceci démocratise l'accès au calcul haute performance, permettant à plusieurs utilisateurs de partager le même GPU sans interférence.
Disposer d'une stratégie claire, alliant matériel adapté, modèle de paiement intelligent et orchestration flexible, est indispensable pour éviter les gaspillages dans le cloud computing. Du choix de la VRAM au déploiement des instances Spot, chaque décision technique influe directement sur la rapidité d'innovation et la rentabilité de tout projet de calcul avancé.
