- L'optimisation multiplateforme combine une architecture native du cloud, un stockage évolutif et des protocoles modernes pour garantir une faible latence.
- Des stratégies de mise en cache, des files d'attente de tâches et des bases de données bien optimisées permettent de maintenir les performances à mesure que l'application évolue vers des millions d'utilisateurs.
- Des frameworks comme Flutter ou React Native, associés à une bonne gestion de la mémoire, du GPU et des ressources, permettent des expériences quasi natives.
- L'IA permet une allocation prédictive des ressources, une sécurité avancée et une personnalisation, éléments clés pour être compétitif dans des environnements mobiles et web exigeants.
L'optimisation des performances sur plusieurs plateformes est devenue un sujet incontournable du développement logiciel moderne. Les utilisateurs comparent tout à l'expérience quasi instantanée de l'IA, exigent des temps de réponse inférieurs à la seconde et souhaitent une fluidité identique sur un smartphone d'entrée de gamme, un iPhone Pro, une tablette Android ou le navigateur web de leur ordinateur portable professionnel.
Dans ce contexte, « faire fonctionner » ne suffit plus ; la performance a un impact direct sur la fidélisation, la conversion et la réputation de la marque . Des entreprises spécialisées comme Q2BSTUDIO ou ITERAM aux plateformes low-code comme Adalo, en passant par les équipes travaillant avec Flutter, React Native ou des solutions web, l’accent est passé du développement rapide au développement rapide et de qualité, grâce à des architectures évolutives, une surveillance continue et une intelligence artificielle de plus en plus performante qui accompagne chaque étape du cycle de vie.
Performance multiplateforme : contexte, défis et indicateurs clés
Le premier changement de mentalité consiste à comprendre que l'optimisation des performances multiplateformes est un travail continu , et non une simple mise au point finale avant la publication sur la boutique d'applications. Chaque système d'exploitation, navigateur et type d'appareil impose ses propres règles, et pourtant l'utilisateur s'attend à ce que l'application offre une expérience utilisateur optimale sur tous les environnements.
Du point de vue de l'ingénierie des performances, des indicateurs tels que le temps d'interaction (TTI), la durée des sessions sans plantage et le temps de rendu des images sont primordiaux. Un objectif raisonnable et très ambitieux aujourd'hui est de maintenir le TTI en dessous de 500 ms sur 95 % des appareils, tout en visant une durée de session sans plantage de 99,99 %, même avec une gamme de matériel incluant des objets connectés, des smartphones d'entrée de gamme, des tablettes et des ordinateurs de bureau.
Sur iOS, les priorités sont les animations à 60 images par seconde, la fluidité des gestes tactiles et une gestion efficace de la mémoire . Sur Android, outre les performances brutes, l'accent est mis sur l'autonomie, la variété des tailles d'écran et la compatibilité avec différents matériels. Sur le web, les clés du succès des applications web résident dans la rapidité de chargement, la compatibilité multi-navigateurs et des performances acceptables même sur les réseaux à faible débit.
Tout cela soulève une question délicate mais essentielle : comment garantir des performances équivalentes sur toutes les plateformes sans faire exploser les coûts de développement ? C’est là qu’interviennent les frameworks multiplateformes, les architectures cloud-native, l’optimisation des ressources, les stratégies de mise en cache et l’utilisation intelligente de l’IA.
Stratégie principale : architecture, stockage et réseau
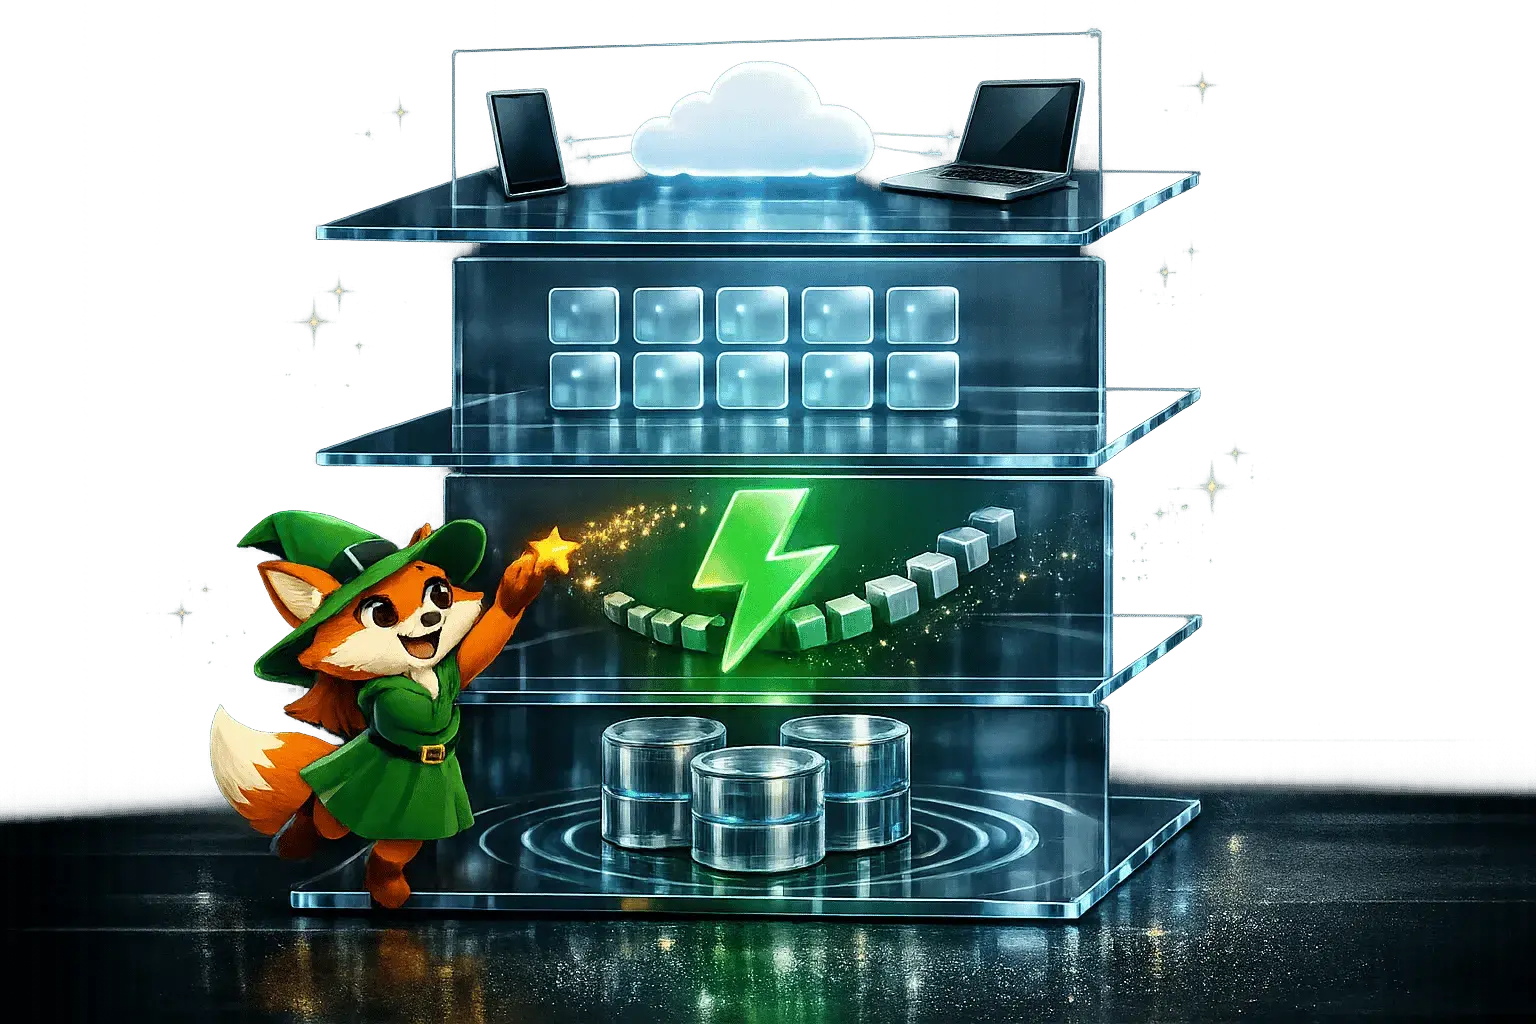
Pour qu'une application multiplateforme puisse gérer des centaines, voire des millions d'utilisateurs, l'architecture des données et du réseau est tout aussi importante que le code de l'interface . Se contenter d'« utiliser le cloud » ne suffit pas ; il faut concevoir l'emplacement de stockage des données, leur mode de transit et les données mises en cache sur chaque appareil.
Une combinaison très courante consiste à utiliser le stockage cloud comme infrastructure principale , avec des bases de données gérées, et à s'appuyer sur un stockage local haute performance sur chaque appareil. Ceci permet d'équilibrer une capacité quasi illimitée côté serveur avec un accès ultra-rapide aux données critiques côté client, garantissant ainsi l'utilisation de l'application même en cas de connexion limitée.
À mesure que l'application se développe, une architecture de microservices avec un modèle « base de données par service » devient essentielle . Cela permet de choisir la technologie de stockage optimale pour chaque module : relationnelle pour les paiements, objet pour l'analyse, clé-valeur pour les sessions ou cache de configuration. Elle facilite également la mise à l'échelle sélective des ressources qui en ont réellement besoin, sans impacter le reste du système.
Parallèlement, l' infrastructure élastique (disques et bases de données permettant un réglage indépendant des IOPS, du débit et de la capacité) permet de répondre aux pics de trafic sans surdimensionnement permanent. La combinaison de la mise à l'échelle horizontale, du stockage élastique et de la distribution géographique des données est essentielle pour maintenir une faible latence depuis n'importe quelle région.
Enfin, la couche réseau évolue vers des protocoles modernes : HTTP/3, QUIC et WebTransport permettent des flux unidirectionnels, une livraison hors séquence et des performances améliorées dans les environnements à télémétrie étendue et synchronisation en temps réel. La migration des flux ou canaux de données critiques vers ces technologies se traduit généralement par une réduction significative de la latence perçue.
Optimisation intelligente des ressources : IA, binaire et cryptographie
Dans les appareils modernes, le processeur n'est plus le seul facteur limitant ; la batterie, la température, la mémoire et la qualité du réseau influent également sur l'expérience utilisateur . C'est là que l'IA prend une place prépondérante, grâce à des modèles légers exécutés directement sur l'appareil.
Une approche avancée consiste à allouer les ressources de manière prédictive à l'aide de modèles d'apprentissage automatique embarqués . Ces modèles reçoivent des signaux tels que le type d'appareil, la version du système d'exploitation, la mémoire vive disponible, la température de la batterie, les habitudes d'utilisation et la qualité de la connexion, et ajustent dynamiquement les paramètres de l'application, comme la compression vidéo, la complexité du rendu, la taille du cache de l'interface utilisateur et la fréquence de synchronisation.
De plus, le problème classique de la « surcharge » des frameworks multiplateformes doit être résolu. L’association d’ une élimination agressive du code mort et du chargement dynamique des modules permet d’obtenir des binaires plus petits et d’améliorer les démarrages à froid : seules les fonctionnalités essentielles sont chargées initialement, les fonctionnalités lourdes étant ajoutées à la demande, lorsque l’utilisateur en a réellement besoin.
Un autre défi majeur réside dans la surcharge cryptographique liée à l'ère post-quantique . Des algorithmes comme CRYSTALS-Kyber augmentent la taille des clés et le coût de l'établissement de la liaison, ce qui est perceptible sur les appareils de milieu de gamme. Les stratégies hybrides, combinant cryptographie classique pour la rapidité et PQC pour la protection des clés, ainsi que l'exécution hors thread de l'échange de clés, contribuent à maintenir la sécurité sans compromettre le TTI (Time-To-Impact Factor).
Tout cela nécessite une vision plus large de la performance : il ne s'agit pas seulement de gagner quelques millisecondes, mais de concevoir des systèmes adaptatifs qui réagissent avant même que l'utilisateur ne remarque la dégradation.
Mise en cache, files d'attente et bases de données : accélérer le flux de données
Une fois l'infrastructure de stockage bien conçue, l'étape suivante consiste à mettre en place des stratégies de mise en cache et des systèmes de file d'attente , qui permettent réellement de soulager les bases de données et d'assurer le bon fonctionnement de l'interface utilisateur.
La mise en cache en mémoire (par exemple avec Redis) offre des temps de réponse inférieurs à la milliseconde et peut gérer des centaines de milliers, voire des millions de requêtes par seconde. Concrètement, cela signifie que les données fréquemment consultées (profils, configurations, listes populaires, etc.) sont servies sans accéder au disque, ce qui réduit les coûts et les temps de réponse.
Dans les applications mobiles et les PWA, la combinaison de la mise en cache distante et de la mise en cache locale spécifique à l'appareil fait toute la différence. Les Service Workers et l'API Cache permettent d'enregistrer le HTML, le CSS et le JavaScript pour un chargement quasi instantané et un mode hors ligne basique. Sur mobile, les bases de données locales comme SQLite ou Realm servent de couche d'état avec des TTL agressifs qui transforment un démarrage lent en une reprise quasi instantanée.
Les systèmes de gestion de files d'attente (RabbitMQ, SQS, solutions cloud, etc.) prennent en charge toutes les opérations non critiques pour l'interaction immédiate : génération de rapports volumineux, calculs complexes, intégration de services tiers ou traitement de fichiers volumineux. Une pratique courante consiste à stocker les fichiers dans un stockage blob, à renvoyer une URL pré-signée par redirection et à gérer le téléchargement en dehors de la couche applicative principale.
Côté base de données, les optimisations classiques restent essentielles : un indexage et un pool de connexions appropriés peuvent réduire les temps de requête de plus de 70 % et améliorer la latence des transactions dans des proportions similaires. Dans des systèmes comme Firebase Realtime Database, des structures de données plates, des écouteurs bien placés et des requêtes basées sur les clés plutôt que sur les champs enfants améliorent considérablement les performances.
Développement front-end multiplateforme : frameworks, interface utilisateur et animations
L'utilisateur ne voit que l'interface, c'est pourquoi une architecture front-end bien conçue est tout aussi importante qu'un back-end performant . C'est là qu'interviennent React Native, Flutter, .NET MAUI, WebAssembly et les applications web progressives, entre autres, et même des frameworks comme Lazarus.
React Native peut atteindre des performances quasi natives en gérant correctement le pont avec JavaScript natif , en minimisant les interfonctionnalités inutiles et en déléguant les tâches lourdes aux modules natifs. L'optimisation des composants, l'utilisation de listes virtualisées et une gestion efficace de l'état font toute la différence entre une application lente et une application fluide.
Flutter se situe dans une catégorie à part en termes de performances d'interface, car compile le code Dart en code natif et dessine directement sur le canevas.Dart 3 apporte des améliorations au niveau du typage, de la gestion des valeurs nulles et de la compilation AOT, ce qui réduit la surcharge et améliore les temps de démarrage, tout en permettant une utilisation intensive de const et les objets immuables minimisent les reconstructions inutiles des widgets.
Impeller, le nouveau moteur de rendu de Flutter, est conçu pour garantir des pipelines de rendu plus prévisibles, moins de saccades et une meilleure utilisation du GPU , notamment sur les appareils aux ressources graphiques limitées. Il en résulte des animations plus fluides et une consommation de ressources plus stable.
Au-delà de la structure, il existe des principes généraux : éviter le surdessin, séparer les éléments statiques en calques, privilégier les performances perçues et garantir l’accessibilité . Les interfaces utilisateur minimalistes, le chargement progressif du texte, les micro-interactions avec animations et le retour haptique qui masque les brefs temps d’attente améliorent bien plus la sensation de rapidité globale qu’une réduction de 20 ms de la latence d’un appel réseau.
Gestion de la mémoire, du GPU et des périphériques hétérogènes
Dans un écosystème où les iPhones dotés de 16 Go de RAM coexistent avec des appareils Android hautement optimisés à 3 Go, la gestion des ressources mémoire et graphiques est essentielle aux performances . Une erreur de calcul à ce niveau peut entraîner des plantages, des blocages du GPU et une décharge rapide de la batterie.
L'optimisation multiplateforme implique de comprendre comment chaque framework et plateforme gère l'allocation, le ramasse-miettes et les cycles de vie des objets . Des stratégies telles que le profilage périodique du tas, le suivi précis des objets conservés après des flux spécifiques et l'application de limites d'affichage permettent de détecter les fuites de mémoire qui ne sont pas immédiatement apparentes, mais qui peuvent se manifester par des pauses aléatoires après quelques semaines.
Le GPU est une autre ressource clé : le transfert de certains calculs (traitement d’image, filtres, transformations lourdes) vers des shaders de calcul utilisant Metal Compute sur iOS ou Vulkan sur Android permet de dédier le thread principal à l’interface utilisateur, en maintenant 60 images par seconde même lors d’opérations intensives.
Parallèlement, l'optimisation des ressources visuelles réduit la consommation de mémoire et améliore les temps de chargement. L'utilisation de formats modernes (WebP, AVIF), la génération automatique de plusieurs densités pour iOS (@1x, @2x, @3x) et Android (mdpi, hdpi, xhdpi, etc.), ainsi que l'adoption de graphismes vectoriels lorsque cela est approprié contribuent à garantir des applications légères et nettes sur tous les écrans.
Enfin, il faut tenir compte de l'énorme diversité du matériel. Les stratégies adaptatives qui ajustent la qualité des textures, la résolution vidéo ou la complexité des animations en fonction des capacités de l'appareil permettent d'offrir une expérience optimale sur les appareils haut de gamme sans pour autant condamner les autres utilisateurs à une application inutilisable.
Évolutivité réelle : cas d’utilisation et plateformes low-code
Lorsqu'on aborde la question du passage à l'échelle pour des millions d'utilisateurs, il est utile d'examiner les solutions déjà mises en œuvre. Slack, par exemple, a migré d'une infrastructure MySQL fragmentée vers Vitess , parvenant à gérer des millions de requêtes par seconde avec une latence de quelques millisecondes seulement et à résoudre les problèmes de surcharge des partitions. Ce type d'architecture, répliqué dans plusieurs régions, démontre que le système dorsal peut évoluer sans être saturé.
Côté interface utilisateur, Slack a travaillé sur la mise en cache et l'optimisation du démarrage, parvenant à réduire de plus de moitié les temps de démarrage et à améliorer significativement les démarrages à chaud . Une fois de plus, le message est clair : il ne s'agit pas d'un changement miraculeux isolé, mais d'une multitude de petites décisions bien ciblées.
Airbnb, de son côté, a relevé le défi de la synchronisation des données entre plusieurs plateformes grâce à une architecture décentralisée, où chaque client gère son propre état local et se coordonne via une couche centrale robuste. L'utilisation de registres structurés facilite l'évolution du système sans impacter les utilisateurs individuels.
À l'opposé, on trouve des plateformes comme Adalo, qui permettent aux équipes sans grande expertise en infrastructure de développer des applications web, iOS et Android à partir d'une base de code unique , grâce à un backend modulaire capable de traiter des dizaines de millions de requêtes quotidiennes avec une haute disponibilité. Leur modèle de tarification prévisible et leurs outils d'IA pour la génération d'écrans, de flux et de structures de données accélèrent considérablement la mise sur le marché.
L'important ici est de comprendre que, que vous développiez une solution personnalisée avec Q2BSTUDIO ou ITERAM ou que vous utilisiez du low-code, les meilleures pratiques en matière de performance, de sécurité et d'évolutivité restent les mêmes : caches, files d'attente, bases de données bien indexées, surveillance continue et une architecture qui permet la croissance sans avoir à tout refaire.
IA, sécurité et avenir du développement multiplateforme
À l'avenir, la frontière entre l'ingénierie des performances et l'intelligence artificielle s'estompera de plus en plus. L'IA ne se contente pas de générer du code ; elle décide comment et quand utiliser les ressources , détecte les anomalies, anticipe les pics de charge et propose des modifications de configuration en temps réel.
Les outils de génération de code comme GitHub Copilot ou les assistants conversationnels accélèrent le développement, mais le point vraiment intéressant réside dans les modèles qui s'exécutent au sein même de l'application ou en périphérie : ils allouent les ressources de manière prédictive, personnalisent l'expérience en fonction du comportement de l'utilisateur et ajustent dynamiquement la qualité du contenu en fonction du réseau ou de l'appareil.
En matière de sécurité, l'association du modèle Zero Trust, de l'authentification sans mot de passe (mots de passe, biométrie) et des systèmes de détection d'anomalies basés sur l'IA renforce les applications critiques telles que la banque, la santé et l'industrie. L'enjeu principal est d'intégrer la sécurité tout au long du cycle de vie grâce aux pratiques DevSecOps, à l'automatisation des tests et à la prévention des vulnérabilités liées au développement rapide.
En revanche, l'interconnexion avec l'Internet des objets (IoT) et l'informatique de périphérie (edge computing ) impose une optimisation poussée : traitement des données au plus près de la source, filtrage des données non pertinentes avant leur envoi vers le cloud et maintien d'une expérience utilisateur fluide même en cas de réseau instable. Des secteurs comme la logistique, la télémédecine et la domotique reposent déjà sur ce type d'architectures.
Le rôle du développeur lui-même évolue : les profils de développeurs multiplateformes, de spécialistes de la performance informatique, d’experts en automatisation des tests et d’architectes cloud-native sont de plus en plus recherchés. La formation actuelle combine développement natif et hybride, gestion de bases de données, sécurité, automatisation et, bien sûr, optimisation des performances de bout en bout.
L'ensemble de ce dispositif – architecture cloud-native, gestion des données, interface utilisateur multiplateforme, intelligence artificielle, sécurité et tests – converge vers un objectif unique : créer des applications rapides, fiables et offrant une expérience utilisateur homogène sur tous les appareils , tout en maîtrisant les coûts et en permettant une itération rapide. Concevoir dès le départ en tenant compte des performances, de l'évolutivité et de l'expérience utilisateur, c'est ce qui distingue les applications simplement fonctionnelles des produits qui deviennent des références sur leur marché.
