- A VibeVoice egy Microsoft TTS modell, amely képes hosszú, kifejező, több hangszórós hangot generálni, ideális podcastokhoz és hangoskönyvekhez.
- Architektúrája a beszédtokenizátorok, a nagyméretű nyelvi modell és a diffúzió ötvözete révén természetes hangokat biztosít akár 90 perces hangfelvételek esetén is.
- Enyhe eltérésekkel közel valós idejű válaszokat tesz lehetővé, de felelősségteljes használatot igényel a hangklónozás és a deepfake-ek kockázata miatt.
- Nyílt forráskódú kutatási keretrendszerként jelent meg, bár a Microsoft ideiglenesen korlátozta a tárházat a visszaélésekkel kapcsolatos aggodalmak miatt.

A Microsoft VibeVoice technológiájának megjelenése forradalmasítja a podcastok és a hosszú formátumú hanganyagok mesterséges intelligencia segítségével történő létrehozásának módját. Ez a nyílt forráskódú TTS (szövegfelolvasó) modell nemcsak hiperrealisztikus hangokat generál, hanem lehetővé teszi több beszélővel folytatott, akár 90 perces beszélgetések létrehozását is kínos vágások vagy minőségromlások nélkül.
A VibeVoice célja, hogy bárki számára biztosítson egy virtuális felvevőfülkét, amely képes professzionálisan podcastokat, hangoskönyveket vagy narrációkat készíteni számítógépről. Csupán egy szkriptre és némi alapvető technikai tudásra van szükséged a modell beállításához, a mesterséges intelligencia pedig gondoskodik a többiről: az intonációról, a természetességről, a hangváltozásokról és a folytonosságról a hanganyagban.
Mi a VibeVoice, és miért olyan fontos a podcastok számára?
A modell a TTS (Text-to-Speech) technológián alapul, ami azt jelenti, hogy közvetlenül beszéddé alakítja a szöveget , de olyan folyékonysággal és árnyaltsággal, amely nagyon hasonlít az emberi beszédhez. A VibeVoice kezdetben 1.5B és 7B paraméterekkel rendelkező verziókban jelent meg , amelyek célja a minőség és a hosszú hangfolyamok generálásának képessége közötti egyensúly megteremtése túlzott erőforrás-felhasználás nélkül.
Az egyik legnagyobb erőssége, hogy akár 90 percnyi hanganyagot is képes folyamatosan rögzíteni , miközben végig megőrzi a hangkonzisztenciát és az intonációt. Ez különösen hasznossá teszi teljes podcastok, hangoskönyv-fejezetek vagy hosszú oktatási tartalmú epizódok esetén, ahol korábban több felvételi ülésre volt szükség emberi hangszínészekkel.
Továbbá a VibeVoice úgy lett kialakítva, hogy akár négy különböző hangot is kezeljen egyetlen hangfelvételen belül , lehetővé téve a szimulált interjúkat, panelbeszélgetéseket, szereplők közötti párbeszédeket vagy különböző szinkronszínészek által narrált epizódokat. Ez a többbeszélős képesség kulcsfontosságú ahhoz, hogy a mesterséges intelligencia által vezérelt podcastok dinamikusabbak és lebilincselőbbek legyenek.
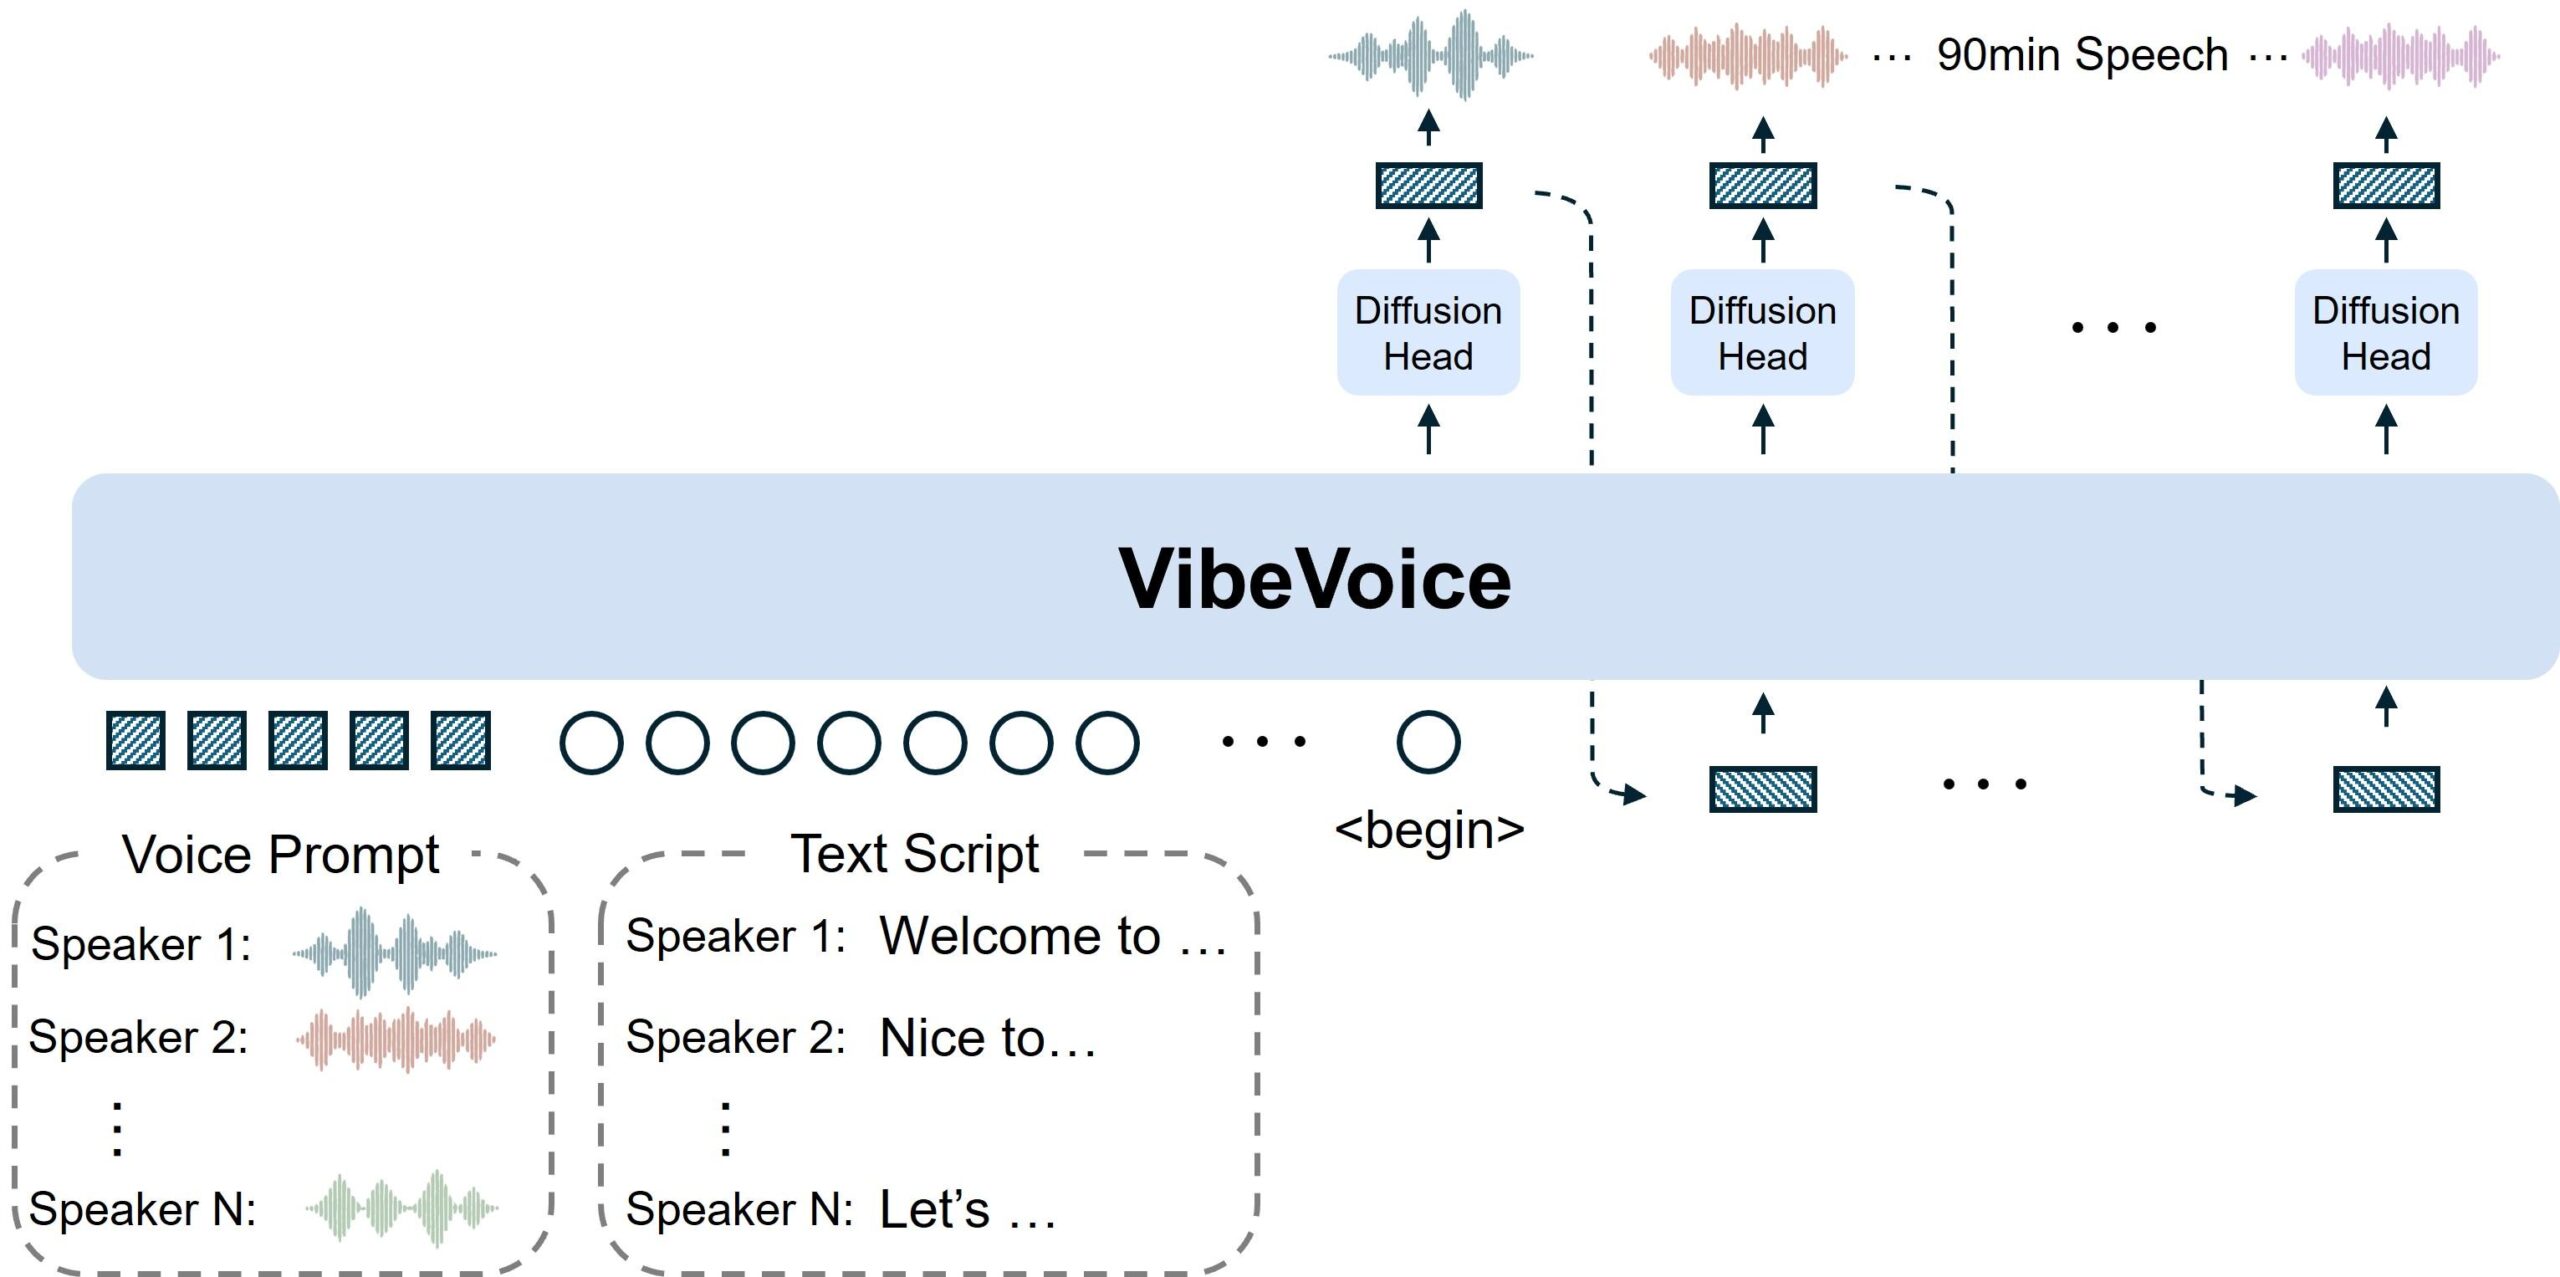
A VibeVoice működése: fejlett beszédszintézis és alacsony késleltetés
A figyelemfelkeltő címsoron túl a VibeVoice különlegességét a hosszú hangfelvételekhez és beszélgetésekhez tervezett technikai architektúrája adja . A Microsoft számos összetevőt kombinál, hogy a hang természetesnek hangozzon, alkalmazkodjon a szöveghez, és valós időben vagy ahhoz közel generálódjon.
A rendszer folyamatos akusztikus és szemantikus beszédtokenizátorokat használ , amelyek nagyon alacsony frekvencián, körülbelül 7,5 Hz-en működnek. Ez azt jelenti, hogy a hanginformációkat másodpercenként kevesebb „lépésre” sűríti, mint más modellek, megőrzi a hanghűséget, miközben jelentősen csökkenti a számítási költségeket hosszú sorozatok esetén.
Ezen a tömörített reprezentáción felül egy nagy nyelvi modell (LLM) is szerepet játszik, amely a szöveg tartalmának, a beszélgetés menetének és az adott pillanatban beszélő személy értelmezéséért felelős. Ily módon megérti, hogy kérdésről, válaszról, ironikus megjegyzésről vagy témaváltásról van-e szó, és ennek megfelelően alakítja a hangkimenetet.
Végül egy diffúziós fej segítségével kiváló minőségű akusztikai részleteket rekonstruálnak: hangszínt, vokális textúrát, finom lélegzetvételeket és egyéb árnyalatokat. Ez az LLM + diffúzió kombináció biztosítja, hogy a kapott hang konzisztens, kifejező és kellemes hallgatnivaló legyen hosszabb ideig.
Ezzel párhuzamosan a Microsoft piacra dobott egy speciális változatot, a VibeVoice-Realtime-0.5B-t , amelyet rendkívül gyors válaszidőkre terveztek: ez a modell körülbelül 300 milliszekundum múlva képes hangot kibocsátani a szöveg vétele után. Ez gyakorlatilag valós időben ideális hangügynököknek, beszélgetős asszisztenseknek vagy olyan alkalmazásoknak, ahol a késleltetésnek minimálisnak kell lennie.
Elérhető verziók: modellek, paraméterek és ajánlott felhasználási módok
A VibeVoice ökoszisztémán belül számos verzió jelent meg, különböző modellméretekkel és orientációkkal , amelyeket hosszú hanganyagokhoz és interaktív alkalmazásokhoz egyaránt terveztek.
Egyrészt a főbb változatok 1.5B és 7B paraméterekkel rendelkeznek , amelyek kiterjedt tartalmak, például teljes podcastok, szimulált rádióműsorok, hangoskönyv-fejezetek vagy hangos kurzusok kezelésére szolgálnak. A nagyobb számú paraméter nagyobb kapacitást tesz lehetővé az árnyalatok rögzítésére és az összetett párbeszédek kezelésére, bár egyben növeli a hardverigényt is.
Másrészt a VibeVoice-Realtime-0.5B verzió a válaszidőt helyezi előtérbe a modell méretével szemben. Bár „csak” 0,5 milliárd paraméterrel rendelkezik – ami szerény mennyiség az olyan óriásokhoz képest, mint a ChatGPT vagy a Gemini –, pontosan ez teszi lehetővé, hogy akár 90 perc folyamatos hangot generáljon, miközben tiszta hangot és stabil intonációt biztosít.
Ez a valós idejű változat különösen vonzó a hangalapú ügynökök, chatbotok, virtuális asszisztensek és minden olyan alkalmazás számára, ahol a felhasználó elvárja a mesterséges intelligenciától, hogy azonnal hanggal, ne pedig csak szöveggel válaszoljon. A közel 300 ms-os késleltetéssel az élmény nagyon hasonló ahhoz, mintha a vonal másik végén beszélgetnénk valakivel.
A modell minden esetben helyi vagy kutatási környezetben való használatra készült , mivel a Microsoft kezdetben úgy döntött, hogy nyílt forráskódú projektként adja ki, amely elérhető a GitHubról és olyan platformokról, mint a Hugging Face, így a közösség könnyen tesztelheti, adaptálhatja és eszközöket építhet rá.
Gyakorlati alkalmazások: hogyan készítsünk podcastot a VibeVoice segítségével
A VibeVoice egyik zászlóshajó alkalmazása kétségtelenül a podcastok létrehozása emberi hangszínészek nélkül . Bárki számára, akinek vannak ötletei, forgatókönyvei vagy írott tartalmai, de nem mer mikrofon elé állni, ez a modell hatalmas lehetőséget nyit meg.
A VibeVoice-szal történő podcastkészítés általános munkafolyamata jellemzően egy jól strukturált forgatókönyv előkészítéséből áll : bevezetés, tartalomblokkok, lehetséges interjúk (valós vagy kitalált), átmenetek és lezárás. Minél világosabb a szöveg, annál jobban képes a modell rögzíteni a hangnem változásait, a szüneteket és az egyes „személyek” szerepét a beszélgetésben.
Ezután a modellre épülő eszközök (szkriptek, grafikus felületek vagy más alkalmazásokkal való integrációk) segítségével a szöveg minden részét hozzárendeljük az elérhető előadók egyikéhez . Használhatunk például egy hangot az előadóhoz, egy másikat egy visszatérő vendéghez, egy harmadikat a közönségtől felolvasott kérdésekhez, és egy negyediket tájékoztató jegyzetekhez vagy szponzorált szegmensekhez.
A modell folyamatos hangot generál , miközben tiszteletben tartja a szkript sorrendjét, a hangátmeneteket és a beszélgetés ritmusát. Innentől kezdve az eredmény finomítható egy hagyományos hangszerkesztőben, háttérzene, hangeffektusok, átmenetek hozzáadásával, vagy kisebb hangerő- és hangszínszabályozási beállításokkal.
Annak a képességnek köszönhetően, hogy akár 90 percnyi tartalmat is képes generálni a koherencia elvesztése nélkül , egy teljes epizódot létrehozhatunk egyetlen menetben: nem kell kis blokkokban rögzíteni, vagy aggódni a hangfáradtság, a dikciós hibák vagy a háttérzaj miatt, ami egy fizikai fülkében állandó fejfájást okoz.
AI hangklónozás és hang személyre szabás
Az egyik legkifinomultabb, mégis erőteljes fejlesztés ebben a technológiában a „hangklónozás”, vagy mesterséges intelligencia által vezérelt hangklónozás . Ez mélytanuláson alapuló szintézistechnikákat foglal magában, amelyek lehetővé teszik egy adott hang hangszínének, beszédmintáinak és árnyalatainak replikálását.
A gyakorlatban ezek a rendszerek a célhang egyedi jellemzőit elemzik, mint például a hangszín, a formánsok, a beszédritmus és a prozódiai minták (szünetek, hangsúlyok, kérdő hanglejtés stb.). Mindössze néhány másodpercnyi mintával képesek egy olyan szintetikus hangot generálni, amely nagyon hasonlít az eredetihez.
A VibeVoice esetében említésre került, hogy mindössze 10 másodpercnyi eredeti hanganyaggal is nagyon pontos szimulációkat lehet elérni , amelyek elég jól visszaadják a hang érzelmi hatását és textúráját. Egy podcast esetében ez olyan lehetőségeket nyit meg, mint például a „márkahang” megőrzése még a valódi személy felvételének befejezése után is, vagy visszatérő karakterek létrehozása következetes vokális identitással.
Ez a képesség azonban nagyon komoly etikai kockázatokkal és a szintetikus hangok észlelésének szükségességével jár :
Emiatt a Microsoft hangsúlyozza, hogy a VibeVoice-t kutatási keretrendszeren belül és egyértelmű figyelmeztetésekkel adják ki : nem szabad személyazonosság-lopásra, csalásra, manipulációra vagy dezinformációs kampányokra használni. A felelős használat ennek az egész ökoszisztémának a kulcsfontosságú eleme.
Előnyök tartalomkészítők és kis projektek számára
Egy, a modell futtatására alkalmas számítógéppel és némi szkriptírási idővel hosszú szövegeket percek alatt professzionális hanganyaggá lehet alakítani . Ez vonatkozik informatív podcastokra, hírösszefoglalókra, kitalált történetekre, folytatásos regényekre vagy akár narrált műszaki kézikönyvekre is.
Nagy segítséget nyújt a meglévő írott tartalmak újrahasznosításában is : blogcikkek, hírlevelek, közösségi média hozzászólások vagy jelentések hanganyaggá alakíthatók, amelyek szélesítik az üzenet hatókörét, és kényelmesebb módot kínálnak azok számára, akik inkább hallgatni, mint olvasni szeretnének.
További előny a minőség időbeli állandósága . Míg egy emberi szinkronhang a naptól függően változtathatja az energiáját, az intonációját vagy a tisztaságát, a mesterséges intelligencia állandó szintet tart fenn, ami megkönnyíti a sorozatgyártást: több epizód egyetlen felvétellel rögzítve megőrzi ugyanazt a hangjelenlétet és stílust.
Az oktatás területén a VibeVoice tökéletesen alkalmas hangos kurzusokhoz, vezetett felolvasásokhoz és akadálymentes anyagokhoz látássérültek vagy azok számára, akik egyszerűen csak hallgatás útján szeretnének tanulni, miközben más feladatokat végeznek. A leckék vagy hosszú dokumentumok hangos változatainak generálása rengeteg lehetőséget kínál.
Kockázatok, korlátozások és a Microsoft döntése a tárházzal kapcsolatban
Az érem másik oldala az, hogy az emberi hangok utánzására és realisztikus beszéd generálására képes mesterséges intelligencia komoly etikai és biztonsági aggályokat vet fel. A rosszindulatú felhasználás kockázata valós, és a nagy technológiai vállalatok egyre inkább tudatában vannak ennek.
Magában a bevezető szövegben a Microsoft kifejezetten kijelenti, hogy a VibeVoice-t nem szabad deepfake-ekre, személyazonosság-lopásra vagy illegális tevékenységekre használni . Emellett közvetlenül tiltja a dezinformáció vagy csalás céljából történő használatát, pontosan azért, mert a realizmus szintje könnyen megtévesztheti a gyanútlan hallgatókat.
Bár a létrehozott hang nagyon meggyőző, a modell alkotói rámutatnak, hogy még mindig nem ragadja meg az igazi emberi hang minden finomságát : a lélegzetek, az érzelmi mikrovariációk, bizonyos természetes szünetek és a ritmusváltozások még mindig gazdagabbak egy személyben, mint a mesterséges intelligenciában. Ez a „tökéletlenség” részben segíthet annak felismerésében, hogy egy szintetikus hanggal van dolgunk, de a határ egyre inkább elmosódik.
A projekt nyílt forráskódú kutatási keretrendszerként való megjelenését követően a Microsoft olyan eseteket észlelt, ahol a modellt olyan módon használták, amely nem volt összhangban az eredeti szándékával és a felelős használat elveivel. Válaszul a vállalat bejelentette, hogy kénytelen volt ideiglenesen letiltani a tárházat , amíg biztosítani nem tudja, hogy ezek a hatókörön kívüli felhasználások a továbbiakban ne fordulhassanak elő.
A nyilatkozat hangsúlyozza, hogy a felelős mesterséges intelligenciahasználat a Microsoft egyik alapelve , és hogy inkább szüneteltetik és áttekintik a folyamatot, mintsem fenntartják azt az eszközt, amely súlyos visszaélésekre adhat okot. Ennek ellenére a dokumentáció, a demók és a technikai anyagok máris inspirálták a közösséget és továbbfejlesztették a beszédszintézis területét.
Egyéb alkalmazások a podcastokon túl
Bár a médiafigyelem elsősorban a podcastokra összpontosult, a VibeVoice meglehetősen széleskörű felhasználási lehetőségeket nyit meg a mesterséges intelligencia által generált hanganyagok világában. Ezek közül sok a digitális tartalmakba és az automatizálási stratégiákba is illeszkedik.
Az egyik legkézenfekvőbb példa a hangoskönyvek és a narrált történetek , ahol kulcsfontosságú a kifejező hang, amely képes több tíz percig fenntartani a figyelmet. A több hangszórós képesség lehetővé teszi, hogy minden szereplő saját hangot hallhasson, ami nagyban javítja a hallgatási élményt az egyetlen narrátorhoz képest.
A hangalapú ügynökök és beszélgetős asszisztensek területén a VibeVoice valós idejű verziója ideális. Egy bot, amely mindössze 300 ms késleltetéssel válaszol, sokkal természetesebbnek érződik, mint egy olyan, amelyiknek több másodpercre van szüksége a beszédhez, így az ügyfélszolgálattal, a chatbotokkal vagy a hangalapú felületekkel való interakció sokkal gördülékenyebb.
Egy másik nagyon érdekes terület az automatizált tartalom : hírösszefoglalók, piaci frissítések, időszakos jelentések vagy akár e-mailes értesítések is létrehozhatók emberi beavatkozás nélkül, megőrizve a márkaimázssal összhangban lévő hangvételt.
Végül, léteznek kísérletibb alkalmazások is, mint például a kitalált párbeszédek, szimulált interjúk vagy teljes egészében mesterséges intelligencia által létrehozott szórakoztató programok létrehozása . Itt a forgatókönyvíráshoz használt nyelvi modelleket kombinálják a VibeVoice szinkronhanggal, olyan formátumokat eredményezve, amelyek nemrég még sci-finek tűntek.
Összességében a VibeVoice kulcsszereplőként emelkedik ki a mesterséges intelligencia által generált hangok új hullámában , képes természetes hangokat, több résztvevős beszélgetéseket, nagyon hosszú hangklipeket és szinte azonnali válaszokat kombinálni. Felelősségteljesen és az etikai határokon belül használva hihetetlenül hatékony eszközzé válhat bárki számára, aki podcastot szeretne indítani vagy skálázni, hangoskönyveket készíteni, vagy professzionális szinkronhangokat hozzáadni digitális projektjeihez anélkül, hogy mindig egy hagyományos felvevőstúdióra kellene támaszkodnia.

Index
- 1 Mi a VibeVoice, és miért olyan fontos a podcastok számára?
- 2 A VibeVoice működése: fejlett beszédszintézis és alacsony késleltetés
- 3 Elérhető verziók: modellek, paraméterek és ajánlott felhasználási módok
- 4 Gyakorlati alkalmazások: hogyan készítsünk podcastot a VibeVoice segítségével
- 5 AI hangklónozás és hang személyre szabás
- 6 Előnyök tartalomkészítők és kis projektek számára
- 7 Kockázatok, korlátozások és a Microsoft döntése a tárházzal kapcsolatban
- 8 Egyéb alkalmazások a podcastokon túl