- A mesterséges intelligencia átalakítja a fájlkezelést az osztályozás automatizálásával, a stratégiai adatok kinyerésével és a hitelesség ellenőrzésével.
- Az olyan technológiák, mint az IDP, a számítógépes látás és az NLP, lehetővé teszik az emberi hibák csökkentését és a szabályozási megfelelés optimalizálását a kritikus ágazatokban.
- Az összetett minták elemzésének és a kifinomult csalások felderítésének képessége a dokumentumkezelést verseny- és biztonsági előnnyé teszi.
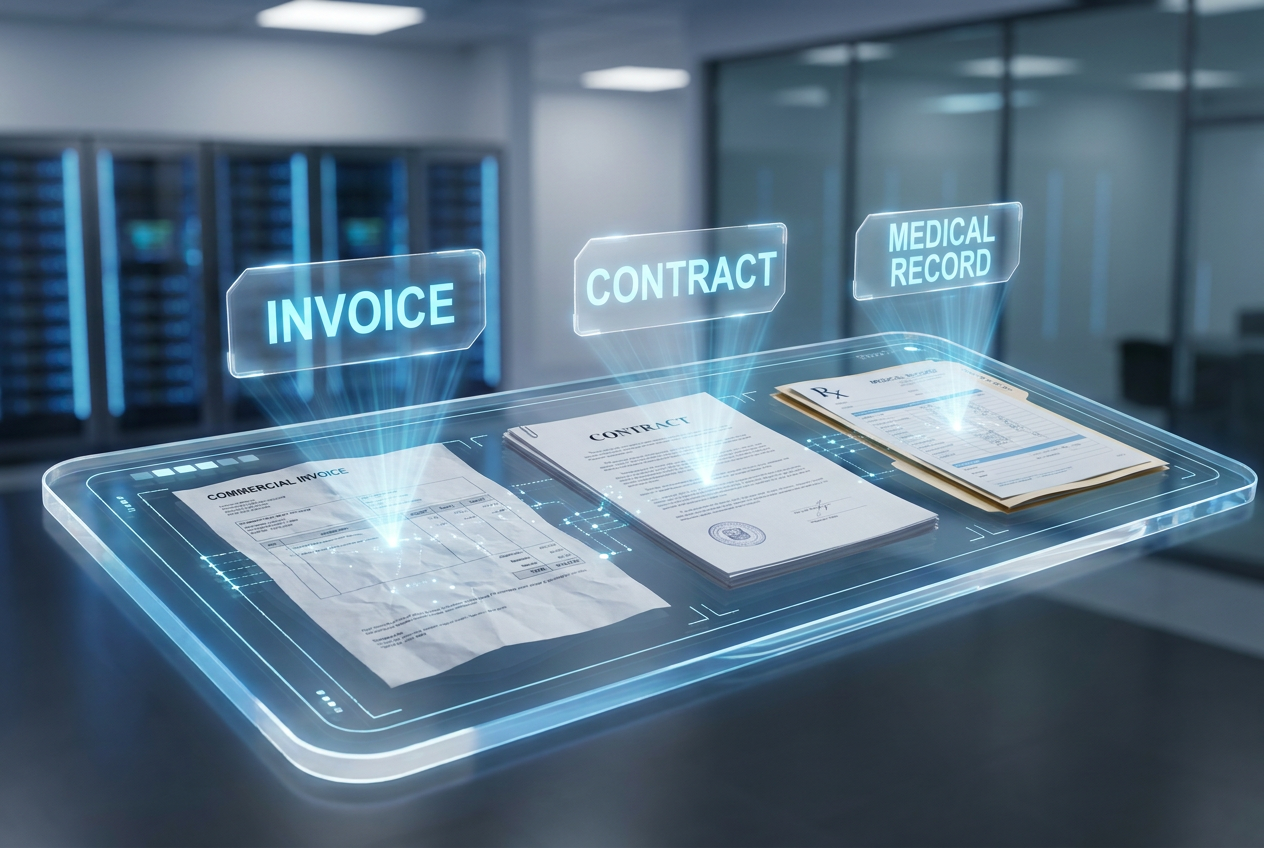
A vállalatok információkezelése már nem pusztán dokumentumok iktatásáról vagy PDF-ek megosztott mappába mentéséről szól. Az adatrobbanás miatt, amit tapasztalunk, a szervezetek strukturálatlan fájlok tengerében rekednek , ahol egy adott információ megtalálása igazi odiszszeiává válhat. Itt jön képbe a mesterséges intelligencia az archiválásban és a dokumentumkezelésben , amely nemcsak segítséget nyújt, hanem teljesen megváltoztatja a játékszabályokat azáltal, hogy a dokumentumkáoszt stratégiai eszközzé alakítja.
Az intelligens észlelő és elemző rendszerek bevezetése lehetővé teszi a vállalatok számára, hogy ne pazarolják az idejüket az ismétlődő és fárasztó feladatokra. Nincs többé szükség arra, hogy egy szakértő manuálisan elolvasson minden szerződést vagy áttekintsen minden számlát; most a gépi tanulási algoritmusoknak és a számítógépes látásnak köszönhetően a gépek megérthetik, hogy mi van egy dokumentumban, annak célját és az esetleges kockázatokat – mindezt a másodperc töredéke alatt és olyan pontossággal, amely megszégyeníti az emberi szemet.

Intelligens dokumentumosztályozás
A fájlok osztályozása több, mint címkézésük; az üzleti dokumentumok automatikus kategorizálásáról szól az erőforrások optimalizálása és a kritikus hibák megelőzése érdekében. Korábban ez a folyamat szűk keresztmetszet volt, amely összetett programozást vagy fárasztó manuális erőfeszítést igényelt. Ma a mesterséges intelligencia minden bejövő fájlt beolvas, és előre meghatározott kategóriákba sorolja, majd közvetlenül a megfelelő munkafolyamatba küldi a zökkenőmentes feldolgozás érdekében.
Ahhoz, hogy ez működjön, a mesterséges intelligencia olyan alapvető fogalmakat használ, mint az entitás azonosítása (nevek, dátumok vagy számok), a kockázati kategória hozzárendelése (például nyilvános vagy bizalmas dokumentumok) és az állandó címkézés. Ez utóbbi létfontosságú ahhoz, hogy más biztonsági eszközök tudják, hogyan kezeljék a fájlt. Továbbá a kontextualizálás lehetővé teszi a mesterséges intelligencia számára, hogy megértse a dokumentumot annak életciklusán belül, több mint 95%-os pontosságot elérve nemcsak a kulcsszavakra, hanem a szöveg tényleges jelentésére is támaszkodva.

Személyazonosság-ellenőrzés és csalásmegelőzés
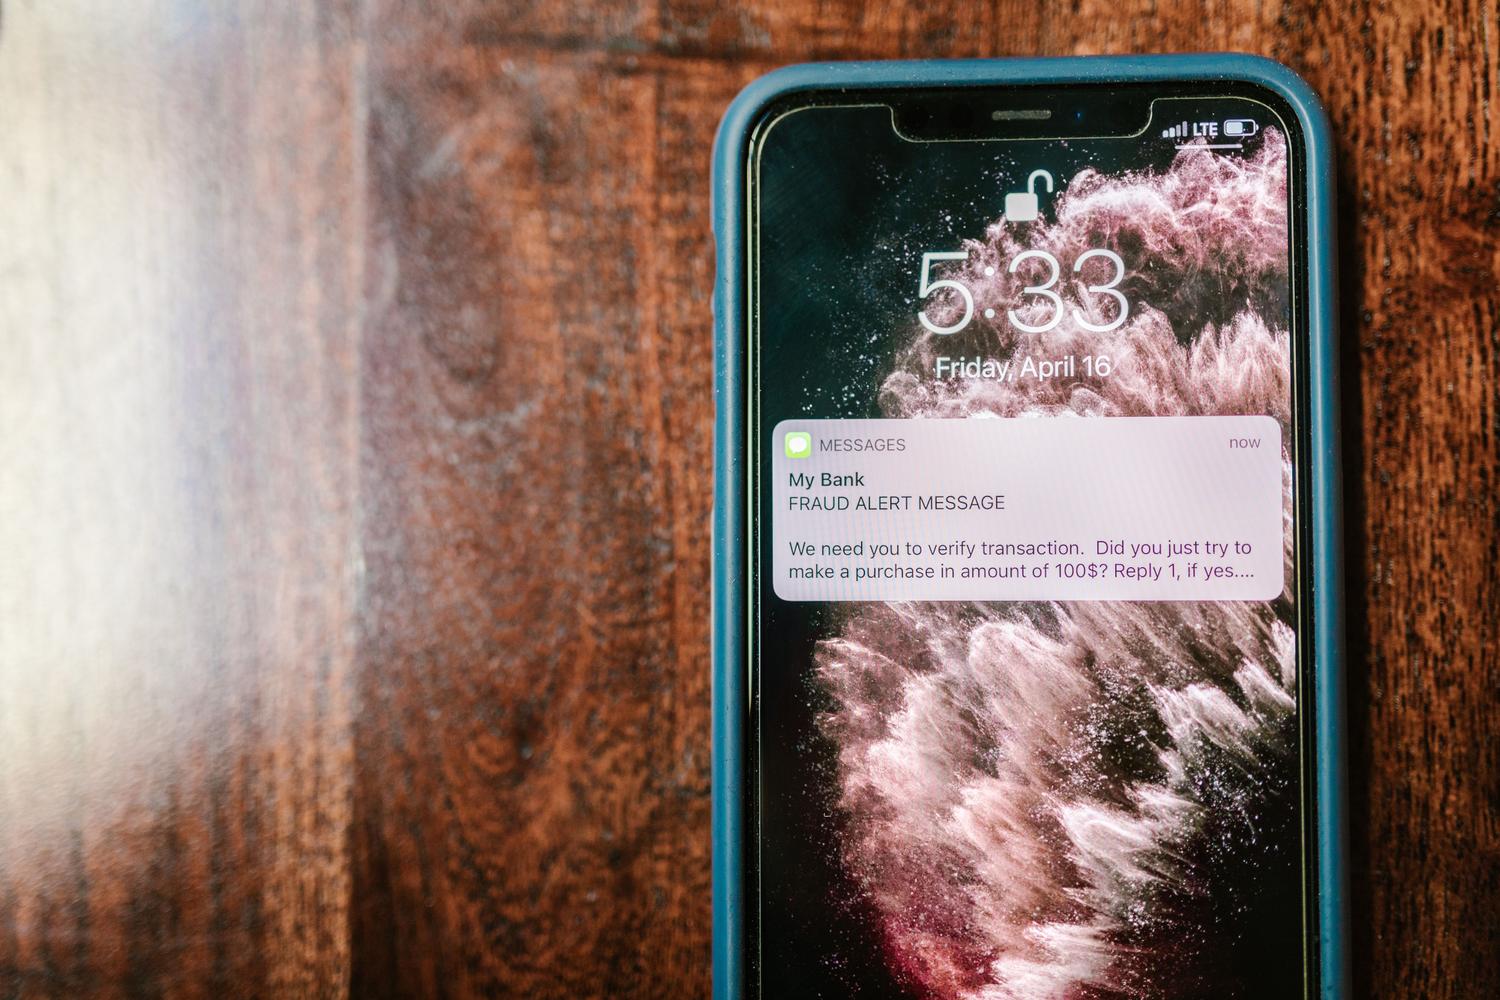
A biztonsági szektorban a mesterséges intelligencia óriási előrelépést tett a személyazonosító okmányok ellenőrzésében, és központi szerepet kapott a KYC (Ismerd meg az ügyfeledet) és az AML (Pénzmosás elleni) folyamatokban. A számítógépes látás és a képelemzés segítségével a rendszerek szinte láthatatlan változtatásokat, például manipulált hologramokat, hamis vízjeleket vagy a mikronyomtatás következetlenségeit is képesek észlelni, amelyeket a legtöbb ember észre sem venne.
Az egyik legerősebb pontja a digitális csalások elleni küzdelem képessége. A mesterséges intelligencia pixelszinten elemzi az anomáliákat, hogy kiszűrje a Photoshop retusálását vagy az arcmódosításokat (deepfake). Továbbá, a biometrikus arcfelismerés összehasonlítja a dokumentumfotót a felhasználó élő videójával, passzív vagy aktív élőség-érzékelést használva annak biztosítására, hogy a dokumentumot bemutató személy fizikailag jelen legyen, és ne csak egy maszk vagy fénykép legyen.

Vezetői technológiák: IDP, NLP és OCR
Mindezek mögött az intelligens dokumentumfeldolgozás (IDP) áll, amely számos technológiát ötvöz, hogy valódi értéket nyerjen ki az adatokból. A fejlett OCR már nem egyszerűen betűket olvas be; a kontextust is értelmezi a pontosság biztosítása érdekében , képeket vagy fizikai dokumentumokat strukturált adatokká alakítva. Eközben a természetes nyelvi feldolgozás (NLP) lehetővé teszi a gép számára, hogy megértse a szöveg szemantikáját, megkönnyítve a minták és anomáliák észlelését.
- Azure AI keresés: Egy olyan szolgáltatás, amely lehetővé teszi a mély szemantikai keresést hatalmas mennyiségű strukturálatlan adatban, ideális jogi vagy HR osztályok számára.
- Nyelvi modellek (LLM-ek): Az olyan eszközök, mint a GPT-4, a Claude vagy a Gemini, képesek egyszerre több fájlt összefoglalni, és összetett kérdésekre válaszolni a forrástartalommal kapcsolatban.
- Viselkedéselemzés: Olyan rendszerek, amelyek figyelik, hogyan lép interakcióba a felhasználó a dokumentummal, hogy azonosítsák a csalás lehetséges jelei.
Valós alkalmazások különböző ágazatokban
Ezeknek az eszközöknek a sokoldalúsága lehetővé teszi, hogy szinte minden szektor profitáljon belőlük. A pénzügyekben a fizetések és a hitelek érvényesítése valós idejű adatkinyerés révén automatizált . A jogi szektorban a mesterséges intelligencia elemzi a szerződéseket, hogy kiemelje a kockázatos záradékokat vagy jogsértéseket, és másodpercek alatt több ezer dokumentum szűrésével egyszerűsíti az elektronikus adatfeltárási folyamatot.
Az egészségügyi szektor mesterséges intelligenciát használ az orvosi feljegyzések digitalizálására és a biztosítási igények automatizálására , megakadályozva az érzékeny adatok elvesztését. Eközben a humánerőforrás területén a vállalati erőforrás-tervezés (ERP) és a humánerőforrás-szoftverek integrációja lehetővé teszi az önéletrajzok automatikus osztályozását készségek szerint, így az ideális jelölt megtalálható anélkül, hogy több száz profilt kellene átnézni. A logisztikában a szállítólevelek és számlák felismerése drasztikusan csökkenti a működési hibákat és optimalizálja az ellátási láncot.

Rendszermegvalósítás és kihívások
Egy ilyen rendszer megvalósításához nem elég egyszerűen szoftvert telepíteni; azonosítani kell a fájdalompontokat, például az időigényes folyamatokat. Kulcsfontosságú a mérhető célok meghatározása, valamint annak biztosítása, hogy a megoldás skálázható legyen, és megfeleljen az olyan szabályozásoknak, mint a GDPR és a CCPA, mivel a személyes adatok kezelése érzékeny terület.
Nem minden megy zökkenőmentesen, mivel jelentős kihívásokkal kell szembenézni. A betanítási adatokban mutatkozó torzítás bizonyos demográfiai csoportok esetében tisztességtelen eredményekhez vezethet, ezért létfontosságú a változatos adatkészletek használata. Ezenkívül a csalók folyamatosan fejlesztik taktikáikat, arra kényszerítve a mesterséges intelligencia modelljeit, hogy folyamatos átképzésen menjenek keresztül, hogy elkerüljék az elavulást.
Ezen képességek integrálása lehetővé teszi az adatvesztés-megelőzési (DLP) eszközök sebészi pontossággal történő működését. Ha a mesterséges intelligencia egy fájlt magas kockázatú bizalmasként jelöl meg , a biztonsági rendszer automatikusan blokkolhatja annak kilépését a vállalati hálózatból. Ez a dokumentumkezelést valódi kiberbiztonsági pajzsmá alakítja, amely garantálja az érzékeny információk teljes nyomon követhetőségét.
A szemantikus elemzés, a számítógépes látás és a generatív modellek konvergenciája egy olyan ökoszisztémát hoz létre, ahol az információkat már nem egyszerűen tárolják, hanem aktívan kezelik. A fájltípus-észlelés és -validálás automatizálásával a szervezetek nemcsak a költségeket és az időt csökkentik, hanem megvédik infrastruktúrájukat a csalástól , és felhatalmazzák a valós, strukturált adatokon alapuló döntéshozatalt.
