- VibeVoice adalah model TTS Microsoft yang mampu menghasilkan audio multi-pembicara yang panjang dan ekspresif, ideal untuk podcast dan buku audio.
- Arsitekturnya menggabungkan tokenisasi ucapan, model bahasa yang besar, dan difusi untuk menghasilkan suara alami bahkan dalam rekaman audio hingga berdurasi 90 menit.
- Teknologi ini memungkinkan respons mendekati waktu nyata dengan sedikit variasi, tetapi memerlukan penggunaan yang bertanggung jawab karena risiko kloning suara dan deepfake.
- Kerangka kerja ini telah dirilis sebagai kerangka kerja penelitian sumber terbuka, meskipun Microsoft untuk sementara membatasi repositori karena kekhawatiran tentang penyalahgunaan.

Kehadiran VibeVoice dari Microsoft merevolusi cara pembuatan podcast dan konten audio berdurasi panjang menggunakan kecerdasan buatan. Model TTS (text-to-speech) sumber terbuka ini tidak hanya menghasilkan suara yang sangat realistis, tetapi juga memungkinkan produksi percakapan dengan banyak pembicara dan durasi hingga 90 menit tanpa gangguan atau penurunan kualitas yang canggung.
Tujuan VibeVoice adalah menyediakan studio rekaman virtual bagi siapa pun yang mampu memproduksi podcast, buku audio, atau narasi secara profesional dari komputer. Yang Anda butuhkan hanyalah naskah dan beberapa pengetahuan teknis dasar untuk mengatur modelnya, dan AI akan menangani sisanya: intonasi, naturalitas, perubahan suara, dan kontinuitas di seluruh audio.
Apa itu VibeVoice dan mengapa begitu penting untuk podcast?
Model ini berbasis pada teknologi TTS (Text-to-Speech), yang berarti secara langsung mengubah teks menjadi ucapan , tetapi dengan tingkat kelancaran dan nuansa yang sangat mirip dengan ucapan manusia. VibeVoice awalnya dirilis dalam versi dengan parameter 1.5B dan 7B , yang dirancang untuk menyeimbangkan kualitas dan kemampuan untuk menghasilkan aliran audio panjang tanpa konsumsi sumber daya yang berlebihan.
Salah satu keunggulan terbesarnya adalah kemampuannya untuk merekam audio hingga 90 menit secara terus menerus , menjaga konsistensi suara dan intonasi sepanjang rekaman. Hal ini membuatnya sangat berguna untuk podcast lengkap, bab buku audio, atau episode konten pendidikan panjang yang sebelumnya membutuhkan beberapa sesi perekaman dengan aktor suara manusia.
Selain itu, VibeVoice dirancang untuk menangani hingga empat suara berbeda dalam satu rekaman audio , memungkinkan simulasi wawancara, diskusi panel, dialog antar karakter, atau episode yang dinarasikan oleh aktor suara yang berbeda. Kemampuan multi-pembicara ini merupakan kunci untuk membuat podcast bertenaga AI menjadi lebih dinamis dan menarik.
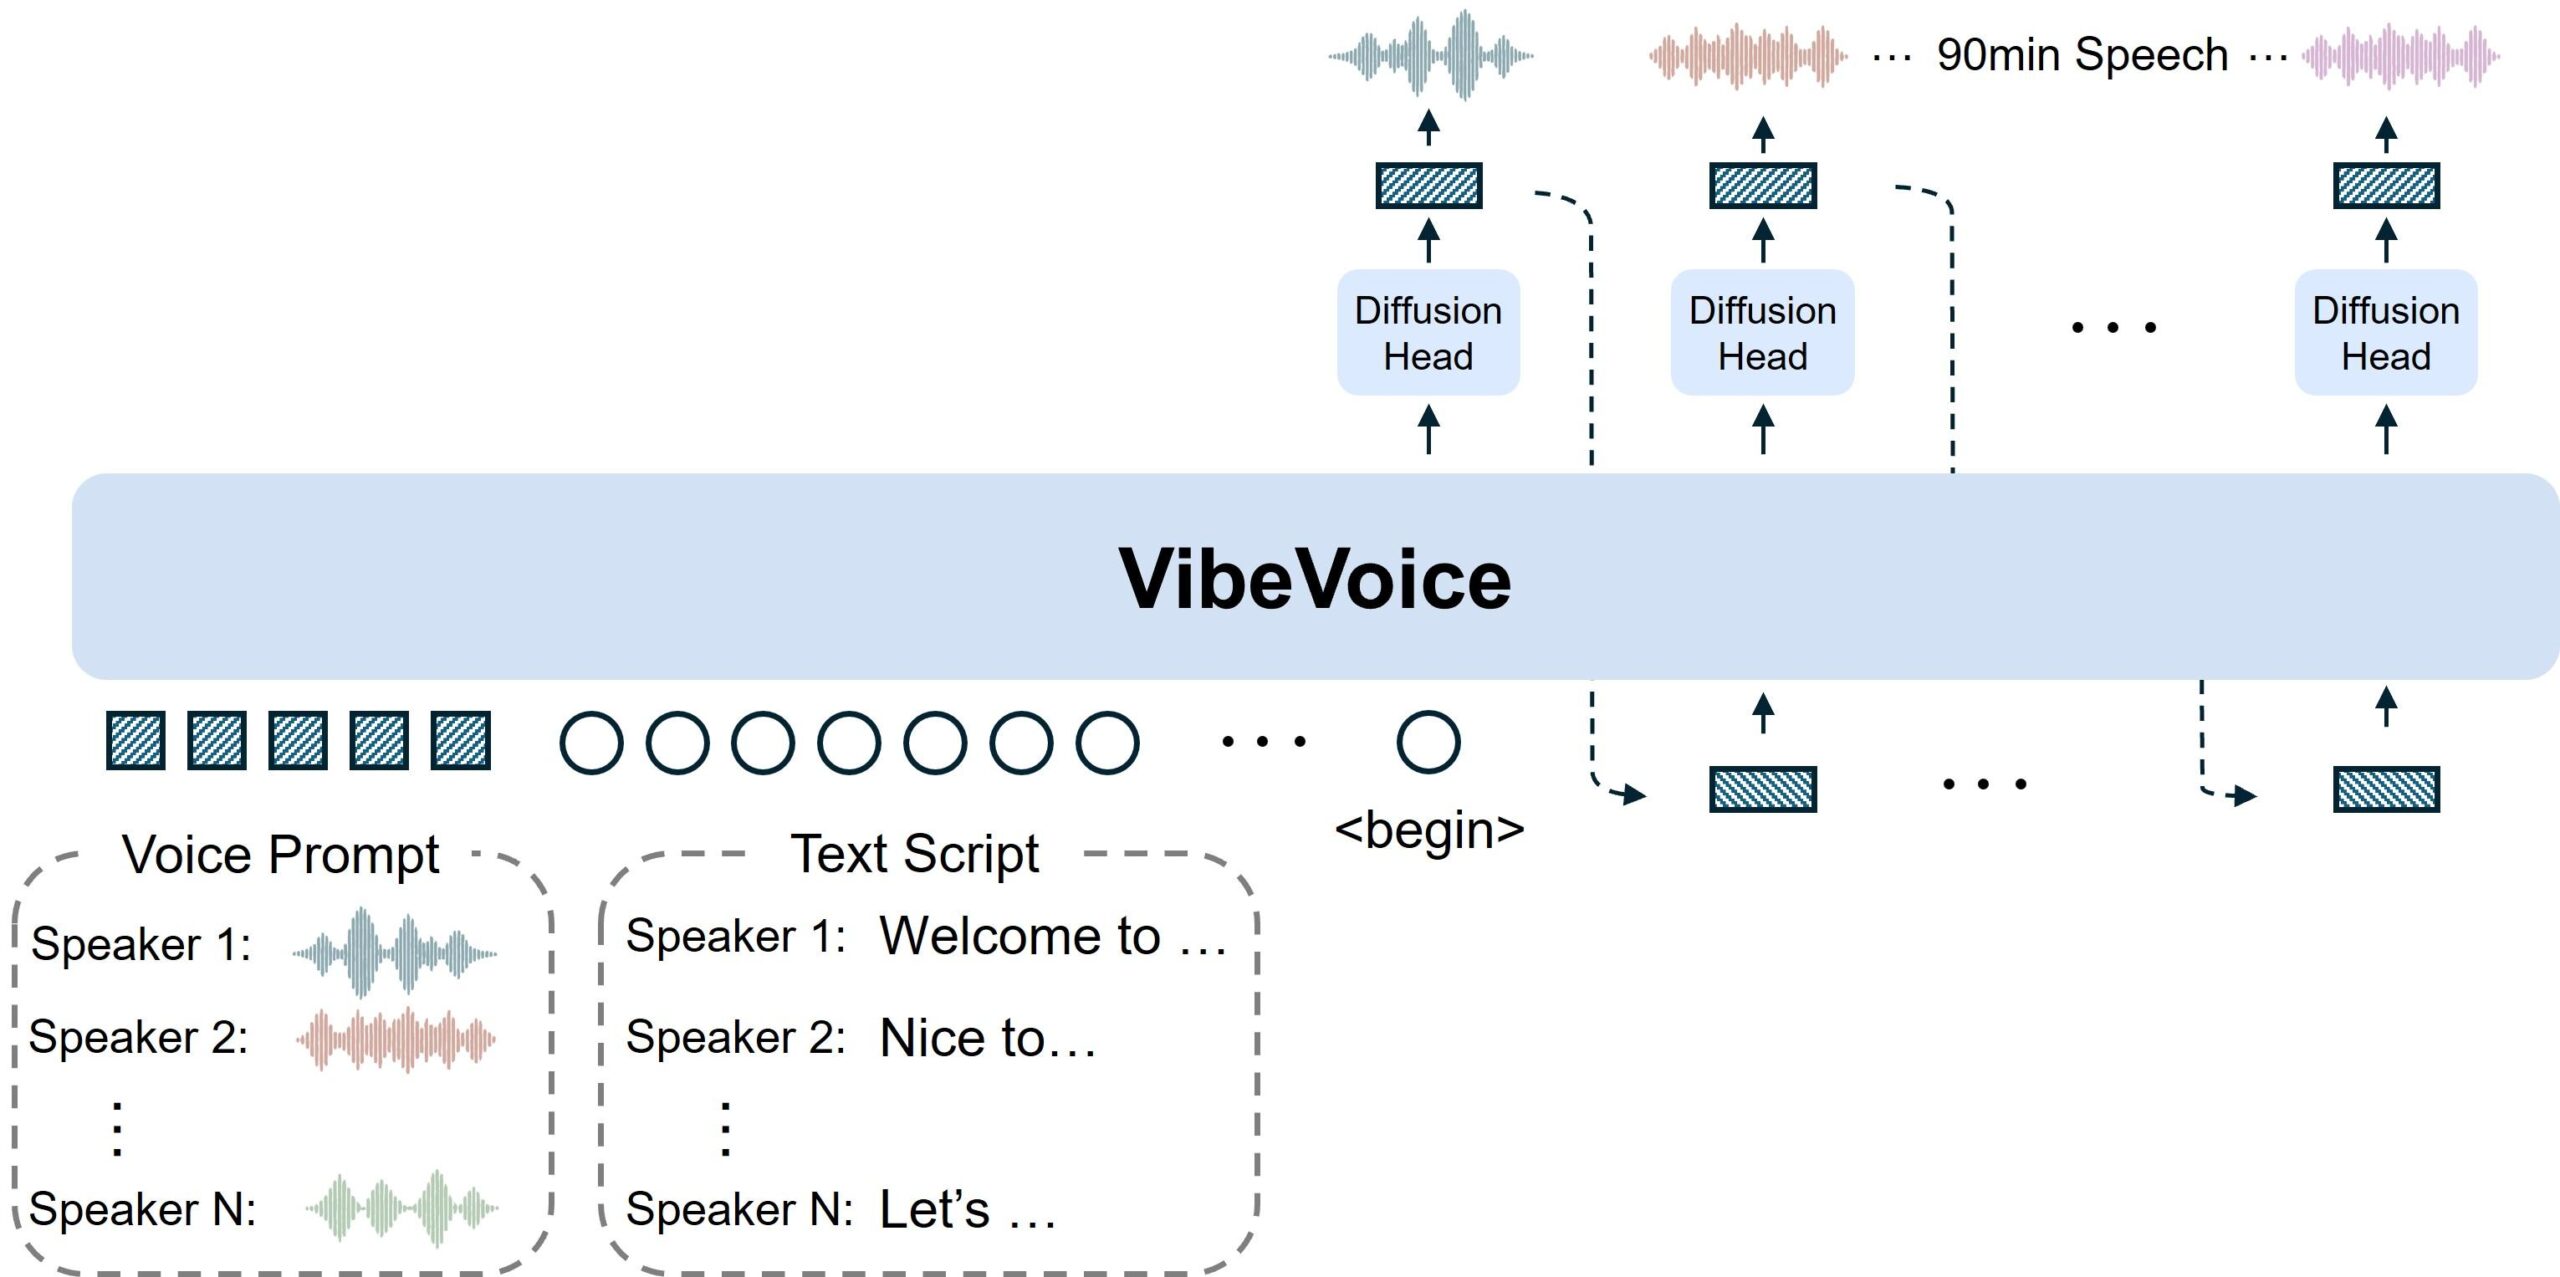
Cara kerja VibeVoice: sintesis suara tingkat lanjut dan latensi rendah.
Di balik judul yang menarik perhatian, yang membuat VibeVoice istimewa adalah arsitektur teknisnya yang dirancang untuk rekaman audio dan percakapan berdurasi panjang . Microsoft menggabungkan beberapa komponen untuk membuat suara terdengar alami, beradaptasi dengan teks, dan dihasilkan secara real-time atau mendekati real-time.
Sistem ini menggunakan tokenisasi ucapan akustik dan semantik kontinu yang beroperasi pada frekuensi sangat rendah, sekitar 7,5 Hz. Ini berarti sistem ini memadatkan informasi audio menjadi lebih sedikit "langkah" per detik dibandingkan model lain, sehingga mempertahankan fidelitas suara sekaligus mengurangi biaya komputasi secara signifikan saat bekerja dengan urutan yang panjang.
Di atas representasi yang dikompresi ini, sebuah model bahasa besar (LLM) berperan penting, yang bertanggung jawab untuk menafsirkan isi skrip, alur percakapan, dan siapa yang berbicara pada saat tertentu. Dengan cara ini, ia memahami apakah itu pertanyaan, jawaban, komentar ironis, atau perubahan topik, dan menyesuaikan keluaran suara sesuai dengan itu.
Terakhir, kepala difusi digunakan untuk merekonstruksi detail akustik berkualitas tinggi: timbre, tekstur vokal, napas halus, dan nuansa lainnya. Kombinasi LLM + difusi ini memastikan bahwa audio yang dihasilkan konsisten, ekspresif, dan nyaman didengarkan dalam jangka waktu lama.
Secara paralel, Microsoft telah meluncurkan varian khusus yang disebut VibeVoice-Realtime-0.5B , yang dirancang untuk respons yang sangat cepat: model ini dapat mulai memancarkan suara sekitar 300 milidetik setelah menerima teks. Artinya, praktis secara real-time, ideal untuk agen suara, asisten percakapan, atau aplikasi di mana latensi harus minimal.
Versi yang tersedia: model, parameter, dan penggunaan yang disarankan.
Dalam ekosistem VibeVoice, beberapa versi telah diperkenalkan dengan ukuran dan orientasi model yang berbeda , yang dirancang untuk aplikasi audio panjang dan interaktif.
Di satu sisi, kita memiliki varian utama dengan parameter 1.5B dan 7B , yang dirancang untuk menangani konten yang luas seperti podcast lengkap, program radio simulasi, bab buku audio, atau kursus audio. Jumlah parameter yang lebih tinggi memungkinkan kapasitas yang lebih besar untuk menangkap nuansa dan mengelola dialog yang kompleks, meskipun juga meningkatkan kebutuhan perangkat keras.
Di sisi lain, versi VibeVoice-Realtime-0.5B memprioritaskan kecepatan respons daripada ukuran model. Meskipun "hanya" memiliki 0,5B parameter , jumlah yang sederhana dibandingkan dengan raksasa seperti ChatGPT atau Gemini, justru inilah yang memungkinkannya menghasilkan audio kontinu hingga 90 menit sambil mempertahankan suara yang jernih dan intonasi yang stabil.
Varian waktu nyata ini sangat menarik untuk agen suara, chatbot, asisten virtual , dan aplikasi apa pun di mana pengguna mengharapkan AI untuk merespons langsung dengan suara, bukan hanya teks. Dengan latensi mendekati 300 ms, pengalamannya sangat mirip dengan berbicara dengan seseorang di ujung sana.
Dalam semua kasus, model ini dimaksudkan untuk digunakan dari lingkungan lokal atau penelitian , karena Microsoft awalnya memutuskan untuk merilisnya sebagai proyek sumber terbuka, yang dapat diakses dari GitHub dan platform seperti Hugging Face, sehingga memudahkan komunitas untuk mengujinya, mengadaptasinya, dan membangun alat di atasnya.
Aplikasi praktis: cara membuat podcast dengan VibeVoice
Salah satu aplikasi unggulan VibeVoice tidak diragukan lagi adalah pembuatan podcast tanpa perlu aktor suara manusia . Bagi siapa pun yang memiliki ide, naskah, atau konten tertulis, tetapi tidak berani tampil di depan mikrofon, model ini membuka peluang besar.
Alur kerja umum untuk memproduksi podcast dengan VibeVoice biasanya melibatkan persiapan skrip yang terstruktur dengan baik : pengantar, blok konten, potensi wawancara (nyata atau fiktif), transisi, dan penutup. Semakin jelas teksnya, semakin baik model dapat menangkap perubahan nada, jeda, dan peran setiap "orang" dalam percakapan.
Kemudian, dengan menggunakan alat yang dibangun berdasarkan model tersebut (skrip, antarmuka grafis, atau integrasi dengan aplikasi lain), setiap bagian teks ditugaskan kepada salah satu pembicara yang tersedia . Misalnya, kita dapat menggunakan satu suara untuk presenter, suara lain untuk tamu tetap, suara lain untuk pertanyaan yang dibacakan dari audiens, dan suara keempat untuk catatan informatif atau segmen bersponsor.
Model ini menghasilkan audio berkelanjutan dengan tetap memperhatikan urutan skrip, transisi suara, dan ritme percakapan. Dari situ, hasilnya dapat disempurnakan dalam editor audio tradisional, dengan menambahkan musik latar, efek suara, transisi, atau melakukan penyesuaian kecil pada volume dan ekualisasi.
Berkat kemampuan untuk menghasilkan konten hingga 90 menit tanpa kehilangan koherensi , kami dapat membuat satu episode lengkap dalam sekali jalan: tidak perlu merekam dalam blok-blok kecil atau khawatir tentang kelelahan suara, kesalahan diksi, atau kebisingan latar belakang, sesuatu yang di dalam studio rekaman fisik merupakan masalah yang terus-menerus.
Kloning suara AI dan personalisasi suara
Salah satu kemajuan paling halus namun ampuh dalam teknologi ini adalah "kloning suara" atau kloning suara berbasis AI . Ini melibatkan teknik sintesis berdasarkan pembelajaran mendalam yang memungkinkan replikasi timbre, pola bicara, dan nuansa suara tertentu.
Dalam praktiknya, sistem ini menganalisis karakteristik unik dari suara target, seperti timbre, formant, ritme bicara, dan pola prosodik (jeda, aksen, intonasi pertanyaan, dll.). Hanya dengan beberapa detik sampel, mereka mampu menghasilkan suara sintetis yang sangat mirip dengan suara aslinya.
Dalam kasus VibeVoice, disebutkan bahwa dimungkinkan untuk mencapai simulasi yang sangat akurat hanya dengan 10 detik audio asli , menangkap dampak emosional dan tekstur suara dengan cukup baik. Untuk podcast, ini membuka kemungkinan seperti mempertahankan "suara merek" bahkan setelah orang tersebut berhenti merekam, atau menciptakan karakter berulang dengan identitas vokal yang konsisten.
Namun, kemampuan ini disertai dengan risiko etika yang sangat serius dan kebutuhan untuk mendeteksi audio sintetis :
Oleh karena itu, Microsoft menekankan bahwa VibeVoice dirilis dalam kerangka penelitian dan dengan peringatan yang jelas: aplikasi ini tidak boleh digunakan untuk pencurian identitas, penipuan, manipulasi, atau kampanye disinformasi. Penggunaan yang bertanggung jawab adalah komponen kunci dari seluruh ekosistem ini.
Keuntungan bagi pembuat konten dan proyek kecil
Dengan komputer yang mampu menjalankan model tersebut dan sedikit waktu untuk menulis skrip, dimungkinkan untuk mengubah teks panjang menjadi audio profesional hanya dalam hitungan menit. Ini berlaku untuk podcast informatif, buletin berita, cerita fiksi, novel berseri, atau bahkan manual teknis yang dinarasikan.
Ini juga sangat membantu dalam mendaur ulang konten tertulis yang sudah ada : artikel blog, buletin, unggahan media sosial, atau laporan dapat diubah menjadi episode audio yang memperluas jangkauan pesan dan menawarkan cara yang lebih nyaman bagi mereka yang lebih suka mendengarkan daripada membaca.
Keunggulan lainnya adalah konsistensi kualitas dari waktu ke waktu . Sementara aktor suara manusia dapat memvariasikan energi, intonasi, atau kejelasan suara mereka tergantung pada hari itu, AI mempertahankan tingkat yang konstan, yang memfasilitasi produksi serial: beberapa episode yang direkam dalam satu kali pengambilan akan mempertahankan kehadiran dan gaya suara yang sama.
Di bidang pendidikan, VibeVoice sangat cocok untuk kursus audio, panduan membaca, dan materi yang mudah diakses bagi penyandang disabilitas visual atau mereka yang lebih suka belajar dengan mendengarkan sambil melakukan tugas lain. Kemampuan untuk menghasilkan versi lisan dari pelajaran atau dokumen panjang menawarkan banyak kemungkinan.
Risiko, keterbatasan, dan keputusan Microsoft terkait repositori tersebut.
Sisi lain dari permasalahan ini adalah bahwa AI yang mampu meniru suara manusia dan menghasilkan ucapan yang realistis menimbulkan kekhawatiran etika dan keamanan yang serius. Risiko penggunaan yang jahat itu nyata, dan perusahaan teknologi besar semakin menyadarinya.
Dalam teks peluncurannya, Microsoft secara eksplisit menyatakan bahwa VibeVoice tidak boleh digunakan untuk deepfake, pencurian identitas, atau aktivitas ilegal . Mereka juga secara langsung melarang penggunaannya dalam konteks disinformasi atau penipuan, justru karena tingkat realismenya dapat dengan mudah menipu pendengar yang tidak curiga.
Meskipun suara yang dihasilkannya sangat meyakinkan, para pencipta model tersebut menunjukkan bahwa suara itu masih belum menangkap semua nuansa suara manusia asli : tarikan napas, variasi mikro emosional, jeda alami tertentu, dan perubahan ritme masih lebih kaya pada manusia daripada pada AI. "Ketidaksempurnaan" ini dapat membantu, sebagian, untuk mendeteksi bahwa kita sedang berurusan dengan suara sintetis, tetapi batasannya semakin kabur.
Setelah proyek tersebut dirilis sebagai kerangka kerja penelitian sumber terbuka , Microsoft mendeteksi beberapa kasus di mana model tersebut digunakan dengan cara yang tidak sesuai dengan tujuan awal dan prinsip penggunaan yang bertanggung jawab. Sebagai tanggapan, perusahaan mengumumkan bahwa mereka terpaksa menonaktifkan sementara repositori tersebut hingga dapat memastikan bahwa penggunaan di luar cakupan tersebut tidak dapat terjadi lagi.
Pernyataan tersebut menekankan bahwa penggunaan AI yang bertanggung jawab adalah prinsip inti bagi Microsoft , dan bahwa mereka lebih memilih untuk berhenti sejenak dan meninjau daripada mempertahankan alat yang dapat memfasilitasi penyalahgunaan serius. Meskipun demikian, dokumentasi, demo, dan materi teknis telah berhasil menginspirasi komunitas dan terus memajukan bidang sintesis suara.
Aplikasi lain selain podcasting
Meskipun perhatian media terutama terfokus pada podcast, VibeVoice membuka berbagai macam kasus penggunaan dalam dunia audio yang dihasilkan AI. Banyak di antaranya juga sesuai dengan strategi konten digital dan otomatisasi.
Salah satu contoh yang paling jelas adalah buku audio dan cerita yang dinarasikan , di mana memiliki suara ekspresif yang mampu mempertahankan perhatian selama puluhan menit sangat penting. Kemampuan multi-speaker memungkinkan setiap karakter memiliki suara mereka sendiri, yang sangat meningkatkan pengalaman mendengarkan dibandingkan dengan narator tunggal.
Di bidang agen suara dan asisten percakapan, versi real-time VibeVoice sangat ideal. Bot yang merespons dengan penundaan hanya 300 ms terasa jauh lebih alami daripada bot yang membutuhkan beberapa detik untuk berbicara, sehingga interaksi dengan layanan pelanggan, chatbot, atau antarmuka suara menjadi jauh lebih lancar.
Bidang lain yang sangat menarik adalah konten otomatis : ringkasan berita, pembaruan pasar, laporan berkala, atau bahkan pembacaan dan pemberitahuan email dapat dihasilkan tanpa campur tangan manusia, dengan tetap mempertahankan gaya bahasa yang konsisten dengan citra merek.
Terakhir, terdapat aplikasi yang lebih eksperimental, seperti pembuatan dialog fiksi, wawancara simulasi, atau program hiburan yang dibuat sepenuhnya oleh AI . Di sini, model bahasa untuk penulisan skrip digabungkan dengan VibeVoice untuk pengisi suara, menghasilkan format yang baru-baru ini tampak seperti fiksi ilmiah.
Jika dilihat secara keseluruhan, VibeVoice menonjol sebagai pemain kunci dalam gelombang baru audio yang dihasilkan AI , mampu menggabungkan suara alami, percakapan multi-peserta, klip audio yang sangat panjang, dan respons yang hampir instan. Jika digunakan secara bertanggung jawab dan dalam batasan etika yang telah ditetapkan, VibeVoice dapat menjadi alat yang sangat ampuh bagi siapa pun yang ingin meluncurkan atau mengembangkan podcast, memproduksi buku audio, atau menambahkan sulih suara profesional ke proyek digital mereka tanpa selalu bergantung pada studio rekaman tradisional.

Indeks
- 1 Apa itu VibeVoice dan mengapa begitu penting untuk podcast?
- 2 Cara kerja VibeVoice: sintesis suara tingkat lanjut dan latensi rendah.
- 3 Versi yang tersedia: model, parameter, dan penggunaan yang disarankan.
- 4 Aplikasi praktis: cara membuat podcast dengan VibeVoice
- 5 Kloning suara AI dan personalisasi suara
- 6 Keuntungan bagi pembuat konten dan proyek kecil
- 7 Risiko, keterbatasan, dan keputusan Microsoft terkait repositori tersebut.
- 8 Aplikasi lain selain podcasting