- Pipe di Linux memungkinkan Anda untuk menghubungkan proses secara berantai dengan menghubungkan stdout dan stdin, dengan dukungan kernel dan alat seperti tee, xargs, dan cpio untuk alur yang kompleks.
- Pipeline CI/CD yang efisien di Linux bergantung pada desain tahapan yang baik, penggunaan cache yang intensif, artefak yang tidak dapat diubah, dan pengujian paralel.
- Mengoptimalkan server Linux (CPU, RAM, I/O, Docker) dan eksekutor Jenkins, GitHub Actions, atau GitLab Runner adalah kunci untuk mengurangi waktu eksekusi.
- Mengintegrasikan keamanan, kemampuan pengamatan, dan pengendalian biaya ke dalam alur kerja memastikan penerapan yang andal, dapat dilacak, dan berkelanjutan di lingkungan produksi.
Mengoptimalkan pipeline di Linux Ini bukan hanya tentang menggabungkan perintah dengan simbol. |Di balik semua itu tersembunyi sebuah dunia yang luas. optimalisasi kinerjaDesain alur kerja, CI/CD, keamanan, dan penyetelan sistem operasi membuat perbedaan besar antara pipeline yang lambat dan tidak stabil dengan pipeline yang berjalan cepat, andal, dan murah untuk dipelihara. Jika Anda bekerja dengan server Linux, baik itu mengotomatiskan tugas di terminal atau menjalankan pipeline integrasi berkelanjutan, memahami detail ini akan menghemat banyak waktu dan mengurangi masalah.
Dalam artikel ini kita akan menggabungkan dua perspektif yang saling melengkapi: di satu sisi, Penggunaan klasik pipe dalam baris perintah Linux (pipa, pengalihan, perintah seperti) tee, xargs o cpio); di sisi lain, Optimasi pipeline CI/CD pada server LinuxIni mencakup caching, paralelisasi pengujian, penyetelan Docker, keamanan rantai pasokan, dan metrik alur kerja tingkat lanjut. Semuanya dijelaskan dalam bahasa Spanyol (dari Spanyol), dengan contoh yang jelas dan pendekatan yang sangat praktis.
Apa itu pipeline dan bagaimana pipa (pipe) terintegrasi ke dalam Linux?
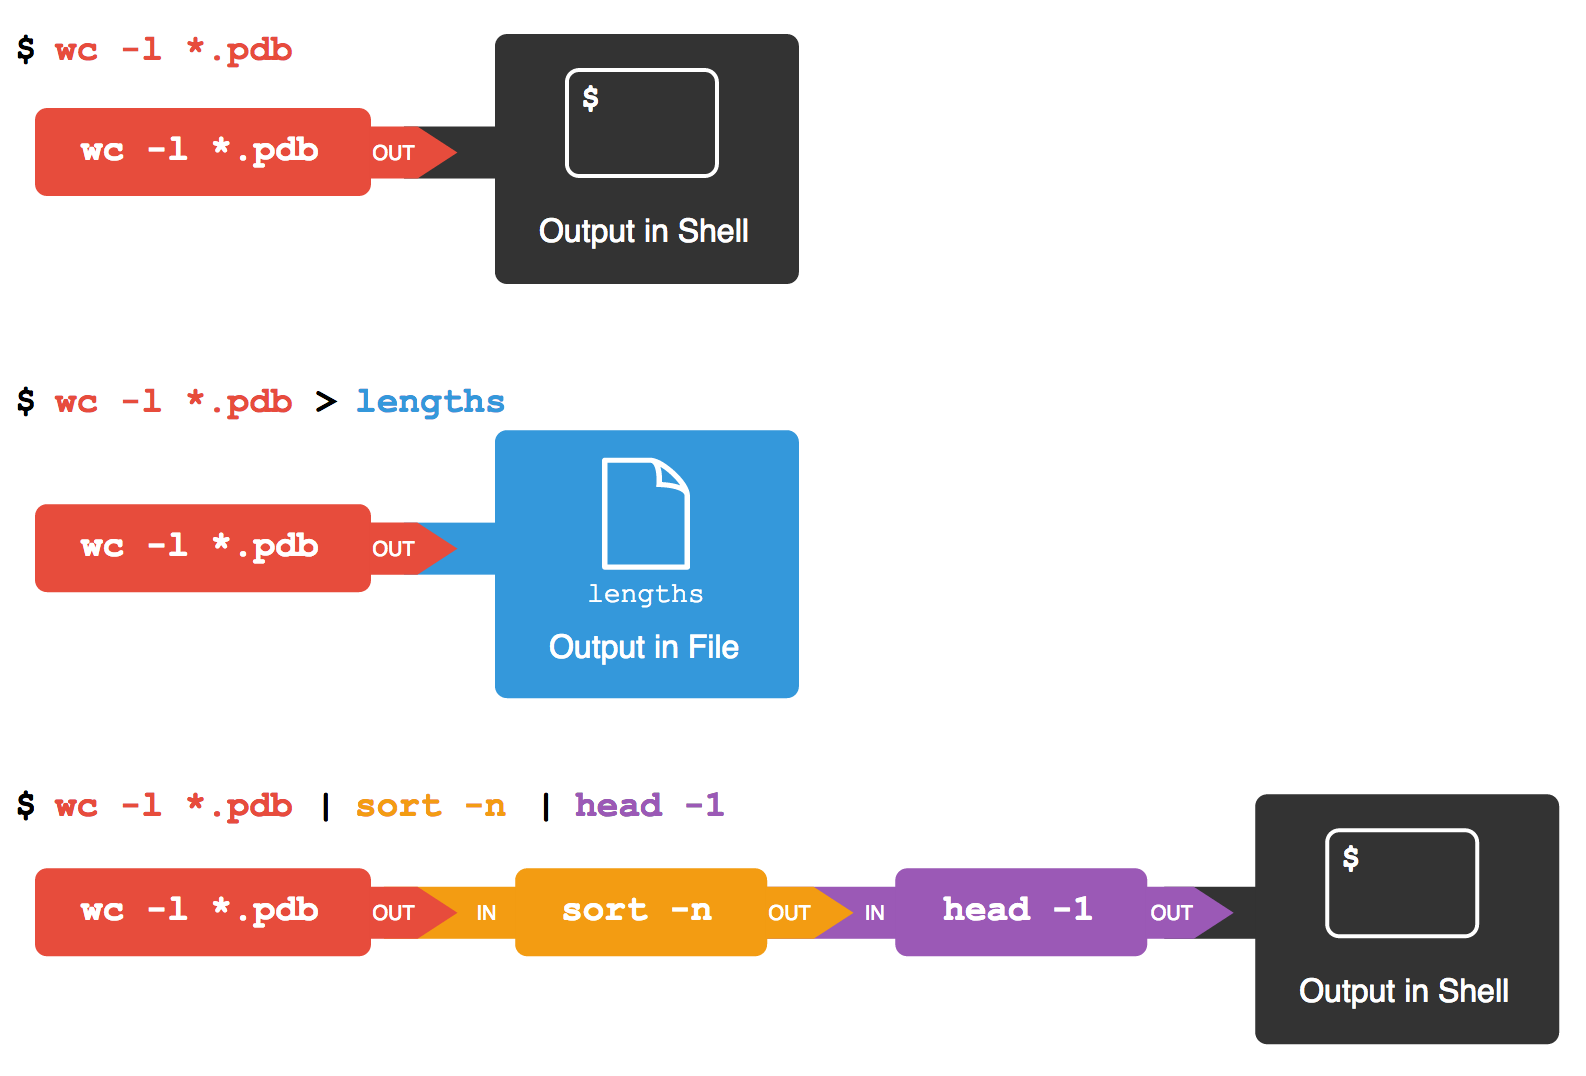
Istilah pipeline berasal dari gagasan sebuah pipa : aliran data yang mengalir dari satu titik ke titik lain. Dalam komputasi, dan khususnya di Linux, pipa adalah mekanisme yang memungkinkan output standar dari satu proses menjadi input standar dari proses lain. Dengan kata lain, output dari satu perintah secara otomatis dimasukkan ke perintah berikutnya tanpa melalui file perantara.
Dalam sistem mirip Unix, terdapat dua jenis pipa utama . Di satu sisi, terdapat pipa anonim atau tanpa nama , yang hanya dapat digunakan antara proses yang terkait erat (misalnya, induk dan anak). Di sisi lain, terdapat pipa bernama , juga dikenal sebagai FIFO (First In – First Out), yang memungkinkan komunikasi antara proses yang tidak terkait langsung dan bahkan mungkin berada di mesin yang berbeda yang terhubung ke jaringan.
Saluran anonim biasanya menyediakan komunikasi searah : satu proses menulis dan proses lainnya membaca. Sebaliknya, saluran bernama memungkinkan komunikasi dua arah jika dirancang demikian, misalnya, dengan membuka FIFO dalam mode baca/tulis dari kedua ujungnya. Saluran ini banyak digunakan untuk mengkoordinasikan proses daemon, skrip, atau layanan yang perlu saling mengirim data tanpa memblokir.
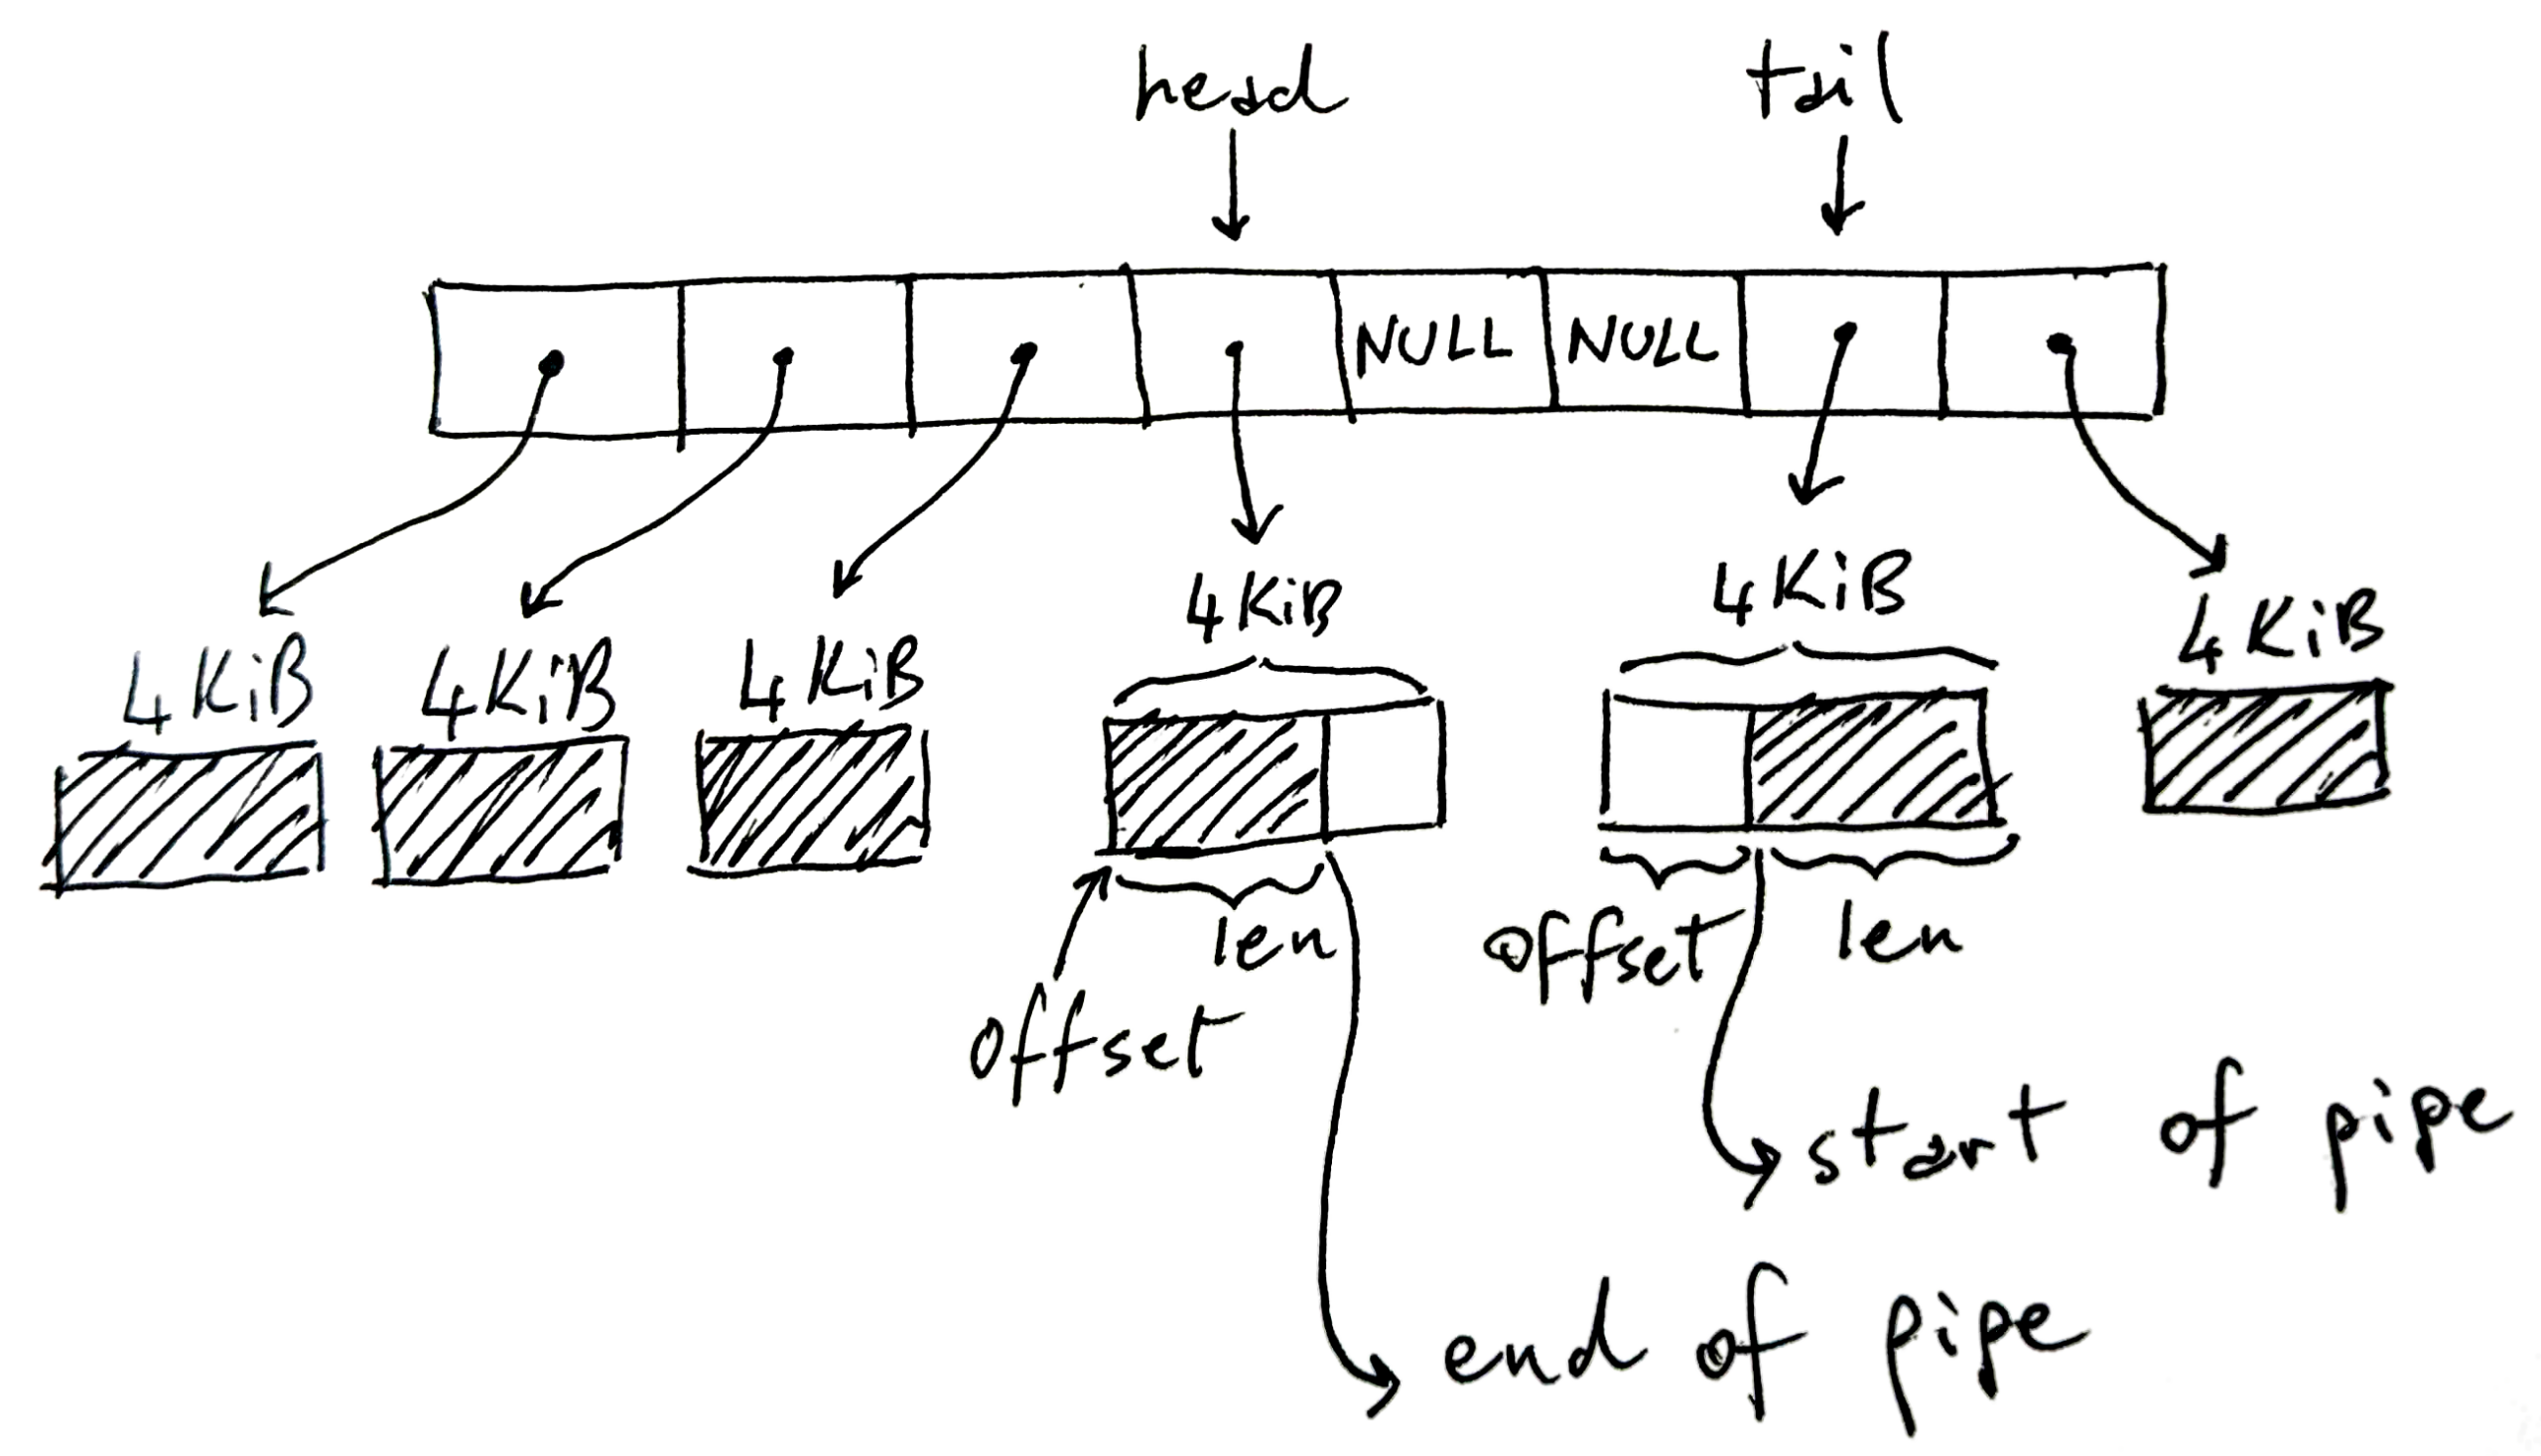
Pada tingkat implementasi, dukungan untuk pipeline ada di kernel linuxbukan di dalam shell. Penerjemah perintah (bash, zsh, dll.) hanya membuat pipeline melalui panggilan sistem seperti pipe() y fork()Mengalihkan deskriptor file lalu meluncurkan setiap program. Keajaiban sebenarnya tentang bagaimana proses diblokir, bagaimana buffer dikelola, dan bagaimana data disebarkan antara produsen dan konsumen ditangani oleh kernel sistem.
Memahami stdin, stdout, dan aliran data.
Untuk bekerja secara efektif dengan pipeline, sangat penting untuk memahami apa itu stdin, stdout, dan stderr . Ini bukanlah konsep abstrak: setiap proses di Linux dimulai dengan tiga deskriptor file terbuka, yang menunjuk ke sumber daya spesifik yang dikelola oleh kernel.
stdin (deskriptor 0) dan stdout (deskriptor 1) dapat dilihat sebagai aliran byte yang terhubung ke sesuatu: bisa berupa terminal, file, soket jaringan, atau pipa. Keduanya bukan sekadar buffer; keduanya adalah referensi ke objek kernel ( struktur tipe file ) yang pada gilirannya terkait dengan inode, soket, atau struktur pipa internal.
Setiap proses memiliki deskriptornya masing-masing, sehingga setiap perintah dalam sebuah pipeline Ia memandang stdin dan stdout secara independen. Pada baris seperti ls | grep txt | wc -l, The ls tulis di dalam pipa, grep Ia membaca dari satu pipa dan menulis ke pipa lainnya, dan wc Baca dari yang terakhir. Bagi pengguna, ini tampak sebagai satu string tunggal, tetapi secara internal, ini adalah... beberapa buffer kernel yang digabungkandengan setiap proses akan terhenti dan dilanjutkan kembali tergantung pada ruang atau data yang tersedia.
Ketika proses pertama menghasilkan data lebih cepat daripada proses kedua mengonsumsinya, buffer pipa akan penuh. Pada titik itu, penulisan selanjutnya akan kembali, memblokir proses pengirim hingga proses pengonsumsi... baca informasi yang cukup dan membebaskan ruang. Ini mencegah memori menjadi tidak terkendali; data tidak menumpuk tanpa batas kecuali Anda menggunakan I/O non-blocking atau sinyal khusus. Misalnya, dalam kasus seperti dd if=/dev/sda | gzip -9dan gzip mengompres lebih lambat, dd Dia terpaksa menunggu.
Mekanisme tekanan balik ini membuat pipeline cukup stabil bahkan ketika ada ketidakseimbangan kinerja antar tahapan, sesuatu yang kemudian juga tercermin dalam desain pipeline CI/CD , di mana tahapan yang lambat menjadi hambatan yang perlu diukur dan dioptimalkan.
Penggunaan praktis pipe di terminal Linux
Dalam penggunaan sehari-hari, pipe digunakan untuk menghubungkan perintah dalam satu baris dan mengubah data langkah demi langkah. Alih-alih menjalankan perintah, melihat output, menyalinnya, lalu menempelkannya ke perintah lain, Anda dapat membangun "pabrik data" kecil yang sangat fleksibel dalam teks biasa.
Contoh umum dalam lingkungan Unix adalah menggabungkan perintah fortune, yang menampilkan kutipan acak, dengan cowsayyang mencetak gambar sapi yang "berbicara". Dengan menggunakan pipa, Kepergian Fortune menjadi pesan bagi Cowsay.Semua dalam satu perintah. Ini adalah contoh yang menyenangkan, tetapi secara sempurna menggambarkan gagasan menghubungkan alat-alat sederhana untuk tugas-tugas yang lebih kompleks.
Cara klasik lainnya adalah mengirimkan hasil dari ls a wc untuk menghitung baris, kata, dan karakter. Kira-kira seperti ini: ls | wc Ini memungkinkan Anda untuk melihat dengan cepat berapa banyak item yang terdaftar. Kelebihannya adalah Anda tidak memerlukan satu program pun untuk melakukan semuanya, melainkan... Anda menciptakan solusi dengan utilitas kecil yang dirancang dengan baik..
Sangat umum juga untuk merangkainya bersama-sama. cat, sort y more (atau program pengurut halaman lainnya) untuk mengurutkan berkas teks dan kemudian menelusurinya halaman demi halaman. Dengan menggunakan pipe, konten diteruskan dari satu perintah ke perintah berikutnya tanpa disimpan ke berkas sementara secara eksplisit, yang sangat menyederhanakan pembuatan skrip dan tugas administratif.
Dalam kasus praktis seperti memproses daftar siswa dan nilai dalam file terpisah, Anda dapat menggunakan paste untuk menggabungkan kolom, cut untuk memilih hanya bidang yang Anda minati dan pipa berantai untuk memfilter, mengurutkan, atau mengubah semuanya dalam satu baris skrip shell. Pola ini Uraikan masalah besar menjadi perintah-perintah sederhana yang dikombinasikan dengan pipe. Inilah intisari dari filosofi Unix.
Perintah tingkat lanjut untuk memaksimalkan penggunaan pipe: tee, xargs, dan cpio
Saat Anda mulai benar-benar mengotomatiskan berbagai hal di Linux, pipe menjadi semakin ampuh berkat beberapa alat penting. Di antaranya adalah: tee, xargs y cpioyang melengkapi alur data standar dengan sangat baik.
Perintah tee Cara kerjanya seperti huruf "T" pada pipa air: ia membaca dari stdin, menulis ke stdout, dan juga menyalin output yang sama ke satu atau lebih file. Ini ideal ketika Anda ingin Lihat hasilnya di layar dan, pada saat yang sama, simpan. untuk meninjaunya nanti atau memprosesnya di tahap lain. Dengan pilihan -a Fungsi ini menambahkan data ke akhir file, bukan menimpanya.
Misalnya, Anda dapat mengurutkan daftar dengan sortkirim hasilnya ke tee untuk menyimpannya dalam log dan, pada saat yang sama, meneruskannya ke more untuk melakukan paginasi. Dengan cara ini, dalam satu alur kerja, Anda memiliki pengurutan, penyimpanan ke disk, dan tampilan yang mudah tanpa mengulangi proses pengurutan.
Perintah xargs Ini adalah bagian fundamental lain dalam hal pipe. Fungsinya adalah untuk mengambil apa yang datang melalui stdin (biasanya daftar elemen) dan mengubahnya menjadi argumen untuk perintah lain. Ini sangat berguna ketika program mengalami crash karena menerima terlalu banyak parameter sekaligus atau ketika Anda ingin bagi pekerjaan menjadi beberapa kelompok dengan opsi -n, yang membatasi jumlah argumen yang dilewatkan per eksekusi.
Misalnya dengan ls | xargs -n 4 Anda membagi daftar file menjadi kelompok empat, lalu menjalankan perintah target (secara default). echo(atau yang Anda tentukan) beberapa kali. Dengan cara ini, Anda dapat membangun alur kerja seperti "pratinjau apa yang akan saya hapus" dengan menggabungkan ls, xargs y echo rm sebelum meluncurkan penghapusan data yang sebenarnya.
Berhati-hatilah dengan input yang kompleks: jalur dengan spasi atau karakter khusus dapat merusak perilaku default dari xargsDalam kasus tersebut, biasanya digunakan dalam kombinasi dengan find dan pilihannya -print0, yang memisahkan elemen dengan karakter null, bersama dengan xargs -0 sehingga kedua ujung menggunakan pembatas yang sama dan kuat.
Akhirnya, cpio Ini adalah perintah yang kurang dikenal dibandingkan tarNamun, ia sangat fleksibel untuk bekerja dengan aliran file melalui pipa. Tidak seperti tar, ia dirancang dari awal untuk beroperasi dengan pengalihan dan pipa: menerima daftar file melalui stdin (biasanya dihasilkan dengan find) dan menghasilkan atau mengonsumsi file tipe "paket" tanpa kompresi sendiri, yang kemudian dapat Anda kompres dengan gzip atau serupa.
Modus utama cpio izinkan pembuatan file (-o), menyalin struktur direktori (-p) atau ekstrak konten (-i(sering disebut sebagai “salin masuk”). Opsi seperti -u untuk menimpa, -m untuk menyimpan cap waktu atau -d Membuat ulang struktur direktori memungkinkan hal tersebut. untuk mengontrol secara detail apa yang disalin dan bagaimana caranya., sangat berguna terutama dalam skrip yang kompleks di mana tar gagal.
Desain dan optimasi pipeline CI/CD pada server Linux.
Di luar baris perintah tradisional, konsep pipeline telah menjadi fundamental dalam dunia Integrasi Berkelanjutan dan Pengiriman Berkelanjutan (CI/CD) . Pada server Linux, pipeline CI/CD adalah urutan langkah-langkah otomatis: mengambil kode, menginstal dependensi, mengkompilasi, menjalankan pengujian, mengemas artefak, dan menyebarkan.
Linux sangat cocok untuk ini karena unggul dalam hal kecepatan, stabilitas, dan ekosistem alat otomatisasi . Platform seperti Jenkins, GitHub Actions, dan GitLab CI mengandalkan eksekutor Linux (mesin fisik, mesin virtual, atau kontainer) untuk menjalankan pipeline secara konsisten.
Mengoptimalkan pipeline ini berarti tidak hanya membuatnya "berfungsi," tetapi juga membuatnya berfungsi dengan gesekan seminimal mungkin. Ini berarti mengurangi waktu checkout, meminimalkan instalasi dependensi yang berulang, mengoptimalkan image Docker untuk menghindari pembangunan ulang yang tidak perlu, menggunakan kembali artefak yang sudah dihasilkan, dan menjaga lingkungan tetap aman dan dapat dipantau.
Praktik baik yang mendasar adalah menyusun alur kerja ke dalam tahapan yang terdefinisi dengan baik: membangun, menguji, dan menyebarkan . Idealnya, Anda hanya perlu mengkompilasi sekali, menghasilkan artefak (biner, paket, citra Docker) yang diuji secara paralel dalam berbagai varian (misalnya, berbagai versi bahasa), dan kemudian menyebarkan artefak yang sama ke lingkungan staging dan produksi tanpa kompilasi ulang.
Bekerja dengan artefak yang tidak dapat diubah yang disimpan dalam repositori (S3, Nexus, Artifactory, registri kontainer, atau paket yang tertanam di GitLab/GitHub) menyederhanakan audit, memungkinkan pengembalian versi yang cepat, dan mengurangi kemungkinan "berfungsi di mesin saya tetapi tidak di lingkungan produksi".
Prasyarat: distribusi, pengguna CI, dan pengerasan server.
Sebelum terjebak dalam optimasi milidetik di sana-sini, penting untuk membangun fondasi yang stabil pada server Linux yang akan bertindak sebagai eksekutor CI/CD. Ini dimulai dengan memilih distribusi dan konfigurasi keamanan minimum.
Pendekatan yang paling masuk akal biasanya adalah melakukan standardisasi pada distribusi LTS atau stabil yang sudah dikenal tim: Ubuntu LTS, Debian Stable, atau alternatif perusahaan seperti AlmaLinux atau Rocky Linux. Dengan menggunakan versi yang sama untuk semua pengguna, perilaku yang tidak terduga yang disebabkan oleh perbedaan pustaka atau kernel antar pekerjaan dapat dicegah.
Rekomendasi lainnya adalah untuk mengkonfigurasi pengguna khusus untuk CI, tanpa hak akses root, dengan sudo yang sangat terbatas hanya pada perintah-perintah penting (misalnya, systemctl o docker (jika memang benar-benar diperlukan). Pengguna ini harus melakukan otentikasi menggunakan kunci SSH, baik untuk mengakses server maupun untuk berinteraksi dengan repositori Git atau mesin jarak jauh lainnya.
Pada tingkat sistem, disarankan untuk memelihara server. diperbarui dan diperkuat seminimal mungkinIni termasuk menerapkan pembaruan keamanan, mengkonfigurasi firewall yang ketat (misalnya, dengan UFW: menolak semua lalu lintas masuk kecuali yang diperlukan dan mengizinkan lalu lintas keluar), dan mengaktifkan alat-alat seperti fail2ban untuk menghentikan serangan brute-force pada SSH dan menyesuaikan beberapa parameter jaringan dan kernel melalui sysctl untuk meningkatkan keandalan dan kinerja.
Sebagai contoh, biasanya batas dinaikkan batalkan untuk mencegah sistem build yang memantau banyak file kehabisan sumber daya, dan menyesuaikan parameternya. vm.swappiness untuk membuat kernel lebih konservatif saat menggunakan swap, sesuatu yang sangat relevan terutama ketika pekerjaan CI mengonsumsi banyak memori sekaligus.
Cache, Docker, dan paralelisasi: pengungkit kinerja dalam CI/CD
Jika Anda melihat ke mana waktu sebenarnya dihabiskan dalam alur kerja rata-rata, Anda akan melihat bahwa sebagian besar waktu hilang untuk menginstal dependensi dan membangun ulang citra Docker . Mengatasi hal ini biasanya lebih efektif daripada mengoptimalkan kode pengujian beberapa milidetik.
Pengungkit pertama adalah caching dependensi . Hampir semua pengelola dependensi (pip, npm, Maven, Gradle, modul Go, dll.) menggunakan direktori cache lokal. Pada server Linux yang persisten, Anda dapat berbagi direktori ini antar pekerjaan atau memasangnya pada volume persisten. Dengan cara ini, setiap eksekusi tidak perlu mengunduh setengah dari internet lagi.
Untuk Docker, aktifkan MembangunKit dan menyusun struktur dengan baik Dockerfile Ini menandai titik balik. Menempatkan instalasi dependensi tepat setelah menyalin file persyaratan, dan sebelum sisa kode, memastikan bahwa lapisan-lapisan tersebut digunakan kembali selama versi dependensi tersebut tetap tidak berubah. Selain itu, cache khusus untuk pip, npm, dll., dapat diatur di dalam proses build itu sendiri.
Tuas utama kedua adalah eksekusi pengujian paralelBanyak framework yang secara bawaan mendukung konkurensi: pytest dengan -n autoAlat Java seperti Surefire, Jest di JavaScript dengan --maxWorkersdll. Membagi rangkaian pengujian berdasarkan modul, folder, atau bahkan perkiraan waktu dan membaginya di antara beberapa pekerja memungkinkan pengurangan durasi fase pengujian sebanyak 2 hingga 5 kali lipat tanpa mengubah satu pun lini bisnis.
Terakhir, ada masalah artefak dan penyebaran . Alih-alih mengkompilasi ulang citra yang sama untuk lingkungan staging, pra-produksi, dan produksi, pendekatan yang efisien adalah membangun sekali, menyimpan hasilnya ke repositori, dan memberi tag sesuai dengan lingkungan penyebaran. Ini mengurangi penggunaan CPU, menghindari inkonsistensi, dan secara signifikan mempercepat alur kerja yang panjang.
Mengoptimalkan Jenkins, GitHub Actions, dan GitLab Runner di Linux
Setiap sistem CI memiliki kekhasan masing-masing, tetapi semuanya mendapat manfaat dari ide dasar yang sama saat dijalankan di Linux. Kuncinya biasanya adalah menggunakan executor yang bersifat sementara dan bersih , mempertahankan cache persisten dengan ukuran yang tepat, dan mengontrol konkurensi.
Di Jenkins, praktik umum adalah menggunakan agen ringan dan sementara (seperti kontainer Docker atau pod di Kubernetes atau solusi orkestrasi kontainer lainnya ) untuk menjalankan pekerjaan, sambil menjaga node master sesederhana mungkin. Agen-agen ini dapat dikonfigurasi sebagai layanan systemd pada server Linux, mendaftar ke pengontrol dan berjalan secara otomatis saat mesin dinyalakan.
Untuk GitHub Actions dengan runner yang dihosting sendiri, disarankan untuk menyebarkannya di Mesin virtual Linux dengan SSD cepatUntuk membuat direktori cache besar yang dikhususkan untuk tindakan (ketergantungan bahasa, cache build, dll.), batasi jumlah pekerjaan bersamaan untuk menghindari kelebihan beban CPU dan disk. Manfaatkan tindakan caching resmi dengan jalur seperti ~/.cache/pip, ~/.npm o ~/.m2 Hal itu membuat perbedaan besar dalam hal waktu.
Di GitLab Runner, pilihan antara shell executor dan Docker bergantung pada keseimbangan antara performa dan isolasi yang Anda butuhkan. Shell executor lebih cepat karena berjalan langsung di host, tetapi Docker executor menawarkan lingkungan yang bersih dan dapat direplikasi. Anda juga dapat mengkonfigurasi caching bersama (lokal atau di S3) dan menyesuaikan jumlah maksimum pekerjaan bersamaan untuk memanfaatkan perangkat keras tanpa membebani perangkat tersebut.
Dalam semua kasus ini, memiliki volume bersama untuk caching dependensi sekaligus mencegah ruang kerja menjadi berantakan di antara proses build sangat penting. Mesin atau kontainer sementara, yang dibuat dan dihancurkan dengan setiap pipeline atau kelompok pipeline, sangat mengurangi masalah "berhasil kemarin, tetapi tidak hari ini" yang disebabkan oleh sisa-sisa build sebelumnya.
Performa server Linux: CPU, memori, I/O, dan Docker
Tidak peduli seberapa optimal skrip Anda, jika server Linux yang menjalankan pipeline tidak memiliki ukuran yang tepat, Anda akan menghadapi antrian yang tak berujung dan pekerjaan yang berjalan lambat. Konfigurasi yang umum dan wajar untuk mesin kelas menengah adalah 4-8 vCPU dan 8-16 GB RAM , dengan penyimpanan SSD (idealnya NVMe) dan ruang swap (2-4 GB) untuk menangani beban puncak tanpa harus menghentikan proses secara agresif.
Sistem file juga penting. Gunakan ext4 atau XFS dengan opsi noatime Pada volume tempat Anda mengkompilasi atau menulis log, kurangi I/O yang tidak perlu. Selain itu, memasang sebuah tmpfs untuk file sementara atau artefak berumur pendek (misalnya, /mnt/ci-tmp) mempercepat operasi intensif dan mencegah disk terisi penuh dengan file sisa di antara pekerjaan.
Terkait Docker, kebersihan daemon sangat penting. Menghapus image dan volume yang tidak digunakan secara aman dan teratur, sambil mempertahankan image dasar yang aktif, membantu untuk mengontrol ruang disk dan waktu bootingPerintah seperti docker system prune Dengan filter waktu yang tepat, mereka memungkinkan pembersihan tanpa membebani sumber daya yang baru saja digunakan.
Jika CI Anda sangat bergantung pada kontainer, Anda juga dapat menggunakan register yang dicerminkan untuk menghindari pengunduhan terus-menerus dari internet, menggunakan BuildKit untuk konkurensi dan caching lapisan, dan bahkan mengkonfigurasi afinitas CPU (set CPU) atau node khusus untuk eksekutor yang paling menuntut, mencegah interferensi antara beban kerja yang berdekatan. Selain itu, memahami mikroarsitektur CPU membantu Anda menentukan ukuran sumber daya yang lebih baik untuk beban kerja CI yang intensif.
Keamanan dalam pipeline (DevSecOps) dan penerapan pada Linux
Pipeline yang cepat namun tidak aman adalah bom waktu yang siap meledak. Mengintegrasikan keamanan ke dalam pipeline itu sendiri dan keamanan kontainer Docker kini menjadi standar dalam strategi DevSecOps apa pun, dan Linux menawarkan banyak alat untuk hal ini.
Hal pertama yang harus dilakukan adalah memperlakukan rahasia dan kredensial dengan sangat hati-hati . Rahasia dan kredensial tidak boleh pernah berada di dalam kode atau file konfigurasi yang memiliki versi. Sebaliknya, rahasia dan kredensial disimpan dalam pengelola rahasia (variabel bertopeng GitLab, rahasia terenkripsi GitHub, HashiCorp Vault, dll.) dan hanya disuntikkan selama eksekusi pekerjaan yang membutuhkannya, menggunakan token berumur pendek jika memungkinkan.
Lapisan penting lainnya adalah pembuatan SBOM (Software Bill of Materials) dan penandatanganan artefak. Alat seperti Syft atau CycloneDX memungkinkan Anda untuk mencantumkan semua komponen yang membentuk sebuah image atau binary, sementara Cosign atau solusi penandatanganan terverifikasi lainnya memastikan bahwa hanya artefak yang telah melalui pipeline dan divalidasi yang di-deploy.
Dari segi jaringan dan akses, disarankan untuk memisahkan jaringan CI dan produksi , menerapkan firewall yang ketat, mengaudit log eksekusi, dan merotasi kredensial secara berkala. Jika menggunakan SSH, lebih baik menggunakan sertifikat atau kunci dengan tanggal kedaluwarsa daripada kata sandi statis.
Saat melakukan deployment di Linux, strategi seperti Blue/Green, rolling, dan canary sangat mengurangi dampak kesalahan deployment. Menjalankan aplikasi sebagai layanan systemd, menempatkan Nginx atau HAProxy di depannya, dan mengontrol lalu lintas antar versi dengan health check memungkinkan Anda mencapai waktu henti hampir nol selama pembaruan.
Misalnya, saat memuat ulang Nginx dan memulai ulang layanan dengan systemd menggunakan sinyal soft stop (seperti SIGTERMDengan waktu tunggu yang wajar, Anda dapat menguras koneksi aktif sebelum proses berhenti, sehingga pengalaman pengguna tetap terjaga saat Anda beralih versi di latar belakang.
Observabilitas, metrik, dan biaya dalam pipeline Linux
Setelah alur kerja Anda berjalan, langkah selanjutnya adalah mengukurnya dan memahami ke mana waktu dan sumber daya dialokasikan . Tidak cukup hanya mengetahui apakah alur kerja berhasil atau gagal; Anda perlu memantau durasi setiap tahap, waktu antrian, tingkat keberhasilan, frekuensi penerapan, tingkat hit cache, dan sebagainya.
Mengekspor metrik sistem biasanya dilakukan dengan cara berikut: node_exporterSentralisasikan log dengan solusi seperti ELK atau Loki, dan visualisasikan semuanya di dasbor Grafana. Dengan cara ini, Anda dapat mendeteksi, misalnya, jika fase pengujian telah meningkat durasinya sebesar 30% dalam seminggu terakhir atau jika pekerjaan menghabiskan terlalu banyak waktu menunggu eksekutor yang tersedia; pemantauan lalu lintas jaringan Alat sumber terbuka melengkapi visibilitas tersebut.
Dimungkinkan juga untuk menginstrumentasi pipeline itu sendiri, misalnya di GitHub Actions atau GitLab CI, untuk untuk mengukur secara terprogram berapa banyak eksekusi yang berhasil, berapa lama setiap eksekusi berlangsung, dan bagaimana status keseluruhannya.Sebuah skrip yang memanggil API penyedia, menghitung jumlah total eksekusi, jumlah eksekusi yang berhasil, jumlah eksekusi yang gagal, tingkat keberhasilan, dan durasi rata-rata, lalu menyimpan semuanya dalam file JSON (seperti pipeline-metrics.json) memungkinkan Anda untuk mengintegrasikan metrik-metrik ini ke dalam laporan atau dasbor.
Dengan informasi ini, Anda dapat membuat keputusan tentang ukuran dan jumlah runner : terkadang lebih baik memiliki lebih banyak runner kecil daripada beberapa runner yang sangat besar untuk mengurangi waktu tunggu. Autoscalability—misalnya, cloud autoscaling atau dynamic pools dari node Kubernetes—membantu menyerap aktivitas puncak di siang hari dan meminimalkan sumber daya yang kurang dimanfaatkan di malam hari.
Praktik-praktik ini tidak hanya meningkatkan pengalaman tim, tetapi juga membantu menyesuaikan biaya infrastruktur dengan mengendalikan konsumsi CPU, memori, dan terutama penyimpanan, yang cenderung melonjak drastis jika tidak dibersihkan secara teratur dan terencana dengan menggunakan image dan cache.
Menguasai baik perintah baris klasik maupun pipeline CI/CD modern di Linux menawarkan kombinasi yang ampuh: Anda dapat mengotomatiskan segalanya, mulai dari tugas penyaringan teks sederhana hingga pipeline build, test, dan deployment yang kompleks, mudah dipelihara, aman, dan cepat. Memahami bagaimana informasi mengalir antar proses, bagaimana dependensi di-cache, bagaimana server disetel, dan bagaimana metrik dan keamanan diintegrasikan memungkinkan Anda membangun alur kerja yang dapat diskalakan bersama tim dan proyek Anda tanpa menjadi hambatan yang konstan.
