- Sebagian besar bencana sistem RAID diperparah oleh tindakan tergesa-gesa dalam beberapa menit pertama setelah kegagalan terjadi.
- Setiap level RAID mengelola data dan paritas secara berbeda, yang menentukan risiko aktual dan strategi pemulihan.
- Intervensi profesional ini menggabungkan kloning disk, rekonstruksi array virtual, dan teknik analisis logis tingkat lanjut.
- RAID tidak menggantikan backup: pencegahan dan respons yang teratur adalah kunci untuk menyelamatkan data.
Ketika sistem RAID mengalami kegagalan, beberapa menit pertama sangat kritis. Dalam apa yang disebut "jam emas" setelah kegagalan, sebagian besar kesalahan manusia terjadi, mengubah masalah yang dapat dipulihkan menjadi bencana yang tidak dapat diperbaiki. Mengganti disk secara membabi buta, melakukan restart terus-menerus, atau mencoba membangun kembali tanpa mengetahui apa yang salah biasanya merupakan jalan tercepat menuju kehilangan data total.
Mengapa pemulihan RAID begitu rumit?
Dalam banyak insiden kritis, kehilangan data bukan disebabkan oleh kegagalan perangkat keras awal, tetapi oleh tindakan tergesa-gesa yang dilakukan selama jam pertama . Periode ini sangat penting: disk mungkin berubah posisi, proses inisialisasi mungkin dimulai secara keliru, pembangunan ulang mungkin dipaksakan, atau sistem mungkin melakukan booting dari cadangan yang tidak lengkap pada susunan penyimpanan yang sama, dan apa yang dulunya merupakan masalah yang kompleks tetapi dapat dikelola menjadi teka-teki yang hampir mustahil.
Situasi risiko yang paling umum meliputi pertukaran disk dengan urutan yang salah (dalam RAID 0, 1, 5, 6, 10, dll.), mengganti kontroler dengan model lain tanpa mengkloning atau mendokumentasikan konfigurasi, memaksa disk "online" tanpa menganalisis keadaan sebenarnya, menginisialisasi volume yang salah, atau meluncurkan pembangunan ulang yang belum selesai dan selanjutnya merusak struktur internal array.
Yang juga sangat berbahaya adalah pemulihan cadangan langsung ke sistem yang rusak , migrasi penyimpanan tipe VMware Storage vMotion dengan array yang tidak stabil, dan operasi apa pun yang menulis metadata konfigurasi RAID baru ke disk dengan informasi yang berpotensi dapat dipulihkan.
Array RAID merupakan fondasi dari sebagian besar server fisik, NAS, dan sistem SAN, dan tidak selalu langsung jelas bahwa masalahnya berasal dari array itu sendiri. Oleh karena itu, jika ragu, tindakan paling bijaksana adalah menghentikan semua penulisan ke disk , mendokumentasikan situasi secara detail, dan meminta nasihat dari spesialis pemulihan data sebelum melakukan perubahan lebih lanjut.
Kesalahan umum manusia dan praktik baik dasar
Ketika sistem RAID memasuki kondisi terdegradasi, satu atau lebih disk mengalami kegagalan, atau NAS tidak dapat melakukan booting, reaksi naluriah biasanya adalah mencoba berbagai hal "sampai ada yang berhasil." Pendekatan ini hampir selalu berakhir memperburuk masalah karena setiap tindakan meninggalkan jejak pada disk dan dapat menimpa paritas, metadata, atau data pengguna yang masih utuh.
Di antara kesalahan yang paling sering terjadi dan mempersulit pemulihan adalah tindakan seperti mengkonfigurasi RAID baru menggunakan kontroler dan disk yang sama , memasukkan disk tersebut ke dalam enclosure penyimpanan yang berbeda untuk "melihat apakah sistem mengenalinya," atau mengubah urutan fisik slot drive. Dalam persentase kasus yang tinggi, tindakan ini menimpa konfigurasi asli, menghancurkan parity stripes, dan secara drastis mengurangi peluang keberhasilan.
Praktik buruk umum lainnya adalah gagal mencatat semua kejadian. Dalam skenario kegagalan yang kompleks, sangat penting untuk mencatat semua kejadian secara kronologis : pemadaman listrik, pesan sistem , perubahan disk, upaya pembangunan ulang, pembaruan firmware, dll. Informasi ini nantinya akan membantu teknisi spesialis untuk menyusun kepingan teka-teki tersebut.
Sama pentingnya untuk mendokumentasikan dan menyimpan posisi pasti setiap disk dalam array . Mengganti slot disk "secara asal-asalan" atau membuang disk yang dianggap rusak adalah tindakan ceroboh: jika RAID perlu dirakit ulang di laboratorium nanti, mengetahui disk mana yang berada di slot mana dan memiliki semua disk asli (bahkan yang diganti) dapat membuat perbedaan besar.
Sebagai aturan umum, jika terjadi kegagalan RAID, tindakan berikut harus dilakukan: matikan komputer, jangan melakukan konfigurasi ulang apa pun, beri label pada semua disk , kumpulkan informasi sebanyak mungkin tentang kejadian tersebut, dan, jika data tersebut penting, hubungi layanan pemulihan data profesional sebelum melanjutkan percobaan.
Bagaimana para profesional menangani pemulihan sistem RAID
Perusahaan yang mengkhususkan diri dalam pemulihan data RAID bekerja dengan prosedur yang sangat terstruktur karena setiap keputusan teknis harus meminimalkan risiko kerusakan lebih lanjut . Dalam kasus tipikal dengan banyak disk dan terabyte data yang dipertaruhkan, setiap langkah improvisasi dapat berakibat fatal.
Contoh nyata yang sangat menggambarkan situasi ini adalah susunan RAID dengan dua belas disk dan sekitar 12 TB data. Pencadangan data tidak dikelola dengan benar, sehingga satu-satunya solusi yang layak adalah menghubungi perusahaan pemulihan data RAID profesional . Situasinya mendesak; operasi perlu dilanjutkan sesegera mungkin, dan susunan tersebut telah mencapai kondisi kritis setelah dua disk gagal selama konfigurasi ulang.
Dalam skenario seperti itu, spesialis biasanya mulai dengan mengkloning semua disk yang berfungsi dan selalu bekerja pada salinan, bukan yang asli. Pada saat yang sama, mereka mencoba memperbaiki, sejauh mungkin, drive yang rusak secara fisik, baik melalui intervensi laboratorium (ruang bersih, penggantian head, elektronik donor, dll.) atau dengan teknik pembacaan parsial tingkat lanjut.
Dalam kasus hard drive 12 TB, masalah terbesar adalah konfigurasi ulang RAID telah dimulai sebelum kegagalan kedua , sehingga pengontrol telah sebagian menghitung ulang nilai paritas baru. Keuntungan relatifnya adalah hard disk kedua gagal pada tahap awal proses, sehingga sebagian besar struktur logis lama masih dapat dipulihkan.
Setelah memulihkan salah satu disk yang rusak dan membuat salinan lengkapnya, tantangannya adalah merekonstruksi struktur logis array secara manual : urutan disk, ukuran blok, distribusi paritas, kemungkinan perubahan di tengah proses… Pekerjaan ini, yang dapat memakan waktu beberapa hari analisis, memungkinkan kami untuk memulihkan sekitar 90% data, yang, mengingat keadaannya, dianggap sebagai tingkat keberhasilan yang tinggi dalam pemulihan RAID.
Layanan profesional: apa yang biasanya mereka tawarkan dan bagaimana cara kerjanya
Perusahaan yang mengkhususkan diri dalam pemulihan data RAID biasanya menawarkan diagnostik cepat dan gratis , terutama untuk server penting atau perangkat NAS produksi. Dalam beberapa kasus, mereka berkomitmen untuk menilai masalah dalam beberapa jam, memberikan laporan kelayakan dan penawaran harga tetap, serta mematuhi kebijakan "tidak ada pemulihan, tidak ada biaya".
Layanan tipikal dimulai ketika klien meminta penawaran gratis untuk memulihkan RAID mereka . Pada fase awal ini, informasi dikumpulkan tentang jenis array (RAID 0, 1, 5, 6, 10, JBOD, dll.), jumlah disk, sistem file (misalnya, ext4, Btrfs, XFS, HFS+, NTFS…), perangkat keras yang terlibat (Synology NAS, QNAP, server bermerek, array SAN…), dan deskripsi rinci tentang gejala dan tindakan yang telah diambil sejauh ini.
Setelah studi diterima, perusahaan biasanya mengatur pengambilan peralatan atau cakram secara gratis , dengan memberikan instruksi pengemasan yang tepat: gunakan pembungkus antistatik atau berlapis, tempatkan perangkat dalam kotak kaku dengan bahan penyerap guncangan, cegah cakram bergerak selama pengangkutan, dan beri label dengan jelas menggunakan nomor aplikasi.
Kembali ke laboratorium, teknisi melakukan diagnostik fisik dan logis pada setiap disk , membuat citra bit-per-bit jika memungkinkan, mengevaluasi kondisi sektor, dan memutuskan cara merekonstruksi RAID secara virtual. Baru kemudian penawaran akhir diberikan, termasuk perkiraan persentase data yang dapat dipulihkan dan perkiraan waktu penyelesaian.
Jika klien menyetujui, proses pemulihan sebenarnya dimulai. Setelah menstabilkan drive dan menyiapkan RAID di lingkungan yang terkontrol, para spesialis membuat daftar file yang dapat diakses. Sampai saat ini, klien biasanya belum membayar apa pun . Hanya jika daftar tersebut memuaskan, data disalin ke media penyimpanan baru (hard drive eksternal, NAS pengganti, dll.) dan dikirim kembali ke klien, hampir selalu termasuk biaya pengiriman.
Dasar-dasar: bagaimana cara kerja RAID dari dalam
Sederhananya, sistem RAID adalah sekumpulan disk fisik yang disajikan ke sistem operasi sebagai satu unit logis tunggal . Kuncinya terletak pada bagaimana data didistribusikan dan, berpotensi, paritas antar disk untuk mendapatkan peningkatan kinerja, kapasitas, toleransi kesalahan, atau kombinasi dari semuanya.
Teknologi RAID memungkinkan data didistribusikan dalam bentuk strip atau blok yang ditulis secara paralel di beberapa disk, mempercepat akses dengan menggabungkan transfer. Selain itu, data redundan (paritas) disimpan pada level tertentu untuk menghitung ulang data dari disk yang gagal tanpa gangguan layanan, asalkan batas kegagalan yang ditentukan dalam desain array tidak terlampaui.
Keunggulan penting lainnya adalah kemampuan untuk melakukan hot-swap disk pada banyak sistem. Ini berarti bahwa disk yang rusak dapat dilepas dan diganti secara fisik tanpa mematikan server atau array penyimpanan, memungkinkan pengontrol untuk merekonstruksi data yang hilang pada disk baru di latar belakang sementara sistem terus beroperasi.
Tidak ada satu pun "tingkat RAID sempurna" yang cocok untuk semua skenario. Setiap tingkat memprioritaskan keseimbangan yang berbeda antara kinerja, keamanan, dan kapasitas yang dapat digunakan . Oleh karena itu, sangat penting untuk memahami jenis RAID apa yang dikonfigurasi sebelum mencoba operasi perbaikan atau pemulihan apa pun.
Ketika terjadi kesalahan, RAID itu sendiri biasanya dapat merekonstruksi data jika toleransi kesalahan yang direncanakan terpenuhi. Namun, ketika beberapa masalah fisik, logis, atau kesalahan manusia terjadi secara berurutan, susunan RAID dapat kehilangan koherensi dan menjadi tidak mampu pulih sendiri, sehingga memerlukan intervensi ahli.
Tingkat RAID umum dan karakteristiknya
Setiap level RAID mengelola distribusi data dan paritas antar disk secara berbeda , sehingga menghasilkan perbedaan perilaku yang sangat jelas jika terjadi kegagalan. Memahami perbedaan ini membantu menilai risiko kegagalan yang sebenarnya dan kemungkinan keberhasilan pemulihan.
RAID 0, yang dikenal karena performanya yang tinggi, mendistribusikan data dalam bentuk strip di setidaknya dua disk tanpa menyimpan informasi redundan apa pun. Ini berarti bahwa hilangnya satu disk akan mengakibatkan hilangnya seluruh volume , karena bagian dari setiap file tersebar di semua drive. Keunggulan utamanya adalah kecepatan, tetapi dari perspektif keamanan data, RAID 0 sangat rentan.
RAID 1, atau mirroring, menyimpan salinan data yang identik pada dua disk . Jika salah satu gagal, yang lain akan terus beroperasi tanpa gangguan. Sistem ini sederhana, andal, dan menawarkan kecepatan baca yang baik, meskipun mengorbankan kapasitas yang dapat digunakan, karena ruang yang tersedia setara dengan kapasitas satu disk dalam pasangan tersebut. Dalam proses pemulihan, memiliki setidaknya satu disk yang utuh biasanya akan mempermudah segalanya.
Terdapat juga level RAID seperti RAID 3 dan RAID 4, yang kurang umum saat ini, yang menggabungkan disk data dengan disk paritas khusus . Pada RAID 3, akses ke disk data bersifat simultan, dan disk paritas menjadi potensi hambatan, sedangkan RAID 4 memungkinkan akses yang lebih independen ke setiap disk data, sehingga meningkatkan kinerja pada beban kerja tertentu.
RAID 5 mungkin merupakan konfigurasi RAID yang paling banyak digunakan di lingkungan server dan NAS. Konfigurasi ini mendistribusikan data dalam strip di beberapa disk dan menyisipkan blok paritas yang didistribusikan di antara semua drive , tanpa mendedikasikan satu disk secara eksklusif untuk fungsi tersebut. Konfigurasi ini memungkinkan pemulihan data pada disk pengganti jika salah satu disk gagal, asalkan kegagalan kedua tidak terjadi selama proses pemulihan.
RAID 6 meningkatkan keamanan lebih lanjut dengan menyimpan dua blok paritas untuk setiap set data , sehingga mampu menahan kegagalan simultan hingga dua disk tanpa kehilangan data. Hal ini membutuhkan kapasitas disk yang lebih besar untuk paritas dan daya komputasi yang lebih tinggi, tetapi sebagai imbalannya menawarkan margin kesalahan yang jauh lebih besar jika terjadi kegagalan berantai, fitur yang sangat berharga dalam susunan disk besar.
Selain level RAID "klasik" ini, terdapat kombinasi seperti RAID 10 (mirroring + striping), RAID 50 atau 60, dan konfigurasi linear atau JBOD, di mana disk hanya digabungkan untuk membentuk volume besar , tanpa redundansi sejati. Dalam semua kasus ini, RAID tidak menggantikan sistem pencadangan yang dirancang dengan baik.
Kegagalan sistem RAID yang umum terjadi dan kapan pemulihan menjadi rumit.
Sistem RAID memiliki reputasi sebagai sistem yang tangguh, dan memang demikian adanya, tetapi sistem ini tidak kebal terhadap masalah. Dalam praktiknya, kesalahan fisik, logis, dan manusia dapat terjadi , seringkali saling terkait dan menyebabkan situasi yang rumit dari perspektif pemulihan.
Dari sudut pandang logis, salah satu hambatan paling serius adalah hilangnya atau rusaknya strip paritas . Ketika metadata yang menunjukkan bagaimana data dan paritas didistribusikan di seluruh disk mengalami degradasi, RAID tidak lagi dapat meregenerasi informasi tersebut dengan sendirinya, dan intervensi eksternal diperlukan untuk menemukan dan membangun kembali strip ini secara manual atau semi-otomatis.
Terkait perangkat keras, statistik menunjukkan bahwa sebagian kecil disk dalam infrastruktur tertentu mungkin mengalami kegagalan fisik setiap tahunnya, sekitar 2-3%. Dalam susunan disk dengan banyak disk, ini berarti bahwa kemungkinan setidaknya satu disk mengalami kegagalan tidak dapat diabaikan. Kegagalan mekanis, lonjakan daya, firmware yang rusak, suhu ekstrem, atau komponen berkualitas rendah adalah penyebab umum kegagalan fisik.
Masalah akan semakin parah jika terjadi kegagalan kedua selama proses pembangunan ulang, terutama pada RAID 5 atau konfigurasi dengan banyak disk. Jika, saat sistem sedang meregenerasi data dari disk yang gagal, disk lain mulai mengalami kesalahan serius, array dapat berubah dari kondisi terdegradasi menjadi sama sekali tidak dapat diakses. Ketika lebih banyak disk yang gagal melebihi toleransi yang diharapkan , logika internal RAID tidak lagi memadai, dan teknik pemulihan tingkat lanjut harus digunakan.
Kesalahan manusia melengkapi keseluruhan masalah: menunda penggantian hard disk yang sudah memberikan peringatan, mengabaikan alarm pengontrol, mematikan sistem secara tidak benar saat terjadi pemadaman listrik berulang , memasang driver yang tidak memadai , memaksa restart terus-menerus, atau menerapkan prosedur pemeliharaan tanpa cadangan terbaru adalah praktik yang sangat meningkatkan risiko kehilangan data.
Penggunaan perangkat lunak khusus: contoh praktis dengan R-Studio
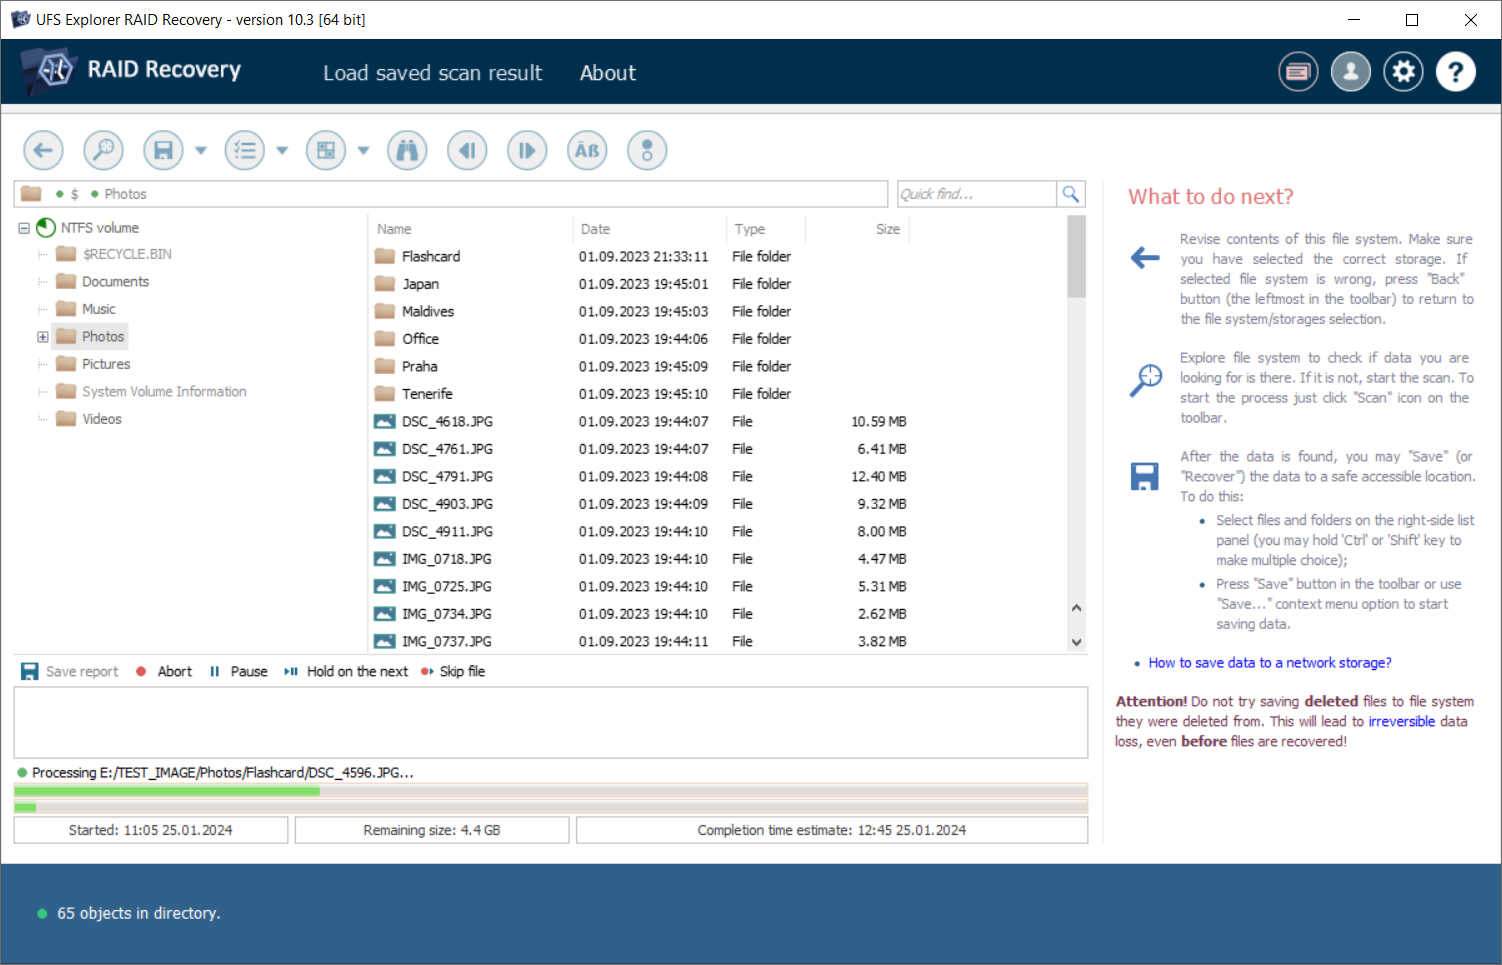
Ketika RAID tidak lagi dapat diakses melalui kontroler asli, salah satu opsi teknisnya adalah membangun kembali array secara virtual menggunakan perangkat lunak khusus . Alat seperti R-Studio memungkinkan Anda untuk mendeteksi RAID yang masih konsisten seolah-olah itu adalah volume normal, dan dalam kasus yang lebih serius, untuk membuat RAID virtual dari disk atau citra disk.
Prinsip kerjanya melibatkan pembuatan susunan RAID virtual berdasarkan disk fisik atau salinan citranya , dengan memasukkan parameter secara manual seperti jumlah disk, ukuran blok, offset awal, tipe RAID (0, 1, 4, 5, 6, 10, JBOD, ZFS RAIDZ, RAIDZ2, dll.), dan urutan disk. Setelah perangkat lunak mendeteksi sistem file yang valid, susunan RAID virtual ini akan ditampilkan sebagai volume yang dapat dinavigasi, di mana file dapat dicantumkan dan dipulihkan.
Sebagai contoh, untuk susunan RAID 5 sederhana dengan tiga disk, blok 64 KB, dan paritas kiri asinkron, Anda cukup memilih ketiga disk tersebut dalam urutan yang benar , menentukan ukuran blok, mengatur offset yang sesuai, dan membiarkan alat tersebut mengidentifikasi partisi. Dari situ, Anda dapat membuka volume, memeriksa folder, melihat pratinjau file (terutama yang berukuran besar), dan memverifikasi bahwa struktur telah dipasang dengan benar.
Pada konfigurasi yang lebih kompleks, seperti RAID 5 dengan blok 4KB dan pola paritas khusus, tabel urutan blok harus didefinisikan secara manual . Ini melibatkan memasukkan, baris demi baris, disk mana yang berisi setiap blok data atau paritas, memastikan urutannya konsisten. Perangkat lunak akan memberi tahu Anda ketika mendeteksi ketidakkonsistenan dalam tabel ini sehingga dapat diperbaiki sebelum menerapkan perubahan.
Penting untuk diperhatikan bahwa RAID virtual ini hanyalah objek logis dalam perangkat lunak : RAID virtual tidak menulis apa pun ke disk asli tempat ia dibuat. Hal ini memungkinkan Anda untuk bereksperimen dengan berbagai kombinasi parameter hingga menemukan kombinasi yang tepat untuk membangun kembali sistem file tanpa risiko kerusakan lebih lanjut.
Dalam kasus di mana disk fisik hilang, beberapa alat memungkinkan Anda untuk menggantinya dengan "disk yang hilang" atau blok ruang kosong, mensimulasikan perilaku RAID yang terdegradasi. Meskipun demikian, agar pemulihan file dapat diandalkan, semua parameter harus benar; satu ukuran blok yang salah atau offset yang salah hitung dapat merusak file yang diekstrak, oleh karena itu pentingnya keahlian teknis.
Jenis-jenis RAID dan perilakunya saat terjadi kehilangan data.
Di luar level RAID klasik, sistem RAID saat ini mendukung berbagai macam konfigurasi hibrida dan linier . Masing-masing menghadirkan tantangan tersendiri dalam hal pemulihan data setelah kegagalan kritis.
Dalam susunan RAID 0 (pure striping), data dipecah menjadi kelompok-kelompok kecil yang ditulis secara berurutan ke semua disk dalam susunan tersebut. Kapasitas total adalah jumlah dari semua drive, tetapi tidak ada redundansi dalam bentuk apa pun . Jika salah satu disk gagal, seluruh volume menjadi tidak dapat digunakan, dan satu-satunya opsi pemulihan melibatkan teknik canggih yang mencoba merekonstruksi apa yang dapat dilakukan dari disk yang masih berfungsi.
RAID 1 selalu mempertahankan salinan identik dari semua data pada setiap disk dalam mirror . Kesederhanaan ini merupakan keuntungan besar dalam proses pemulihan, karena jika salah satu disk tetap utuh, datanya dapat diakses langsung seolah-olah itu adalah disk independen, atau isinya dapat disalin ke drive baru dan mirror dibuat ulang kemudian.
Pada level RAID seperti RAID 4 dan RAID 5, di mana paritas didistribusikan secara berbeda, kapasitas yang dapat digunakan biasanya merupakan jumlah dari semua disk dikurangi kapasitas hanya satu disk. Kebutuhan untuk merekonstruksi data disk secara matematis dari paritas inilah yang mempersulit pemulihan ketika kegagalan terjadi secara berurutan dan lebih banyak disk yang hilang daripada yang diizinkan oleh desain.
Konfigurasi linier atau JBOD (Just a Bunch Of Disks) mengelompokkan beberapa disk dengan ukuran yang sama atau berbeda untuk membentuk satu unit logis yang lebih besar tanpa mendistribusikan data secara paralel. Konfigurasi ini tidak menawarkan peningkatan kinerja atau redundansi yang signifikan: jika ada disk yang gagal, akses ke seluruh volume akan hilang . Pemulihan dalam kasus ini melibatkan pengerjaan pada setiap disk dan merekonstruksi konten secara manual dari segmen yang tidak terpengaruh.
Semua skenario ini menyoroti bahwa, betapapun canggihnya teknologi penyimpanan, cadangan eksternal dan terverifikasi tetap penting . RAID mengurangi atau menghilangkan waktu henti jika terjadi kegagalan tertentu, tetapi tidak melindungi dari penghapusan yang tidak disengaja, kerusakan logis, serangan malware, atau kesalahan konfigurasi yang menghancurkan informasi pada tingkat sistem file.
Tips penting untuk meminimalkan risiko dan melindungi data Anda
Rekomendasi pertama, meskipun tampak jelas, adalah untuk mempertahankan kebijakan pencadangan rutin yang tidak bergantung pada RAID itu sendiri. Ini termasuk server, workstation, smartphone, sistem NAS, dan perangkat lain apa pun tempat data berharga disimpan. Hanya dengan cara ini, jika terjadi kegagalan serius, layanan dapat dipulihkan tanpa bergantung pada keberhasilan pemulihan forensik.
Jika insiden masih terjadi dan tidak ada cadangan yang dapat digunakan, tindakan paling bijaksana adalah menghindari upaya perbaikan sendiri tanpa pemahaman yang jelas tentang langkah-langkah dan potensi konsekuensinya. Sebelum menjalankan alat perbaikan sistem file, memulai pembangunan ulang otomatis, atau menukar drive antar slot, disarankan untuk berkonsultasi dengan spesialis pemulihan data dan menjelaskan situasinya kepada mereka secara detail.
Penting juga untuk memperhatikan tanda-tanda awal kegagalan : disk yang mulai menunjukkan sektor yang dialokasikan ulang, pengontrol yang menghasilkan peringatan, log sistem dengan peringatan I/O, susunan penyimpanan yang menandai susunan sebagai terdegradasi… Mengabaikan gejala-gejala ini karena kemalasan atau takut menghentikan layanan biasanya merupakan awal dari kegagalan yang jauh lebih serius dan mahal.
Terakhir, ketika data tersebut berharga, ada baiknya untuk mengidentifikasi penyedia pemulihan data tepercaya terlebih dahulu . Saat saatnya tiba, memiliki kontak langsung akan mempersingkat waktu respons, memungkinkan Anda menerima instruksi yang tepat sejak awal, dan meningkatkan kemungkinan memulihkan data sebanyak mungkin.
Pengalaman yang terkumpul dari berbagai kasus menunjukkan bahwa kombinasi desain RAID yang tepat, cadangan data yang andal, respons yang tenang terhadap kegagalan, dan dukungan spesialis saat dibutuhkan adalah hal yang benar-benar membedakan antara kepanikan yang terkendali dan kehilangan data yang dahsyat.