- Linux utilizza tutta la RAM disponibile per le cache e la cache di pagina, quindi avere poca memoria libera non significa necessariamente che ci sia un problema.
- La combinazione di swap, zram/zswap e un'impostazione corretta di vm.swappiness consente di bilanciare prestazioni e stabilità.
- cgroup v2, systemd-oomd e strumenti come earlyoom o nohang offrono un controllo preciso sulla pressione della memoria e sugli eventi di esaurimento della memoria (OOM).
- Il monitoraggio tramite strumenti come free, vmstat, htop, sar o Glances è fondamentale per individuare i colli di bottiglia e ottimizzare la gestione della memoria.
Se gestisci sistemi, lavori con i container o ti occupi della manutenzione di server di produzione, una conoscenza approfondita della gestione della memoria in Linux non è più un'opzione, ma una necessità. È ciò che fa la differenza tra un server che gestisce i picchi di carico senza problemi e uno che fatica, entra in modalità thrashing o finisce per attivare il temuto OOM killer nel momento peggiore.
Linux è progettato per utilizzare la RAM nel modo più efficiente possibile: memorizza i file nella cache, comprime le pagine, sposta i dati nello swap e assegna le priorità ai processi secondo politiche molto precise. Dall'esterno, potrebbe sembrare che "consumi molta memoria" o che "non ci sia mai RAM libera", ma in realtà sta cercando di offrire massime prestazioni e stabilità . Vediamo, passo dopo passo e con una spiegazione semplice, come funziona tutto questo e come è possibile ottimizzarlo in modo avanzato.
Concetti di base e falsi miti sulla memoria in Linux
Prima di armeggiare con i parametri del kernel o di montare zram a caso, è una buona idea avere alcune idee chiare sui tipi di memoria, l'architettura e il modo in cui il sistema vede la RAM.
La quantità massima di memoria fisica che un computer può gestire è determinata dal sistema operativo e dall'architettura del processore. Un sistema a 32 bit è in genere limitato a 4 GB di RAM, mentre un sistema a 64 bit può gestire facilmente decine o centinaia di gigabyte (teoricamente, molti di più, anche se il limite effettivo è imposto dall'hardware).
In Linux, tutta la memoria viene gestita come memoria virtuale . Ciò include sia la RAM fisica che lo spazio di swap. La RAM non può essere "estesa" se non aggiungendo moduli fisici, ma la memoria virtuale può essere espansa utilizzando il disco (partizioni o file di swap) e meccanismi avanzati come zram o zswap.
La memoria fisica (RAM) È la risorsa veloce e costosa: è lì che vengono caricati processi, librerie, cache di file, buffer di I/O, memoria condivisa, ecc. Linux ha una filosofia molto chiara: se c'è RAM libera, è meglio usarla come cache e velocizzare gli accessi piuttosto che lasciarla vuota. Ecco perché vedere poca memoria "libera" in strumenti come free Non significa che tu abbia un problema.
La memoria su disco ( memoria persistente) è molto più lenta. Mentre la RAM risponde in nanosecondi, persino un SSD risponde in microsecondi o millisecondi. Ecco perché il sistema cerca di mantenere i dati utilizzati più frequentemente nella RAM e ricorre al disco solo quando è assolutamente necessario: caricare file eseguibili, leggere dati poco utilizzati o scambiare pagine.
Memoria virtuale, pagine e strutture interne del kernel
La memoria virtuale è il meccanismo tramite il quale Linux fornisce a ciascun processo un proprio spazio di indirizzamento isolato e protetto . L'hardware e il kernel traducono gli indirizzi virtuali in indirizzi fisici attraverso strutture chiamate tabelle di pagine.
L'unità più piccola utilizzata per gestire la memoria è la pagina , in genere di 4 KB. L'intero sistema di memoria virtuale ruota attorno alle pagine: vengono allocate, liberate, scambiate, memorizzate nella cache e contrassegnate con diversi permessi (sola lettura, esecuzione, ecc.).
Le tabelle delle pagine sono strutture gerarchiche gestite dal kernel. Memorizzano, per ogni pagina virtuale di ciascun processo, la posizione della pagina fisica effettiva (se esiste), i suoi permessi e il suo stato corrente. Questa traduzione consente di isolare i processi, condividere le pagine tra di essi e mappare i file direttamente in memoria.
Quando un processo tenta di accedere a un indirizzo valido, ma la pagina non è pronta per l'accesso, si verifica un errore di pagina . Questo può essere lieve (la pagina è nella RAM ma in uno stato che richiede un aggiornamento) o oneroso (la pagina si trova su disco, nella memoria di swap o in un file e deve essere caricata nella RAM). Se gli errori di pagina diventano frequenti, il sistema rallenta perché impiega troppo tempo a leggere dal disco.
La cache di pagina è la cache delle pagine di file gestita dal kernel. Memorizza dati e metadati per file e directory al fine di ridurre gli accessi al disco. Questo è uno dei motivi per cui Linux "sembra" utilizzare tutta la RAM: in realtà, sfrutta la memoria che le applicazioni non stanno utilizzando attivamente per velocizzare l'accesso al disco.
Tipi di memoria: basata su file, anonima e il loro rapporto con lo swap
In Linux, si fa solitamente una distinzione tra memoria file e memoria anonima . Entrambe risiedono nella RAM, ma la loro origine e l'eventuale backup su disco sono differenti.
La chiamata memoria file È quello di cui vengono salvati i file di sistema: binari eseguibili, librerie condivise, dati mappati con mmap da un file, ecc. Tale memoria può essere scartata e ricaricata dal file originale se è necessario spazio.
La memoria anonima È tutto ciò che il processo riserva e che non è legato a un file: l'heap dinamico, lo stack, le regioni private con MAP_ANONYMOUSe le aree copiate tramite copy-on-write durante l'esecuzione fork()Questa memoria esiste solo nella RAM (o nello spazio di swap, se viene spostata) e il suo unico backup possibile è proprio quello spazio di swap.
Quando il kernel ha bisogno di liberare RAM, tenta innanzitutto di rilasciare le pagine che può riassemblare: in genere, pagine dalla cache delle pagine o da regioni basate su file. Solo quando non c'è più spazio o la pressione sulla memoria è molto elevata, inizia a spostare la memoria anonima nello swap , operazione molto più dispendiosa ma che alleggerisce il carico sul sistema.
Pressione della memoria, agitazione e killer OOM
La pressione sulla memoria si verifica quando il numero di pagine libere scende al di sotto di determinate soglie interne. Il kernel è quindi costretto a lavorare costantemente per liberare memoria: svuotando le cache, scrivendo le pagine modificate su disco, eliminando le pagine utilizzate raramente e così via.
Un elevato carico di memoria può produrre sintomi molto evidenti: latenza elevata nei servizi web , interfacce grafiche lente, risposte ritardate dalle sessioni remote (SSH, VNC, RDP), mouse scattoso, finestre che impiegano secondi a reagire, ecc. A quel punto, il sistema è più concentrato sulla sopravvivenza che sull'esecuzione di attività utili.
Il thrashing si verifica quando la RAM è insufficiente per contenere le pagine utilizzate costantemente dai processi. Il kernel inizia a scambiare continuamente le pagine: ne rimuove una per inserirne un'altra, ma poi ha immediatamente bisogno di quella appena rimossa. Il risultato è un ciclo di errori di pagina e accessi al disco che degrada le prestazioni.
Con lo swap abilitato, il thrashing consiste nello spostamento continuo di pagine anonime tra la RAM e lo spazio di swap, saturando il disco. Senza swap, il problema si sposta sulle pagine dei file: queste vengono scartate e ricaricate ripetutamente dal file system, il che può rendere la macchina praticamente inutilizzabile.
Se il kernel non riesce ancora a ottenere memoria libera, si verifica quanto segue: Meccanismo Out-of-Memory (OOM)Quando tutto ciò che può essere eliminato, compattato o scambiato è esaurito, il kernel calcola un punteggio per ogni processo (oom_scoree decide quale sacrificare. Tale processo viene completato dal OOM killer per liberare una quantità significativa di RAM ed evitare un arresto anomalo totale.
Swap: cos'è, quanto metterne e perché non è "il diavolo"
La memoria di swap ha una cattiva reputazione, in parte a causa di consigli obsoleti e semplificazioni eccessive come "se hai molta RAM non hai bisogno dello swap". In realtà, lo spazio di swap è una componente chiave della progettazione della memoria in Linux, anche su sistemi con molta RAM.
Lo swap è un'area del disco (partizione o file) che il kernel utilizza per memorizzare pagine di memoria inattive . Questo gli consente di liberare RAM per i processi che ne hanno effettivamente bisogno. Non si tratta di memoria virtuale in sé, ma di uno dei meccanismi che rendono possibile questo processo.
Senza swap, le pagine anonime non hanno un posto dove andare quando la pressione sulla memoria aumenta. Il kernel può ancora fare affidamento sulle cache e sulle pagine basate su file, ma non appena la memoria anonima raggiunge livelli critici, è praticamente costretto ad attivare il killer OOM molto prima. Tecnicamente, Linux può funzionare senza swap, ma in pratica, nella maggior parte dei casi, rappresenta un rischio inutile.
Quando si tratta di dimensionare lo spazio di swap, non esiste una formula univoca, ma ci sono alcuni criteri moderni piuttosto ragionevoli a seconda del ruolo della macchina:
- Server senza ibernazione4-8 GB di spazio di swap sono generalmente sufficienti come buffer, anche con molta RAM. Per i servizi che richiedono molta memoria (database, virtualizzazione), è possibile aumentarlo fino a 1,5 volte la RAM, ma la priorità dovrebbe essere l'incremento della RAM fisica.
- Desktop senza ibernazioneCon 16 GB o più di RAM, 2-4 GB di swap sono più che sufficienti come rete di sicurezza.
- dispositivi con funzione di ibernazione abilitataLo spazio di swap deve essere uguale o leggermente superiore alla RAM, perché il sistema vi trasferisce tutto il contenuto della memoria durante l'ibernazione.
La creazione di spazio di swap è molto flessibile. È possibile utilizzare una partizione dedicata o un file di swap . Un file di swap è ideale quando il disco è già partizionato o quando si desidera regolarne le dimensioni senza riconfigurare l'intero sistema.
Metriche della memoria: free, vmstat, ps, RSS, PSS e altro ancora
Gli strumenti classici di gestione della memoria di Linux possono portare a interpretazioni errate se non si conosce il significato di ciascuna colonna. Il comando free -h È il modo più semplice per visualizzare a colpo d'occhio la memoria totale, la memoria utilizzata, la memoria libera, la cache e lo swap.
All'uscita di free È fondamentale guardare la riga che deduce buffer e cache, perché quella colonna indica il memoria effettivamente occupata dai processisenza contare ciò che il kernel utilizza come cache e che può rilasciare rapidamente se necessario.
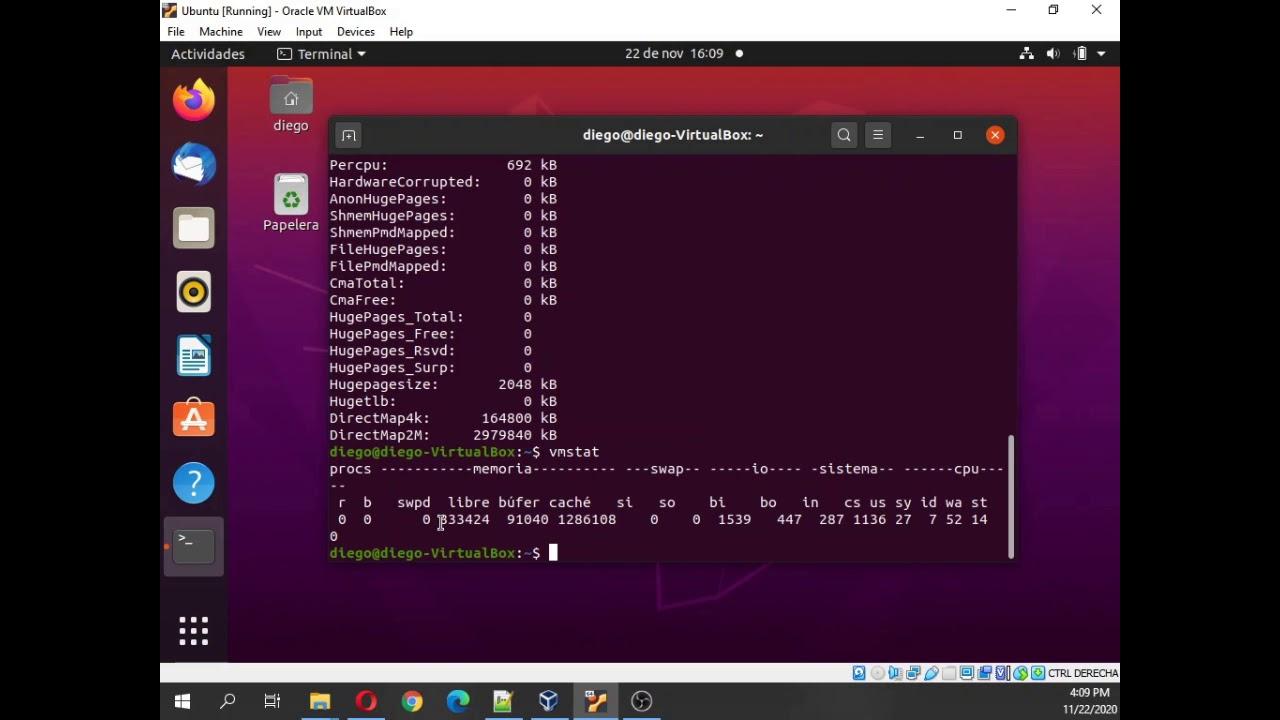
Con vmstat -s -S M Si ottiene un riepilogo più dettagliato: memoria totale, memoria utilizzata, memoria libera, memoria attiva, memoria inattiva, cache di swap, ecc. È anche possibile consultare /proc/meminfo per visualizzare ogni parametro in dettaglio, sebbene l'output sia più arido e meno intuitivo.
Per scoprire quali processi influenzano maggiormente la RAM, ps aux visualizza colonne come VSZ (memoria virtuale totale che il processo potrebbe utilizzare se caricasse tutto) e RSS (Resident Set Size, memoria effettiva attualmente presente nella RAM). Nota: RSS include anche la memoria della libreria condivisa, che viene conteggiata più volte se utilizzata da più processi.
Qui entra in gioco PSS (Dimensione del set proporzionale)che distribuisce il costo delle librerie condivise tra i processi che le utilizzano. Per ottenere PSS facilmente, esistono strumenti come smem, molto utile per vedere quali applicazioni sono realmente "divoratrici di dati" senza distorcere i dati a causa di librerie condivise.
Frammentazione della memoria, stack, heap e ulimit
Un altro aspetto meno visibile della gestione della memoria è la frammentazione . Possiamo parlare di frammentazione interna (quando i blocchi arrotondati vengono allocati in multipli di 4, 8 o 16 byte, lasciando una porzione inutilizzabile) e di frammentazione esterna (quando la memoria libera esiste ma è divisa in piccoli pezzi che impediscono l'utilizzo di un'unica grande allocazione contigua).
In applicazioni come Redis, a volte si notano differenze tra la memoria segnalata dal sistema (RSS) e la memoria che l'app stessa considera utile (used_memory). Questa distanza è solitamente dovuta in gran parte a frammentazione esterna, spazi vuoti che il sistema considera occupati ma che il processo in realtà non utilizza.
La memoria di un processo è concettualmente divisa in pila e mucchioLo stack viene utilizzato per le variabili locali e le chiamate di funzione, mentre l'heap viene utilizzato per le allocazioni dinamiche. malloc() e simili. Quando le strutture dati crescono oltre la capacità dello stack, vengono prelevate dall'heap e gestite tramite puntatori.
La dimensione massima dello stack per processo può essere regolata con ulimit -a e configurazioni di sistema. Riducendolo si limita il numero di variabili locali di grandi dimensioni, mentre aumentandolo si possono utilizzare più variabili o una ricorsione profonda. La regolazione di questo parametro può aiutare a controllare meglio l'utilizzo della memoria e a ridurre alcuni tipi di frammentazione, sebbene non sia una soluzione universale.
Monitoraggio e diagnostica avanzati: top, htop, vmstat, sar e altro ancora.
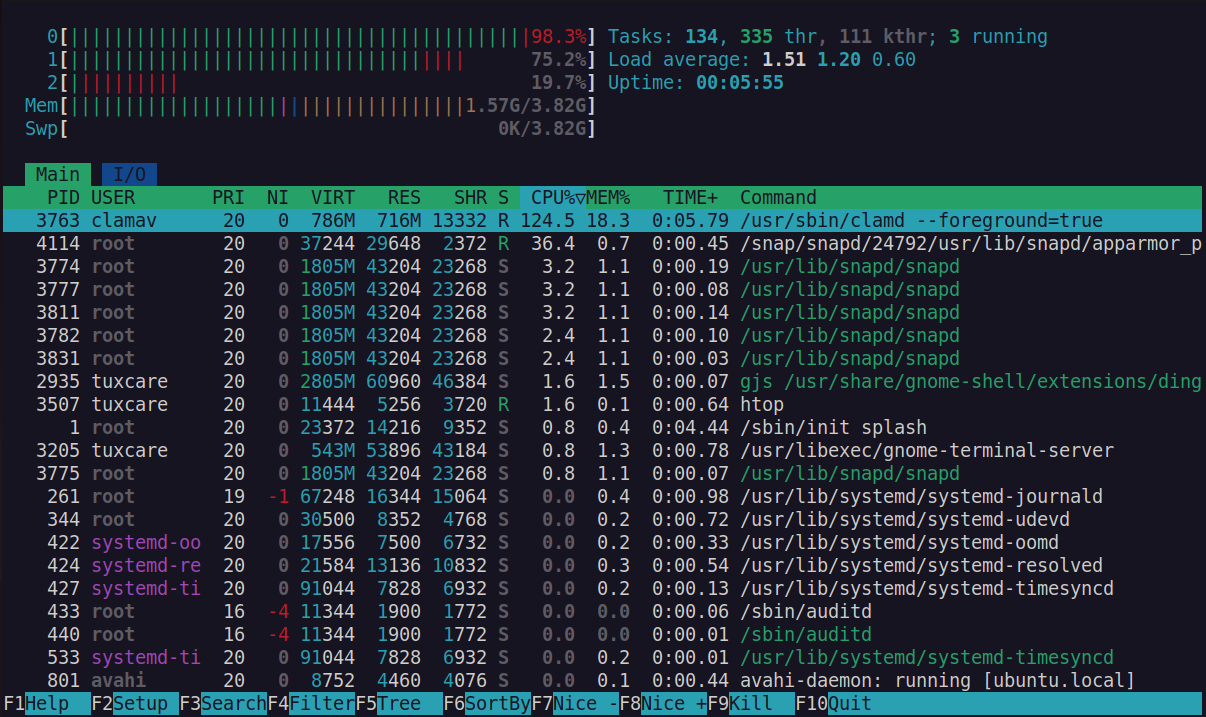
Per individuare i processi che consumano RAM, puoi iniziare con top E se desideri qualcosa di più intuitivo, con htopQuest'ultima visualizza le barre di utilizzo di CPU, memoria e swap e consente l'ordinamento e il filtraggio interattivo dei processi.
In Debian e derivati, installare htop con sudo apt install htopIn AlmaLinux e altri sistemi simili a Red Hat, con sudo dnf install htopUna volta effettuato l'accesso, è possibile ordinare i file in base alla memoria utilizzata, cercare processi specifici e terminare le attività problematiche direttamente dall'interfaccia.
Per analisi più approfondite ed elaborazione in batch, vmstat 5 Fornisce informazioni regolari su processi, memoria, paginazione, I/O a blocchi, interruzioni e pianificazione della CPU. È ideale per osservare come si evolve la pressione sulla memoria nel tempo.
seguente sysstat Incorpora strumenti come sarche consentono di registrare e analizzare l'utilizzo della memoria e di altre risorse. Ad esempio, sar -r 1 5 Visualizza l'utilizzo della memoria e dello swap ogni secondo, cinque volte. Su Debian è installato con sudo apt install sysstate in AlmaLinux con sudo dnf install sysstat.
Se hai bisogno di un debug approfondito a livello di kernel, bpftrace È un potente strumento basato su eBPF. Consente di strumentare le chiamate di sistema, osservare l'accesso alla memoria e rilevare i colli di bottiglia senza ricompilare o riavviare. In genere viene installato con sudo apt install bpftrace sui sistemi di tipo Debian.
Gestione pratica della memoria: swap, swappiness e pulizia della cache.
Un compito fondamentale su molti server è controllare il stato attuale dello scambio. Con swapon --show Hai a disposizione un elenco di dispositivi e file di swap attivi, con le relative dimensioni, tipo e priorità. Se devi aggiungere swap al volo, puoi creare un file con fallocate, ottenere permessi con chmod 600, formattalo con mkswap e attivarlo con swaponPer renderlo permanente, è sufficiente aggiungere la voce corrispondente a /etc/fstab.
Parametro vm.swappiness Questo parametro controlla la priorità con cui il kernel utilizza lo swap rispetto al continuo riempimento della RAM. Il suo valore va da 0 a 100. Valori bassi (10-20) inducono il sistema a evitare lo swap finché non sia assolutamente necessario, mentre valori alti (60 o superiori) incoraggiano il sistema a spostare più facilmente le pagine nello swap per mantenere la RAM libera.
Sui server con dischi lenti o database di grandi dimensioni, è spesso di interesse abbassare il prezzo di scambioAd esempio, fino a 10 o 20, con sudo sysctl vm.swappiness=10Per i computer desktop con ZRAM veloce o SSD, valori intermedi come 30-60 possono fornire un buon compromesso tra latenza e utilizzo della memoria.
In situazioni di memoria discreta, a volte è necessario forzare la rilascio della cache con sudo sync && sudo sysctl -w vm.drop_caches=3Questa operazione svuota gran parte della cache delle pagine e dei dentries. Può essere utile occasionalmente per eseguire test o liberare memoria su sistemi con risorse molto limitate, ma non dovrebbe essere utilizzata regolarmente perché si perde anche il miglioramento delle prestazioni offerto dalla cache.
Strumenti di controllo avanzati: cgroup v2, memory.pressure e OOM nello spazio utente
Nei sistemi moderni che utilizzano systemd e cgroup v2 , la gestione della memoria può essere ottimizzata per gruppi di processi. cgroup v2 organizza i task in gerarchie e applica limiti e priorità alle risorse (CPU, memoria, I/O) a livello di gruppo, non solo a livello di singolo processo.
All'interno della gerarchia di memoria, parametri quali memory.low Consentono di indicare che la memoria di determinati cgroup deve essere maggiormente protetta dalla pressione globale, mentre altre possono essere più facilmente sacrificabili qualora sia necessario liberare RAM.
Il file memory.pressure Espone metriche molto utili: per quanto tempo le attività in quel cgroup sono state bloccate a causa della mancanza di memoria, in intervalli di 10, 60 e 300 secondi. La variante alcuni Indica se almeno un'attività è stata ritardata e pieno Riflette i momenti in cui tutti i compiti del gruppo sono stati contemporaneamente compromessi.
Oltre al killer OOM del kernel, sono emerse soluzioni a livello di spazio utente come presto, nohang o systemd-oomdEarlyOOM monitora la RAM e lo swap e, quando scendono al di sotto di determinate soglie, termina proattivamente i processi. oom_score più alto, ripristinando l'usabilità prima che la macchina si blocchi.
NoHang fa un ulteriore passo avanti: supporta più criteri di selezione , può tenere conto della pressione sulla memoria e si integra bene con configurazioni avanzate, sebbene il suo sviluppo abbia avuto alti e bassi. Nel frattempo, systemd-oomd si integra direttamente con systemd e cgroup v2 ed è attualmente l'opzione preferita in molte distribuzioni per gestire le situazioni di scarsa memoria in modo più intelligente e granulare.
Modern Swap: zram, zswap e priorità dei dispositivi
Oltre al classico swapping del disco, Linux offre meccanismi moderni che migliorano notevolmente le prestazioni combinando la compressione della RAM e l'utilizzo selettivo del disco.
zram è un modulo del kernel che crea dispositivi a blocchi nella RAM stessa, dove le pagine vengono memorizzate in uno stato compresso. Questi vengono tipicamente utilizzati come dispositivi di swap ultraveloci: la compressione e la decompressione consumano parte della CPU, ma si guadagna capacità di memoria logica e si riduce drasticamente l'utilizzo del disco.
In molte distribuzioni è sufficiente installare zram-tools o zram-generator e abilitarne il servizio. Ad esempio, in Debian puoi usare sudo apt install zram-tools e attivare zramswap con systemd. In AlmaLinux, con sudo dnf install zram-generator e il relativo servizio.
zswap , d'altro canto, funziona come una cache compressa davanti all'area di swap del disco . Inizialmente tenta di memorizzare le pagine scambiate nella RAM compressa; solo quando questa cache è piena o le pagine diventano inattive, scrive nell'area di swap vera e propria. Ciò riduce le operazioni di I/O del disco e prolunga la durata degli SSD, a costo di un certo utilizzo della CPU.
Quando si combinano più dispositivi di swap (ad esempio, zram e un file su disco), è fondamentale regolare il priorità. Con swapon -p o opzione pri= en /etc/fstab Si specifica quale dispositivo deve essere utilizzato per primo. La prassi comune è quella di assegnare una priorità elevata (ad esempio, 100) a zram e una priorità inferiore (10) allo swap su disco, in modo che il kernel sfrutti appieno lo spazio di swap compresso nella RAM prima di accedere al disco.
Gestione della memoria applicata ai server: swap, servizi e sicurezza.
Nei server web (Apache, Nginx), nei database (MySQL, MariaDB, MongoDB) o nelle applicazioni che richiedono molte risorse, la memoria è la risorsa critica. La configurazione della RAM e dello swap determina direttamente quante richieste simultanee è possibile gestire prima che il sistema inizi a rallentare.
Nel caso di motori di database come MongoDB, è fondamentale che la RAM fisica superi i requisiti del database ; altrimenti, inizierà a utilizzare lo spazio di swap e le prestazioni crolleranno a causa della notevole differenza tra l'accesso alla RAM e l'accesso al disco. Lo stesso vale per MySQL/MariaDB, dove strumenti come MySQLTuner consigliano parametri di memoria in base alla RAM disponibile.
Per evitare di sprecare memoria, è consigliabile interrompere i servizi non utilizzati ed eliminare container, immagini e volumi Docker non più necessari. Negli ambienti di sviluppo e di controllo qualità, è molto facile accumulare risorse dimenticate che rubano gigabyte di RAM e spazio su disco senza che nessuno se ne accorga.
Anche la sicurezza gioca un ruolo importante: porte non necessarie aperte Aumentano la superficie di attacco. Il malware che riesce a infiltrarsi in un sistema può, ad esempio, avviare processi di mining che consumano CPU e memoria, pianificare attività in crontab e mandare in crash il sistema. Controllare le porte in entrata e in uscita, chiudere tutto ciò che non è essenziale e ripulire i processi cron sospetti fanno parte della pulizia di base del sistema, che protegge anche le risorse di memoria.
Memoria e file system: ext4, XFS, Btrfs e journaling
Sebbene possa sembrare una questione a sé stante, la scelta del file system e la sua configurazione influenzano anche il comportamento della memoria e il carico di I/O. Ext4, ad esempio, utilizza un journal che, a seconda del carico, può esercitare una pressione aggiuntiva sul disco e, di conseguenza, sulla gestione della cache.
Negli ambienti server più esigenti, molti amministratori optano per XFS o persino Btrfs . XFS in genere offre prestazioni eccellenti con file di grandi dimensioni e sistemi ad alte prestazioni. Btrfs offre funzionalità avanzate come snapshot, compressione trasparente e sottovolumi, a costo di una maggiore complessità e, a seconda della versione e della distribuzione, di un livello di maturità ancora oggetto di dibattito per tutti i carichi di lavoro.
Il kernel adatta la sua politica di caching e di scrittura differita alle caratteristiche del file system, quindi il passaggio da ext4 a XFS o Btrfs non influisce solo sull'I/O grezzo, ma anche sul modo in cui la RAM e la cache di pagina vengono utilizzate per memorizzare temporaneamente le operazioni di lettura e scrittura.
Strumenti e utilità grafiche essenziali per gli amministratori
Sebbene il terminale rimanga il coltellino svizzero di ogni amministratore di sistema, esistono strumenti che semplificano notevolmente la gestione della memoria e delle risorse . Uno di questi è Glances , un monitor in tempo reale che visualizza CPU, memoria, disco, rete e processi su un'unica schermata, con un'interfaccia web opzionale per il monitoraggio di più server tramite browser.
Per un'installazione rapida su Debian, è sufficiente... sudo apt install glancesGli sguardi si abbinano molto bene con htop, vmstat y sar, fornendo una panoramica più visiva del comportamento del sistema sotto carico.
Nell'ambito dell'amministrazione grafica dei server, Cockpit offre un'interfaccia web intuitiva per il monitoraggio di memoria, processi e servizi . Consente di gestire più server da un'unica console, avviare e arrestare le unità systemd, monitorare l'utilizzo di swap e zram e consultare i log senza uscire dal browser.
Sui sistemi desktop, molte distribuzioni integrano un proprio monitor delle risorse, ma per gli ambienti privi di interfaccia grafica o dove si desidera qualcosa di leggero, la combinazione di questi strumenti da riga di comando con script personalizzati offre un'eccellente visibilità su ciò che sta accadendo alla memoria in un dato momento.
Una corretta gestione della memoria in Linux implica la comprensione di come il kernel utilizza la RAM, dei ruoli di swap, zram e zswap, di come cgroup v2 e i vari OOM (Out Of Memory) reagiscono alla pressione e degli strumenti disponibili per monitorare e ottimizzare il sistema. Quando si mettono insieme tutti questi elementi – da free, vmstat, PSS e memory.pressure a zram, swappiness e systemd-oomd – si smette di lottare con il problema "Linux che consuma RAM" e si inizia ad avere un sistema stabile e ottimizzato, in grado di massimizzare le prestazioni hardware in qualsiasi contesto: server, desktop o ambiente ad alto carico.

Indice
- 1 Concetti di base e falsi miti sulla memoria in Linux
- 2 Memoria virtuale, pagine e strutture interne del kernel
- 3 Tipi di memoria: basata su file, anonima e il loro rapporto con lo swap
- 4 Pressione della memoria, agitazione e killer OOM
- 5 Swap: cos'è, quanto metterne e perché non è "il diavolo"
- 6 Metriche della memoria: free, vmstat, ps, RSS, PSS e altro ancora
- 7 Frammentazione della memoria, stack, heap e ulimit
- 8 Monitoraggio e diagnostica avanzati: top, htop, vmstat, sar e altro ancora.
- 9 Gestione pratica della memoria: swap, swappiness e pulizia della cache.
- 10 Strumenti di controllo avanzati: cgroup v2, memory.pressure e OOM nello spazio utente
- 11 Modern Swap: zram, zswap e priorità dei dispositivi
- 12 Gestione della memoria applicata ai server: swap, servizi e sicurezza.
- 13 Memoria e file system: ext4, XFS, Btrfs e journaling
- 14 Strumenti e utilità grafiche essenziali per gli amministratori