- Ollama מאפשר לך להריץ מודלים של שפה מתקדמים באופן מקומי, מה שמבטיח פרטיות ותפעול מוחלטים ללא אינטרנט.
- הביצועים תלויים ישירות בחומרה, כאשר זיכרון ה-VRAM של הכרטיס הגרפי הוא הגורם הקריטי למהירות התגובה.
- הכלי מציע ממשק API תואם ל-OpenAI ויכולת ליצור מודלים מותאמים אישית באמצעות Modelfiles.
אתם כנראה כבר מכירים כלים כמו ChatGPT, Claude או Gemini. למרות שהם מדהימים, יש מלכוד: הם פועלים בענן. משמעות הדבר היא שכל מילה שאתם מקלידים מגיעה לשרתים של חברה, מה שיכול להוות סיכון פרטיות חמור אם אתם מטפלים במידע רגיש או עובדים במגזרים שבהם החוק אוסר על יציאת מידע מהמשרד.
כאן נכנסת לתמונה Ollama, אפליקציה שהופכת את המחשב שלכם למרכז העצבים של הבינה המלאכותית . שכחו ממנויים חודשיים ומהסתמכות על חיבור אינטרנט יציב; בעזרת כלי זה, תוכלו להוריד מודלים בקוד פתוח ולהריץ אותם ישירות על החומרה שלכם, תוך שמירה על שליטה מלאה על הנתונים שלכם.
מה זה בעצם אולמה ומהם יתרונותיו?
Ollama היא תוכנה בקוד פתוח המשמשת כלקוח לניהול מודלים של שפה גדולה (LLM). היתרון העיקרי שלה הוא שהיא מפשטת את המורכבות הטכנית , מטפלת באופטימיזציה של GPU וניהול זיכרון, כך שצריך רק לבצע פקודה ולהתחיל לשוחח.
היתרונות ברורים. ראשית, הפרטיות מוחלטת מכיוון ששום דבר לא יוצא מהמחשב שלך. שנית, אתה חוסך בעלויות טוקנים של API או בתשלומים החודשיים עבור תוכניות Plus. ושלישית, ברגע שהתבנית נמצאת בכונן הקשיח שלך, אתה יכול להשתמש בה במצב לא מקוון לחלוטין , אידיאלי כשאתה במטוס או במקומות עם כיסוי רשת גרוע.
עם זאת, לא הכל שמש וקשת בענן. החיסרון העיקרי הוא שאתם זקוקים לחומרה חזקה . אם תנסו להריץ דגם ענק על מחשב עם מעט זיכרון RAM, התגובה תהיה כל כך איטית שתספיקו להכין קפה לפני שהוא יסיים את המשפט שלו. יתר על כן, הבינה המלאכותית יודעת רק מה למדה עד לתאריך האימון שלה, כך שאין לה גישה לחדשות מתפרצות בזמן אמת.
דרישות מערכת וחומרה מומלצת
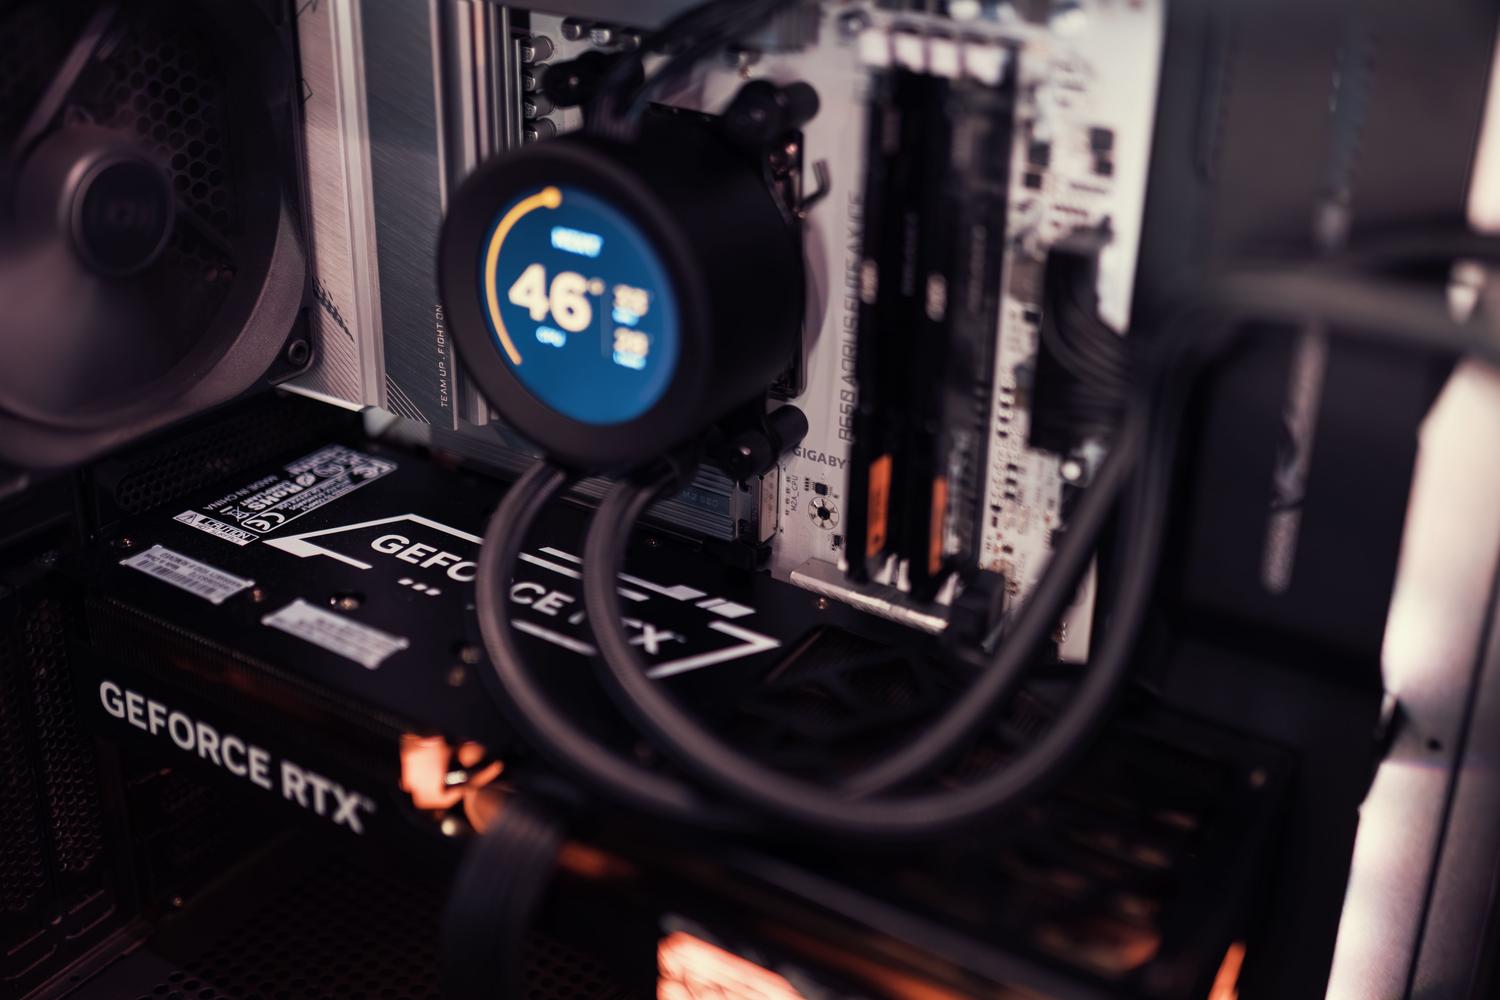
כדי להימנע מחוויה מתסכלת, כדאי לבדוק את הרכיבים שלכם. המשאב החשוב ביותר הוא זיכרון ה-RAM וה-VRAM של כרטיס המסך שלכם . ככלל, דגם של 1.5B תופס כ-1GB של מקום, אך הוא זקוק ליותר זיכרון כדי לפעול בצורה חלקה.
- דגמי מיני (270M עד 4B): אידיאלי לציוד צנוע או נייד.
- דגמים קטנים (4B עד 14B): האפשרות המאוזנת למשתמש ביתי.
- דגמים בינוניים (14B עד 70B): כאן אתה צריך חומרה רצינית.
- דגמים גדולים (מעל 70B): רק למכונות עם משאבים עצומים.
לגבי המעבד הגרפי (GPU), כרטיס מסך של NVIDIA עם CUDA, כרטיס מסך של AMD עם ROCm, או Mac עם Apple Metal עושים הבדל עצום, ומאיצים את יצירת הטקסט פי 5 עד 10 בהשוואה לשימוש במעבד בלבד. אם אתם מתכוונים לקנות ציוד, חפשו כרטיסי מסך עם לפחות 16GB של VRAM כדי שלא ייגמר לכם מהר.
מדריך התקנה שלב אחר שלב
התקנת Ollama היא פשוטה באופן מפתיע וניתן לבצע אותה תוך דקות ספורות, תלוי במערכת ההפעלה בה אתם משתמשים:
ב- Windows , פשוט הורידו את קובץ ה-.exe מהאתר הרשמי. הוא בדרך כלל יותקן בתיקיית AppData של המשתמש. עבור אלו המעדיפים קונטיינרים, ניתן גם לפרוס אותו באמצעות Docker Desktop על ידי הפעלת פקודת ההתקנה הרשמית בטרמינל.
למשתמשים ב- לינוקסהדרך המהירה ביותר היא להשתמש בטרמינל עם הפקודה curl -fsSL https://ollama.com/install.sh | shלאחר ההתקנה, השירות בדרך כלל פועל ברקע. אם עליך לשנות את מיקום האחסון של המודלים כדי למנוע מילוי הדיסק הראשי, תוכל לערוך את משתנה הסביבה. דגמי_תנור בקובץ התצורה של שירות systemd.
En MacOSההתקנה פשוטה באמצעות תוכנת ההתקנה שהורדת או אפילו באמצעות brew install ollamaהמערכת תנצל באופן אוטומטי את ה- האצת מתכת של שבבי הסיליקון של אפל.
כיצד לנהל ולהפעיל מודלים של בינה מלאכותית
ברגע ששרת אולמה פעיל (תראו אותו בסמל בשורת המשימות), תוכלו להתחיל להוריד מודלים. הפקודה הבסיסית היא ollama pull [nombre-del-modelo]למרות שאם אתה משתמש ollama run, המערכת יוריד את המודל באופן אוטומטי אם עדיין אין לך אותו.
ישנן קטגוריות שונות של דגמים בהתאם לצרכים שלכם:
- שיחה: לאמה 3 או מיסטרל הם המלכים כאן בגלל האיזון שלהם בין איכות למהירות.
- תִכנוּת: CodeLlama או DeepSeek-Coder אידיאליים לאיתור שגיאות קוד או יצירת פונקציות.
- רב-מודאלי (ראייה): מודלים כמו LLaVA מאפשרים לך להעלות תמונות ולבקש מבינה מלאכותית לתאר אותן.
- חשיבה (היגיון): מודלים שנועדו להסביר תהליכים שלב אחר שלב.
כדי לקיים אינטראקציה, פשוט השתמשו ollama run llama3 ותזינו הנחיה אינטראקטיבית. בתוך סשן זה, תוכלו להשתמש בפקודות כגון /? לעזרה או /bye כדי לצאת. אם ברצונך לראות מה התקנת, ollama list זה ייתן לך את הרשימה המלאה, ועם ollama ps אתה יכול לבדוק אם המודל הוא טעון על גבי ה-GPU או ה-CPU.
הגדרות מתקדמות והתאמה אישית
אם אתם מפתחים, Ollama הוא מכרה זהב מכיוון שהוא חושף REST API בפורט 11434. זה מאפשר לכם לחבר בינה מלאכותית מקומית לכל יישום. הוא תואם לפורמט OpenAI, כך שתוכלו לשלב אותו ב-VS Code דרך GitHub Copilot (באמצעות אפשרות BYOK) או להשתמש בסוכנים כמו OpenCode.
תכונה עוצמתית נוספת היא Modelfile . היא דומה ל-Dockerfile אך מיועדת לבינה מלאכותית. היא מאפשרת לך ליצור גרסה מותאמת אישית של מודל על ידי הגדרת שורת מערכת ספציפית (לדוגמה, הפיכת Llama למומחה במשפט ספרדי), התאמת הטמפרטורה כדי להפוך אותה ליצירתית או מדויקת יותר, ושמירת התצורה תחת שם מותאם אישית.
עבור אלו המחפשים ממשק ויזואלי הדומה יותר ל-ChatGPT, אנו ממליצים להתקין את Open WebUI . הוא מתחבר ל-Ollama כשרת צד-שרת ומספק חוויית אינטרנט מלאה עם היסטוריית צ'אט וניהול מסמכים, כולם פועלים ברשת המקומית שלכם.
טיפים לאופטימיזציה וביצועים
כאשר מבחינים שהבינה המלאכותית פועלת לאט, הצעד הראשון הוא לבדוק את הכימות . תהליך זה מפחית את דיוק המשקלים של המודל (מ-16 סיביות ל-4 או 8 סיביות, לדוגמה), מה שמקטין באופן דרסטי את כמות ה-RAM הנדרשת מבלי להתפשר על איכות רבה מדי. מודל Q4_K_M הוא בדרך כלל הנקודה המתוקה בין ביצועים לדיוק.
כדי למנוע מ-Ollama לצרוך משאבים כאשר אינו בשימוש, ניתן להשבית את ההפעלה האוטומטית במנהל המשימות של Windows. כמו כן, כדאי לנטר את השימוש ב-VRAM בזמן אמת כדי לקבוע אם המודל מוריד עומס מזיכרון המערכת, מה שמאט משמעותית את הביצועים.
שליטה על התשתית המקומית מאפשרת דמוקרטיזציה של השימוש בבינה מלאכותית, מבטלת את המחסומים הכלכליים של מנויים ואת סיכוני האבטחה של הענן. על ידי שילוב העוצמה של מודלים כמו Llama 3 או Mistral עם קלות הניהול של Ollama, כל חובב או חברה יכולים לבנות מערכת אקולוגית פרטית משלהם של בינה מלאכותית , תוך אופטימיזציה של החומרה הזמינה והתאמה אישית של התנהגות המודל באמצעות Modelfiles ו-APIs משולבים.