- מערכות RAID משפרות ביצועים וזמינות, אך הן אינן מחליפות גיבויים ואינן חסינות מפני כשלים פיזיים, לוגיים או אנושיים.
- רעשים מוזרים, מצב מדורדר, איטיות חריגה ושגיאות זוגיות או קריאה/כתיבה הם סימנים ברורים לבעיות קרבות ב-RAID.
- כפיית שיפוץ, סידור מחדש של דיסקים ללא תיעוד או שימוש בכלי תיקון גנריים יכולים להפוך כשל שניתן לנהל לאובדן נתונים מוחלט.
- פעולה זהירה וממוקדת, יחד עם תמיכה של מומחי שחזור RAID, מגדילה מאוד את הסיכויים להצלת המידע.
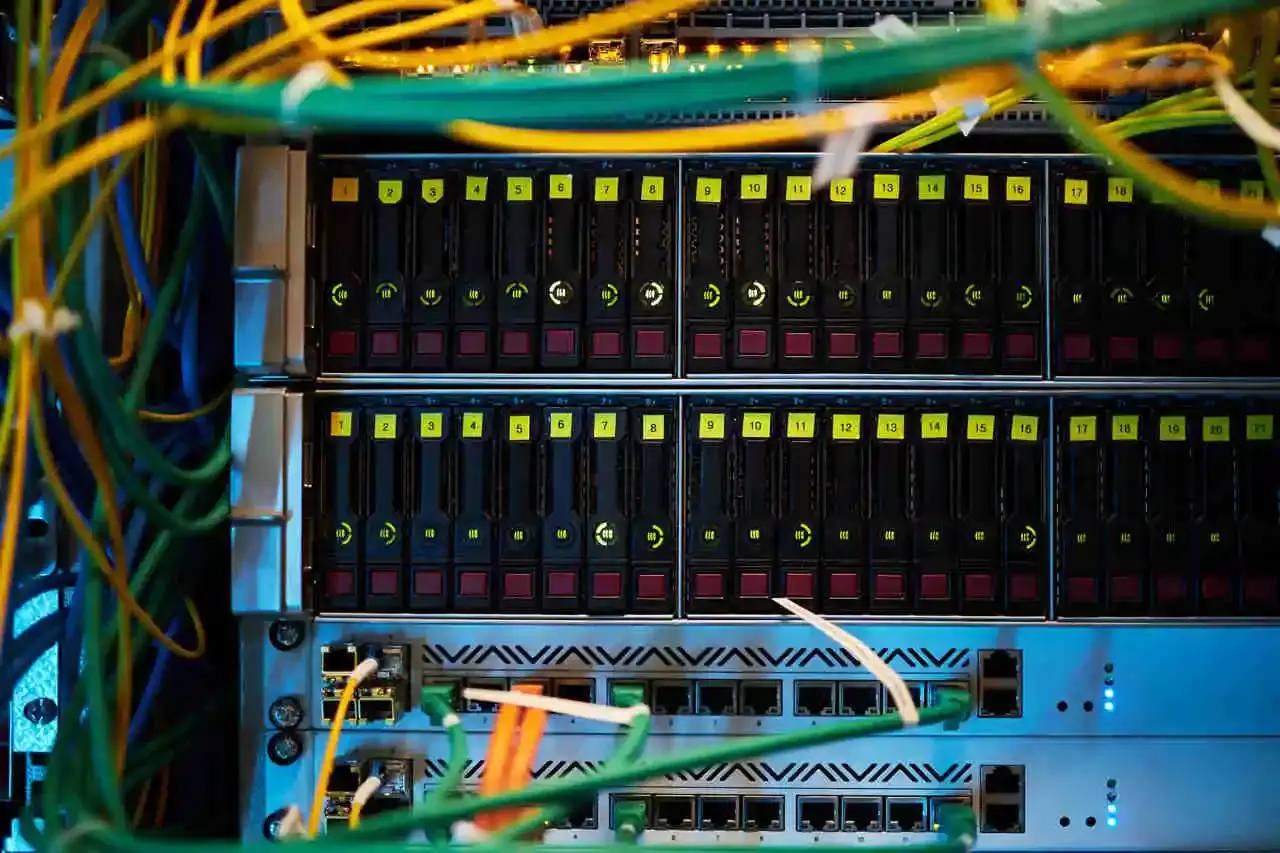
מערכות RAID הפכו לנפוצות בשרתים, התקני NAS ומערכי אחסון משום שהן מבטיחות ביצועים משופרים ועמידות לתקלות . עם זאת, בעוד שהן מציעות שקט נפשי, הן אינן פתרון קסם: תקלה שמנוהלת בצורה גרועה עלולה להוביל לאסון ולהשאיר אתכם ללא נתונים תוך דקות ספורות.
כאשר מערכת RAID מתחילה להראות תסמינים חריגים, המפתח אינו להיות המהיר ביותר לתיקון, אלא להיות זהיר ביותר. זיהוי סימני הכשל וידיעה מה לא לעשות הם ההבדל בין החלפת דיסק פשוטה לבין אובדן נתונים מוחלט ובלתי ניתן לשחזור, אפילו עבור מעבדה מקצועית.
מהו כשל RAID ומדוע הוא אינו זהה לגיבוי?
RAID (מערך יתיר של דיסקים עצמאיים) מקבץ מספר דיסקים כדי להציע זמינות, ביצועים ו/או יתירות גבוהים יותר , בהתאם לרמה שבה נעשה שימוש. החל מ-RAID 1 קלאסי עם שיקוף ועד תצורות מורכבות יותר כמו RAID 5, RAID 6 או RAID 10, הרעיון הוא שהמערכת ממשיכה לתפקד גם אם דיסק פיזי אחד (או יותר) נכשל.
הבעיה היא שאנשים רבים מניחים "יש לי RAID, אז יש לי גיבוי", וזו טעות מהותית. RAID אינו מחליף גיבויים : הוא מגן מפני כשל של דיסק אחד או יותר (בהתאם לרמת ה-RAID), אך אינו מונע פגיעה לוגית, טעויות אנוש, תוכנות כופר, מחיקות מקריות או כשלים בבקר או בשרת.
יתר על כן, האופן שבו הבקר - כולל קושחת הבקר - מפיץ נתונים (סדר דיסק, גודל פס, אלגוריתמי זוגיות, מטא-דאטה וכו') גורם לכך שכל מניפולציה שגויה של המערך עלולה לשבור את המבנה ולהפוך את השחזור למסובך ביותר, אפילו כאשר הדיסקים "נראים" תקינים.
רמות RAID עיקריות והשפעתן על שחזור
כל רמת RAID מתנהגת בצורה שונה במקרה של כשלים, וזה משפיע באופן משמעותי על אפשרויות שחזור נתונים. הבנת ההבדלים הללו עוזרת להימנע מקבלת החלטות מסוכנות כאשר משהו משתבש.
במערך RAID 0, הנתונים מופצים על פני מספר דיסקים ללא שוויון או שיקוף. אין יתירות מכל סוג שהוא : אם דיסק בודד נכשל או מתפרק במידה מספקת, האובדן הלוגי הוא מוחלט מכיוון שחלק חיוני מכל קובץ חסר. לדבר על "שחזור" כאן אין טעם רב; העדיפות היא לנסות לשחזר את מה שניתן לשחזר מהדיסקים שניזוקו פיזית.
במערך RAID 1, הדיסקים משוקפים: כל כונן מכיל עותק מלא של הנתונים . תצורה זו בדרך כלל אמינה למדי לשחזור נתונים, בתנאי שלא מתרחשות שגיאות טיפול (לדוגמה, אתחול אחד הדיסקים במערכת אחרת או ערבוב שלהם בבקרים שאינם תואמים).
RAID 5 מפזר נתונים על פני מספר כוננים ומחשב זוגיות מבוזרת, מה שמאפשר לו לעמוד בפני כשל של כונן אחד . הבעיה מתעוררת כאשר כונן שני מתחיל לתפקד כראוי במהלך בנייה מחדש: עומס העבודה מרקיע שחקים, מופיעות שגיאות קריאה והמערך יכול לקרוס ללא אזהרה.
RAID 6 פועל באופן דומה ל-RAID 5 אך מוסיף זוגיות שנייה, המאפשרת לו לסבול כשל של עד שני דיסקים . בתמורה, הארכיטקטורה מורכבת יותר, בנייה מחדש אורכת זמן רב יותר, וכל שגיאת לוגיקה או תצורה מסבכת עוד יותר את מאמצי השחזור.
RAID 10 משלב מראות ופסים: זוגות דיסקים שמשתקפים "נפגעים". למטרות שחזור, סדר הדיסקים והקשר בין המראות והפסים הוא קריטי; ערבוב מיקומים או בנייה מחדש עיוורת עלולים להרוס את המערך גם אם כל הדיסקים תקינים פיזית.
סימנים ברורים לכך שה-RAID שלך מתחיל להיכשל
לפני שמערכת כושלת לחלוטין, היא בדרך כלל משאירה סדרה של רמזים. לימוד זיהוים מאפשר לך לעצור בזמן ולמנוע נזק נוסף.
אחד הסימנים הברורים ביותר הוא רעשים מוזרים המגיעים מהדיסקים: נקישות חוזרות ונשנות, חריקות, זמזומים לסירוגין או צלילים מתכתיים שלא היו שם קודם לכן. רעשים אלה מצביעים בדרך כלל על כשלים מכניים בראשי הקריאה/כתיבה או במגשים , או בעיות במנוע. אם תתעלמו מהם ותמשיכו לאלץ קריאות, מצב הכונן בדרך כלל יתדרדר מהר מאוד.
סימן אופייני נוסף הוא הופעת הודעות "Degraded", "Failed" או "Critical" בקונסולת הניהול של ה-NAS או בקר ה-RAID. הודעה זו משמעותה שדיסק אחד או יותר סומנו כבעייתיים והמערך פועל ללא היתירות המיועדת. בשלב זה, במיוחד עם RAID 5, כשל שני יכול להיות הקש ששבר את גב הגמל.
שימו לב לתסמינים פחות בולטים אך מסוכנים באותה מידה, כגון ירידה פתאומית ובלתי מוסברת בביצועים . אם זמני הקריאה והכתיבה מרקיעים שחקים, במיוחד בעת גישה לאמצעי אחסון או תיקיות מסוימים, ייתכן שהבקר מתקשה עם סקטורים שקשה לקרוא או חווה ניסיונות חוזרים רציפים שמעמיסים על המערכת.
יומני מערכת או בקר מציגים לעתים קרובות שגיאות קלט/פלט, הודעות זוגיות שגויות, "שגיאת קריאה בלתי ניתנת לשחזור", "בדיקת זוגיות נכשלה" או "זוהה פס פגום". עלייה מתמשכת בשגיאות קריאה/כתיבה , גם אם המערכת עדיין מתפקדת, היא דגל אדום שאין להתעלם ממנו.
דגל אדום נוסף הוא שהנפח נראה פגום למרות שאף דיסק לא נכשל לחלוטין . זה בדרך כלל מצביע על פגיעה לוגית במטא-נתונים של ה-RAID או בבלוקים מבוזרים, וכפיית בנייה מחדש אוטומטית במצב זה עלולה להפיץ את הפגיעה בכל המערך.
תסמינים של פגיעה לוגית ובעיות שקטות ב-RAID
לא כל כשלונות RAID גורמים לדיסק "מת" באופן מיידי. לעתים קרובות, הבעיה היא פגיעה הדרגתית בנתונים שזוחלת פנימה בשקט עד שהמצב הופך להיות קשה מאוד לתיקון.
דוגמה אופיינית היא קבצים שנראים כאילו הם שם, בעלי הגודל והשם הנכונים, אך אינם נפתחים, מכילים שגיאות עיצוב או נראים קטומים . מסדי נתונים שאינם נטענים, מכונות וירטואליות שאינן מופעלות או תמונות שהצופה דוחה הם בדרך כלל אינדיקטורים לחוסר עקביות בבלוקים המפוזרים על פני דיסקים.
כמו כן, נפוץ שמערכת ההפעלה או היישומים יציגו איטיות מקומית באמצעי אחסון RAID מסוימים, למרות שהמעבד וה-RAM אינם נראים לחוצים במיוחד. אם ההאטה מתמקדת בפעולות קריאה/כתיבה באותו אמצעי אחסון, סביר להניח שאתם מתמודדים עם פגיעה או סקטורים לא יציבים.
תסמין מסוכן נוסף הוא שבנייה מחדש שמתחילה לאחר החלפת דיסק תמיד נעצרת באותה נקודה , זורקת שגיאות מוזרות, או פשוט מסמנת את התהליך ככושל. זה בדרך כלל מצביע על כך שבלוקי המקור כבר פגומים והבקר אינו מסוגל ליצור עותק קוהרנטי בדיסק החדש.
לפעמים רק דיסק אחד מציג התראות SMART (סקטורים שהוקצו מחדש, זמני גישה ארוכים וכו'), אך ההתנהגות יוצאת הדופן מורגשת בכל מערך ה-RAID. במקרים כאלה, דיסק בודד עם סקטורים פגומים עלול לפגוע בעקביות של המערך כולו, במיוחד כאשר מתחילה בדיקת זוגיות או בנייה מחדש.
התעלמות מאזהרות אלו והמשך פעולה כרגיל, או גרוע מכך, כפיית משימות אינטנסיביות כגון אימותים, גיבויים המוניים או בנייה מחדש אוטומטית, עלולה להפיץ שחיתות ולהחליף בלוקים תקפים בנתונים פגומים . מנקודה זו ואילך, אפילו כלים מקצועיים לא יוכלו להבטיח שחזור מלא.
כשלים אופייניים בבקרים, שרתים ולוחות אם
לא הכל סובב סביב הדיסקים. בקר ה-RAID, לוח האם, או אפילו השרת כולו, יכולים להפוך לחוליה החלשה בשרשרת ולגרום לכשלים במערך, גם אם הדיסקים תקינים.
בקר ה-RAID, בין אם חומרה ייעודית או משולבת בלוח האם, אחראי להחליט היכן כל בלוק ייכתב, כיצד מחושב הזוגיות וכיצד מורכבים הכרכים . כשל, קושחה פגומה או נחשול מתח עלולים להשבית אותו, ולגרום למערך להיעלם או להציג אותו כ"זר", "לא מקוון" או דומה.
במקרה של בקרי חומרה ייעודיים, ישנה בעיה נוספת: חוסר תאימות כמעט מוחלט בין דגמים ויצרנים . אם בקר Supermicro ספציפי מתקלקל, למשל, לא מספיק פשוט להחליף אותו ב"בקר דומה": לעתים קרובות, נדרש אותו דגם בדיוק, עם גרסת קושחה דומה, כדי שיוכל לקרוא נכון את המטא-דאטה של ה-RAID.
עם פתרונות RAID משולבים (מה שנקרא "RAID מזויף"), כגון כמה RAIDs של תוכנות שבבים של AMD או Intel, הסיכון הוא שהחלפת לוח אם, איפוס BIOS או אובדן תצורת CMOS עלולים לגרום למערך להיות בלתי פעיל. במחשבים שולחניים ותחנות עבודה רבות, כשל בלוח האם או בסוללת CMOS עלול למחוק את תצורת ה-RAID, ולהשאיר את הכוננים כיחידות מבודדות.
יתר על כן, השרת עצמו ( ספק כוח , זיכרון, לוח אם, לוח אחורי וכו') עלול להיכשל עקב בעיות חשמליות, התחממות יתר או פגמי חומרה. ברבים מהמקרים הללו, התוצאה המעשית היא שה-RAID הופך לבלתי נגיש , למרות שבמציאות, הדיסקים המחוברים למערכת אחרת עם האסטרטגיה המתאימה, יכולים לשחזר את הנתונים שלהם.
כדי להחמיר את המצב, המערכת חייבת "להרכיב מחדש" את מערך ה-RAID בכל פעם שהוא מופעל מחדש או מאתחל. אם מתרחשות הפסקות חשמל, קפיצות מתח או שגיאות בקבצי התצורה (כגון mdadm.conf בלינוקס) במהלך תהליך זה, המערכת עלולה להרכיב את המערך בצורה שגויה, להשאיר אותו לא שלם, או פשוט לא לזהות אותו, מה שיהפוך את אמצעי האחסון לבלתי שמיש.
סיבות נפוצות לאובדן נתונים במערכי RAID
בהתחשב בכל האמור לעיל, ברור שמערכי RAID, למרות היותם שימושיים מאוד, עדיין חשופים לסיכונים ניכרים. הגורמים האמיתיים העיקריים לאובדן נתונים בסביבות אלו הם בדרך כלל שילוב של גורמים פיזיים, לוגיים ואנושיים.
הסיבה הברורה ביותר היא כשל של דיסק אחד או יותר עקב בלאי, פגמי ייצור, רעידות, טמפרטורה או פגיעות. למרות ש-RAID נועד לעמוד בחלק מהמצבים הללו, הוא לא תמיד מצליח ללא נזק משני : דיסק שמתחיל להחזיר סקטורים פגומים יכול לגרור את שכנו, במיוחד במהלך תהליכי אימות או בנייה מחדש.
מקור נפוץ נוסף לבעיות הוא שגיאות הרכבה או שחזור . אם המערכת מתקינה את המערך עם פרמטרים שגויים, דיסקים בסדר שגוי, רמות RAID שונות מהמקוריים, או לאחר העברה כושלת, הנתונים עלולים בקלות להפוך לבלתי מיושרים. במונחים מעשיים, אמצעי האחסון עשויים להופיע כקובץ RAW, לדרוש עיצוב או להציג מבני קבצים לא עקביים.
גם כשלים בשרת (לוח אם, קושחה, לוח אחורי, בקר SAS/SATA וכו') משחקים תפקיד משמעותי. באחוז גבוה מאוד של מקרים, כאשר השרת כשל פתאומי, מערך ה-RAID הופך לבלתי נגיש והנתונים אינם גלויים למערכת, למרות שהם עדיין קיימים פיזית על הדיסקים.
לכל זה עלינו להוסיף גורמים אנושיים: שינויי תצורה ללא תיעוד, סידור מחדש של דיסקים "לבדיקה", עדכוני BIOS ללא גיבוי קודם של התצורה, מחיקה מקרית של אמצעי אחסון, התקנה מחדש של מערכת ההפעלה על דיסקים שהיו חלק מהמערך, או שחזור גיבויים פגומים או לא שלמים על אותו RAID פגום.
לבסוף, ישנם איומים חיצוניים כמו תוכנות כופר, שיכולות להצפין הן את הנתונים והן את המבנים של אמצעי האחסון המאוחסנים במערכי RAID. בתרחישים אלה, תהליך השחזור הופך למסובך כפליים: ראשית, יש לטפל בהצפנה, ולאחר מכן בפגיעה הפנימית הפוטנציאלית של ה-RAID עצמו.
מה לא לעשות כאשר ה-RAID שלך מתחיל להיכשל
כאשר שרת נופל בסוף השבוע וכולם לחוצים, התגובה הנפוצה ביותר היא שמישהו ינסה לתקן את זה תוך כדי תנועה. זה מובן, אבל רבים מהמאמצים בעלי הכוונות הטובות הללו הם בדיוק מה שבסופו של דבר מחמיר את מצב הנתונים.
הפיתוי המסוכן ביותר הוא לכפות בנייה מחדש אוטומטית מבלי לנתח תחילה את המצב האמיתי של הדיסקים . אם באחד הדיסקים יש נתונים פגומים או סקטורים בלתי קריאים, הבנייה מחדש תעתיק ותערבב נתוני זבל עם נתונים טובים עד שמבנה אמצעי האחסון ייהרס לחלוטין.
טעות נפוצה נוספת היא החלפה אקראית של כוננים מבלי לדעת איזה מהם באמת פגום או לתעד את המיקום המקורי של כל כונן . העברת כוננים בין מפרצים, ערבוב שלהם בין בקרים שונים, או החלפת כמה כוננים בו זמנית ללא תוכנית, עלולים לבלבל את הבקר ולגרום למערך ה-RAID לאבד את מעקב אחר התצורה שלו.
הפעלת כלים כמו CHKDSK ב-Windows או fsck ב-Linux ישירות על אמצעי אחסון RAID המראים סימני פגיעה היא גם מסוכנת מאוד. כלי עזר אלה מנסים "לתקן" את מבנה הקבצים על סמך טבלאות שעלולות להינזק , והתיקונים שלהם כוללים לעתים קרובות מחיקת ערכים, העברת בלוקים וכתיבה מחדש של מטא-דאטה. בסביבה שכבר נפגעת, הדבר עלול לגרום לאובדן קבוע של אלפי קבצים.
גרועה באותה מידה היא הסתמכות על תוכנת שחזור RAID גנרית שמבטיחה "להגדיר באופן אוטומטי כל RAID ". רבים מהכלים הללו פועלים באופן שטחי, בהנחה שתבניות פסים, היסט וזוגיות סטנדרטיות שלא תמיד מתקיימות. שימוש לרעה עלול לדרוס סקטורים מרכזיים או להשאיר דיסקים במצב גרוע יותר מאשר כשהותקנו לראשונה.
לבסוף, הפעלה מחדש חוזרת ונשנית של השרת, הפעלה מחדש של ה-NAS, או המשך עבודה רגילה על מערך RAID פגום או כזה עם שגיאות זוגיות רק גורמים נזק נוסף לדיסקים, מקצה מחדש סקטורים נוספים ומפיצים את השחיתות . ככל שיבוצעו יותר כתיבות לאחר הבעיה החמורה הראשונה, כך יהיה למומחים פחות מרחב תמרון.
צעדים זהירים שיש לנקוט בעת זיהוי כשל RAID אפשרי
לנוכח סימפטומים חמורים (רעש, ירידה ברמת הסטטוס, שגיאות זוגיות, איטיות קיצונית, בנייה מחדש כושלת וכו'), דרך הפעולה הנבונה ביותר היא להאט את הקצב ולהמשיך בצורה שיטתית . מה שלא תכתבו או תשנו עכשיו, ייתכן שניתן יהיה להציל אותו מאוחר יותר.
הדבר הראשון שיש לעשות הוא לעצור באופן מיידי כל פעולות כתיבה על המערך : אין להעתיק נתונים עליו, אין מכונות וירטואליות חדשות, אין עדכונים המוניים. אם אמצעי האחסון עדיין נגיש, עדיף לטעון אותו כקריאה בלבד אם המערכת מאפשרת זאת.
בשלב הבא, מומלץ לתעד את המצב הנוכחי בפירוט רב ככל האפשר: צילומי מסך של ממשק ה-BIOS או ה-NAS, רשימת דיסקים עם מיקומם הפיזי, מספר סידורי, הפורטים שאליהם הם מחוברים, הודעות שגיאה מדויקות המופיעות ביומנים וכו'. מידע זה הוא בעל ערך רב עבור כל מעבדת שחזור בעת שחזור התרחיש המקורי.
במקרים בהם ה-RAID נכשל בהרכבה או שהשרת לא מאתחל, אפשרות טכנית אחת היא להסיר את הדיסקים ולחבר אותם למחשב אחר כדי ליצור עותקים פורנזיים סקטור-אחר-סקטור של כל כונן . עותקים אלה, שנוצרו במצב קריאה בלבד, מאפשרים לך לעבוד על שכפולים לאחר מכן מבלי לגרום נזק נוסף לדיסקים המקוריים.
בעזרת ידע מתקדם, כלים מיוחדים וסביבה מבוקרת, ניתן לנסות שחזור לוגי של המערך משכפולים אלה, תוך הסקת סדר הדיסק, גודל הפסים, תבניות הזוגיות, היסטים ומטא-דאטה . עם זאת, זוהי משימה עדינה של הנדסה לאחור: כל ניסוי וטעייה הכוללים שינויים אקראיים בפרמטרים עלולים להוביל לפרשנות שגויה של הנתונים.
עבור רוב העסקים והסביבות הקריטיות, דרך הפעולה הבטוחה ביותר היא ליצור קשר עם שירות שחזור RAID מקצועי בהקדם האפשרי ולפעול לפי ההוראות הראשוניות שלו. שיעור ההצלחה קשור בדרך כלל קשר הדוק למספר הניסיונות הכושלים שבוצעו לפני ההגעה למעבדה.
כיצד פועלות מעבדות שחזור RAID מקצועיות
שירותי שחזור נתונים מקצועיים המתמחים בסביבות RAID משלבים ידע מעמיק בחומרה ומערכות קבצים עם כלים קנייניים ונהלים קפדניים. זה מה שהם עושים בדרך כלל, באופן כללי, כאשר הם מקבלים דיווח על RAID כושל.
הצעד הראשון הוא ביצוע אבחון אינדיבידואלי על כל כונן קשיח : נבדק המצב המכני, האלקטרוני והלוגי של הכוננים, מזוהים סקטורים פגומים, נבדקות טבלאות SMART, והערכת הסיכון לכשל לטווח קצר. אם יש נזק פיזי לכוננים כלשהם, הטיפול בהם בחדר נקי מקבל עדיפות.
לאחר מכן, נוצרים שיבוטים פורנזיים של כל הדיסקים המעורבים . במקום לעבוד על המקור, נוצר עותק סקטור-אחר-סקטור, תוך שימוש בכלים המאפשרים דילוג על סקטורים שניזוקו קשות או ניסיון חוזר עם דפוסים בטוחים. המטרה היא לשמר את המצב המקורי במקרה שיהיה צורך לחזור לשלב קודם בתהליך.
לאחר שהשיבוטים מוכנים, מתבצע שחזור לוגי ידני של ה-RAID : מזוהים הרמה (0, 1, 5, 6, 10 וכו'), סדר הדיסק, גודל הפסים, הקיזוזים, אלגוריתמי הזוגיות וכל מאפיין אחר של הבקר המקורי. לעתים קרובות, ניתן לשחזר את האמצעי אחסון גם ללא אותו בקר או NAS שיצר אותו.
ברגע שהנפח הווירטואלי המשוחזר נראה קוהרנטי, מערכת הקבצים מתוקנת במידת הצורך: NTFS, ReFS, ext4, XFS, Btrfs, ZFS, VMFS ואחרים. עבודה זו דומה לזו של מנתח: מבנים מתוקנים, טבלאות inode, MFTs, סופרבלוקים או יומנים נבנים מחדש, תוך ניסיון תמיד לשנות את המינימום המוחלט.
לבסוף, הנתונים עוברים חילוץ ומאומתים באופן שיטתי. נבדקת העקביות של מסדי הנתונים העיקריים, המכונות הווירטואליות והתיקיות הקריטיות, קבצים מאומתים כנפתחים כראוי, והנתונים מועברים על גבי אמצעי אחסון חדשים ומבודדים , כגון כוננים קשיחים חיצוניים או NAS חדש, כך שהלקוח יוכל לסקור את השחזור לפני קבלתו.
בתרחישים מורכבים במיוחד, כגון RAIDs שנפגעו מתוכנת כופר, שחזורים קודמים שנכשלו, או אמצעי אחסון וירטואליים בתוך מערכים שכבר ניזוקו, טכניקות פענוח, ניתוח פורנזי ושחזור RAID משולבים, אך תמיד תחת אותו כלל: אין לגעת במקוריים יותר מהנדרש לחלוטין.
בסופו של דבר, מערכות RAID הן כלי רב עוצמה לשיפור זמינות נתונים, אך הן נותרות פגיעות לטעויות פיזיות, לוגיות ואנושיות. הבנת חולשותיהן, זיהוי סימני אזהרה מוקדמים, ומעל הכל, הימנעות מהחלטות אימפולסיביות כאשר מתרחשת כשל, הן מה שבאמת עושה את ההבדל בין פחד קל לאסון נתונים.
