- מודל רב-מודאלי מקורי עם טקסט, תמונה, אודיו ווידאו, והזרמה בזמן אמת.
- SOTA ב-22/36 מבחני ביצועים של אודיו/וידאו וברב-לשוני (119/19/10 שפות).
- ארכיטקטורת Thinker-Talker עם MoE, השהייה נמוכה ובקרת הנחיות מערכת.
- פריסה מומלצת עם vLLM/Transformers, Docker ותוכניות שירות רשמיות.
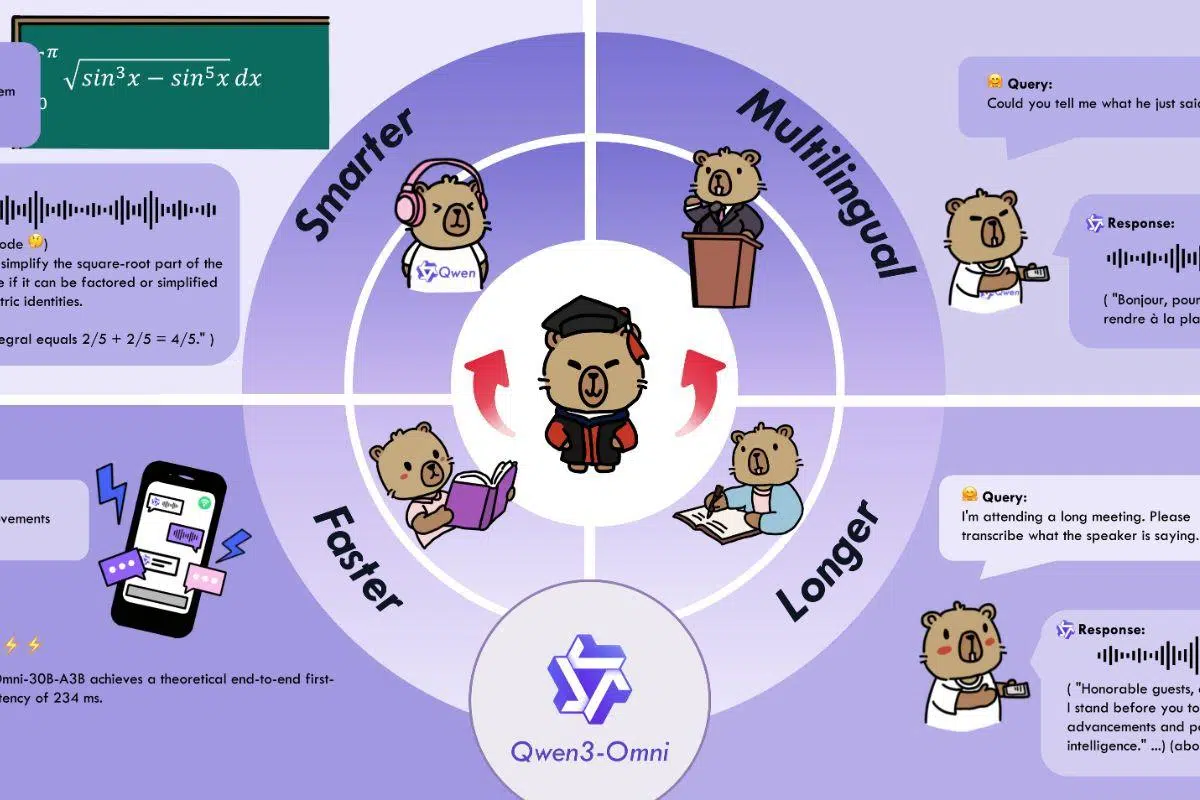
הגעתו של Qwen3-Omni שינתה את נוף הבינה המלאכותית: מודל יחיד מקורי המסוגל להבין ולהגיב לטקסט, תמונות, אודיו ווידאו , עם תגובות מיידיות הן בכתב והן בדיבור. אנחנו לא מדברים על "טלאים" רב-מודאליים, אלא על ארכיטקטורה שתוכננה באופן יסודי לשילוב שיטות עם השהייה נמוכה ובקרה התנהגותית מדויקת.
בתקופה שבה כמעט כולם בודקים צ'אטבוטים ועוזרים, Qwen3-Omni מגיע עם אמביציה: הוא תומך ב-119 שפות באמצעות טקסט, מזהה דיבור ב-19 שפות ומדבר ב-10 שפות , מבין שמע ארוך (עד 30 דקות), ומתגאה בציוני ביצועים מעולים בעשרות מבחנים. יתר על כן, עיצוב החושב-מדבר וגישת שילוב המומחים שלו מכוונים למהירות תגובה ואיכות חשיבה בתרחישים אמיתיים.
מה זה Qwen3-Omni ומה הוא מציע?
Qwen3-Omni היא משפחה של מודלים רב-לשוניים בסיסיים, רב-מודאליים ומקיף, שנועדו לעבד טקסט, תמונות, אודיו ווידאו, עם פלט הן בטקסט והן בדיבור טבעי. המפתח טמון לא רק במגוון הקלטים והפלטים, אלא גם בפונקציונליות הסטרימינג שלה עם תהליכי שיחה זורמים ויכולת להגיב באופן מיידי.
הצוות הציג מספר שיפורים ארכיטקטוניים לשיפור ביצועים ויעילות: אימון מקדים מוקדם של "טקסט תחילה" בשילוב אימון רב-מודאלי מעורב, ועיצוב עם תערובת מומחים (MoE) ששומר על ביצועיו בטקסט ובתמונה תוך שיפור אודיו ווידאו. עם שיפורים אלה, המודל משיג SOTA ב-22 מתוך 36 מדדי שמע/וידאו ו-SOTA בקוד פתוח ב-32 מתוך 36, עם תוצאות דומות ל-Gemini 2.5 Pro ב-ASR, הבנת שמע ושיחת דיבור.
יכולות ושיטות מפתח
Qwen3-Omni מוכן ליישומי שמע, וידאו ואודיו-ויזואליים בעולם האמיתי, עם תמיכה רב-לשונית נרחבת: 119 שפות טקסט, 19 שפות קלט קולי ו-10 שפות פלט קולי . שפות קלט קולי כוללות אנגלית, סינית, קוריאנית, יפנית, גרמנית, רוסית, איטלקית, צרפתית, ספרדית, פורטוגזית, מלאית, הולנדית, אינדונזית, טורקית, וייטנאמית, קנטונזית, ערבית ואורדו; ושפות הפלט כוללות אנגלית, סינית, צרפתית, גרמנית, רוסית, איטלקית, ספרדית, פורטוגזית, יפנית וקוריאנית, בין היתר.
חבילת ספרי הבישול הרשמיים ממחישה את מגוון השימושים שלה. בתחום האודיו, היא מציגה זיהוי דיבור רב-לשוני וקולות ארוכי טווח (ASR) , תרגום דיבור לטקסט ודיבור לדיבור, ניתוח מוזיקה (סגנון, קצב, ז'אנרים), תיאור אפקטים קוליים וכתוביות לכל סוג של אודיו . היא תומכת גם בניתוח משולב של רצועות עם דיבור, מוזיקה וצלילי סביבה.
בראייה, הוא מציע OCR "קשה" עבור תמונות מורכבות, זיהוי וביסוס עצמים , אבטחת איכות של תמונות, פתרון מתמטי של תמונות (שם מודל החשיבה זורח), תיאור וידאו, ניווט מבוסס וידאו בגוף ראשון וניתוח מעברי סצנה . בתרחישים אורקוליים, הוא מדגים אבטחת איכות של אודיו-וידאו עם יישור זמן, אינטראקציה מודרכת עם כניסות AV ודיאלוגים עם התנהגות עוזר.
כסוכן, הוא בולט ביכולתו לתפקד באמצעות שיחות אודיו , מה שפותח זרימות עבודה קוליות המפעילות כלים, ובמשימות נגזרות ישנו Omni-Captioner לכתוביות בפירוט רב, מה שמדגים את הכלליות של הכתוביות הבסיסיות.
אדריכלות ועיצוב של הוגה-דברן עם משרד החינוך
אחד המבדילים המרכזיים הוא הפרדת האחריות: החושב יוצר את הטקסט (עם וריאציות הכוללות הנמקה מפורשת של שרשרת מחשבות), והדובר מפיק אודיו בזמן אמת . ניתוק זה מאפשר שיחה קולית טבעית בעוד שהמערכת שומרת על רמה גבוהה של הבנת טקסט ותכנון.
מסד הנתונים של משרד החינוך מחלק את עומס העבודה בין מומחים ומסתמך על אימון מקדים של AuT לייצוגים כלליים רבי עוצמה. יתר על כן, השימוש בקידוד רב-קודי בערוץ השמע מפחית את זמן ההשהיה למינימום, דבר חיוני עבור שיחות או עוזרים שבהם כל מאית השנייה חשובה.
ביצועים ומדדי ביצועים: טקסט, חזון, אודיו ואודיו-ויזואלי
ה-Qwen3-Omni שומר על ביצועי טקסט ותמונה מתקדמים מבלי להתדרדר בהשוואה לדגמי Qwen בגודל דומה המתמקדים במצב יחיד, בעוד שבביצועי שמע ואודיו-ויזואליים הוא קובע את הקצב ברוב המבחנים . מתוך 36 מדדי שמע ואודיו-ויזואליים, הוא משיג SOTA בקוד פתוח ב-32 ו-SOTA כולל ב-22, ועובר את Gemini 2.5 Pro ו-GPT-4o בכמה נקודות.
כמה אבני דרך בולטות בתחום הטקסט: ב- AIME25 גרסת Flash-Instruct מקבלת ציון של כ-65,9; ב- ZebraLogic ה-Instruct מגיעה ל-90, וב- MultiPL-E היא משיגה נתונים תחרותיים מול GPT-4o. במשימות יישור כמו IFEval ו-WritingBench, המודלים Instruct ו-Thinking מציגים ציונים גבוהים ועקביים.
באודיו, תוצאות ה-ASR עבור סינית ואנגלית מצוינות: ב- WenetSpeech וב- LibriSpeech, הוא מפחית משמעותית את שיעור שגיאות המילים, עם נתונים הקרובים ל-1,22/2,48 ב-LibriSpeech clean/other, ובקבוצות כמו FLEURS (רב-לשוניות), הוא מציע שיעורים נמוכים מאוד. ב-VoiceBench, מדדים כמו AlpacaEval, CommonEval ו-WildVoice מציבים את Qwen3-Omni ברמה של מערכות ייחוס סגורות, והוא מצטיין בהנמקה קולית ב- MMAU v05.15.25.
ביישומים אודיו-ויזואליים, המדד המצוטט ביותר הוא WorldSense (בערך 54,1 ), ועובר את Gemini-2.5-Flash. יתר על כן, בסוויטות כמו DailyOmni ו- VideoHolmes, גרסת ה-Thinking משיגה שיפורים לעומת יישומי SOTA קודמים בקוד פתוח. בראייה טהורה, היא מצטיינת ב- MMMU, MathVista, MathVision ובהבנת מסמכים (AI2D, ChartQA), עם ציונים טובים מאוד בספירה ( CountBench) ובהבנת וידאו (Video-MME, MLVU).
כמו כן נמדדה יצירת קול ברמה אפס-שדה: בהשוואה למשפחות שפות כמו CosyVoice ו-Seed-TTS, Qwen3-Omni מציג עקביות תוכן טובה יותר על פני מספר שפות ודמיון גבוה בין דוברים . בחלק הרב-לשוני, הטבלאות "עקביות תוכן" ו"דמיון בין דוברים" מראות ש-Qwen3-Omni 30B-A3B תחרותי מאוד בסינית ובאנגלית, ויציב בגרמנית, איטלקית, פורטוגזית, ספרדית, יפנית, קוריאנית, צרפתית ורוסית. ב- TTS בין-לשוני , הוא משיג עקביות/WER טובות יותר על פני מספר זוגות שפות (למשל, zh→en, ja→en, ko→zh) בהשוואה ל-CosyVoice 2/3.
דגמים זמינים ולמה כל אחד מהם משמש
סדרת Qwen3-Omni כוללת שלושה חלקים עיקריים, כל אחד מהם מיועד לשימוש ספציפי: Instruct (הוראות) , Thinking (חשיבה) ו- Captioner ( כתוביות) . כולם נובעים מאותו ליבה אך עם יכולות שונות המופעלות או מכווננות למשימות ספציפיות.
Qwen3-Omni-30B-A3B- Instruct מכיל את הפונקציות 'חושב' וה'דבר', מקבל אודיו, וידאו וטקסט, ומחזיר טקסט ואודיו. זוהי הבחירה הנכונה אם אתם רוצים אינטראקציה מלאה ותוצאות מדוברות בזמן אמת, ומומלץ להדגמות קוליות או וידאו .
Qwen3-Omni-30B-A3B - חשיבה מתמקדת בחושב עם הנמקה שרשרת , תומכת באודיו, וידאו וטקסט עם פלט טקסטואלי. היא שימושית לניתוח מעמיק, פתרון בעיות מורכבות, מתמטיקה חזותית או זרימות עבודה שבהן אינך זקוק לפלט קולי אך זקוק לחשיבה מובנית בצורה הטובה ביותר.
Qwen3-Omni-30B-A3B- Captioner הוא נגזרת מעודנת של כתוביות אודיו מדויקות ודלות היפראקטיביות . זהו קוד פתוח, מכסה מגוון רחב של אודיו בפירוט רב, וממלא פער היסטורי במערכת האקולוגית של קוד פתוח: כתוביות אמינות ועשירות לאודיו למטרות כלליות.
שליטה בזמן אמת ובקרה התנהגותית (latency)
המערכת מותאמת לאינטראקציה מיידית, עם זמני תגובה של כ-211 אלפיות השנייה לאודיו ו-507 אלפיות השנייה לאודיו-וידאו . בנוסף לסטרימינג, מושם דגש על תנועות שיחה טבעיות ויציבות קולית, בסיוע התפקידים הברורים של החושב (טקסט) והדובר (קול).
לצורך כוונון עדין, ניתן להתאים אישית את הסגנון באמצעות הנחיות מערכת . בתרחישי AV שבהם אודיו וידאו משמש כהפניה, הצוות מציע הנחיית מערכת שתשמור על נימוקיו של החושב תוך מתן טקסט קריא ושיחתי יותר, מה שמקל על הדובר לדבר בשטף . מומלץ גם לשמור על הפרמטר `use_audio_in_video` עקבי לאורך שיחה מרובת תורות.
בהערכה, ישנן הנחיות ספציפיות: אין להגדיר שורת הפקודה של המערכת , יש לפעול לפי פורמט ChatML של כל ביצועים, וכאשר אין שורת הפקודה, יש להשתמש כברירת מחדל בשפות הבאות: ASR בסינית ("请将这段中文语音转换为纯文本。"), ASR בשפות אחרות ("תעתק את השמע לטקסט."), S2TT ("האזן לדיבור <שפה_מקור> שסופק ...") ומילות השיר (" תעתק את מילות השיר" ... ללא סימני פיסוק, שורות מופרדות באמצעות מעברים").
פריסה, דרישות וכלים
לחוויה מקומית מלאה, הצוות ממליץ על Hugging Face Transformers וסקירת שלבי הנדסת התוכנה , אך שימו לב: בהיותה ארכיטקטורת MoE, היא יכולה לפעול לאט עם הסקת HF; עבור יישומים בייצור או יישומים בעלי השהייה נמוכה , הם ממליצים להשתמש ב-vLLM או ב-API של DashScope , ואף מספקים תמונת Docker הכוללת סביבות עבור שניהם. קוד ה-Transformers כבר מוזג, אך חבילת PyPI טרם שוחררה ויש להתקין אותה מהמקור.
הם מספקים כלי עזר לטיפול באודיו ותמונה/וידאו (base64, כתובות URL, קלט משולב), וממליצים על FlashAttention 2 עם Transformers כדי להפחית את זיכרון ה-GPU בכל פעם שנטען ב- float16 או bfloat16 . עם vLLM, FlashAttn2 כלול, ופרמטרים כגון limit_mm_per_prompt (מקצה מראש זיכרון GPU) ו- max_num_seqs עבור מקביליות מפורטים ; בנוסף, הגדלת tensor_parallel_size מאפשרת הסקה מרובה GPU.
ישנן כמה טיפים שימושיים לחיסכון במשאבים: אם אינך זקוק לאודיו, תוכל להשבית את ה-Talker לאחר האתחול, ובכך לחסוך כ-10 ג'יגה-בייט של VRAM. ואם אתה רוצה פלט טקסט מהיר יותר, השתמש ב -`return_audio=False` במהלך היצירה. דרישות זיכרון תיאורטיות מינימליות עבור BF16 עם FlashAttn2 מסופקות גם כן: לדוגמה, ה-Instruct 30B-A3B משתמש בכ-78,9 ג'יגה-בייט עם 15 שניות של וידאו ו-144,8 ג'יגה-בייט עם 120 שניות; ה-Thinking משתמש בכ-68,7 ג'יגה-בייט ו-131,7 ג'יגה-בייט, בהתאמה.
כדי להגדיר הדגמת אינטרנט מקומית , הם ממליצים להכין את סביבת vLLM שלכם (או את סביבת Transformers האיטית יותר), לוודא ש- ffmpeg מותקן אצלכם , ולהשתמש בסקריפטים שלהם. הם מציעים תמונות Docker מוכנות ל-GPU "qwenllm/qwen3-omni" עם ערכת הכלים של NVIDIA Container , מיפוי פורטים (למשל, host 8901 → container 80), ואפשרות להגיש מ-0.0.0.0. ניתן להזין מחדש או למחוק את המכולה לפי הצורך.
הדגמות, ממשקי API ומערכת אקולוגית
אם אינך מעוניין לפרוס באופן מקומי, תוכל לנסות הדגמות ב-Hugging Face Spaces וב-ModelScope Studio , עם חוויות עבור Qwen3-Omni-Realtime, Instruct, Thinking ו-Captioner. Qwen Chat עם סטרימינג בזמן אמת זמין גם כן: פשוט בחר באפשרות שיחת קול/וידאו בממשק.
לאינטגרציה ניתנת להרחבה עם השהייה נמוכה, הגישה המומלצת היא ממשק ה-API של DashScope , המציע את הביצועים הצפויים ביותר. יתר על כן, הקהילה מתאמת דרך ערוצים כמו Discord ו-WeChat , ומפרסמת ספרי בישול עם יומני ביצוע אמיתיים המאפשרים למשתמשים לשחזר תוצאות על ידי שינוי הנחיות או מודלים.
מפת דרכים ושיפורים מתמשכים
הצוות עובד על תכונות נוספות כגון זיהוי דיבור מרובה דוברים , יישום OCR על וידאו, שיפורים בלמידה אורקולית פרואקטיבית וזרימות עבודה עשירות יותר של סוכנים . הם גם ציינו שתמיכה בפלט שמע ב-vLLM עבור מודל Instruct תהיה זמינה בקרוב, ותשלים את מחזור הפריסה בזמן אמת מאותו backend.
שאלות נפוצות: תמיכה בזמן ריצה וכימות
חלק מהמשתמשים ציינו שהם לא יכולים להריץ את Qwen3-Omni אפילו עם החשודים הרגילים ושהם לא רואים קוונטים ב-Hugging Face ; יתר על כן, הפורמט המקורי של 16 סיביות הוא כ-70 ג'יגה-בייט, גודל בעייתי עבור מחשבים צנועים. הפרויקט עצמו מבהיר ש-Transformers כבר מוזג אך ללא חבילת PyPI , אותה יש להתקין מהמקור, וכי vLLM היא האפשרות המועדפת להסקת מסקנות, אם כי תמיכת האודיו של Instruct ב-vLLM תשוחרר בעתיד הקרוב.
בנוגע לכימות, עדיין אין placeholders רשומים ב-HF עבור Qwen3-Omni 30B-A3B, וכדאי לזכור שהאופי של MoE והרב-מודאלי מסבך תאימות מיידית עם זמני ריצה כמו llama.cpp. עבור אלו שצריכים לבדוק עכשיו, ההמלצה הרשמית היא להשתמש ב- Docker + Transformers/vLLM מהמקור או מה- API , ולעקוב אחר המאגר עבור בקשות תמיכה וכימותים עתידיים כאשר יהיו זמינים.
נוהלי הערכה טובים והנחיות
כדי לשחזר את המספרים, מפורטות ההנחיות הבאות: רוב מבחני הייחוס משתמשים בפענוח גרדי ב-Instruct ללא דגימה, ועבור Thinking, יש לכבד את הפרמטרים ב- generation_config.json . קצב פריימים של הווידאו מוגדר גם הוא ל- fps=2 במהלך ההערכה, ומצוין כי הפקודה של המשתמש צריכה לעקוב אחר הנתונים הרב-מודאליים אלא אם כן מערך הנתונים מציין אחרת.
כאשר מבחן ביצועים אינו כולל הנחיה, ניתן להשתמש בהנחיות ברירת המחדל (ASR/אחר בסינית, S2TT, מילות שירים). בנוסף, אין להגדיר את הנחיית המערכת במהלך ההערכה כדי להבטיח שהתוצאות ניתנות להשוואה בין מערכות והרצות.
Qwen3-Omni ממצבת את עצמה כפלטפורמה רב-מודאלית אמיתית, עם השהייה נמוכה, תמיכה רב-לשונית רחבה, יכולות אודיו ווידאו מתקדמות ונתיב פריסה ברור באמצעות Transformers, vLLM ו-Docker. עבור אלו המחפשים מודל יחיד שמטפל בטקסט ובתמונות בצורה חלקה מבלי להתפשר על ביצועים, וגם מאזין, מדבר ומבין וידאו , זוהי הצעה שקשה לנצח אותה כיום.