- キャッシュ コヒーレンスにより、マルチコア システム上で、異なるキャッシュおよび RAM 内の同じデータのすべてのコピーの一貫性が維持されます。
- 最後のレベルを共有するキャッシュ階層により、一貫性の制御が簡素化され、メインメモリへの直接アクセスが削減されます。
- コヒーレンス プロトコルは、キャッシュ ラインごとの状態と制御ビットによってサポートされるコピー無効化または更新戦略を使用します。
- コンパイラとオペレーティング システムは、重要な期間に命令を挿入し、メモリを構成することで、ハードウェアの一貫性を補完できます。
最新のマルチコアプロセッサの回路図を見ると、必ず同じパターンが見られます。複数のコアがあり、それぞれが近傍に独自のキャッシュを持ち、 RAMにアクセスする前の共通ポイントとして機能する共有の最終レベルキャッシュが配置されています。この構成は偶然や設計者の気まぐれではなく、並列システムにおける重大な問題、すなわちキャッシュコヒーレンシへの直接的な対応策なのです。
堅牢な整合性メカニズムがなければ、各コアはメモリ内の同じデータの異なる古いバージョンを扱うことになりかねません。これは実際のプログラムでは、微妙なエラー、予測不能な障害、さらにはシステムクラッシュにつながります。したがって、ハードウェアレベルとソフトウェアレベルの両方でこの整合性がどのように維持されているかを理解することは、最新のマルチコアCPUのパフォーマンスと安定性を理解する上で非常に重要です。
キャッシュコヒーレンスとは何か:端末のメタファー

複数の人がそれぞれ異なる端末の前に座り、中央サーバーに保存されている同じ文書を編集している状況を想像してみてください。各画面にはファイルのコピーが表示され、誰かが変更を加えると、他の全員の画面にも即座に反映されることが期待されます。
この仕組みが機能するためには、文書の変更内容をすべての端末に反映させる同期メカニズムが必要です。そうすることで、全員が常に同じバージョンを確認できるようになります。このシステムが正常に機能している限り、すべて問題ありません。テキストを修正した人は、他の全員がほぼ瞬時に新しいバージョンを確認できることを知っているからです。
同期システムが突然故障したと想像してみてください。各ユーザーは共有ドキュメントを編集していると思い込んでいますが、実際には各端末にそれぞれ独立したローカルコピーが残されています。その瞬間から、あるユーザーが行った変更は他のユーザーには反映されず、ドキュメントは制御不能なほど乖離し始めます。
コンピューティングの世界では、CPUに信頼できる整合性プロトコルがない場合、まさにこのような事態が発生します。つまり、あるコアがメモリ内のデータを変更する一方で、他のコアはプライベートキャッシュから古いバージョンのデータを読み込み続けるのです。これは、深刻な論理エラー、データの破損、そしてデバッグ不能な動作を引き起こす温床となります。
キャッシュコヒーレンスとは、マルチコアシステムにおいて、異なるキャッシュやRAMに分散された同一データのすべてのコピーが、一貫した状態を維持することを保証する一連のメカニズムのことである。複数のコピーが存在する場合でも、システムはあたかもコピーが1つしかないかのように動作しなければならない。
マルチコアCPUのキャッシュとメモリ階層
CPUキャッシュは、頻繁に使用されるRAMのチャンクのコピーを保持する、小型で非常に高速なメモリです。プロセッサがコードを実行する際、(比較的低速な)RAMに継続的にアクセスする代わりに、キャッシュへの読み書きを試みることで、レイテンシを大幅に削減します。
もちろん、その仕組みは、キャッシュがデータの「公式バージョン」ではなく、一時的な複製のみを保存するという点にある。端末の比喩で言えば、RAMはサーバー上のドキュメントであり、キャッシュはファイルの特定の部分を表示するローカル画面に相当する。
マルチコアCPUでは、各コアが通常、独自のレベル1(L1)キャッシュ、さらにはレベル2(L2)キャッシュを持つため、設計はより複雑になります。これらの上に、コアとRAMへのアクセスを提供するメモリコントローラの間に、共有のレベル3キャッシュ(例えば)が追加されます。
この共有キャッシュは、すべてのコアがRAMに直接かつ集中的にアクセスすることを許可すると、アクセス競合、メモリバス上の競合、そして大幅なパフォーマンス低下を引き起こすため導入されました。ラストレベルキャッシュは、RAMへのアクセスを減らし、データトラフィックの大部分を一元化する共通の「バッファ」として機能します。
さらに、多くのアーキテクチャではキャッシュが包括的に構成されています。プロセッサに近いレベルに格納されているラインは、階層の上位レベルにも存在します。つまり、L1 に存在するラインは L2 にも存在し、さらに L3 にも存在します。これは一貫性に関して非常に有用な結果をもたらします。最下位レベルのキャッシュを正しく更新するだけで、 RAM に常にアクセスすることなく、他のレベルの状態を制御できるのです。
最終レベルの共有キャッシュが一貫性の鍵となる理由
このグローバルな最終レベルキャッシュがなければ、各コアはメインメモリに対して直接整合性チェックを行う必要があった。プライベートキャッシュ内のメモリラインが変更されるたびに、他のコアが同じラインのコピーを保持しているかどうかを確認し、保持している場合は、すべての箇所でそれを更新または無効化する必要があった。
多数のコアを持つシステムでは、このようなチェック処理によって膨大な数のRAMへのトランザクションが発生し、高速キャッシュの利点の多くが失われてしまいます。CPUは、コアとメモリの間に共有キャッシュを配置することで、コヒーレンス制御を単一の中間場所に集中させることができます。
多くの実装では、上位レベル(プロセッサから遠いレベル)のキャッシュには、コアに近いレベルに存在するラインのコピーが格納されています。この構成では、コヒーレンスプロトコルは、最終レベルがメインメモリと同期していること、および各コアのプライベートレベルがその直上のレベルと同期していることを保証するだけで済みます。
これは、ロシアのマトリョーシカ人形のようなものだと考えることができます。第3レベルのキャッシュには第2レベルと第1レベルのコンテンツが含まれ、第2レベルには自身のコンテンツと第1レベルのコンテンツが含まれ、第1レベルは自身の行のみを認識します。このように、「一番大きな人形」(最後のレベル)を制御することで、システムは残りの部分をより効率的に調整できます。
その結果、設計とメモリトラフィックの面で、一貫性を維持することがより経済的になります。各コアが常にRAMを処理することを強制する代わりに、このプロトコルは共有キャッシュ上で動作し、そこからプライベートキャッシュ内のどの行を更新または無効化すべきかを管理します。
更新方法: コピーの無効化と更新
2つ以上のコアが、複数のキャッシュに複製された同じデータ行にほぼ同時にアクセスしようとすると、重大な問題が発生します。このような状況において、整合性システムは通常、書き込みを処理する際に2つの基本的な戦略を採用します。
最初の方法は無効化に基づいています。カーネルが特定のキャッシュラインに書き込む必要がある場合、プロトコルは他のキャッシュに存在する可能性のある同じラインのコピーをすべて無効化します。書き込みを行うカーネルのみが、そのラインを読み書き可能な状態に維持します。他のカーネルは、そのデータを再度使用したい場合は、上位レベル(またはメモリ)から更新されたバージョンでラインを再ロードする必要があります。
2つ目の戦略は更新に関するものです。この場合、カーネルが行を変更すると、システムは新しいコンテンツを自動的に他のキャッシュ内の既存のコピーに伝播しようとします。こうすることで、その行を保存していたすべてのキャッシュは、後で無効化して再ロードする必要なく、更新されたバージョンを受け取ることができます。
それぞれの方法には長所と短所があります。書き込みが頻繁に行われる場合、無効化の方が一般的に効率的です。これは、他のコアがすぐに必要としない更新によってメモリシステムが飽和状態になるのを防ぐためです。逆に、更新は、多くのコアが同じデータを頻繁に読み取り、そのデータの変更頻度が比較的低い場合に有利です。これは、無効化のたびにデータラインを再ロードする必要がなくなるため、レイテンシが削減されるためです。
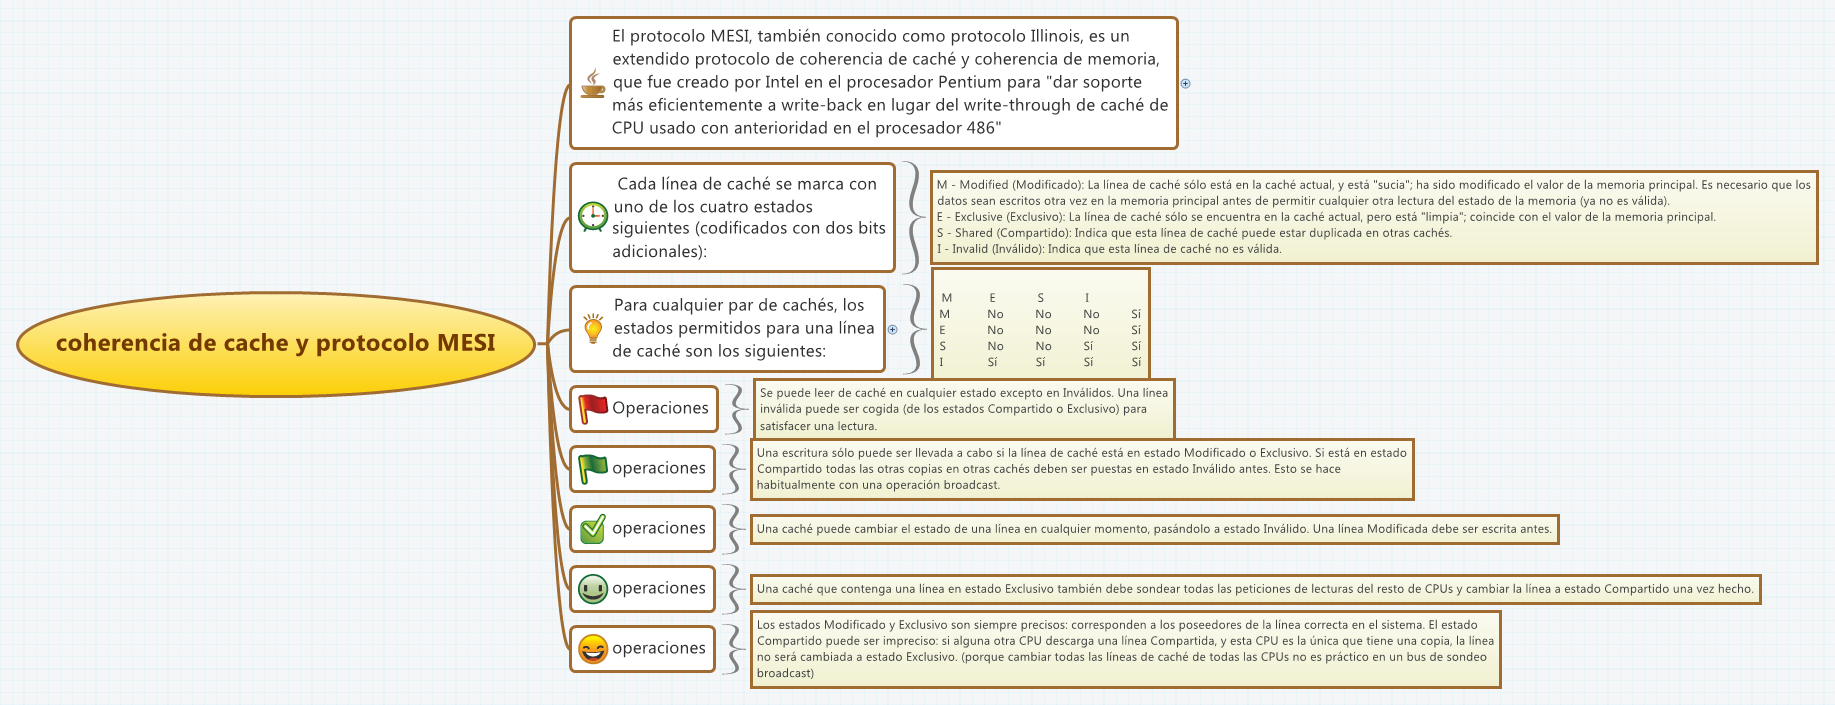
いずれの場合も、両方の方式はキャッシュライン内の追加の状態と制御ビットを利用します。各ラインには通常、その内容がRAMの内容と一致するかどうか、また、特定のプロトコル(MESI、MOESI、MSIなど)に応じて、共有、変更、排他、予約などに関する情報が含まれています。これにより、既に複製されたラインで読み取りまたは書き込み操作が発生した場合に、ハードウェアは迅速に処理を決定できます。
キャッシュとメモリ間の整合性をチェックする
CPUやGPUのすべてのキャッシュレベルとメインメモリ間の整合性を直接検証することは、設計の複雑さとパフォーマンスコストの両面で途方もない作業となる。そのため、現代のシステムではこの検証を階層的に行うようになっている。
プロセッサに最も近いキャッシュ(L1、L2)は通常、RAMに直接接続されるのではなく、次のレベルのキャッシュに接続されます。つまり、各レベルでメインメモリに対して整合性が検証されるのではなく、直上のレベルに対して検証されるということです。これにより、RAMへのアクセス回数が減り、下位レベルで必要なロジックが簡素化されます。
最終的に、キャッシュの内容とRAMの内容の比較は、最下位レベルのキャッシュとメインメモリの間で行われます。この最下位レベルが正しく一貫性のある状態を維持し、下位の各レベルも上位レベルとの一貫性を維持すれば、各行をRAMと繰り返し照合することなく、階層全体が一貫性を保つことができます。
カーネルがキャッシュラインに書き込み、そのデータを変更すると、そのラインの状態は、メモリに格納されているコピーと完全に一致しなくなったことを示すようにマークされます。そこから、プロトコルが更新を調整します。他のキャッシュ内の対応するコピーを予約済みまたは無効としてマークし、適切な場合に、新しい内容を関連するメインメモリラインに書き込みます。
このカスケード構造により、データを更新するカーネルからメインメモリへの変更は、制御された方法で各キャッシュレベルを通過しながら段階的に伝播されます。これにより、一貫性の維持がプロセッサにとって克服できないボトルネックとなることはありません。
ハードウェアの一貫性とソフトウェアの一貫性
これまで、プロトコル、ステータスビット、共有キャッシュなど、主にハードウェアで実装される一貫性メカニズムについて説明してきました。しかし、その複雑さの一部をソフトウェア、具体的にはコンパイラとオペレーティングシステムに移そうとする別のアプローチも存在します。
ソフトウェアベースの一貫性スキームは、コードを解析してコンパイル時に判断を下すことで、追加のオンチップロジックの必要性を低減しようとするものです。コンパイラが特定の共有データへのアクセスタイミングと方法を推測できれば、多くの場合、そのデータがキャッシュされるのを防いだり、その可視性を明示的に管理したりできるという考え方です。
このアプローチには明確な利点があります。処理負荷の一部が実行時解決からコンパイル時解決へと移行するのです。ハードウェアがすべての競合をその場で検出して処理する代わりに、コンパイラが競合を予測し、危険な状況を回避するコードを生成しようとします。
欠点は、静的コード解析には限界があるため、コンパイラが保守的になりがちであることだ。つまり、一貫性を損なわないようにするため、キャッシュの有効性を低下させるような判断を下すことが多い。データに問題がある可能性があると疑われる場合、そのデータのキャッシュを阻止したり、必要以上に頻繁に同期を強制したりすることが多い。
したがって、これらのソフトウェア方式は、特にハードウェア設計の簡素化という点では理論的には魅力的であるものの、実際にはCPU自体に統合されたコヒーレンスサポートを置き換えるものではなく、特定のシナリオにおいてそれを補完するものとなる。
キャッシュの一貫性におけるコンパイラの役割
ソフトウェアベースの一貫性アプローチにおける重要な要素の一つは、コンパイラの役割です。コンパイラはコードを詳細に分析し、どの共有データ構造がキャッシュに適さない可能性があるかを判断できます。そして、それに基づいて、これらの要素に特別なマークを付けたり、コード生成を調整したりします。
最も単純で、かつ最も保守的なアプローチは、共有データ変数をキャッシュしないようにすることです。つまり、これらの変数にアクセスするたびに、メインメモリまたはキャッシュ不可能な領域へのアクセスが強制されます。これにより一貫性は保証されますが、共有構造は実際には特定の期間にプライベートに使用されたり、他の期間に読み取り専用になったりする可能性があるため、多くのパフォーマンス向上の機会を逃すことになります。
実際には、一貫性の問題は、少なくとも1つのプロセスが変数に書き込み、別のプロセスがそれを読み取ることができる期間にのみ発生します。これらの重要な期間以外では、変数は単一のスレッド専用、あるいはしばらくの間は実質的な定数として扱われるため、問題なくキャッシュすることができます。
最も高度なコンパイル戦略では、共有変数が競合を起こさないとみなせる「安全な」期間を特定しようとします。そのため、コンパイラは実行パス、潜在的な同時アクセス、同期パターン(ロック、クリティカルセクションなど)を分析します。この分析に基づいて、変数の有効期間をいくつかのフェーズに分割します。一部のフェーズはキャッシュに適していますが、その他のフェーズでは特別な処理が必要です。
書き込みを伴う同時アクセスが検出された重要な期間には、コンパイラはキャッシュの一貫性を確保するために、生成されたコードに追加の命令を挿入します。これらの命令は、プログラミングモデルと基盤となるアーキテクチャに応じて、キャッシュのフラッシュ、メモリの再ロード、メモリバリア、またはキャッシュ不可としてマークされた領域へのアクセスを強制する場合があります。
コンパイラ、オペレーティングシステム、ハードウェアの関係
「コンパイラはキャッシュの一貫性を確保するために、生成されたコードに命令を挿入する」という表現から、オペレーティングシステムがこれらの命令を高レベルのヒントのように読み取り、それに基づいてプログラムの実行方法を決定すると考える人もいるかもしれない。しかし実際には、その仕組みはやや異なる。
コンパイラがこれらの命令を追加すると、バイナリに導入されるのは、アーキテクチャまたは実行環境によってサポートされている特定の操作です。たとえば、キャッシュフラッシュ命令、メモリバリア、領域をキャッシュ不可としてマークする特別な命令、またはメモリ属性を設定するオペレーティングシステムサービスへの呼び出しなどを挿入できます。
オペレーティングシステムは、これらの命令をコンパイラによって記述された高レベルの「コメント」や「ヒント」として解釈するのではなく、他の命令と同様にマシンコードを実行します。ただし、これらの命令の中には、メモリサブシステムやキャッシュ管理と連携するように設計されており、CPUが特定のデータにアクセスする方法を変更するものもあります。
言い換えれば、コンパイラは予備的な解析を行い、実行時に目的のキャッシュ動作を実現するコードを生成します。オペレーティングシステムは、メモリ属性(キャッシュ可能領域またはキャッシュ不可能領域、書き込みポリシーなど)を設定したり、同期プリミティブを提供したりすることで協力しますが、コンパイラのように特殊命令を意味的に解釈するという意味で「読み取る」わけではありません。
また、ハードウェアが特定の命令を検知すると、特定の整合性メカニズムや同期メカニズムが作動することもあります。例えば、フェンス命令やバリア命令は、メモリへのアクセス順序を保証し、キャッシュ階層全体にわたって特定の可視性効果を強制します。この場合、コンパイラがこれらの命令の配置場所を決定し、オペレーティングシステムが実行環境を構成し、ハードウェアがキャッシュおよびメモリバスレベルで実際の動作を実装するという、三者間の連携が行われます。
これらの要素すべてが連携することで、同じデータの複数のコピーが異なるキャッシュやメインメモリに分散されていても、並列プログラムが一貫したメモリモデルで実行されることが保証されます。キャッシュの一貫性は、単なるCPU内部の詳細ではなく、マルチコアシステムが信頼性と効率性を維持して動作するための中心的な要素となります。
キャッシュ階層、ハードウェアコヒーレンスプロトコル、ソフトウェアサポート技術がどのように組み合わさっているかを理解することで、現代のCPU設計がなぜこれほど類似した構造を共有しているのか、そしてこれらのメカニズムのいずれかにわずかな不具合が生じると、すべてのコアが適切なタイミングで同じデータを参照することに完全に依存している並行アプリケーションで、なぜ混沌とした動作を引き起こす可能性があるのかがより明確になります。