- LiteRTは、モバイル、デスクトップ、IoTデバイス上でAIを実行するためのGoogleの汎用フレームワークとして、TensorFlow Liteに取って代わります。
- NPU、GPU、CPUを活用することで推論を最適化し、従来のCPUと比較して最大100倍の速度向上を実現しています。
- LiteRT-LMは、LLMやGemmaなどの生成モデルのオーケストレーションに特化しており、メモリ管理とローカルコンテキストを改善します。
- PyTorch、JAX、TensorFlowとの完全な互換性を提供し、モデルを.tflite形式にスムーズに変換することを可能にします。

生成型人工知能は驚異的な進歩を遂げており、もはやデータをクラウドに送信して応答を待つだけではありません。今や、モバイル端末やエッジ環境など、デバイス上で全てを直接実行することが最重要課題となっています。これにより、ユーザー体験は瞬時に向上し、何よりもデータプライバシーが外部サーバーに依存しないようにすることが可能になります。
こうした背景から、Googleが開発した新しい標準規格であるLiteRTが登場しました。これは、長年使われてきたTensorFlow Liteに代わるものです。単なるパッチではなく、スマートウォッチからWindows PCまで、あらゆるプラットフォーム上で強力なAIモデルを展開し、利用可能なハードウェアを最大限に活用できるように設計された、汎用的なインフラストラクチャです。

LiteRTとは何か、そしてなぜ画期的な技術なのか?
LiteRTは、TensorFlow Liteの後継として開発され、ハードウェアの断片化という課題に対処するために誕生しました。従来の機械学習は画像認識のような単純なタスクに重点を置いていましたが、GenAIはより積極的なリソース管理を必要とします。このフレームワークは、デバイスがAndroid、iOS、macOS、Linux、あるいはWebアプリケーションであっても、再現性と効率性に優れた推論を可能にします。
スタートアップを立ち上げたり、テクノロジー製品を開発したりする人にとって、これはまさにパラダイムシフトです。モデルをローカルで実行することで、レイテンシが大幅に削減され、サードパーティAPIの継続的なコストが不要になるため、インターネット接続がなくてもアプリケーションを完全に機能させることができます。
アクセラレーションエンジン:CPU、GPU、NPUのパワー

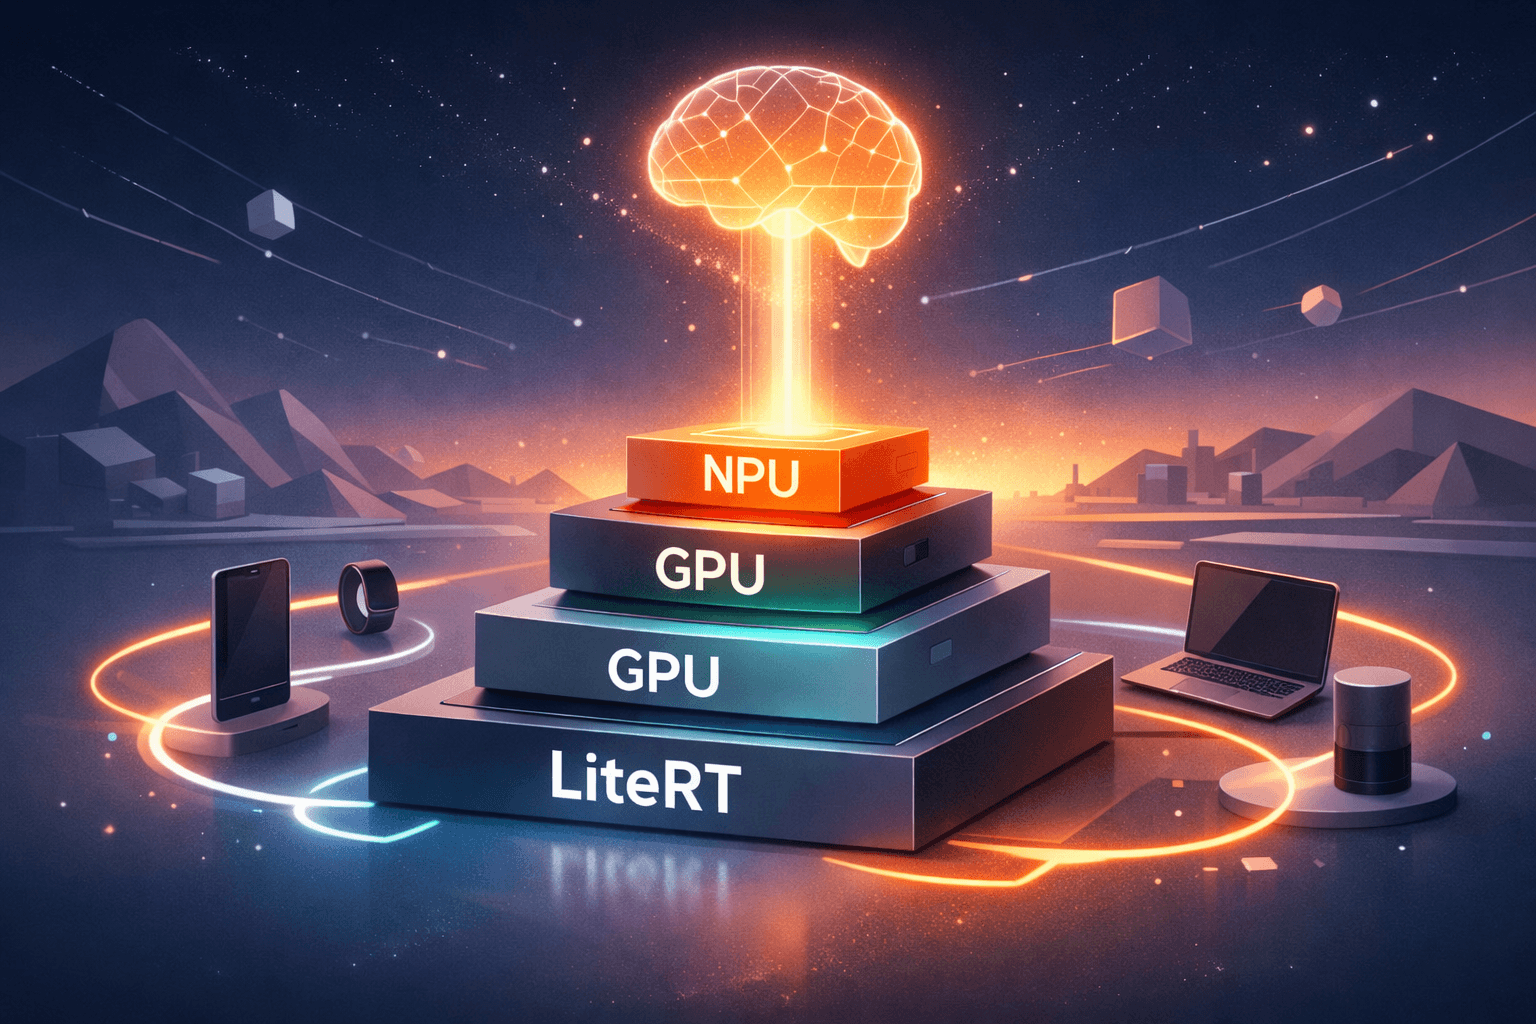
LiteRTの真の強みは、各チップから性能を最大限に引き出す能力にあります。ML Driftと呼ばれるエンジンのおかげで、システムはMetal、OpenCL、OpenGL、WebGPUといった様々なAPIを使用してGPUアクセラレーションを管理できます。実際、Androidでは、ランタイムはOpenCLが利用可能であれば自動的にOpenCLを優先し、OpenGLはあくまでバックアップとしてのみ使用するという賢い設計になっています。
しかし、LiteRTが真価を発揮するのは、そのNPU(ニューラルプロセッシングユニット)にあります。Qualcommとの共同開発により、QNNアクセラレータは、特定のシナリオにおいてCPUの最大100倍、GPUの最大10倍の速度向上を実現します。これにより、AIは低速な実験段階から、実用的な生産ツールへと進化を遂げます。
LiteRT-LM:生成AIとLLMの連携
大規模言語モデル(LLM)について語る場合、それらは単純なモデルではなく複雑なパイプラインであるため、話は複雑になります。そこで登場するのがLiteRT-LMです。これは、メモリ、バッファ、コンテキストを効率的に管理する専用のオーケストレーションレイヤーです。Pixel WatchやChromeのGemini Nanoにも採用されている技術です。

プログラマーの作業を容易にするため、GoogleはLiteRT Torch Generative APIを搭載しました。このツールを使用すると、PyTorchベースのモデルを簡単に変換でき、Gemmaのようなオープンモデルをデバイス上で超高速に実行できます。実際のベンチマークテストでは、LiteRTはハードウェアをより効率的に活用することで、プリフィルとデコード速度においてllama.cppを上回ることが実証されています。
技術革新:ゼロコピーと非同期実行
モバイルAIにおける一般的なボトルネックの一つは、CPUとアクセラレータ間のデータ転送です。LiteRTは、メモリ内での不要なデータ重複を防ぐゼロコピーバッファ管理によってこの問題を解決します。まるでモデルが情報をその場所から直接読み取っているかのように動作するため、背景セグメンテーションなどのタスクが最大2倍高速化されます。
さらに、新しいCompiledModel APIでは、推論を非同期で実行できます。これにより、AIがデータを処理している間もアプリケーションがフリーズすることがなくなり、ユーザーインターフェースのスムーズさが向上します。システムはハードウェアをリアルタイムで評価し、開発者が各チップ専用のコードを記述する必要なく、最適なアクセラレータを選択します。
フレームワークの柔軟性と戦略的な展開
一番の利点は、特定の言語に縛られないことです。LiteRTはPyTorch、JAX、TensorFlowに対応しています。既にトレーニングパイプラインを構築済みの場合でも、それを破棄する必要はありません。モデルを.tflite形式に変換し、サポートされている任意のオペレーティングシステムにデプロイできます。
企業にとって、これを実現するには明確な戦略が必要です。モデルだけでは不十分で、必要に応じてAIを拡張できるように、カスタムソフトウェア開発とクラウドコンピューティングインフラストラクチャを組み合わせる必要があります。さらに、AIをデバイスに導入する際には、機密情報がユーザーのハードウェアから決して漏洩しないようにすることが不可欠であるため、サイバーセキュリティが極めて重要になります。
この標準規格を採用することで、リアルタイムで応答する自律型エージェントの作成が可能になり、高価なサーバーへの依存度を低減できます。現在ローカル推論を統合している組織は、クラウドのみに依存し続けている組織と比較して、コスト、プライバシー、応答速度の面で大きな競争優位性を獲得できるでしょう。
