- テキスト、画像、オーディオ、ビデオ、リアルタイム ストリーミングを備えたネイティブ オムニモーダル モデル。
- 22/36 オーディオ/ビデオ ベンチマークおよび多言語 (119/19/10 言語) での SOTA。
- MoE、低レイテンシ、システムプロンプト制御を備えた Thinker-Talker アーキテクチャ。
- vLLM/Transformers、Docker、公式ユーティリティを使用したデプロイメントをお勧めします。
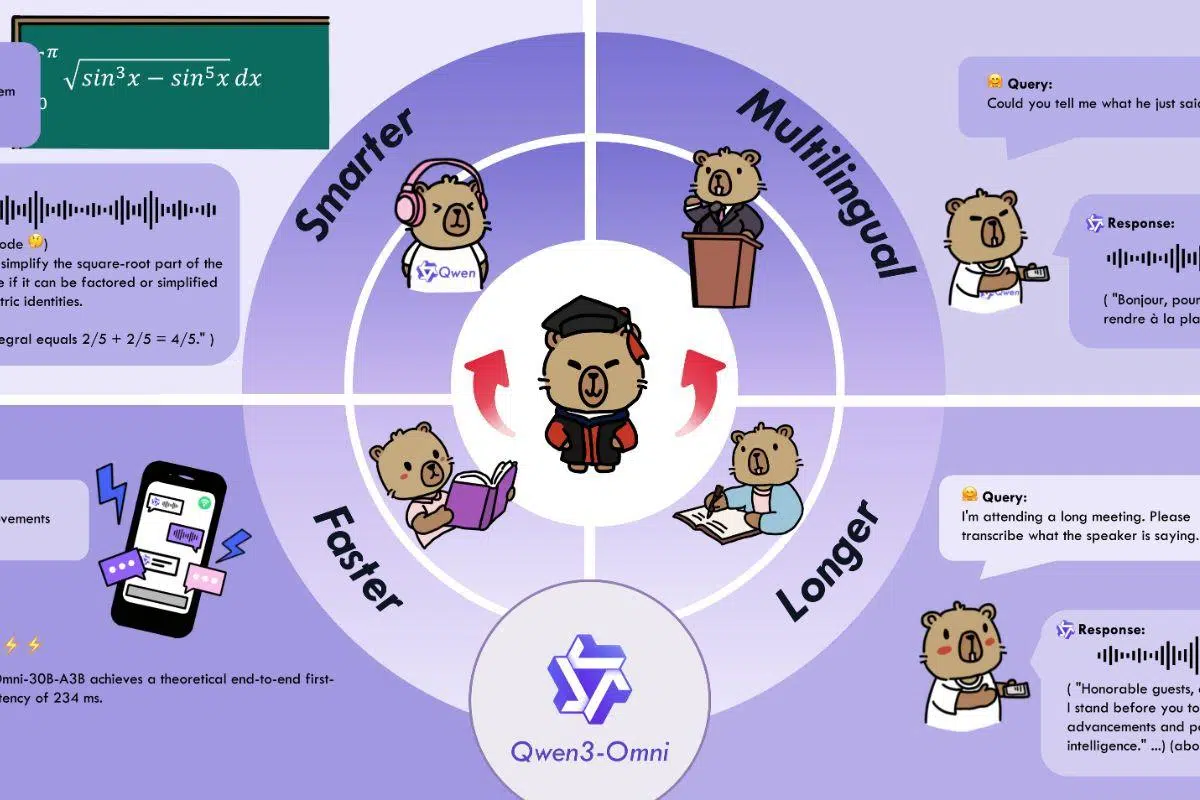
Qwen3-Omniの登場は、AIのあり方を大きく変えました。テキスト、画像、音声、動画を理解し、それらに応答できる単一のネイティブモデルであり、書面と音声の両方でリアルタイムに応答します。これは、マルチモーダルな「パッチ」ではなく、低遅延と微調整された動作制御で様々なモダリティを統合するための、根本的に設計されたアーキテクチャなのです。
ほぼすべての企業がチャットボットやアシスタントをテストしている今、Qwen3-Omniは野心的な製品として登場しました。テキストによる119言語のサポート、19言語での音声認識、10言語での音声発話、最大30分までの長尺音声の理解、そして数十種類のテストでベンチマークスコアを獲得しています。さらに、Thinker-Talker設計とMixture of Expertsアプローチにより、実世界のシナリオにおける応答速度と推論の質の向上を目指しています。
Qwen3-Omni とは何ですか? 何を提供しますか?
Qwen3-Omniは、テキスト、画像、音声、動画を処理し、テキストと自然音声の両方で出力できるように設計された、基盤となるオムニモーダルなエンドツーエンドの多言語モデル群です。その鍵は、多様な入出力だけでなく、流暢な会話ターンと即時応答能力を備えたストリーミング機能にもあります。
チームは、パフォーマンスと効率性を向上させるために、いくつかのアーキテクチャ上の改善を導入しました。具体的には、早期の「テキスト優先」事前学習とマルチモーダル学習の組み合わせ、そしてテキストと画像におけるパフォーマンスを維持しながら音声と動画のパフォーマンスを向上させるエキスパート混合モデル(MoE)を用いた設計です。これらの改善により、このモデルは36の音声/動画ベンチマークのうち22でSOTA(最先端)を達成し、オープンソースのベンチマークでは36のうち32でSOTAを達成しました。また、音声認識、音声理解、音声会話においては、Gemini 2.5 Proに匹敵する結果となっています。
主な機能とモダリティ
Qwen3-Omniは、119のテキスト言語、19の音声入力言語、10の音声出力言語という広範な多言語サポートを備え、実際のオーディオ、ビジョン、およびオーディオビジュアルアプリケーションに対応しています。音声入力言語には、英語、中国語、韓国語、日本語、ドイツ語、ロシア語、イタリア語、フランス語、スペイン語、ポルトガル語、マレー語、オランダ語、インドネシア語、トルコ語、ベトナム語、広東語、アラビア語、ウルドゥー語が含まれます。出力言語には、英語、中国語、フランス語、ドイツ語、ロシア語、イタリア語、スペイン語、ポルトガル語、日本語、韓国語などが含まれます。
公式クックブック群は、その幅広い用途を示しています。音声分野では、多言語および長尺音声の音声認識(ASR)、音声テキスト変換および音声音声変換、音楽分析(スタイル、リズム、ジャンル)、効果音の説明、あらゆる音声への字幕生成といった機能を備えています。また、音声、音楽、環境音を含むトラックの混合分析にも対応しています。
視覚分野では、複雑な画像に対する「ハード」OCR、物体検出と位置特定、画像品質保証、画像演算(Thinkingモデルが真価を発揮する分野)、ビデオ説明、一人称視点のビデオベースナビゲーション、シーン遷移分析を提供します。視聴覚分野では、時間同期による音声・映像品質保証、 AV入力とのガイド付きインタラクション、アシスタントの動作との対話を実現します。
エージェントとして際立っているのは、音声からの通話機能です。これにより、ツールを起動する音声ワークフローが実現します。また、派生タスクには、詳細な字幕を作成するためのOmni-Captionerがあり、基盤となるエージェントの汎用性を示しています。
MoEによる思考・対話型建築とデザイン
重要な差別化要因の一つは、役割分担の明確化です。思考型(Thinker)はテキストを生成し(思考の流れを明示的に示すバリエーションも含む)、話型(Talker)はリアルタイムの音声を生成します。この分離により、システムは高いレベルのテキスト理解と計画性を維持しながら、自然な音声会話を実現できます。
MoEデータベースは、専門家間でワークロードを分散させ、強力な汎用表現を実現するためにAuTの事前学習に依存しています。さらに、音声チャネルでマルチコードエンコーディングを使用することで遅延を最小限に抑え、100分の1秒が重要となる通話やアシスタントにとって不可欠な機能を実現しています。
パフォーマンスとベンチマーク: テキスト、ビジョン、オーディオ、オーディオビジュアル
Qwen3-Omniは、単一モードに特化した同サイズのQwenモデルと比較して、テキストと画像のパフォーマンスを低下させることなく最先端の性能を維持しています。また、オーディオとオーディオビジュアルのパフォーマンスでは、ほとんどのテストでトップクラスの性能を発揮します。36のオーディオおよびオーディオビジュアルベンチマークにおいて、32でオープンソースSOTA、22で総合SOTAを達成し、Gemini 2.5 ProやGPT-4oを数ポイント上回りました。
テキスト処理における注目すべきマイルストーンとしては、 AIME25ではFlash-Instructのバリアントが約65,9のスコアを獲得し、ZebraLogicではInstructが90に達し、MultiPL-EではGPT-4oに匹敵するスコアを達成しています。IFEvalやWritingBenchなどのアライメントタスクでは、InstructとThinkingモデルは高いスコアを安定して示しています。
音声に関しては、中国語と英語のASRの結果は非常に優れています。WenetSpeechとLibriSpeechでは単語エラー率が大幅に低下し、LibriSpeech clean/otherでは1,22/2,48に近い数値を示し、FLEURS(多言語)のようなセットでは非常に低いエラー率を実現しています。VoiceBenchでは、AlpacaEval、CommonEval、WildVoiceなどの指標でQwen3-Omniはクローズドリファレンスシステムと同等の性能を示し、 MMAU v05.15.25では音声推論において優れた性能を発揮します。
オーディオビジュアルアプリケーションでは、最も頻繁に引用される指標はWorldSense(約54,1)で、Gemini-2.5-Flashを上回っています。さらに、DailyOmniやVideoHolmesなどのスイートでは、 Thinkingバリアントは以前のオープンソースSOTAアプリケーションよりも優れた性能を発揮しています。純粋な画像処理においては、MMMU、MathVista、MathVision、および文書理解(AI2D、ChartQA)で優れた性能を発揮し、カウント(CountBench)およびビデオ理解(Video-MME、MLVU)でも非常に高いスコアを獲得しています。
ゼロショット音声生成も測定されました。CosyVoiceやSeed-TTSのようなファミリーと比較すると、Qwen3-Omniは複数の言語でコンテンツの一貫性が高く、話者の類似性も高いことがわかります。多言語セクションでは、「コンテンツの一貫性」と「話者の類似性」の表から、Qwen3-Omni 30B-A3Bは中国語と英語で非常に競争力があり、ドイツ語、イタリア語、ポルトガル語、スペイン語、日本語、韓国語、フランス語、ロシア語で堅実であることがわかります。クロスリンガルTTSでは、CosyVoice 2/3と比較して、いくつかのペア(例:zh→en、ja→en、ko→zh)でWER/一貫性が向上しています。
利用可能なモデルとそれぞれの用途
Qwen3-Omniシリーズは、それぞれ特定の用途向けに設計された3つの主要コンポーネントで構成されています。それらは、 Instruct(指示)、Thinking(思考)、Captioner(キャプション)です。これらはすべて同じコアをベースにしていますが、特定のタスクに合わせて異なる機能が有効化または微調整されています。
Qwen3-Omni-30B-A3B- Instructは、ThinkerとTalkerを搭載し、音声、動画、テキストを受け付け、テキストと音声を返します。完全な対話とリアルタイムの音声結果が必要な場合に最適な選択肢であり、音声または動画デモにおすすめです。
Qwen3-Omni-30B-A3B- Thinkingは、連鎖推論による思考力に焦点を当て、音声、動画、テキスト出力に対応しています。詳細な分析、複雑な問題の解決、視覚的な数学、あるいは音声出力は不要だが構造化された思考が求められるワークフローなどに役立ちます。
Qwen3-Omni-30B-A3B- Captionerは、高精度かつ低負荷な音声字幕生成技術を洗練させた派生版です。オープンソースであり、幅広い種類の音声を詳細にカバーし、汎用音声向けの信頼性が高く豊富な字幕という、オープンソースのエコシステムにおける長年の空白を埋めます。
レイテンシー、リアルタイム、行動制御
このシステムは即時対話に最適化されており、音声応答時間は約211ミリ秒、音声・映像応答時間は約507ミリ秒です。ストリーミングに加え、思考者(テキスト)と話者(音声)の明確な役割分担により、自然な会話のやり取りと安定した音声配信が実現されています。
微調整を行うには、システムプロンプトを使用してスタイルをカスタマイズできます。ビデオ音声を参照として使用するAVシナリオでは、思考者の推論を維持しつつ、より読みやすく会話的なテキストを提供するシステムプロンプトを推奨します。これにより、話者が流暢に話せるようになります。また、複数ターンにわたる会話では、`use_audio_in_video`パラメータを常に一定に保つことをお勧めします。
評価においては、特定のガイドラインがあります。システムプロンプトを設定しないこと、各ベンチマークのChatML形式に従うこと、プロンプトがない場合は、デフォルトで以下を使用することです。中国語ASR(「この段中文语音を罬换为纯文本。」)、その他の言語のASR(「音声をテキストに書き起こしてください。」)、S2TT(「提供された<source_language>の音声を聞いてください…」)、および歌詞(「歌詞を書き起こしてください」…句読点なしで、改行で区切って)。
展開、要件、ツール
完全なローカル環境を実現するには、Hugging Face Transformersとソフトウェアエンジニアリングの各フェーズを確認することを推奨しますが、注意点として、MoE アーキテクチャであるため、HF 推論では動作が遅くなる場合があります。本番環境や低遅延アプリケーションには、 vLLM または DashScope API の使用を推奨しており、両方の環境を含む Docker イメージも提供しています。Transformers のコードは既にマージされていますが、PyPI パッケージはまだリリースされておらず、ソースからインストールする必要があります。
これらは、音声や画像/動画(base64、URL、インターリーブ入力)を処理するためのユーティリティを提供し、float16またはbfloat16を読み込む際にGPUメモリを削減するために、Transformersを使用したFlashAttention 2を推奨しています。vLLMではFlashAttn2が組み込まれており、 limit_mm_per_prompt(GPUメモリを事前割り当て)や並列処理用のmax_num_seqsなどのパラメータが詳しく説明されています。さらに、 tensor_parallel_sizeを増やすことで、マルチGPU推論が可能になります。
リソースを節約するための便利なヒントがいくつかあります。音声が必要ない場合は、初期化後にトーカを無効にすることで、約 10 GB の VRAM を節約できます。また、テキスト出力を高速化したい場合は、生成時に`return_audio=False`を使用してください。FlashAttn2 を使用した BF16 の理論上の最小メモリ要件も提供されています。たとえば、Instruct 30B-A3B は、15 秒のビデオで約 78,9 GB 、120 秒で 144,8 GB を使用します。Thinking は、それぞれ約 68,7 GB と 131,7 GB を使用します。
ローカルのWeb デモをセットアップするには、vLLM 環境 (またはより低速な Transformers 環境) を準備し、ffmpegがインストールされていることを確認し、スクリプトを使用することをお勧めします。NVIDIA Container Toolkit、ポート マッピング (例: ホスト 8901 → コンテナ 80)、および 0.0.0.0 から提供するオプションを備えた GPU 対応の Docker イメージ「qwenllm/qwen3-omni」が提供されています。必要に応じて、コンテナを再投入または削除できます。
デモ、API、エコシステム
ローカル環境にデプロイしたくない場合は、Hugging Face SpacesとModelScope Studioでデモをお試しいただけます。Qwen3-Omni-Realtime、Instruct、Thinking、Captionerの機能を体験できます。リアルタイムストリーミング対応のQwen Chatも利用可能です。インターフェースで音声/ビデオ通話オプションを選択するだけです。
低遅延でスケーラブルな統合を実現するには、最も予測可能なパフォーマンスを提供するDashScope APIが推奨されます。さらに、コミュニティはDiscordやWeChatなどのチャネルを通じて連携し、ユーザーがプロンプトやモデルを変更することで結果を再現できる、実際の実行ログを含むクックブックを公開しています。
ロードマップと継続的な改善
チームは、複数話者音声認識、ビデオへのOCR適用、プロアクティブな視聴覚学習の改善、よりリッチなエージェントワークフローといった追加機能の開発に取り組んでいます。また、Instructモデル向けのvLLMにおける音声出力サポートが間もなく利用可能になり、そのバックエンドからのリアルタイム展開サイクルが完了する予定であることも明らかにしました。
FAQ: ランタイムサポートと量子化
一部のユーザーからは、通常のツールを使っても Qwen3-Omni を実行できないことや、Hugging Face でクオンツが表示されないというコメントが寄せられています。さらに、ネイティブの 16 ビット形式は約 70 GB で、控えめなコンピュータでは問題となるサイズです。プロジェクト自体では、Transformers は既にマージされているものの PyPI パッケージは含まれておらず、ソースからインストールする必要があること、また、推論には vLLM が推奨されるオプションであること、ただし vLLM での Instruct オーディオ サポートは近い将来リリースされる予定であることが明確にされています。
量子化に関しては、HFにはまだQwen3-Omni 30B-A3B用のプレースホルダーは登録されていません。また、MoEとマルチモーダルな性質により、llama.cppなどのランタイムとの即時互換性が複雑になることを覚えておく必要があります。今すぐテストする必要がある場合は、公式の推奨事項として、ソースまたはAPIからDocker + Transformers/vLLMを使用し、サポートのプルリクエストや今後の量子化が利用可能になった際にリポジトリを注視してください。
優れた評価の実践と促進
これらの数値を再現するために、以下のガイドラインを詳しく説明します。ほとんどのベンチマークでは、サンプリングなしでInstructのグリーディデコーディングを使用し、Thinkingではgeneration_config.jsonのパラメータを遵守する必要があります。また、評価中はビデオのフレームレートをfps=2に設定し、データセットで特に指定がない限り、ユーザープロンプトはマルチモーダルデータに従う必要があることを示しています。
ベンチマークにプロンプトが含まれていない場合は、デフォルトのプロンプト(中国語ASR/その他、S2TT、歌詞)を使用できます。また、システム間および実行間で結果を比較できるように、評価中はシステムプロンプトを設定しないでください。
Qwen3-Omniは、低遅延、幅広い多言語対応、最先端のオーディオおよびビデオ機能、そしてTransformers、vLLM、Dockerを使用した明確な導入パスを備えた、真のオムニモーダルプラットフォームとして位置づけられています。パフォーマンスを犠牲にすることなくテキストと画像をシームレスに処理し、さらに音声の聞き取り、音声の発信、ビデオの理解も可能な単一のモデルを求めるユーザーにとって、Qwen3-Omniは今日において他に類を見ない魅力的なソリューションと言えるでしょう。