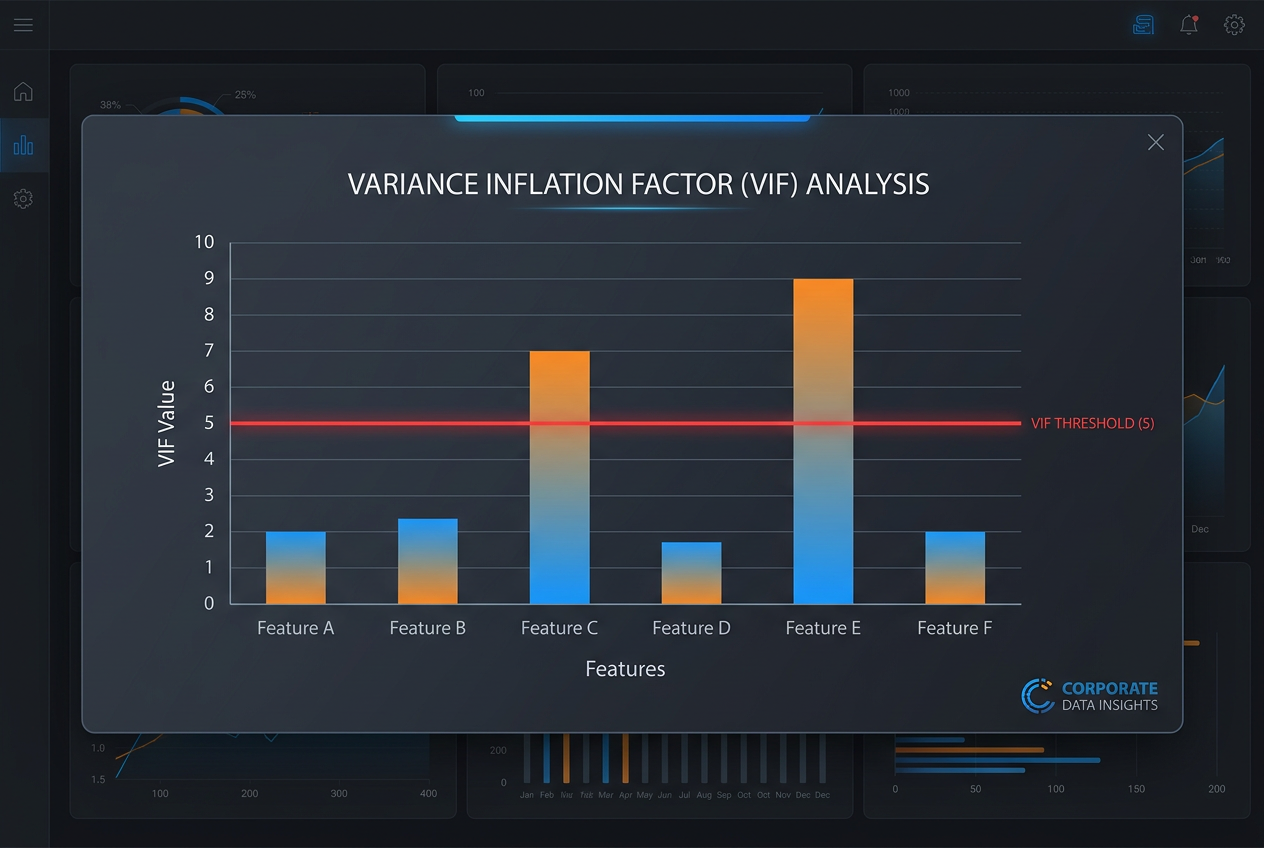
- VIF leidžia aptikti daugiakolineariškumą regresijos modeliuose, o tai yra labai svarbu, kai vertės viršija 5 ribą.
- Įgyvendinimas C# kalba reikalauja duomenų standartizacijos, siekiant užtikrinti skaitinį stabilumą ir išvengti tikslumo klaidų.
- Švarus kodo dizainas turėtų atskirti išorinius išteklius, duomenų būseną ir elgesio logiką, siekiant optimizuoti našumą.
Jei esate išdrįsę pasinerti į duomenų analizės pasaulį, tikriausiai esate susidūrę su multikolinearumo galvos skausmu. Iš esmės tai atsitinka, kai jūsų nepriklausomi kintamieji yra per glaudžiai susiję, o tai gali sutrikdyti jūsų regresijos modelio veikimą ir duoti nepatikimus rezultatus. Siekiant įvesti tvarką šiame chaose, pasitelkiamas dispersijos infliacijos koeficientas (VIF) – pagrindinė priemonė, padedanti nustatyti, kurie kintamieji sukelia problemą.
Nors galingos bibliotekos egzistuoja tokiose kalbose kaip R ar Python, šios koncepcijos įgyvendinimas C# reikalauja tvirto pagrindinės matematikos supratimo ir to, kaip struktūrizuoti kodą, kad jis būtų lengvai prižiūrimas. Svarbu ne tik paleisti po vieną funkciją, bet ir organizuoti programavimo logiką taip, kad programinė įranga būtų lengvai skaitoma ir efektyvi, neleisdama kodui priminti paslaptingo raidžių kratinio.

VIF ir daugiakolinearumo supratimas
Dispersijos infliacijos koeficientas (VIF) – tai matas, rodantis, kiek padidėja įvertinto koeficiento dispersija dėl jo koreliacijos su kitais modelio kintamaisiais. Paprastai tariant, jei kintamojo VIF yra labai aukštas , tai reiškia, kad didelę dalį jo informacijos jau apima kiti kintamieji, todėl standartinės paklaidos smarkiai padidėja ir labai sunku nustatyti, kuris kintamasis iš tikrųjų daro įtaką rezultatui.
Daugelis analitikų vadovaujasi tokia nykščio taisykle: jei VIF reikšmė yra didesnė nei 5 , susiduriame su multikolinearumo atveju. Ekstremaliose situacijose reikšmė, didesnė nei 10, yra aiškus ženklas, kad kintamąjį reikia peržiūrėti arba pašalinti iš duomenų rinkinio, kad būtų išvalytas modelis ir pagerintas skaitinis stabilumas.
Techninis ir loginis įgyvendinimas C# kalba
Norint apskaičiuoti konkretaus kintamojo VIF projektavimo matricoje, procesas apima to kintamojo traktavimą taip, tarsi jis būtų priklausomas kintamasis, ir tiesinės regresijos atlikimą, naudojant visus kitus nepriklausomus kintamuosius kaip prognozuojančius veiksnius. Rezultatas yra determinacijos koeficientas R², o VIF apskaičiuojamas pagal formulę 1 / (1 – R²).
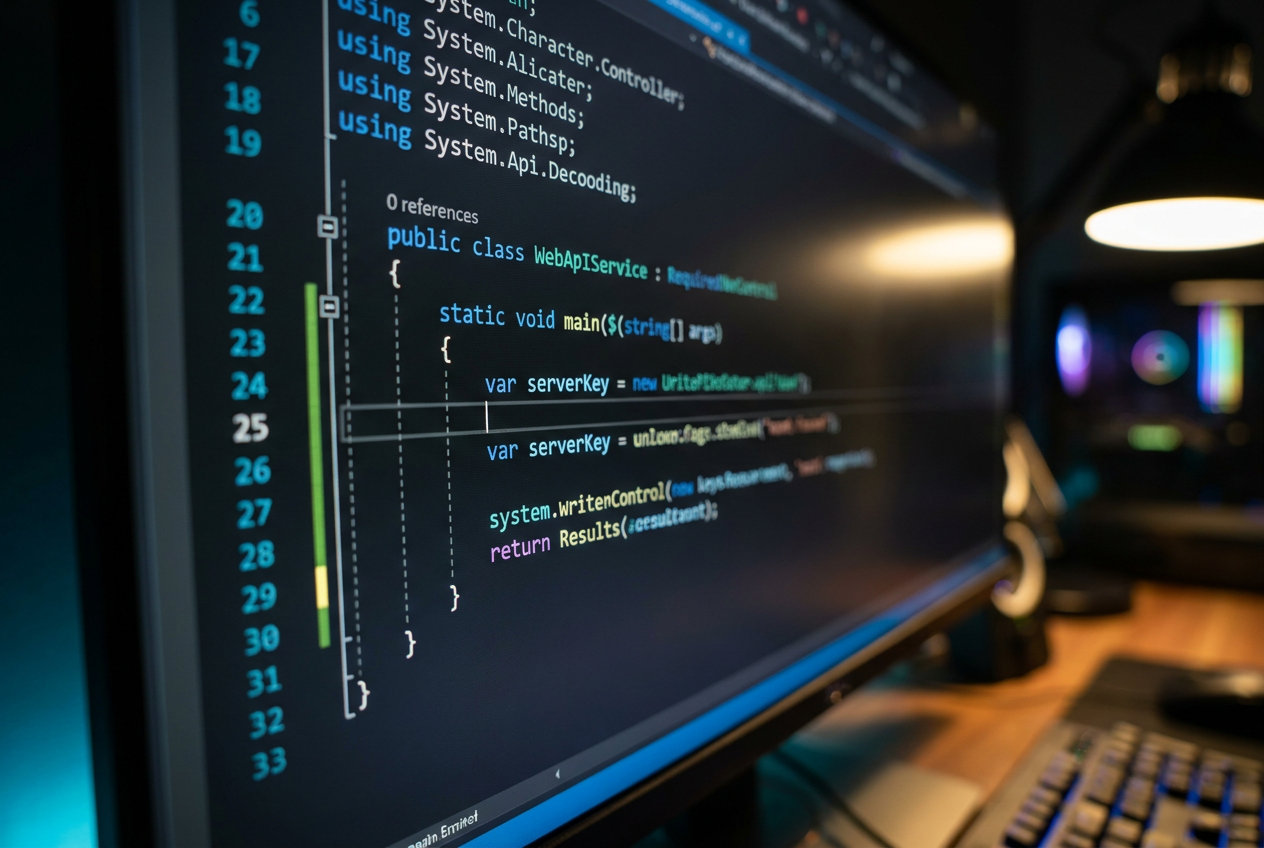
Programuojant tai C# kalba, labai svarbu atkreipti dėmesį į skaitinį stabilizavimą . Geriausia praktika yra standartizuoti projektavimo matricos stulpelius, nustatant vidurkį į 0, o standartinį nuokrypį – į 1. Tai labai svarbu dirbant su labai skirtingo mastelio duomenimis arba netiesinėmis transformacijomis, nes tai apsaugo programą nuo gedimų dėl dešimtainio tikslumo klaidų.
Švaraus kodo projektavimo principai
Be pačios formulės, viską lemia tai, kaip rašome kodą C# kalboje. Dažna klaida yra kurti objektus, kurie atlieka tai, kam jie nėra skirti; pavyzdžiui, „Ball“ klasė turi „Throw()“ metodą, kuris neturi prasmės, nes kamuolys pats savęs nemeta. Kodas turėtų būti skaitomas kaip gerai parašyti sakiniai , kuriuose subjektas atlieka nuoseklų veiksmą su objektu.
- Išoriniai ištekliai: Jie turėtų būti tvarkomi atskiru abstrakcijos lygmeniu, idealiu atveju naudojant priklausomybių injekciją.
- Būsena ir duomenys: Duomenimis pagrįstas kodas turėtų atitikti objektinio programavimo (OOP) principus.
- Elgesys: Logika ir algoritmai turėtų veikti kaip grynos funkcijos, kurių parametrai yra duomenys ir ištekliai.
Projektui organizuoti siūloma hierarchija, kuri prasideda nuo vardų erdvės, didėjant sudėtingumui pereina per statines klases ir baigiasi įprastomis klasėmis. Pageidautina grupuoti susijusias klases tame pačiame faile, jei jos turi tą pačią problemą, tai padeda kompiliatoriui optimizuoti dvejetainį failą ir pagerina vykdymo laiką geriau valdant talpyklą ir procesoriaus registrus.
Alternatyvos ir duomenų vizualizacija
Nors C# yra tvirta įgyvendinimo kalba, tokios priemonės kaip R dažnai naudojamos greito naršymo aplinkose. Šioje kalboje tokios bibliotekos kaip „car“ leidžia beveik akimirksniu apskaičiuoti VIF. Gavus reikšmes, idealu nepasikliauti vien skaičiais, o naudoti juostines diagramas, kad būtų galima vizualiai nustatyti multikolinearumo šaltinius.
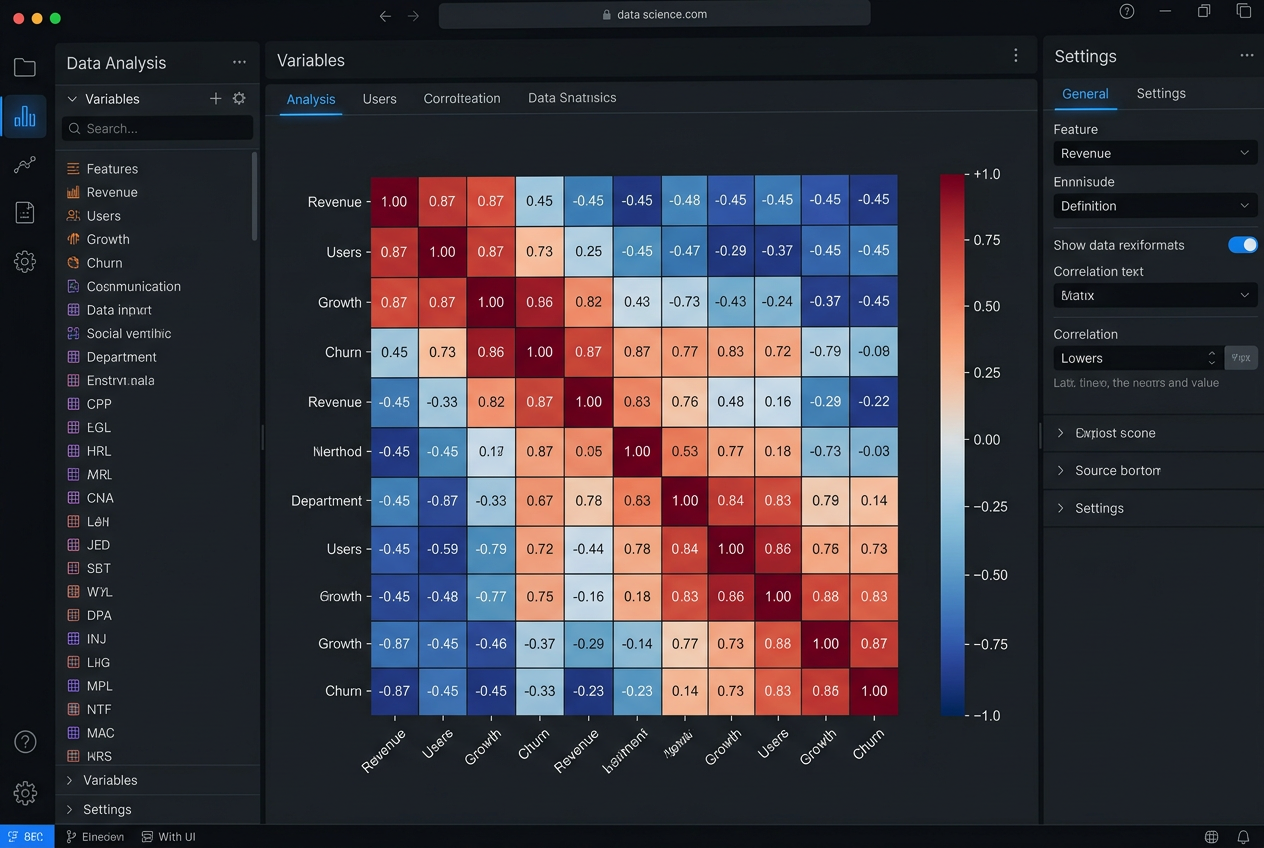
Analizės papildymas koreliacijos matrica yra labai svarbus žingsnis. Kintamųjų tarpusavio ryšio vizualizavimas naudojant spalvas leidžia suprasti ne tik tai, kad yra VIF problema, bet ir tiksliai kuri kintamųjų pora sukelia konfliktą. Šis statistinės analizės ir vizualizacijos derinys užtikrina, kad galutinis modelis būtų tikslus, o ne tiesiog kortų namelis.
Tinkamas VIF valdymas kartu su programinės įrangos architektūra, pagrįsta viena atsakomybe ir standartizuota duomenų struktūra, leidžia kurti galingus ir lengvai prižiūrimus C# analizės įrankius. Pašalindami duomenų perteklių ir taikydami nuoseklius projektavimo principus , mes transformuojame šifruotą kodą į profesionalų sprendimą, galintį visiškai patikimai apdoroti sudėtingas regresijas.