- VibeVoice ir Microsoft TTS modelis, kas spēj ģenerēt garu, izteiksmīgu, vairāku skaļruņu audio, kas ir ideāli piemērots podkāstiem un audiogrāmatām.
- Tās arhitektūra apvieno runas tokenizerus, lielu valodas modeli un difūziju, lai panāktu dabiskas balsis pat audio ierakstos, kuru garums ir līdz 90 minūtēm.
- Tas ļauj reaģēt gandrīz reāllaikā ar nelielām variācijām, taču tas ir jāizmanto atbildīgi, jo pastāv balss klonēšanas un dziļviltojumu risks.
- Tas ir izlaists kā atvērtā pirmkoda pētniecības ietvars, lai gan Microsoft ir īslaicīgi ierobežojis repozitoriju bažu dēļ par ļaunprātīgu izmantošanu.

Microsoft VibeVoice ieviešana revolucionizē podkāstu un garas formas audio satura veidošanas veidu, izmantojot mākslīgo intelektu. Šis atvērtā pirmkoda TTS (teksta pārveidošanas runā) modelis ne tikai ģenerē hiperreālistiskas balsis, bet arī ļauj veidot sarunas ar vairākiem runātājiem un ilgumā, kas var sasniegt pat 90 minūtes, bez neērtiem pārrāvumiem vai kvalitātes kritumiem.
VibeVoice mērķis ir nodrošināt ikvienam virtuālu ierakstu kabīni, kas spēj profesionāli veidot podkāstus, audiogrāmatas vai stāstījumus no datora. Viss, kas jums nepieciešams, ir skripts un dažas pamata tehniskās zināšanas, lai iestatītu modeli, un mākslīgais intelekts rūpējas par pārējo: intonāciju, dabiskumu, balss izmaiņām un nepārtrauktību visā audio ierakstā.
Kas ir VibeVoice un kāpēc tas ir tik svarīgs podkāstiem?
Modelis ir balstīts uz TTS (teksta pārveidošanas runā) tehnoloģiju, kas nozīmē, ka tas tieši pārveido tekstu runā , bet ar tādu plūduma un nianses līmeni, kas ļoti līdzinās cilvēka runai. VibeVoice sākotnēji tika izlaists versijās ar 1.5B un 7B parametriem , kas paredzēti, lai līdzsvarotu kvalitāti un spēju ģenerēt garas audio straumes bez pārmērīga resursu patēriņa.
Viena no tās lielākajām priekšrocībām ir spēja nepārtraukti ierakstīt līdz pat 90 minūtēm audio , saglabājot balss konsekvenci un intonāciju visā ieraksta laikā. Tas padara to īpaši noderīgu pilniem podkāstiem, audiogrāmatu nodaļām vai garām izglītojoša satura epizodēm, kur iepriekš bija nepieciešamas vairākas ierakstīšanas sesijas ar cilvēka balss aktieriem.
Turklāt VibeVoice ir izstrādāta, lai vienā audio ierakstā apstrādātu līdz pat četrām dažādām balsīm , nodrošinot simulētas intervijas, paneļdiskusijas, dialogus starp varoņiem vai epizodes, ko ierunā dažādi balss aktieri. Šī vairāku runātāju iespēja ir būtiska, lai mākslīgā intelekta darbinātas podkāstus padarītu dinamiskākus un saistošākus.
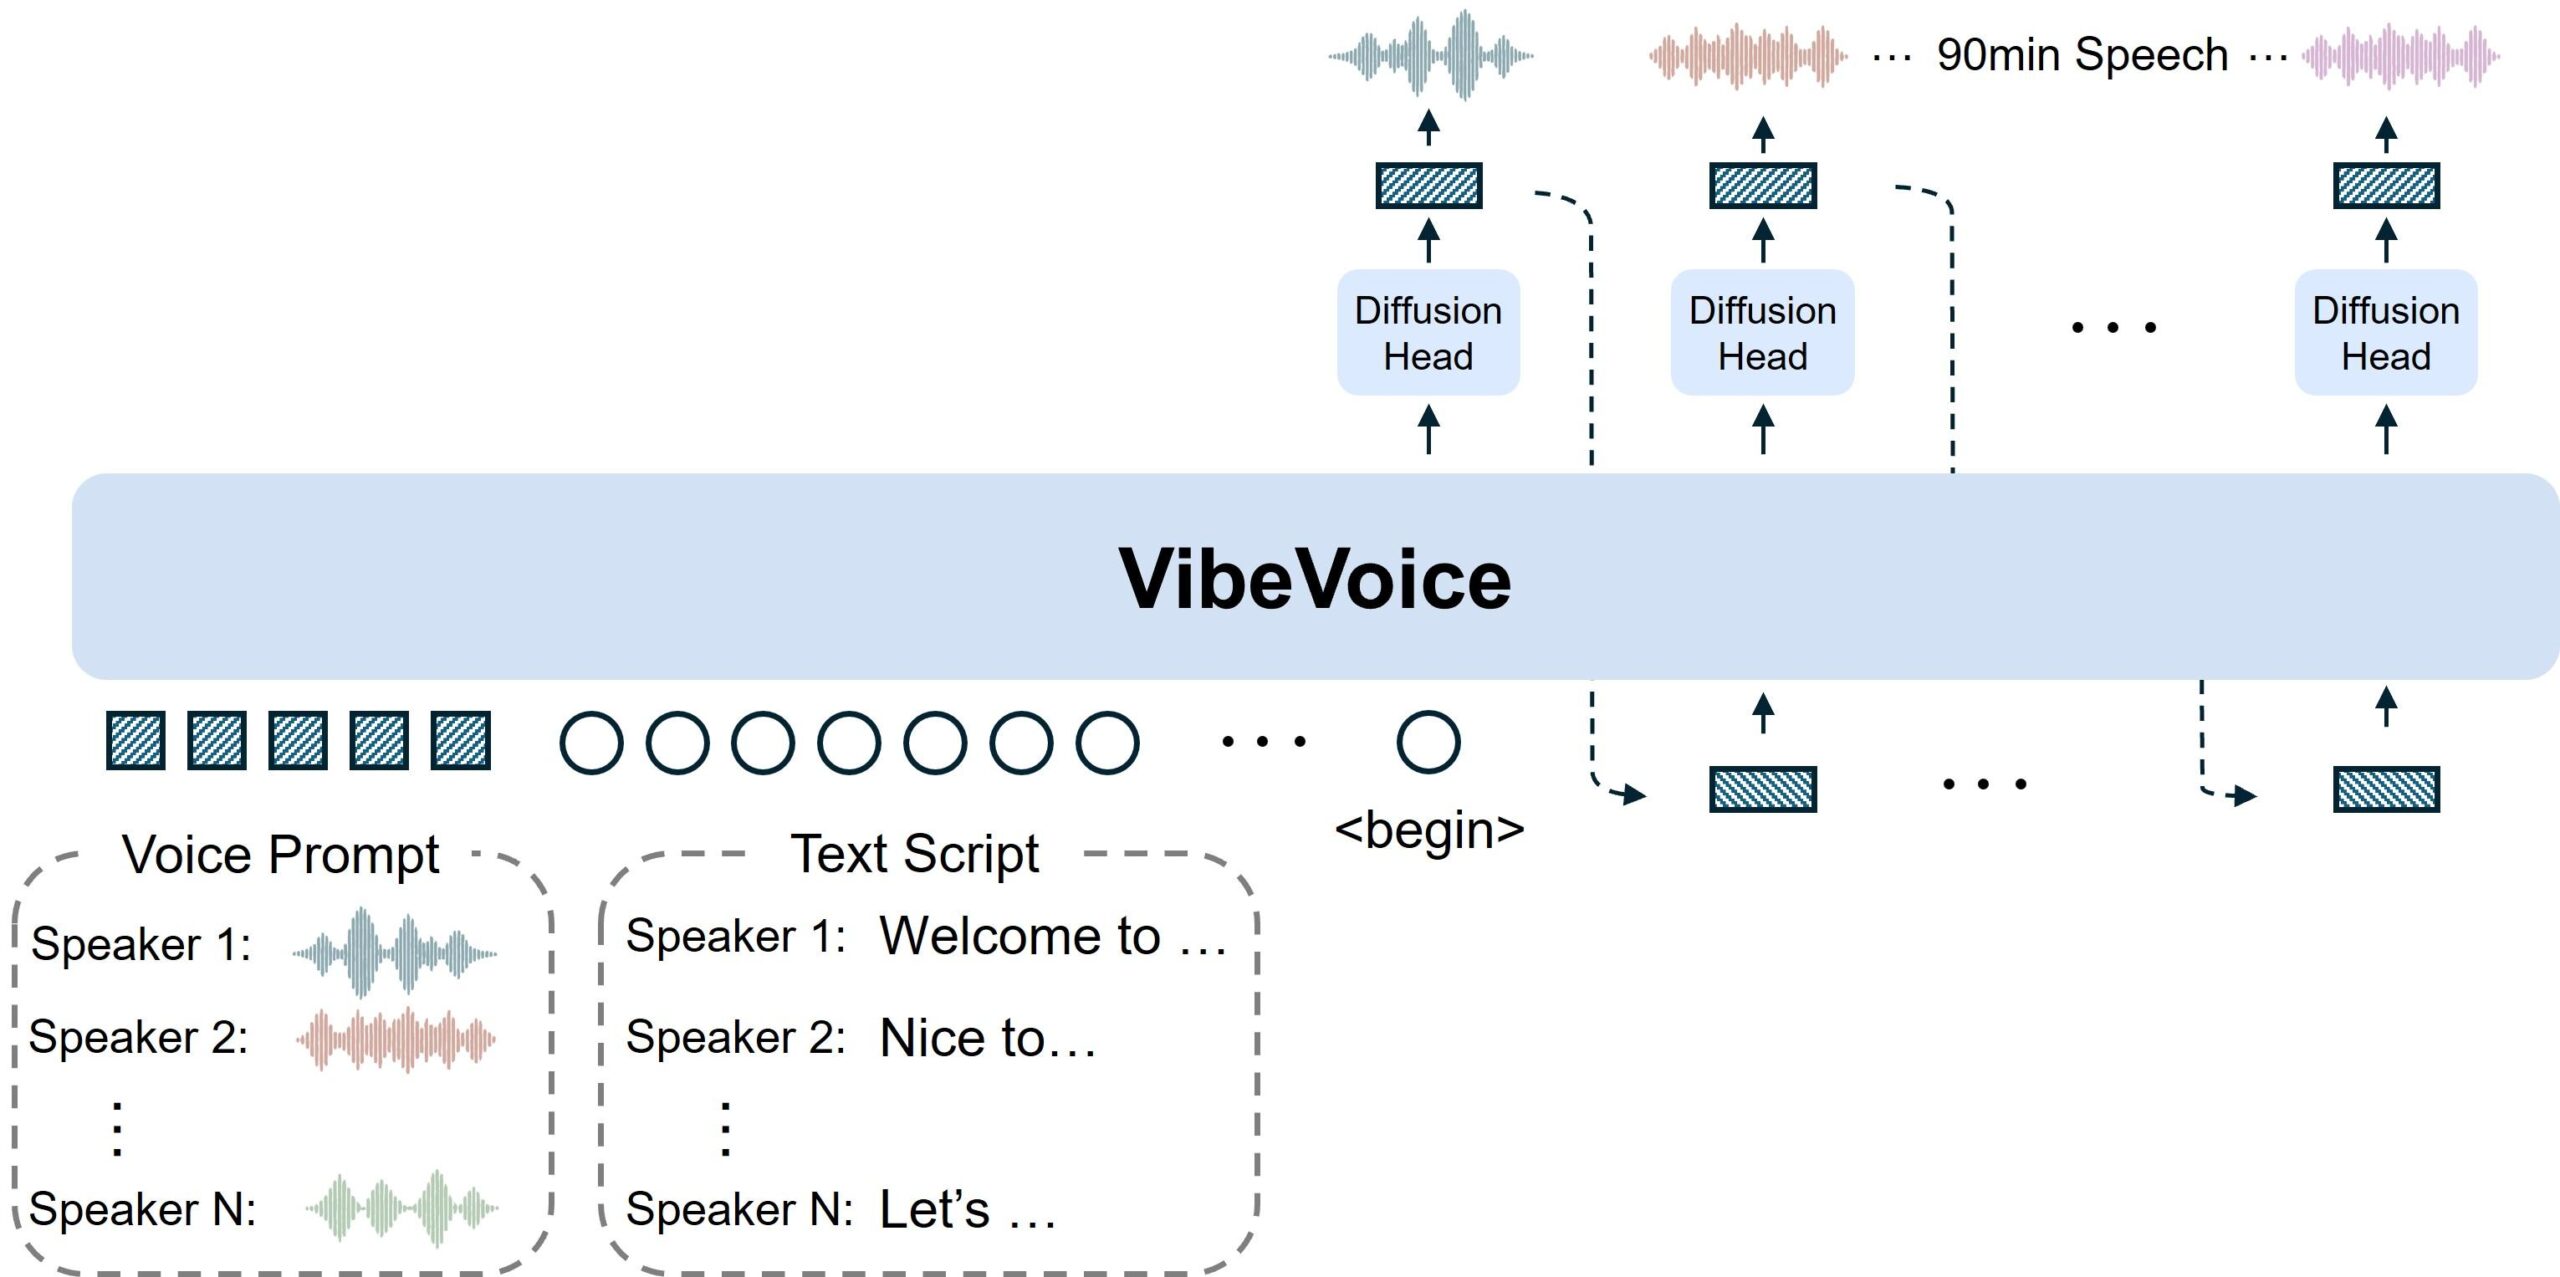
Kā darbojas VibeVoice: uzlabota runas sintēze un zema latentuma pakāpe
Papildus uzmanību piesaistošajam virsrakstam VibeVoice īpašu padara tā tehniskā arhitektūra, kas paredzēta gariem audio ierakstiem un sarunām . Microsoft apvieno vairākus komponentus, lai balss skanētu dabiski, pielāgotos tekstam un tiktu ģenerēta reāllaikā vai gandrīz reāllaikā.
Sistēma izmanto nepārtrauktas darbības akustiskos un semantiskās runas tokenizerus , kas darbojas ļoti zemā frekvencē, aptuveni 7,5 Hz. Tas nozīmē, ka tā kondensē audio informāciju mazākā "soļu" skaitā sekundē nekā citi modeļi, saglabājot skaņas precizitāti un vienlaikus ievērojami samazinot skaitļošanas izmaksas, strādājot ar garām sekvencēm.
Papildus šai saspiestajai reprezentācijai spēlē lomu lielais valodas modelis (LLM) , kas ir atbildīgs par skripta satura, sarunas plūsmas un runātāja konkrētajā brīdī interpretāciju. Tādā veidā tas saprot, vai tas ir jautājums, atbilde, ironisks komentārs vai tēmas maiņa, un attiecīgi pielāgo balss izvadi.
Visbeidzot, difūzijas galviņa tiek izmantota , lai rekonstruētu augstas kvalitātes akustiskās detaļas: tembru, vokālo tekstūru, smalkas elpas un citas nianses. Šī LLM + difūzijas kombinācija nodrošina, ka iegūtais audio ir nemainīgs, izteiksmīgs un patīkams klausīšanai ilgstoši.
Paralēli Microsoft ir laidis klajā īpašu variantu ar nosaukumu VibeVoice-Realtime-0.5B , kas paredzēts ārkārtīgi ātrai reaģēšanai: šis modelis var sākt izstarot balsi aptuveni 300 milisekundes pēc teksta saņemšanas. Tas ir, praktiski reāllaikā, ideāli piemērots balss aģentiem, sarunu asistentiem vai lietojumprogrammām, kurās latentumam jābūt minimālam.
Pieejamās versijas: modeļi, parametri un ieteicamie lietošanas veidi
VibeVoice ekosistēmā ir ieviestas vairākas versijas ar dažādiem modeļu izmēriem un orientācijām , kas paredzētas gan gariem audio ierakstiem, gan interaktīvām lietojumprogrammām.
No vienas puses, mums ir galvenie varianti ar 1.5B un 7B parametriem , kas paredzēti plaša satura, piemēram, pilnu podkāstu, simulētu radio programmu, audiogrāmatu nodaļu vai audio kursu, apstrādei. Lielāks parametru skaits nodrošina lielāku jaudu nianses uztveršanai un sarežģītu dialogu pārvaldībai, lai gan tas arī palielina aparatūras prasības.
No otras puses, VibeVoice-Realtime-0.5B versija prioritāri izvirza reakcijas ātrumu, nevis modeļa izmēru. Lai gan tai ir "tikai" 0,5 miljardi parametru , kas ir pieticīgs daudzums, salīdzinot ar tādiem milžiem kā ChatGPT vai Gemini, tieši tas ļauj tai ģenerēt līdz pat 90 minūtēm nepārtrauktas audio, vienlaikus saglabājot skaidru balsi un stabilu intonāciju.
Šis reāllaika variants ir īpaši pievilcīgs balss aģentiem, tērzēšanas robotiem, virtuālajiem asistentiem un jebkurai lietojumprogrammai, kurā lietotājs sagaida, ka mākslīgais intelekts nekavējoties reaģēs ar balsi, nevis tikai ar tekstu. Ar latentumu, kas ir tuvu 300 ms, pieredze ir ļoti līdzīga sarunai ar kādu otrā galā.
Visos gadījumos modelis ir paredzēts lietošanai vietējā vai pētniecības vidē , jo Microsoft sākotnēji nolēma to izlaist kā atvērtā pirmkoda projektu, kas ir pieejams no GitHub un tādām platformām kā Hugging Face, atvieglojot kopienai tā testēšanu, pielāgošanu un rīku izveidi uz tā pamata.
Praktiski pielietojumi: kā izveidot podkāstu ar VibeVoice
Viena no VibeVoice vadošajām lietotnēm neapšaubāmi ir podkāstu veidošana bez cilvēka balss aktieru palīdzības . Ikvienam, kam ir idejas, scenāriji vai rakstisks saturs, bet kurš neuzdrošinās stāties pie mikrofona, šis modelis paver milzīgas iespējas.
Vispārējā darbplūsma podkāsta veidošanai, izmantojot VibeVoice, parasti ietver labi strukturēta scenārija sagatavošanu : ievadu, satura blokus, iespējamās intervijas (reālas vai izdomātas), pārejas un noslēgumu. Jo skaidrāks teksts, jo labāk modelis var uztvert toņa izmaiņas, pauzes un katras "personas" lomu sarunā.
Pēc tam, izmantojot uz modeļa balstītus rīkus (skriptus, grafiskās saskarnes vai integrācijas ar citām lietotnēm), katra teksta daļa tiek piešķirta vienam no pieejamajiem runātājiem . Piemēram, mēs varam izmantot vienu balsi prezentētājam, citu – pastāvīgajam viesim, vēl vienu – auditorijas nolasītajiem jautājumiem un ceturto – informatīvām piezīmēm vai sponsorētiem segmentiem.
Modelis ģenerē nepārtrauktu audio, vienlaikus ievērojot skripta secību, balss pārejas un sarunas ritmu. Pēc tam rezultātu var uzlabot tradicionālā audio redaktorā, pievienojot fona mūziku, skaņas efektus, pārejas vai veicot nelielas skaļuma un ekvalaizera korekcijas.
Pateicoties spējai ģenerēt līdz pat 90 minūšu garu saturu, nezaudējot saskaņotību , mēs varam izveidot pilnu epizodi vienā piegājienā: nav nepieciešams ierakstīt mazos blokos vai uztraukties par balss nogurumu, dikcijas kļūdām vai fona troksni, kas fiziskā kabīnē rada pastāvīgas galvassāpes.
Balss klonēšana ar mākslīgo intelektu un personalizācija
Viens no delikātākajiem, tomēr spēcīgākajiem sasniegumiem šajā tehnoloģijā ir "balss klonēšana" jeb mākslīgā intelekta darbināta balss klonēšana . Tā ietver sintēzes metodes, kuru pamatā ir dziļā mācīšanās, kas ļauj atkārtot konkrētas balss tembru, runas modeļus un nianses.
Praksē šīs sistēmas analizē mērķa balss unikālās īpašības, piemēram, tembru, formantus, runas ritmu un prozodijas modeļus (pauzes, akcentus, jautājuma intonāciju utt.). Ar tikai dažām sekundēm parauga tās spēj ģenerēt sintētisku balsi, kas ir ļoti līdzīga oriģinālam.
VibeVoice gadījumā tiek minēts, ka ir iespējams panākt ļoti precīzas simulācijas ar tikai 10 sekundēm oriģinālā audio , diezgan labi uztverot balss emocionālo ietekmi un tekstūru. Podkāstam tas paver iespējas, piemēram, saglabāt "zīmola balsi" pat pēc tam, kad īstā persona ir pārtraukusi ierakstīšanu, vai izveidot atkārtotus tēlus ar nemainīgu vokālo identitāti.
Tomēr šī iespēja ir saistīta ar ļoti nopietniem ētiskiem riskiem un nepieciešamību noteikt sintētisko audio :
Šī iemesla dēļ Microsoft uzsver, ka VibeVoice tiek izlaists pētniecības ietvaros un ar skaidriem brīdinājumiem: to nedrīkst izmantot identitātes zādzībām, krāpšanai, manipulācijām vai dezinformācijas kampaņām. Atbildīga lietošana ir šīs ekosistēmas galvenā sastāvdaļa.
Priekšrocības satura veidotājiem un maziem projektiem
Ar datoru, kas spēj darbināt modeli, un laiku skriptu rakstīšanai, garus tekstus ir iespējams pārveidot profesionālā audio formātā dažu minūšu laikā. Tas attiecas uz informatīviem podkāstiem, ziņu biļeteniem, izdomātiem stāstiem, romāniem turpinājumos vai pat ierunātām tehniskām rokasgrāmatām.
Tas ir arī lielisks palīgs esoša rakstiskā satura pārstrādē : emuāra rakstus, informatīvos biļetenus, sociālo mediju pavedienus vai ziņojumus var pārveidot audio epizodēs, kas paplašina ziņojuma sasniedzamību un piedāvā ērtāku veidu tiem, kas dod priekšroku klausīties, nevis lasīt.
Vēl viena priekšrocība ir kvalitātes nemainīgums laika gaitā . Lai gan cilvēka balss aktieris var mainīt savu enerģiju, intonāciju vai skaidrību atkarībā no dienas, mākslīgais intelekts uztur nemainīgu līmeni, kas atvieglo sērijveida producēšanu: vairākas epizodes, kas ierakstītas vienā uzņemšanas reizē, saglabās vienādu balss klātbūtni un stilu.
Izglītības jomā VibeVoice ir ideāli piemērots audio kursiem, vadītai lasīšanai un pieejamiem materiāliem cilvēkiem ar redzes traucējumiem vai tiem, kas vienkārši dod priekšroku mācīties, klausoties, vienlaikus veicot citus uzdevumus. Iespēja ģenerēt stundu vai garu dokumentu ierunātas versijas paver plašas iespējas.
Riski, ierobežojumi un Microsoft lēmums attiecībā uz repozitoriju
No otras puses, mākslīgais intelekts, kas spēj atdarināt cilvēku balsis un ģenerēt reālistisku runu, rada nopietnas ētiskas un drošības bažas. Ļaunprātīgas izmantošanas risks ir reāls, un lielie tehnoloģiju uzņēmumi to arvien vairāk apzinās.
Pašā palaišanas tekstā Microsoft nepārprotami norāda, ka VibeVoice nedrīkst izmantot dziļviltojumiem, identitātes zādzībām vai nelikumīgām darbībām . Tas arī tieši aizliedz tā izmantošanu dezinformācijas vai krāpšanas kontekstā tieši tāpēc, ka tā reālisma līmenis varētu viegli maldināt neko nenojaušošus klausītājus.
Lai gan tā ģenerētā balss ir ļoti pārliecinoša, modeļa veidotāji norāda, ka tas joprojām neaptver visas īstas cilvēka balss smalkumus : elpas, emocionālās mikrovariācijas, noteiktas dabiskas pauzes un ritma izmaiņas cilvēkā joprojām ir bagātīgākas nekā mākslīgajā intelektā. Šī "nepilnība" daļēji var palīdzēt noteikt, ka mums ir darīšana ar sintētisku balsi, taču robeža kļūst arvien neskaidrāka.
Pēc projekta izlaišanas kā atvērtā pirmkoda pētniecības ietvara Microsoft atklāja gadījumus, kad modelis tika izmantots veidos, kas neatbilda tā sākotnējam mērķim un atbildīgas lietošanas principiem. Reaģējot uz to, uzņēmums paziņoja, ka ir spiests uz laiku atspējot repozitoriju, līdz tas varēs nodrošināt, ka šāda ārpus darbības jomas esoša izmantošana vairs nevarēs notikt.
Paziņojumā uzsvērts, ka atbildīga mākslīgā intelekta izmantošana ir Microsoft pamatprincips un ka viņi dod priekšroku apturēt un pārskatīt, nevis uzturēt rīku, kas varētu veicināt nopietnus pārkāpumus. Tomēr dokumentācija, demonstrācijas un tehniskie materiāli jau ir iedvesmojuši kopienu un turpinājuši attīstīt runas sintēzes jomu.
Citas lietojumprogrammas ārpus podkāstu apraides
Lai gan mediju uzmanība galvenokārt ir bijusi vērsta uz podkāstiem, VibeVoice paver diezgan plašu lietošanas gadījumu klāstu mākslīgā intelekta ģenerēta audio pasaulē. Daudzi no tiem iederas arī digitālā satura un automatizācijas stratēģijās.
Viens no acīmredzamākajiem piemēriem ir audiogrāmatas un stāstu ierunāšana , kur izteiksmīgas balsis, kas spēj noturēt uzmanību desmitiem minūšu, ir ļoti svarīgas. Vairāku skaļruņu iespēja ļauj katram varonim izmantot savu balsi, ievērojami uzlabojot klausīšanās pieredzi salīdzinājumā ar viena stāstītāja lietošanu.
Balss aģentu un sarunu asistentu jomā VibeVoice reāllaika versija ir ideāla. Bots, kas reaģē ar tikai 300 ms aizkavi, šķiet daudz dabiskāks nekā tāds, kura runai nepieciešamas vairākas sekundes, padarot mijiedarbību ar klientu apkalpošanas dienestu, tērzēšanas robotiem vai balss saskarnēm daudz vienmērīgāku.
Vēl viena ļoti interesanta joma ir automatizēts saturs : ziņu kopsavilkumus, tirgus atjauninājumus, periodiskus ziņojumus vai pat e-pasta lasījumus un paziņojumus var ģenerēt bez cilvēka iejaukšanās, saglabājot zīmola tēlam atbilstošu balsi.
Visbeidzot, pastāv eksperimentālākas lietojumprogrammas, piemēram, izdomātu dialogu, simulētu interviju vai pilnībā mākslīgā intelekta radītu izklaides programmu veidošana . Šeit scenāriju rakstīšanas valodu modeļi tiek apvienoti ar VibeVoice balss aktiermākslai, kā rezultātā tiek radīti formāti, kas nesen šķita kā zinātniskā fantastika.
Raugoties kopumā, VibeVoice izceļas kā viens no galvenajiem spēlētājiem jaunajā mākslīgā intelekta ģenerētā audio vilnī , kas spēj apvienot dabiskas balsis, daudzu dalībnieku sarunas, ļoti garus audio klipus un gandrīz momentānas atbildes. Lietojot atbildīgi un ievērojot noteiktās ētikas robežas, tas var kļūt par neticami spēcīgu rīku ikvienam, kurš vēlas palaist vai paplašināt podkāstu, producēt audiogrāmatas vai pievienot profesionālus balss ierakstus saviem digitālajiem projektiem, ne vienmēr paļaujoties uz tradicionālo ierakstu studiju.

Indekss
- 1 Kas ir VibeVoice un kāpēc tas ir tik svarīgs podkāstiem?
- 2 Kā darbojas VibeVoice: uzlabota runas sintēze un zema latentuma pakāpe
- 3 Pieejamās versijas: modeļi, parametri un ieteicamie lietošanas veidi
- 4 Praktiski pielietojumi: kā izveidot podkāstu ar VibeVoice
- 5 Balss klonēšana ar mākslīgo intelektu un personalizācija
- 6 Priekšrocības satura veidotājiem un maziem projektiem
- 7 Riski, ierobežojumi un Microsoft lēmums attiecībā uz repozitoriju
- 8 Citas lietojumprogrammas ārpus podkāstu apraides