- Kešatmiņas saskaņotība nodrošina, ka visas to pašu datu kopijas dažādās kešatmiņās un RAM atmiņā daudzkodolu sistēmās saglabājas nemainīgas.
- Kešatmiņas hierarhija ar koplietotu pēdējo līmeni vienkāršo konsekvences kontroli un samazina tiešu piekļuvi operatīvajai atmiņai.
- Saskaņotības protokoli izmanto kopiju anulēšanas vai atjaunināšanas stratēģijas, ko atbalsta stāvokļi un vadības biti katrā kešatmiņas rindā.
- Kompilators un operētājsistēma var papildināt aparatūras konsekvenci, ievietojot instrukcijas un konfigurējot atmiņu kritiskiem periodiem.
Aplūkojot jebkura mūsdienīga daudzkodolu procesora diagrammu, vienmēr parādās viens un tas pats modelis: vairāki kodoli, katram ar savu tuvumā esošo kešatmiņu, un koplietojama pēdējā līmeņa kešatmiņa, kas darbojas kā kopīgs punkts pirms RAM sasniegšanas. Šis izkārtojums nav nejaušs vai dizaineru kaprīze, bet gan tieša atbilde uz kritisku problēmu paralēlās sistēmās: kešatmiņas koherenci.
Bez stabila konsekvences mehānisma katrs kodols varētu strādāt ar atšķirīgu un novecojušu to pašu datu versiju atmiņā , kas reālās pasaules programmās nozīmē nelielas kļūdas, neparedzamas kļūmes un pat sistēmas avārijas. Tāpēc izpratne par to, kā šī konsekvence tiek uzturēta — gan aparatūras, gan programmatūras līmenī —, ir būtiska, lai izprastu mūsdienu daudzkodolu centrālo procesoru veiktspēju un stabilitāti .
Kas ir kešatmiņas koherence: termināļa metafora

Iedomājieties vairākus cilvēkus, kas sēž pie dažādiem termināļiem un visi rediģē vienu un to pašu dokumentu, kas glabājas centrālā serverī . Katrā ekrānā tiek rādīta faila kopija, un visas izmaiņas, ko veic viena persona, nekavējoties tiks atspoguļotas arī visu pārējo ekrānos.
Lai tas darbotos, ir nepieciešams sinhronizācijas mehānisms, kas izplata dokumenta izmaiņas uz visiem termināļiem, lai visi vienmēr redzētu vienu un to pašu versiju. Kamēr šī sistēma darbojas, viss ir kārtībā: ikviens, kas modificē tekstu, zina, ka visi pārējie gandrīz uzreiz redzēs jauno versiju.
Tagad iedomājieties, ka sinhronizācijas sistēma pēkšņi neizdodas. Katra persona turpina rediģēt, pārliecināta, ka strādā pie koplietotā dokumenta, bet patiesībā katram terminālim paliek sava atvienota lokālā kopija . No šī brīža vienas personas veiktās izmaiņas nesasniedz pārējās, un dokuments sāk nekontrolējami atšķirties.
Datorzinību jomā tieši tas notiktu, ja centrālajam procesoram (CPU) trūktu uzticama konsekvences protokola: viens kodols modificē datus atmiņā, bet pārējie kodoli turpina lasīt vecāku versiju no savām privātajām kešatmiņām . Tas rada auglīgu augsni nopietnām loģiskām kļūdām, bojātiem datiem un atkļūdošanas problēmām.
Kešatmiņas koherence tāpēc ir mehānismu kopums, kas nodrošina, ka daudzkodolu sistēmā visas to pašu datu kopijas, kas izplatītas dažādās kešatmiņās un RAM, saglabā konsekventu stāvokli . Pat ja pastāv vairākas kopijas, sistēmai ir jāuzvedas "tā, it kā" tāda būtu tikai viena.
Kešatmiņas un atmiņas hierarhija daudzkodolu centrālajā procesorā
CPU kešatmiņas ir mazas, ļoti ātras atmiņas, kurās glabājas bieži izmantoto RAM fragmentu kopijas . Kad procesors izpilda kodu, tā vietā, lai nepārtraukti piekļūtu (salīdzinoši lēnajai) RAM, tas mēģina lasīt no kešatmiņas un rakstīt tajā, ievērojami samazinot latentumu.
Protams, knifs ir tāds, ka kešatmiņās netiek glabāta datu "oficiālā versija", bet tikai pagaidu kopija . Sekojot termināļa metaforai, RAM būtu dokuments serverī, savukārt kešatmiņās būtu lokālie ekrāni, kuros tiek parādītas noteiktu faila daļu kopijas.
Vairāku kodolu centrālā procesora (CPU) konstrukcija kļūst sarežģītāka, jo katram kodolam parasti ir sava privāta 1. līmeņa (L1) un pat 2. līmeņa (L2) kešatmiņa . Virs tām tiek pievienota (piemēram) koplietota 3. līmeņa kešatmiņa, kas atrodas starp kodoliem un atmiņas kontrolieri, kas nodrošina piekļuvi RAM.
Šī koplietotā kešatmiņa ir ieviesta, jo, ļaujot visiem kodoliem tieši un intensīvi piekļūt RAM, tiktu radīti piekļuves konflikti, konkurence atmiņas kopnē un ievērojams veiktspējas kritums . Pēdējā līmeņa kešatmiņa darbojas kā kopēja "bufera" atmiņa, kas samazina RAM piekļuves un centralizē lielu daļu datu plūsmas.
Turklāt daudzas arhitektūras kešatmiņas organizē iekļaujoši: rindas, kas tiek glabātas procesoram tuvu esošajos līmeņos, atrodas arī augstākos hierarhijas līmeņos . Tas ir, rinda, kas parādās L1 līmenī, atrodas arī L2 līmenī un, savukārt, L3 līmenī. Tam ir ļoti noderīgas sekas konsekvences nodrošināšanai: vienkārši pareizi atjauninot zemākā līmeņa kešatmiņu, ir pietiekami, lai kontrolētu citu līmeņu stāvokli, nepārtraukti nepiekļūstot RAM.
Kāpēc pēdējā līmeņa koplietotā kešatmiņa ir konsekvences atslēga
Bez šīs globālās pēdējā līmeņa kešatmiņas katram kodolam būtu jāpārbauda konsekvence tieši ar galveno atmiņu . Katru reizi, kad privātajā kešatmiņā tiek modificēta atmiņas rinda, būtu jāpārbauda, vai citi kodoli uztur šīs pašas rindas kopiju, un, ja tā, tā jāatjaunina vai jāanulē visur.
Sistēmā ar daudziem kodoliem šī pārbaužu darba slodze izraisītu milzīgu skaitu transakciju RAM , tādējādi liedzot lielu daļu ātru kešatmiņu priekšrocību. Novietojot koplietotu kešatmiņu starp kodoliem un atmiņu, centrālais procesors var koncentrēt koherences kontroli vienā starpposmā.
Daudzās realizācijās kešatmiņas augstākos līmeņos (tālāk no procesora) satur to rindu kopijas, kas atrodas līmeņos, kas atrodas tuvāk kodolam . Izmantojot šo organizāciju, koherences protokolam ir jānodrošina tikai tas, ka pēdējais līmenis ir sinhronizēts ar galveno atmiņu un ka katra kodola privātie līmeņi ir sinhronizēti ar līmeni, kas atrodas tieši virs tā.
To var vizualizēt kā sava veida krievu ligzdošanas lelli: trešā līmeņa kešatmiņa ietver otrā un pirmā līmeņa saturu , otrais līmenis ietver savu un pirmā līmeņa saturu, un pirmais līmenis zina tikai savas rindas. Tādējādi, kontrolējot "lielo lelli" (pēdējo līmeni), sistēma var efektīvāk koordinēt pārējo.
Rezultātā konsekvences saglabāšana kļūst ekonomiskāka gan dizaina, gan atmiņas datplūsmas ziņā . Tā vietā, lai piespiestu katru kodolu pastāvīgi apstrādāt RAM, protokols darbojas koplietotajā kešatmiņā un no turienes pārvalda, kuras rindas ir jāatjaunina vai jāanulē privātajās kešatmiņās.
Atjaunināšanas metodes: kopiju anulēšana un atjaunināšana
Kritiska problēma rodas, ja divi vai vairāki kodoli vēlas gandrīz vienlaicīgi piekļūt vienai un tai pašai datu rindai, kas tiek replicēta vairākās kešatmiņās . Šajā kontekstā konsekvences sistēmas parasti izmanto divas pamatstratēģijas, apstrādājot rakstīšanas darbības.
Pirmā metode ir balstīta uz anulēšanu. Kad kodolam ir jāraksta noteiktā kešatmiņas rindā, protokols anulē visas šīs pašas rindas kopijas, kas var atrasties citās kešatmiņās . Tikai kodols, kas rakstīs, saglabā rindu lasīšanas un rakstīšanas režīmā; pārējiem, ja tie vēlas vēlreiz izmantot šos datus, rinda būs jāielādē no augstāka līmeņa (vai no atmiņas) ar atjaunināto versiju.
Otrā stratēģija ietver atjaunināšanu. Šajā gadījumā, kad kodols modificē rindu, sistēma mēģina automātiski izplatīt jauno saturu esošajās kopijās citās kešatmiņās . Tādā veidā visas kešatmiņas, kurās tika saglabāta šī rinda, saņem atjaunināto versiju, to vēlāk neanulējot un atkārtoti ielādējot.
Katrai pieejai ir savi plusi un mīnusi. Nederīguma atzīšana parasti ir efektīvāka, ja rakstīšana notiek bieži, jo tā novērš atmiņas sistēmas piesātināšanu ar atjauninājumiem, kas citiem kodoliem, iespējams, nav nekavējoties nepieciešami. Savukārt atjaunināšana var būt izdevīga, ja daudzi kodoli bieži lasa tos pašus datus, kas tiek modificēti relatīvi reti , jo tā samazina latentumu, jo nav nepieciešams atkārtoti ielādēt rindu pēc katras nederīguma atzīšanas.
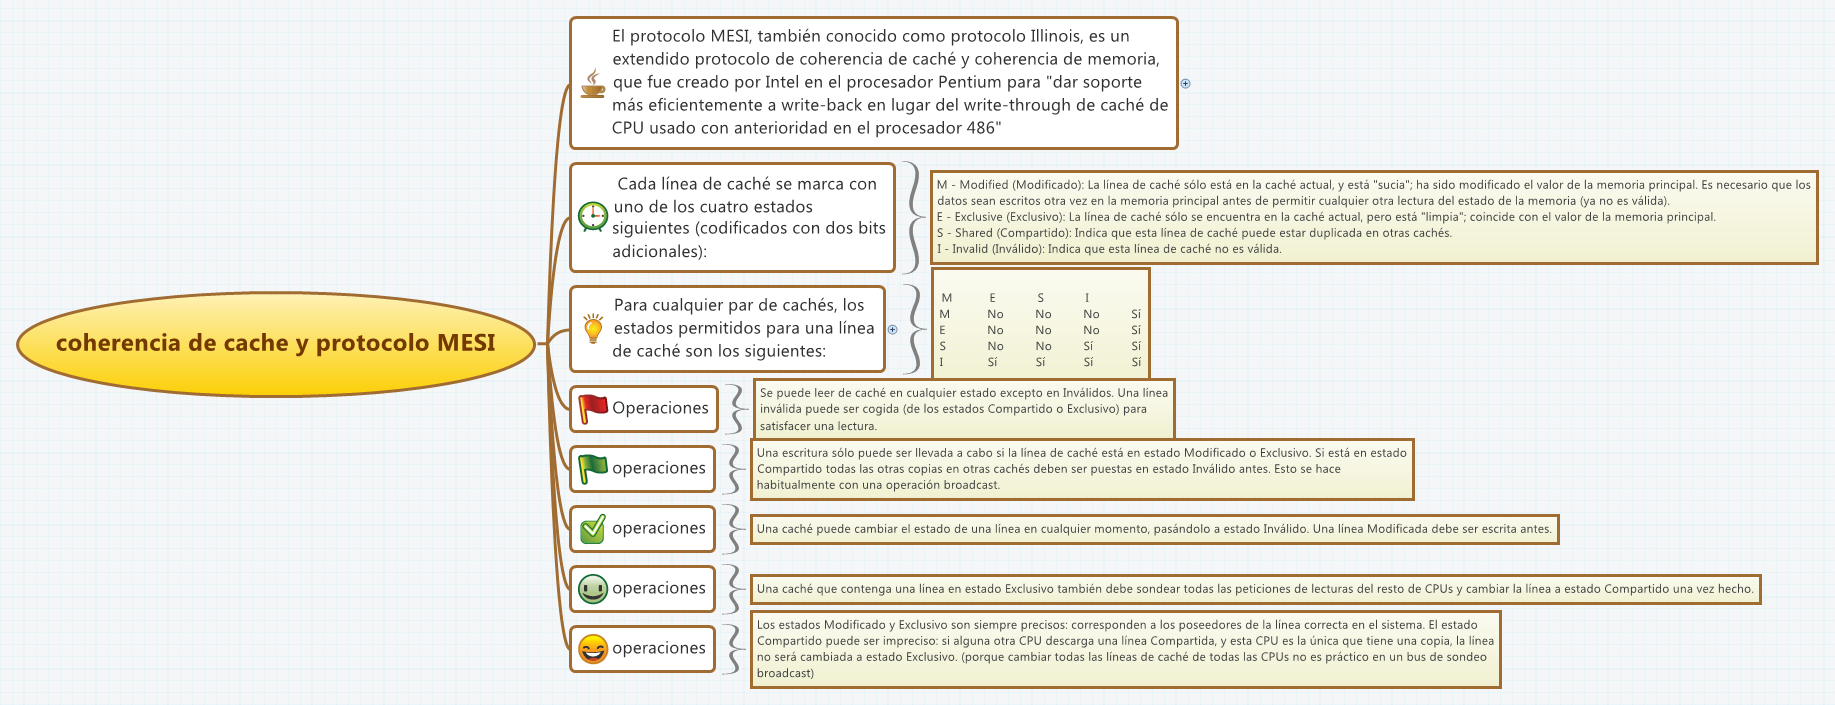
Abos gadījumos abas metodes kešatmiņas rindās izmanto papildu stāvokļus un vadības bitus. Katrā rindā parasti ir ietverta informācija par to, vai tās saturs atbilst RAM saturam un vai tā ir koplietota, modificēta, ekskluzīva, rezervēta utt., atkarībā no konkrētā protokola (MESI, MOESI, MSI utt.). Tas ļauj aparatūrai ātri pieņemt lēmumus par to, kā rīkoties, ja lasīšanas vai rakstīšanas darbība notiek jau replicētā rindā.
Kešatmiņas un atmiņas atbilstības pārbaude
Tieša atbilstības pārbaude starp visiem centrālā procesora vai grafiskā procesora kešatmiņas līmeņiem un operatīvo atmiņu būtu milzīgs uzdevums gan konstrukcijas sarežģītības, gan veiktspējas izmaksu ziņā. Tāpēc mūsdienu sistēmas šo pārbaudi organizē hierarhiski.
Kešatmiņas, kas atrodas vistuvāk procesoram (L1, L2), parasti nav tieši savienotas ar RAM, bet gan ar nākamo kešatmiņas līmeni. Tas nozīmē, ka konsekvence netiek pārbaudīta attiecībā pret galveno atmiņu katrā līmenī, bet gan attiecībā pret nākamo augstāko līmeni . Tas samazina RAM piekļuves reižu skaitu un vienkāršo zemākos līmeņos nepieciešamo loģiku.
Galu galā kešatmiņas satura un RAM satura salīdzināšana tiek veikta starp pēdējā līmeņa kešatmiņu un operatīvo atmiņu . Ja šis pēdējais līmenis uztur pareizu un konsekventu stāvokli, un katrs zemākais līmenis saglabā savu atbilstību augstākajam līmenim, visa hierarhija saglabājas konsekventa, un katra rinda nav atkārtoti jāpārbauda attiecībā pret RAM.
Kad kodols raksta kešatmiņas rindā un maina savus datus, šīs rindas stāvoklis tiek atzīmēts, lai norādītu, ka tā vairs precīzi neatbilst atmiņā saglabātajai kopijai . Pēc tam protokols koordinē atjauninājumu: tas atzīmē atbilstošās kopijas citās kešatmiņās kā rezervētas vai nederīgas un, ja nepieciešams, ieraksta jauno saturu saistītajā galvenās atmiņas rindā.
Šī kaskādes organizācija ļauj izmaiņām pakāpeniski izplatīties no kodola, kas atjaunina datus, uz galveno atmiņu, kontrolēti izejot cauri katram kešatmiņas līmenim. Tādā veidā konsekvences saglabāšana nekļūst par nepārvaramu šķērsli procesoram.
Aparatūras saskaņotība pret programmatūras saskaņotību
Līdz šim esam apsprieduši konsekvences mehānismus, kas galvenokārt tiek ieviesti aparatūrā: protokoli, statusa biti, koplietotās kešatmiņas utt. Tomēr pastāv arī cita pieeja, kas cenšas daļu no šīs sarežģītības pārnest uz programmatūru , proti, uz kompilatoru un operētājsistēmu.
Programmatūras konsekvences shēmas mēģina samazināt nepieciešamību pēc papildu loģikas mikroshēmā, analizējot kodu un pieņemot lēmumus kompilēšanas laikā . Ideja ir tāda, ka, ja kompilators var secināt, kad un kā tiek piekļūts noteiktiem koplietotiem datiem, daudzos gadījumos tas varētu novērst šo datu kešatmiņā saglabāšanu vai skaidri pārvaldīt to redzamību.
Šai pieejai ir nepārprotama priekšrocība: daļa darba slodzes tiek pārnesta no izpildlaika uz risinājumu kompilēšanas laikā . Tā vietā, lai aparatūra noteiktu un apstrādātu visus konfliktus acumirklī, kompilators mēģina tos paredzēt un ģenerēt kodu, kas novērš bīstamas situācijas.
Negatīvā puse ir tā, ka statiskā koda analīze ir ierobežota, un tāpēc kompilatori mēdz būt konservatīvi . Tas nozīmē, ka, lai izvairītos no konsekvences pārkāpumiem, tie bieži pieņem lēmumus, kas samazina kešatmiņu efektivitāti. Ja tiem ir aizdomas, ka daži dati varētu būt problemātiski, tie bieži novērš to kešatmiņā saglabāšanu vai piespiedu sinhronizāciju veic biežāk nekā absolūti nepieciešams.
Tāpēc, lai gan šīs programmatūras shēmas teorētiski ir pievilcīgas, īpaši aparatūras projektēšanas vienkāršošanai, praksē tās neaizstāj pašā centrā integrēto koherences atbalstu , bet gan papildina to dažos konkrētos scenārijos.
Kompilatora loma kešatmiņas konsekvencē
Programmatūras konsekvences pieeju galvenais elements ir kompilatora loma. Kompilators var veikt padziļinātu koda analīzi un noteikt, kuras koplietotās datu struktūras varētu būt nedrošas kešatmiņai . Pamatojoties uz to, tas īpašā veidā iezīmē šos elementus vai pielāgo koda ģenerēšanu.
Vienkāršākā un arī konservatīvākā pieeja ir novērst koplietoto datu mainīgo kešatmiņā saglabāšanu . Tas ir, katra piekļuve šiem mainīgajiem piespiež piekļūt operatīvajai atmiņai vai kešatmiņā nesaglabājamai zonai. Tas garantē konsekvenci, bet zaudē daudzas veiktspējas iespējas, jo koplietoto struktūru faktiski var izmantot privāti noteiktos periodos vai tikai lasīšanas režīmā citos laikos.
Patiesībā konsekvences problēma rodas tikai intervālos, kad vismaz viens process var rakstīt mainīgajā un cits process to var nolasīt . Ārpus šiem kritiskajiem periodiem mainīgo var uzskatīt par paredzētu tikai viena pavediena lietošanai vai pat par efektīvu konstanti kādu laiku, ļaujot to bez problēmām kešatmiņā saglabāt.
Vismodernākās kompilācijas stratēģijas mēģina identificēt tos "drošos" periodus, kuros koplietoto mainīgo var uzskatīt par nekonfliktējošu . Lai to izdarītu, kompilators analizē izpildes ceļus, iespējamās vienlaicīgās piekļuves un sinhronizācijas modeļus (bloķējumus, kritiskās sadaļas utt.). Pamatojoties uz šo analīzi, tas sadala mainīgā dzīves ilgumu fāzēs: dažas ir piemērotas kešatmiņai, citām nepieciešama īpaša apstrāde.
Kritiskos periodos, kad tiek konstatēta vienlaicīga piekļuve ar rakstīšanu, kompilators ģenerētajā kodā ievieto papildu instrukcijas, lai nodrošinātu kešatmiņas konsekvenci . Šīs instrukcijas var piespiest kešatmiņas tīrīšanu, atmiņas atkārtotu ielādi, atmiņas barjeras vai piekļuvi reģioniem, kas atzīmēti kā neievietojami kešatmiņā, atkarībā no programmēšanas modeļa un pamatā esošās arhitektūras.
Saistība starp kompilatoru, operētājsistēmu un aparatūru
Frāze "kompilators ievieto instrukcijas ģenerētajā kodā, lai nodrošinātu kešatmiņas konsekvenci" varētu radīt domu, ka operētājsistēma šīs instrukcijas lasa kā augsta līmeņa padomus un, pamatojoties uz tiem, izlemj, kā izpildīt programmu. Patiesībā mehānisms ir nedaudz atšķirīgs.
Kad kompilators pievieno šāda veida instrukcijas, tas binārajā failā ievieš īpašas darbības, ko atbalsta arhitektūra vai izpildlaika vide . Piemēram, tas var ievietot kešatmiņas tīrīšanas instrukcijas, atmiņas barjeras, īpašas instrukcijas reģionu atzīmēšanai kā nekešatmiņā saglabājamus vai izsaukumus operētājsistēmas pakalpojumiem, kas konfigurē atmiņas atribūtus.
Operētājsistēma šīs instrukcijas neinterpretē kā augsta līmeņa "komentārus" vai "mājienus", ko rakstījis kompilators; tā vienkārši izpilda mašīnkodu tāpat kā jebkuru citu . Tomēr dažas no šīm instrukcijām ir paredzētas mijiedarbībai ar atmiņas apakšsistēmu un kešatmiņas pārvaldību, tādējādi mainot to, kā centrālais procesors piekļūst noteiktiem datiem.
Citiem vārdiem sakot, kompilators veic sākotnējo analīzi un ģenerē kodu, kas, izpildot, rada vēlamo kešatmiņas darbību . Operētājsistēma sadarbojas, izveidojot atmiņas atribūtus (kešatmiņā saglabājamas vai nesaglabājamas zonas, rakstīšanas politikas utt.) un nodrošinot sinhronizācijas primitīvus, taču tā "nelasa" īpašas instrukcijas tādā nozīmē, ka tās semantiski tiek interpretētas, kā to darītu kompilators.
Var arī gadīties, ka aparatūra, redzot noteiktas instrukcijas, aktivizē īpašus koherences vai sinhronizācijas mehānismus . Piemēram, žogs vai barjera instrukcijas garantē atmiņas piekļuves secību un ievieš noteiktus redzamības efektus visā kešatmiņas hierarhijā. Šajā gadījumā pastāv trīspusēja sadarbība: kompilators izlemj, kur ievietot šīs instrukcijas, operētājsistēma konfigurē izpildes vidi, un aparatūra īsteno faktisko darbību kešatmiņas un atmiņas kopnes līmenī.
Kopā visi šie elementi nodrošina, ka pat ar vairākām to pašu datu kopijām, kas izvietotas dažādās kešatmiņās un operatīvajā atmiņā, paralēlas programmas darbojas ar konsekventu atmiņas modeli . Kešatmiņas koherence, kas nebūt nav vienkārša iekšēja centrālā procesora detaļa, kļūst par centrālo komponentu, lai daudzkodolu sistēmas darbotos droši un efektīvi.
Izpratne par to, kā apvienojas kešatmiņas hierarhija, aparatūras koherences protokoli un programmatūras atbalsta metodes, padara skaidrāku, kāpēc mūsdienu centrālo procesoru dizainiem ir tik līdzīga struktūra un kāpēc neliela kļūme jebkurā no šiem mehānismiem var izraisīt haotisku uzvedību vienlaicīgās lietojumprogrammās , kas pilnībā ir atkarīgas no tā, vai visi kodoli redz vienus un tos pašus datus pareizajā laikā.