- Mākslīgais intelekts pārveido failu pārvaldību, automatizējot klasifikāciju, iegūstot stratēģiskos datus un pārbaudot autentiskumu.
- Tādas tehnoloģijas kā IDP, datorredze un NLP ļauj samazināt cilvēciskās kļūdas un optimizēt atbilstību normatīvajiem aktiem kritiski svarīgās nozarēs.
- Spēja analizēt sarežģītus modeļus un atklāt sarežģītas krāpšanas pārvērš dokumentu pārvaldību par konkurences un drošības priekšrocību.
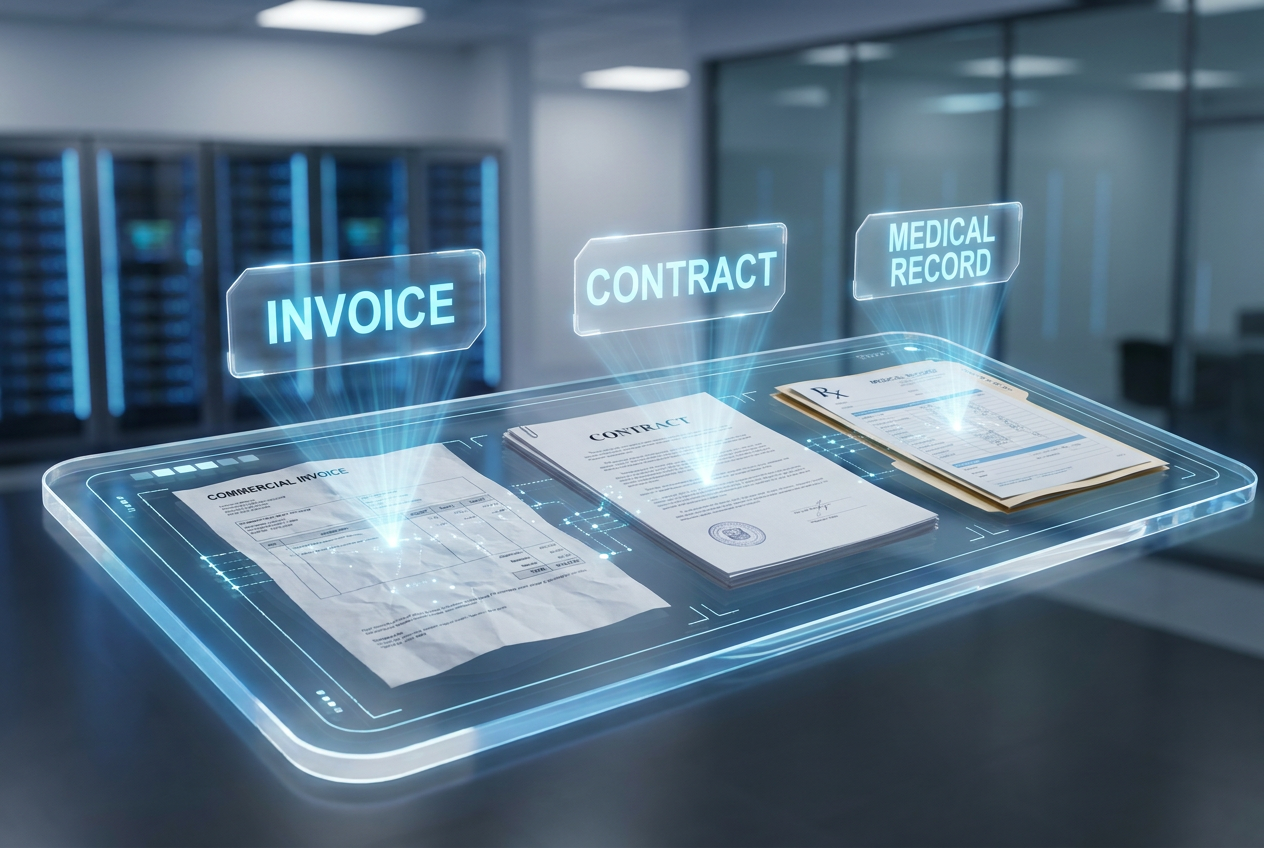
Informācijas pārvaldība uzņēmumos vairs nav tikai dokumentu arhivēšana vai PDF failu saglabāšana koplietojamā mapē. Datu eksplozijas dēļ, ko piedzīvojam, organizācijas ir iestrēgušas nestrukturētu failu jūrā , kur konkrētas informācijas atrašana var kļūt par īstu odiseju. Šeit noder mākslīgais intelekts arhivēšanas un dokumentu pārvaldības jomā , ne tikai palīdzot, bet arī pilnībā mainot spēles noteikumus, pārveidojot dokumentu haosu par stratēģisku aktīvu.
Ieviešot intelektuālas noteikšanas un analīzes sistēmas, uzņēmumi vairs nevar tērēt laiku atkārtotiem un nogurdinošiem uzdevumiem. Vairs nav nepieciešams ekspertam manuāli lasīt katru līgumu vai pārskatīt katru rēķinu; tagad, pateicoties mašīnmācīšanās algoritmiem un datorredzei , mašīnas var saprast dokumenta saturu, tā mērķi un iespējamos riskus — tas viss sekundes daļā un ar precizitāti, kas liek apkaunot cilvēka aci.

Inteliģenta dokumentu klasifikācija
Failu klasificēšana ir kas vairāk nekā tikai to marķēšana; tā ir biznesa dokumentu automātiska kategorizēšana, lai optimizētu resursus un novērstu kritiskas kļūdas. Iepriekš šis process bija šķērslis, kam bija nepieciešama sarežģīta programmēšana vai nogurdinošs manuāls darbs. Mūsdienās mākslīgais intelekts skenē katru ienākošo failu un ievieto to iepriekš definētās kategorijās, nosūtot to tieši uz atbilstošo darbplūsmu nemanāmai apstrādei.
Lai tas darbotos, mākslīgais intelekts (MI) izmanto tādus pamatjēdzienus kā entītiju identifikācija (vārdi, datumi vai numuri), riska kategorijas piešķiršana (piemēram, publiski vai konfidenciāli dokumenti) un pastāvīga marķēšana. Pēdējais ir ļoti svarīgi, lai citi drošības rīki zinātu, kā rīkoties ar failu. Turklāt kontekstualizācija ļauj MI izprast dokumentu tā dzīves cikla laikā, sasniedzot vairāk nekā 95% precizitāti, paļaujoties ne tikai uz atslēgvārdiem, bet arī uz teksta faktisko nozīmi.

Identitātes pārbaude un krāpšanas novēršana
Drošības nozarē mākslīgais intelekts ir spēris milzīgu soli identitātes dokumentu verifikācijā, kļūstot par centrālo elementu KYC (Pazīsti savu klientu) un AML (Nelikumīgi iegūtu līdzekļu legalizācijas novēršanas) procesos. Izmantojot datorredzi un attēlu analīzi , sistēmas var atklāt gandrīz neredzamas izmaiņas, piemēram, manipulētas hologrammas, viltotas ūdenszīmes vai mikrodrukas neatbilstības, ko lielākā daļa cilvēku nepamanītu.
Viena no tās stiprākajām pusēm ir spēja cīnīties pret digitālo krāpšanu. Mākslīgais intelekts analizē anomālijas pikseļu līmenī, lai atklātu Photoshop retušēšanu vai sejas izmaiņas (dziļviltojumus). Turklāt biometriskā sejas salīdzināšana salīdzina dokumenta fotoattēlu ar lietotāja tiešraides video, izmantojot pasīvu vai aktīvu dzīvīguma noteikšanu, lai pārliecinātos, ka dokumenta uzrādītājs ir fiziski klāt, nevis tikai maska vai fotogrāfija.

Vadošās tehnoloģijas: IDP, NLP un OCR
Visa šī virzītājspēks ir viedā dokumentu apstrāde (IDP), kas apvieno vairākas tehnoloģijas, lai no datiem iegūtu reālu vērtību. Uzlabotā OCR vairs ne tikai nolasa burtus; tā interpretē kontekstu, lai nodrošinātu precizitāti , pārveidojot attēlus vai fiziskus dokumentus strukturētos datos. Tikmēr dabiskās valodas apstrāde (NLP) ļauj mašīnai saprast teksta semantiku, atvieglojot modeļu un anomāliju noteikšanu.
- Azure mākslīgā intelekta meklēšana: Pakalpojums, kas ļauj veikt dziļu semantisku meklēšanu milzīgos nestrukturētu datu apjomos, ideāli piemērots juridiskajām vai personāla vadības nodaļām.
- Valodu modeļi (LLM): Tādi rīki kā GPT-4, Claude vai Gemini var vienlaikus apkopot vairākus failus un atbildēt uz sarežģītiem jautājumiem par avota saturu.
- Uzvedības analīze: Sistēmas, kas uzrauga, kā lietotājs mijiedarbojas ar dokumentu, lai identificētu iespējamās krāpšanas pazīmes.
Reālās pasaules pielietojumi dažādās nozarēs
Šo rīku daudzpusība ļauj gūt labumu gandrīz jebkurai nozarei. Finanšu jomā maksājumi un aizdevumu validācija tiek automatizēta, izmantojot datu ieguvi reāllaikā. Juridiskajā nozarē mākslīgais intelekts analizē līgumus, lai izceltu riskantus punktus vai pārkāpumus, racionalizējot e-atklāšanas procesu, dažu sekunžu laikā filtrējot tūkstošiem dokumentu.
Veselības aprūpes nozare izmanto mākslīgo intelektu, lai digitalizētu medicīniskās kartes un automatizētu apdrošināšanas atlīdzību pieprasījumus , novēršot sensitīvu datu zudumu. Tikmēr cilvēkresursu jomā uzņēmuma resursu plānošanas (ERP) un cilvēkresursu programmatūras integrācija ļauj automātiski klasificēt CV pēc prasmēm, lai atrastu ideālo kandidātu, nepārskatot simtiem profilu. Loģistikā piegādes pavadzīmju un rēķinu atpazīšana ievērojami samazina darbības kļūdas un optimizē piegādes ķēdi.

Sistēmas ieviešana un izaicinājumi
Lai ieviestu šādu sistēmu, nepietiek tikai ar programmatūras instalēšanu; ir jāidentificē problemātiskās vietas, piemēram, laikietilpīgi procesi. Ir svarīgi definēt izmērāmus mērķus un nodrošināt, lai risinājums būtu mērogojams un atbilstu tādiem noteikumiem kā GDPR un CCPA, jo personas datu apstrāde ir sensitīva joma.
Ne viss notiek gludi, jo pastāv ievērojamas problēmas. Apmācības datu neobjektivitāte var novest pie negodīgiem rezultātiem noteiktām demogrāfiskajām grupām, tāpēc ir vitāli svarīgi izmantot dažādas datu kopas. Turklāt krāpnieki pastāvīgi attīsta savu taktiku, piespiežot mākslīgā intelekta modeļus nepārtraukti pārapmācīties, lai tie nekļūtu novecojuši.
Šo iespēju integrēšana ļauj datu zuduma novēršanas (DLP) rīkiem darboties ar ķirurģisku precizitāti. Ja mākslīgais intelekts failu atzīmē kā augsta riska konfidenciālu , drošības sistēma var automātiski bloķēt tā iziešanu no korporatīvā tīkla. Tas pārveido dokumentu pārvaldību par patiesu kiberdrošības vairogu, kas garantē pilnīgu sensitīvas informācijas izsekojamību.
Semantiskās analīzes, datorredzes un ģeneratīvo modeļu konverģence rada ekosistēmu, kurā informācija vairs netiek vienkārši glabāta, bet gan aktīvi pārvaldīta. Automatizējot failu tipu noteikšanu un validāciju, organizācijas ne tikai samazina izmaksas un laiku, bet arī aizsargā savu infrastruktūru pret krāpšanu un dod iespēju pieņemt lēmumus, pamatojoties uz reāliem, strukturētiem datiem.
