- Mikroarkitektur mentakrifkan bagaimana CPU melaksanakan ISA dan menentukan IPC, paralelisme dalaman dan kecekapan sebenar, melangkaui frekuensi atau saiz cache.
- Reka bentuk seperti AMD Zen dan Zen 2 menggabungkan cache yang dioptimumkan, pelaksanaan luar tertib, SMT dan unit vektor besar untuk meningkatkan prestasi setiap kitaran dan setiap watt.
- Strategi chiplet dan Infinity Fabric membolehkan penskalaan bilangan teras dalam EPYC dan Ryzen sambil mengekalkan kos terkawal dan prestasi yang sangat kompetitif.
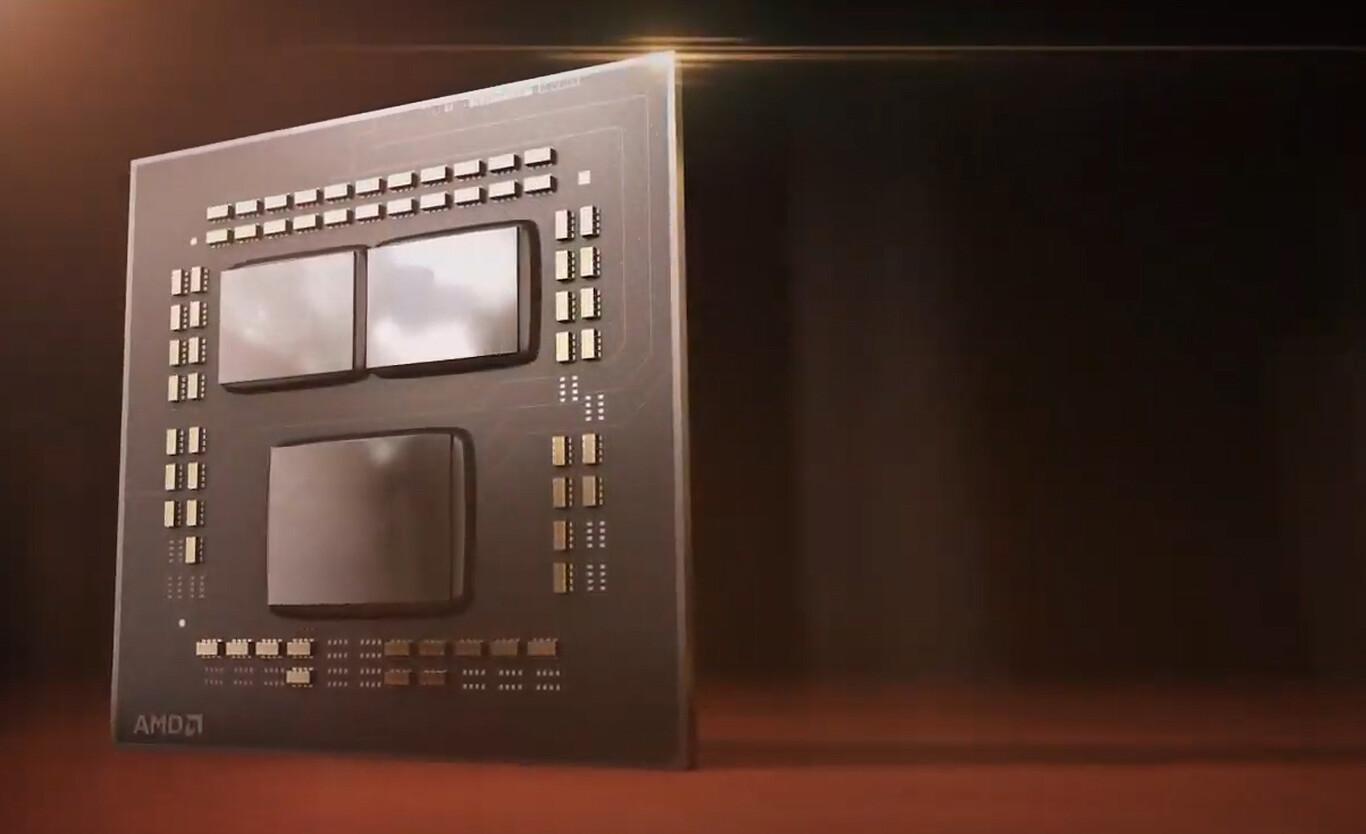
Mikroarkitektur CPU sering diabaikan oleh angka yang lebih menarik perhatian seperti GHz atau MB cache, tetapi ia terletak tepat di sana, dalam reka bentuk dalaman pemproses, di mana sebahagian besar prestasi sebenar, kecekapannya, dan juga jenis perisian yang paling sesuai untuk memanfaatkannya ditentukan.
Apabila anda membaca spesifikasi teknikal yang menyebut tentang teras, thread, cache L3 atau AVX2 , anda sebenarnya melihat akibat konkrit daripada mikroarkitektur tertentu. Memahami bagaimana komponen ini disusun secara dalaman, apa yang membezakan Zen 3 daripada Zen 2, atau Intel hibrid yang berbeza daripada Ryzen klasik, adalah kunci untuk memilih CPU anda yang seterusnya dengan bijak dan mengetahui mengapa sesetengahnya cemerlang dalam permainan, yang lain dalam rendering dan yang lain lagi dalam tugas pelayan.
ISA, makroarkitektur dan mikroarkitektur: membawa susunan kepada konsep-konsep
Sebelum mendalami kerumitan saluran paip dan peramal, adalah berguna untuk membezakan antara tiga tahap yang sering digabungkan: makroarkitektur sistem, ISA dan mikroarkitektur . Setiap satu menerangkan lapisan komputer yang berbeza.
Di satu pihak, terdapat makroarkitektur, atau reka bentuk sistem keseluruhan , yang merangkumi semua yang anda lihat pada papan induk: CPU, pengawal memori, bas, memori utama, cip input/output, pengawal storan, sebarang pemecut luaran dan logik DMA. Ia merupakan gambaran peringkat tinggi tentang bagaimana komponen perkakasan besar bersambung dan bagaimana data mengalir di antara mereka.
Di atasnya ialah ISA (Senibina Set Arahan) , iaitu set arahan yang difahami oleh pemproses: jenis data yang dikendalikannya, saiz perkataan, bilangan dan jenis daftar, mod pengalamatan, format arahan, dsb. Apabila anda memprogram dalam pemasangan menggunakan mnemonik seperti ADD, SUB, MUL atau menggunakan sambungan seperti SSE, AVX atau NEON, anda berkomunikasi secara langsung dengan ISA.
Akhir sekali, kita mempunyai mikrokod, atau μISA , yang mentakrifkan operasi mikro dalaman yang digunakan oleh beberapa seni bina kompleks (seperti x86) untuk melaksanakan arahan CISC mereka. Mikrokod ini boleh dikemas kini melalui firmware untuk membetulkan pepijat atau menambah sokongan untuk arahan baharu.
Apakah sebenarnya mikroarkitektur CPU?
Mikroarkitektur CPU pada asasnya merupakan pelan tindakan dalaman yang menentukan bagaimana arahan ISA dilaksanakan dan bagaimana data bergerak dalam cip. Dua pemproses boleh berkongsi ISA yang sama (contohnya, AMD64 dalam Intel dan AMD) namun mempunyai tingkah laku dan prestasi yang sangat berbeza disebabkan oleh—atau mungkin disebabkan oleh—mikroarkitektur mereka.
Reka bentuk ini merangkumi elemen seperti jenis unit kawalan , sama ada mikrokod boleh atur cara atau logik berwayar keras digunakan; hierarki memori; kedalaman saluran paip; berapa banyak unit berfungsi yang berfungsi secara selari; dan sama ada pemproses mampu melaksanakan arahan secara tidak teratur dan spekulatif.
Di samping itu, pereka bentuk mesti memilih kedalaman saluran paip : daripada CPU mudah tanpa saluran paip, di mana setiap arahan diproses dari awal hingga akhir sebelum memulakan yang seterusnya, kepada reka bentuk moden dengan banyak peringkat (ambil, nyahkod, nama semula, hantar, laksanakan, tulis semula, tamatkan…) yang membolehkan berpuluh-puluh arahan beroperasi pada masa yang sama.
Berkaitan dengan ini ialah bilangan dan jenis unit pelaksanaan : ALU untuk integer, unit pendaraban, pembahagi, FPU untuk nombor titik apung skalar dan vektor, AGU (Unit Penjanaan Alamat) untuk mengira alamat memori, unit lompat, dsb. Jika terdapat beberapa unit jenis yang sama, kita bercakap tentang pemproses superskalar, yang mampu menghantar beberapa arahan setiap kitaran.
Ini adalah asas untuk teknik lanjutan seperti pelaksanaan spekulatif , di mana CPU menjangkakan penyelesaian cabang dan melaksanakan arahan daripada salah satu cabang terlebih dahulu. Jika ramalan betul, masa dapat dijimatkan; jika gagal, kerja yang dilakukan akan dibuang dan saluran paip dikosongkan, dengan penalti yang sepadan.
Kebanyakan CPU berprestasi tinggi moden juga menggunakan pelaksanaan di luar susunan (OoO) . Daripada mematuhi sepenuhnya susunan program, pemproses menyusun semula arahan secara dalaman dan melaksanakan arahan yang datanya sudah siap terlebih dahulu, mengelakkan kitaran terbiar sementara yang lain menunggu memori atau hasil operasi sebelumnya.
Untuk memastikan semua ini berfungsi tanpa melanggar semantik program, penamaan semula daftar digunakan . Pengkompil melihat set daftar logik yang terhad, tetapi mikroarkitektur menterjemahkannya ke dalam bank daftar fizikal yang lebih besar, secara dinamik menetapkan destinasi baharu untuk memecahkan kebergantungan palsu dan membenarkan paralelisme yang lebih besar.
Akhir sekali, reka bentuk ini boleh memberi tumpuan kepada penambahan paralelisme pada peringkat teras dan thread . Ini termasuk segala-galanya daripada CPU teras tunggal kepada cip dengan berpuluh-puluh atau beratus-ratus teras (banyak teras), sistem berbilang pemproses dengan berbilang soket yang saling terhubung oleh rangkaian jejaring berkelajuan tinggi (Infinity Fabric, Intel Mesh, NVLink, dll.), dan sokongan berbilang thread serentak (SMT) supaya setiap teras fizikal boleh mengendalikan dua atau lebih thread logik.
Keserasian, ISA dan keluarga mikroarkitektur
Oleh kerana mikroarkitektur hanyalah satu pelaksanaan khusus ISA , satu ISA boleh mempunyai berpuluh-puluh mikroarkitektur yang berbeza selama bertahun-tahun dan merentasi pengeluar yang berbeza. Inilah yang berlaku dengan x86-64/AMD64 atau ARM.
Dengan hanya melihat AMD dalam AMD64 ISA, kita dapati pelbagai keluarga seperti K8/Hammer, K10, Bulldozer dan keseluruhan siri Zen (Zen, Zen+, Zen 2, Zen 3, Zen 4...). Kesemuanya melaksanakan set arahan asas yang sama, tetapi organisasi dalaman, cache, saluran paip dan pendekatan pelaksanaan selari mereka adalah sama sekali berbeza.
Apabila kita menukar ISA, lonjakan keserasian adalah mutlak. Pemproses berasaskan ARM A64 (seperti Apple Silicon) tidak boleh menjalankan binari yang dikompilasi untuk x86-64, dan sebaliknya, melainkan lapisan terjemahan atau emulasi seperti Rosetta 2, QEMU atau yang serupa digunakan, dengan kos prestasi yang sepadan.
Walaupun antara pemproses yang berkongsi ISA, tiada jaminan bahawa semuanya menyokong set arahan atau sambungan yang sama. Cip yang lebih lama mungkin kekurangan AVX2 atau AVX-512, atau SoC ARM mungkin hanya melaksanakan subset sambungan pilihan. Oleh itu, binari yang banyak menggunakan AVX-512 mungkin gagal boot pada CPU yang hanya menawarkan SSE4.
Semasa mengkompilasi perisian, amalan biasa adalah untuk menjana binari generik untuk ISA tertentu (contohnya, x86-64 dengan sekurang-kurangnya SSE2) tanpa menggunakan sepenuhnya sebarang mikroarkitektur tertentu, supaya boleh laku berjalan pada seberapa banyak CPU yang mungkin. Walau bagaimanapun, jika anda mengkompilasi dengan bendera penalaan untuk mikroarkitektur tertentu (-march=znver3, -mtune=skylake, dll.), anda boleh meningkatkan prestasi dengan ketara pada keluarga tertentu, dengan kos kehilangan keserasian dengan yang lain.
Lesen ISA dan harta intelek reka bentuk
Bukan sahaja kod program dilindungi oleh lesen: ISA dan mikroarkitektur juga merupakan harta intelek. Tiada sesiapa yang boleh mengklon ISA x86 atau AMD64 secara sah tanpa lesen, sama seperti reka bentuk CPU proprietari tidak boleh disalin tanpa kebenaran.
Dalam bidang ISA, terdapat tiga pendekatan utama. Di satu pihak, terdapat ISA tertutup , di mana pemilik mengawal ketat siapa yang boleh melaksanakan teras yang serasi. Contoh klasik ialah IA-32 (x86-32), yang secara sejarahnya dimiliki oleh Intel, yang memberikan lesen kepada AMD, VIA dan lain-lain, bukan tanpa pertempuran undang-undang.
Situasi yang serupa wujud dengan AMD64/x86-64 , yang pada mulanya direka oleh AMD dan kemudiannya dilesenkan kepada Intel (yang memanggilnya EM64T) melalui perjanjian pelesenan silang. Pemain lain, seperti Hygon di China, juga telah memperoleh lesen untuk versi tertentu (contohnya, Zen 1 untuk pasaran China).
Kemudian kita mempunyai ISA dengan pelesenan fleksibel , di mana pemiliknya menawarkan lesen ISA dan teras IP yang sedia untuk diintegrasikan. ARM, SPARC atau OpenPOWER sesuai di sini: anda boleh membayar untuk menggunakan Cortex A/M/R atau Neoverse seadanya, atau untuk lesen yang membolehkan anda mereka bentuk mikroarkitektur anda sendiri di atas ISA, seperti yang dilakukan oleh Apple dengan M1/M2/M3 atau Qualcomm dengan Kryo.
Akhir sekali, terdapat ISA sumber terbuka , di mana sesiapa sahaja boleh mencipta mikroarkitektur yang serasi tanpa membayar royalti untuk ISA (walaupun mereka boleh mempatenkan atau menutup pelaksanaan mereka sendiri). RISC-V adalah contoh terbaik: ISA berada di bawah lesen BSD yang permisif, dan terdapat pilihan daripada kernel yang terbuka sepenuhnya dalam Verilog atau Chisel kepada reka bentuk komersial tertutup.
Selain ISA, setiap mikroarkitektur khusus (teras Zen 4, Cortex X4, reka bentuk GPU, dll.) merupakan blok harta intelek yang dipatenkan atau didaftarkan. Terdapat juga reka bentuk terbuka di sini, yang diterbitkan sebagai teras lembut pada HDL untuk sintesis dalam FPGA atau penyepaduan ke dalam SoC tersuai.
Menyelidiki lebih mendalam tentang mikroarkitektur moden: kes AMD Zen
Untuk melihat bagaimana semua ini diterjemahkan kepada prestasi dunia sebenar, tiada yang setanding dengan membedah keluarga produk tertentu. AMD telah mengubah perniagaannya secara dramatik hasil daripada Zen dan lelarannya yang berturut-turut , beralih daripada era Bulldozer yang sukar dan pemproses FX lama kepada persaingan sengit (dan kadangkala mengatasi) Intel dalam pasaran desktop, pelayan dan komputer riba.
Selepas kegagalan strategi AMD Fusion , syarikat itu menstruktur semula dan memilih reka bentuk berprestasi tinggi yang diketuai oleh, antara lain, Jim Keller. Pelan Zen bertujuan untuk meningkatkan IPC (arahan setiap kitaran) secara agresif berbanding Bulldozer, meningkatkan prestasi setiap watt dan mendapatkan semula kedudukan dalam prestasi teras tunggal, di mana Intel telah menerajui selama bertahun-tahun.
Salah satu perubahan utama ialah pengukuhan bahagian hadapan , bahagian yang bertanggungjawab untuk mengambil dan menyediakan arahan. Zen memperkenalkan cache operasi mikro yang menyimpan operasi mikro yang telah dinyahkod, serupa dengan apa yang dilakukan oleh beberapa mikroarkitektur Intel seperti Conroe. Bulldozer kekurangan ini dan lebih bergantung pada hierarki cache arahan klasik, yang memberi kesan negatif kepada daya pemprosesannya.
Penyahkod Zen boleh menterjemahkan sehingga empat arahan CISC x86-64 setiap kitaran kepada mikro-operasi seperti RISC. Mikro-operasi ini kemudiannya diletakkan dalam barisan yang diberi makan oleh penimbal mikro-operasi, yang seterusnya boleh menghantar sehingga enam mikro-operasi setiap kitaran kepada penjadual bahagian belakang. Di sinilah pelaksanaan di luar susunan bermula.
AMD dengan jelas memisahkan laluan integer dan titik apungan . Pada bahagian integer, ALU, AGU dan logik beban/simpanan disuap daripada barisan operasi mikro. Logik ini mampu melaksanakan dua beban 16-bait dan satu storan 16-bait setiap kitaran daripada L1D 8-hala 32 KB, dengan dasar tulis balik.
Bahagian titik apungan dan vektor menyuap unit FMAC dan AVX. Dengan dua port pendaraban dan dua port penambahan, Zen boleh melaksanakan dua operasi FMA 128-bit atau satu operasi AVX 256-bit secara serentak bagi setiap kitaran jam. Paralelisme peringkat arahan ini merupakan salah satu kunci kepada prestasi kukuhnya di bawah beban kerja intensif pengiraan.
Hierarki cache, TLB dan organisasi memori dalam Zen
Hierarki memori dalam Zen disusun kepada tiga tahap cache: L1 berasingan untuk arahan dan data, L2 persendirian setiap teras dan L3 kongsi . Walaupun ia mewarisi struktur asas mikroarkitektur sebelumnya, saiz, asosiatif dan dasar telah diperhalusi.
L1I (cache arahan) menawarkan 64 KB setiap teras, dengan 4 laluan bersekutu, menggandakan bilangan laluan setiap modul berbanding Bulldozer dan mengurangkan konflik. L1D ( cache data) ditingkatkan kepada 32 KB, 8 laluan dan dasar tulis balik, berbanding Bulldozer 16 KB, 4 laluan dan tulis lalu, meningkatkan kadar hit dan kecekapan tulis dengan ketara.
Cache L2 dilaksanakan sebagai 512 KB setiap teras dan 8-hala, bukannya 2 MB 16-hala yang dikongsi setiap modul generasi sebelumnya. Sementara itu, cache L3 menawarkan beberapa MB setiap teras yang ditetapkan dengan asosiatif 16-hala, bertindak sebagai tahap kongsi terakhir sebelum pergi ke DRAM.
Secara selari, Zen memisahkan TLB kepada ITLB (untuk arahan) dan DTLB (untuk data) , setiap satu dengan beberapa peringkat dan beratus-ratus entri, semuanya dengan perlindungan pariti. Ini mengurangkan kependaman terjemahan alamat maya kepada fizikal dengan ketara, yang menjadi semakin kritikal apabila saiz memori berkembang.
Apabila kita bercakap tentang cache yang 2 hala, 4 hala atau 8 hala , kita sedang menerangkan asosiatifnya, yang berkait rapat dengan idea interleaving dalam memori. Lebih banyak asosiatif bermaksud lebih banyak cara berbeza untuk menyimpan blok memori dalam cache tersebut, mengurangkan konflik, tetapi dengan mengorbankan logik yang sedikit lebih kompleks dan sedikit peningkatan dalam latensi.
Penting juga untuk memahami perbezaan antara tulis-lalu dan tulis-balik . Dalam tulis-lalu, setiap tulis mengemas kini cache dan memori utama secara serentak, memudahkan konsistensi tetapi meningkatkan trafik. Dalam tulis-balik, hanya cache yang ditulis dan baris ditanda dengan bit kotor; DRAM hanya dikemas kini apabila baris tersebut dikeluarkan, menjimatkan lebar jalur dan meningkatkan prestasi dengan mengorbankan logik yang sedikit lebih kompleks.
Zen dan Zen+: lonjakan dalam IHP dan kecekapan
Zen mewakili lonjakan IPC yang sangat ketara untuk AMD berbanding Bulldozer , hasil gabungan bahagian hadapan yang lebih baik, peramal cabang yang lebih baik, lebih banyak unit pelaksanaan, SMT dan bukannya CMT (setiap teras penuh mengendalikan dua thread, bukannya berkongsi sebahagian FPU antara dua teras logik) dan hierarki cache yang jauh lebih masuk akal.
Selain reka bentuk, AMD mendapat manfaat daripada proses pembuatan yang lebih canggih dengan FinFET dan nod yang lebih kecil , yang membolehkan peningkatan ketumpatan transistor, pengurangan penggunaan kuasa pada prestasi yang sama dan frekuensi yang lebih tinggi sambil mengekalkan TDP ( lengkung frekuensi voltan ) yang munasabah. Keseimbangan prestasi setiap watt ini adalah penting untuk mendapatkan semula daya saing dalam komputer riba dan pelayan.
Peralihan daripada Bulldozer kepada Zen juga membawa kepada barisan pemberhentian yang lebih panjang, penjadual arahan yang lebih besar, lebar jalur dalaman yang lebih besar, ramalan cabang dengan teknik yang berasaskan rangkaian saraf mudah dan SMT yang mampu memerah unit pelaksanaan yang tersedia dengan lebih baik.
Dalam konteks ini, Zen+ muncul , yang boleh kita lihat sebagai bersamaan dengan "tanda semak" dalam strategi Tick-Tock lama Intel: reka bentuk asas yang sama seperti Zen, tetapi dihasilkan pada nod yang lebih halus, dengan penambahbaikan frekuensi, pengurangan latensi sedikit dan pelarasan masa dalaman. Ia bukanlah revolusi seni bina, tetapi sebaliknya penambahbaikan yang diterjemahkan kepada beberapa titik prestasi tambahan.
Zen 2: ciplet, AVX2 penuh dan penghalusan mendalam
Dengan Zen 2 , AMD bukan lagi sekadar menggilap prosesnya: ia memperkenalkan perubahan mikroarkitektur yang besar dan melancarkan strategi cipletnya secara besar-besaran . Daripada satu acuan monolitik yang besar, ia membahagikan reka bentuk kepada beberapa acuan pengkomputeran (CCD) 7nm yang lebih kecil dan acuan I/O 12nm yang berasingan yang mengendalikan memori, PCIe dan sambungan.
Pendekatan ciplet ini meningkatkan hasil setiap wafer (lebih mudah untuk mengeluarkan acuan kecil yang bebas kecacatan), mengurangkan kos dan memudahkan untuk meningkatkan bilangan teras: hanya tambah lebih banyak CCD untuk mencapai 16, 32 atau lebih teras dalam EPYC dan Threadripper. Pertukarannya adalah komunikasi dalaman yang sedikit lebih kompleks, bergantung pada sambungan Infinity Fabric, yang telah diperhalusi oleh AMD dari generasi ke generasi.
Dari segi prestasi mentah, AMD menyatakan sekitar +15% IPC untuk Zen 2 berbanding Zen+ pada frekuensi yang sama dan peningkatan prestasi keseluruhan setiap watt yang boleh menjadi sekitar +75% berbanding Zen pertama apabila penambahbaikan reka bentuk dan proses digabungkan.
Dalam bahagian belakang vektor, Zen 2 mengambil bahagian yang hilang: ia menawarkan sokongan penuh AVX2 256-bit dalam satu operasi mikro , tanpa membahagikan arahan kepada dua operasi 128-bit seperti yang berlaku dalam Zen/Zen+. Ini bermakna unit pelaksanaan vektor kini benar-benar 256-bit dan boleh memproses beban kerja AVX2 pada kelajuan penuh dengan penalti frekuensi yang jauh lebih kecil berbanding reka bentuk lain.
Cache mikro-operasi juga sedang diperkukuh, meningkat kepada entri 4K (dua kali ganda saiznya), memanfaatkan sebahagian kawasan yang dibebaskan dengan mengurangkan separuh cache L1I tetapi menggandakan asosiatifnya daripada 4 kepada 8 cara. Simulasi dalaman menyebabkan AMD menyimpulkan bahawa, untuk kebanyakan beban kerja dunia sebenar, cache uop yang lebih besar adalah lebih berfaedah daripada cache L1I yang lebih besar.
Kapasiti cache L3 setiap blok teras digandakan , yang membantu mengurangkan kegagalan peringkat terakhir, walaupun latensi akses meningkat daripada kira-kira 35 kepada 40 kitaran. Untuk mengurangkan kesan ini, Zen 2 menambah baik lebar jalur pemuatan dan penyimpanan serta memperhalusi dasar praambilan.
Satu lagi aspek penting ialah peramal cabang. Zen 2 menggunakan peramal TAGE (TAgged GEometric) dengan lebih 7 entri, yang mampu memanfaatkan sejarah panjang berubah-ubah dan entri yang ditag. Ini mengurangkan aliasing antara cabang yang berbeza dan, menurut AMD, mengurangkan bilangan ramalan yang salah sebanyak sekitar 30% berbanding skema sebelumnya, yang secara langsung diterjemahkan kepada lebih sedikit penyiraman saluran paip dan IPC yang lebih tinggi.
Bahagian Belakang Zen 2: AGU, penimbal dan latensi yang diselaraskan
Di keseluruhan bahagian belakang, Zen 2 terus menghantar sehingga enam operasi mikro setiap kitaran daripada penimbal susunan semula, yang diperluas kepada kira-kira 224 entri (berbanding Zen yang 192). Unit penjadualan dibahagikan kepada empat baris gilir untuk ALU yang setiap satu mempunyai 16 entri dan satu baris gilir untuk AGU yang setiap satu mempunyai 28 entri.
Bilangan Unit Penjanaan Alamat (AGU) meningkat daripada dua kepada tiga, walaupun tidak semuanya sama: dua daripadanya boleh mengendalikan kedua-dua beban dan penulisan, manakala yang ketiga mengkhusus dalam operasi storan. Pengagihan ini direka bentuk untuk profil perisian biasa, di mana beban biasanya lebih kerap dan kritikal daripada operasi stor.
Dalam satah titik apungan, bahagian belakang boleh menerima empat operasi mikro setiap kitaran kepada unit vektor FMA 256-bitnya, disokong oleh fail daftar fizikal 160 entri. Laluan beban/simpanan 256-bit telah dipertingkatkan untuk memberi makan unit-unit ini pada kadar yang berterusan di bawah beban kerja vektor yang berat.
Zen 2 juga melaraskan latensi operasi tertentu : contohnya, pendaraban titik apungan mengurangkan latensinya daripada 4 kepada 3 kitaran, yang membantu dengan gelung pengiraan berangka yang sangat ketat. Dan, secara amnya, terdapat satu set pengoptimuman kecil yang tersebar di seluruh saluran paip yang menambah kepada IPC tambahan yang dilihat dalam penanda aras sintetik dan aplikasi dunia sebenar.
Berkenaan hierarki dalaman mengikut kumpulan teras, AMD menggunakan konsep CCX (Core Complex) : blok 4 teras yang berkongsi cache L3 yang sama (16 MB dalam Zen 2). Saiz tambahan ini membayangkan kependaman yang sedikit lebih tinggi, tetapi sebaliknya mengurangkan kadar kegagalan, terutamanya dalam aplikasi dengan set kerja yang besar.
Sebagai rujukan, kita boleh mengingati angka kependaman dalaman anggaran: sekitar 4 kitaran untuk L1 , kira-kira 12 untuk L2, dan sekitar 40 kitaran untuk L3. Kuncinya adalah untuk menyimpan sebanyak mungkin data dalam L1/L2 dan mengurangkan trafik ke L3 dan DRAM , sesuatu yang mikroarkitektur dan pengkompil bekerjasama untuk dicapai.
Infinity Fabric: gam yang digunakan dalam chiplet dan kesannya terhadap prestasi
Satu komponen yang tidak selalunya dikaitkan dengan mikroarkitektur, tetapi penting dalam Zen 2 dan yang lebih baharu, ialah Infinity Fabric . Bas proprietari ini bertindak sebagai "lebuh raya" komunikasi antara CCX, CCD, acuan I/O, memori dan, secara amnya, antara semua blok SoC.
Infinity Fabric merupakan evolusi HyperTransport , bas berkelajuan tinggi yang dipelopori oleh AMD bertahun-tahun yang lalu dan turut digunakan oleh pihak ketiga seperti NVIDIA, Cisco, Sun dan ahli konsortium lain. IF mewarisi falsafah pautan titik-ke-titik yang boleh diskalakan, tetapi disesuaikan dengan keperluan SoC moden dan sambungan CPU-GPU.
Dalam Zen 2, AMD memperkenalkan IF2 , dengan sokongan untuk PCIe 4.0 dan bas dalaman 512-bit antara CCX, dua kali ganda daripada versi pertama. Ini diterjemahkan kepada lebar jalur yang lebih berkesan dan peningkatan kecekapan yang AMD anggarkan sekitar 27% berbanding IF1, membantu mengurangkan penalti prestasi bertukar antara ciplet.
Tambahan pula, jam Infinity Fabric sebahagiannya diasingkan daripada jam DRAM , yang membolehkan memori utama diskalakan kepada frekuensi yang lebih tinggi dalam senario tertentu tanpa semestinya memaksa IF untuk mengikuti rentak, yang menawarkan lebih banyak ruang penalaan halus untuk peminat dan pereka sistem.
Dalam pemproses pelayan seperti EPYC , dengan empat atau lebih ciplet pengiraan, Infinity Fabric membolehkan semua dadu disambungkan bersama-sama dengan topologi yang hampir lengkap (putaran 180º, pautan langsung, dll.), mencapai lebar jalur die-to-die yang boleh melebihi dwiarah 150 GB/s dengan mudah bergantung pada kelajuan DDR yang digunakan.
Gabungan mikroarkitektur yang mantap dalam setiap teras , reka bentuk yang boleh diskala menggunakan ciplet dan sambungan yang cukup pantas membolehkan AMD memasang CPU dengan 32, 64 atau lebih teras dengan prestasi cemerlang dalam beban kerja yang sangat selari, sambil mengekalkan IPC setiap thread yang kompetitif.
Akhirnya, apabila anda membandingkan pemproses dalam penanda aras permainan, pemaparan 3D, kompilasi besar-besaran atau simulasi saintifik, angka kiraan GHz dan teras hanya menceritakan sebahagian daripada cerita. Apa yang benar-benar membuat perbezaan ialah bagaimana mikroarkitektur mengatur pelaksanaan dalaman , bagaimana ia menggunakan atau membazirkan setiap kitaran jam dan apakah pertukaran yang telah dibuat oleh pengeluar antara kependaman, lebar jalur, penggunaan kuasa dan kerumitan.
