- Seni bina Blackwell memperkenalkan kuasa yang belum pernah terjadi sebelumnya dengan cip yang mengandungi 208.000 bilion transistor dan sokongan untuk format data FP4.
- Evolusi ini berterusan dengan Blackwell Ultra dan platform Rubin yang akan datang, yang memberi tumpuan kepada penaakulan AI dan model berskala trilion.
- Strategi NVIDIA mengutamakan infrastruktur pusat data sebelum membawa inovasi ini ke sektor permainan dan profesional.

Industri pengkomputeran dipercepatkan sedang mengalami detik yang belum pernah terjadi sebelumnya, dan NVIDIA merupakan teras pergolakan ini. Dengan pelancaran seni bina Blackwell, syarikat itu bukan sahaja berusaha untuk menambah baik apa yang telah dimilikinya, tetapi juga bertujuan untuk mentakrifkan semula kuasa pemprosesan untuk era kecerdasan buatan generatif, meninggalkan generasi Hopper dan Ada Lovelace sebelumnya.
Bukan rahsia lagi bahawa permintaan untuk cip untuk melatih rangkaian saraf adalah sangat tinggi, dan NVIDIA telah memainkan peranan yang tepat untuk mengekalkan monopoli hampir sepenuhnya dalam sektor ini. Platform baharu ini bukan sekadar silikon yang lebih pantas, tetapi ekosistem kompleks yang membolehkan model bahasa dengan bertrilion parameter dijalankan sambil menggunakan kuasa yang jauh lebih rendah berbanding sebelum ini, memudahkan pelaksanaan LLM tempatan dalam persekitaran perusahaan.

Teras Blackwell: Kejuruteraan di hadnya
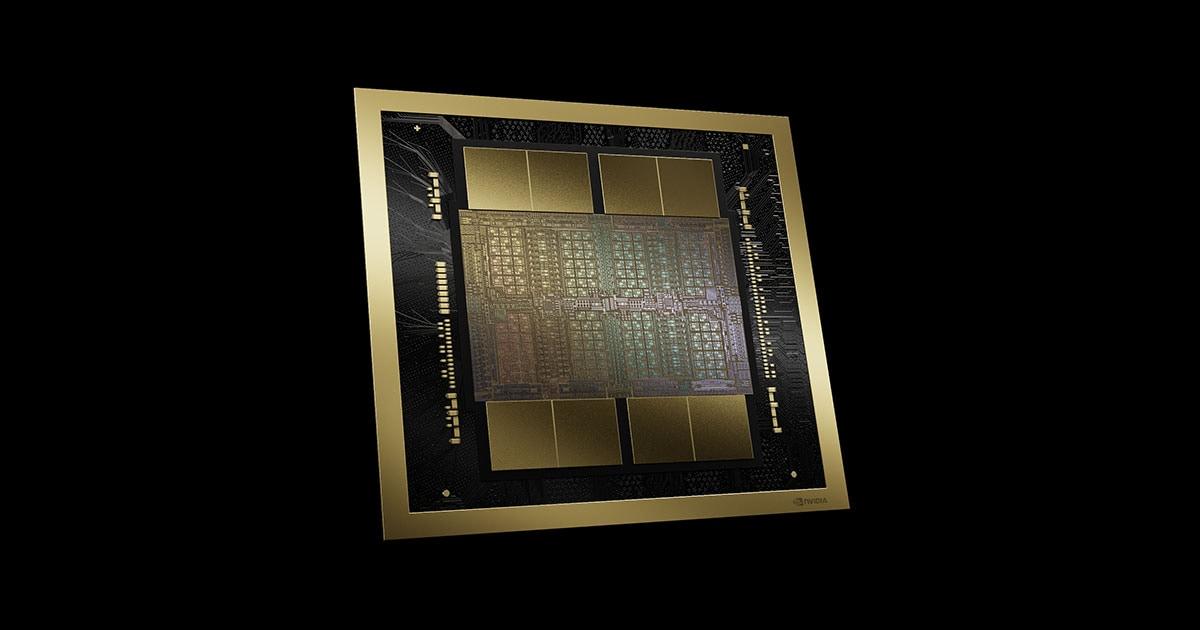
Jika kita mendalami spesifikasi teknikalnya, Blackwell memang hebat. Bagi pusat data, ia menggunakan proses TSMC 4NP , iaitu versi 4N yang dioptimumkan. Cip GB100 sangat besar sehingga ia telah mencapai had fizikal yang boleh diukir oleh mesin litografi, memaksa NVIDIA menggunakan dua acuan yang disambungkan melalui antara muka berkelajuan tinggi yang dipanggil NV-HBI, berdasarkan NVLink 7.
Konfigurasi ini membolehkan sistem berfungsi seolah-olah ia adalah cip monolitik tunggal, mencapai sejumlah 208.000 bilion transistor . Dari segi prestasi, lonjakannya sangat besar: Teras Tensor generasi kelima telah diperkenalkan yang menyokong format ketepatan rendah seperti MXFP4 dan MXFP6 , membolehkan inferens AI yang lebih pantas dan cekap.
Bagi mereka yang mahukan kualiti visual, seni bina ini juga membawakan teras penjejakan sinar generasi keempat. Mereka telah menambah enjin persilangan kluster segitiga untuk meningkatkan geometri kompleks dan penjejakan butiran halus, seperti rambut, menjadikan pemaparan jauh lebih realistik terima kasih kepada penjanaan bingkai DLSS dalam permainan video.
Blackwell Ultra dan ketibaan Rubin
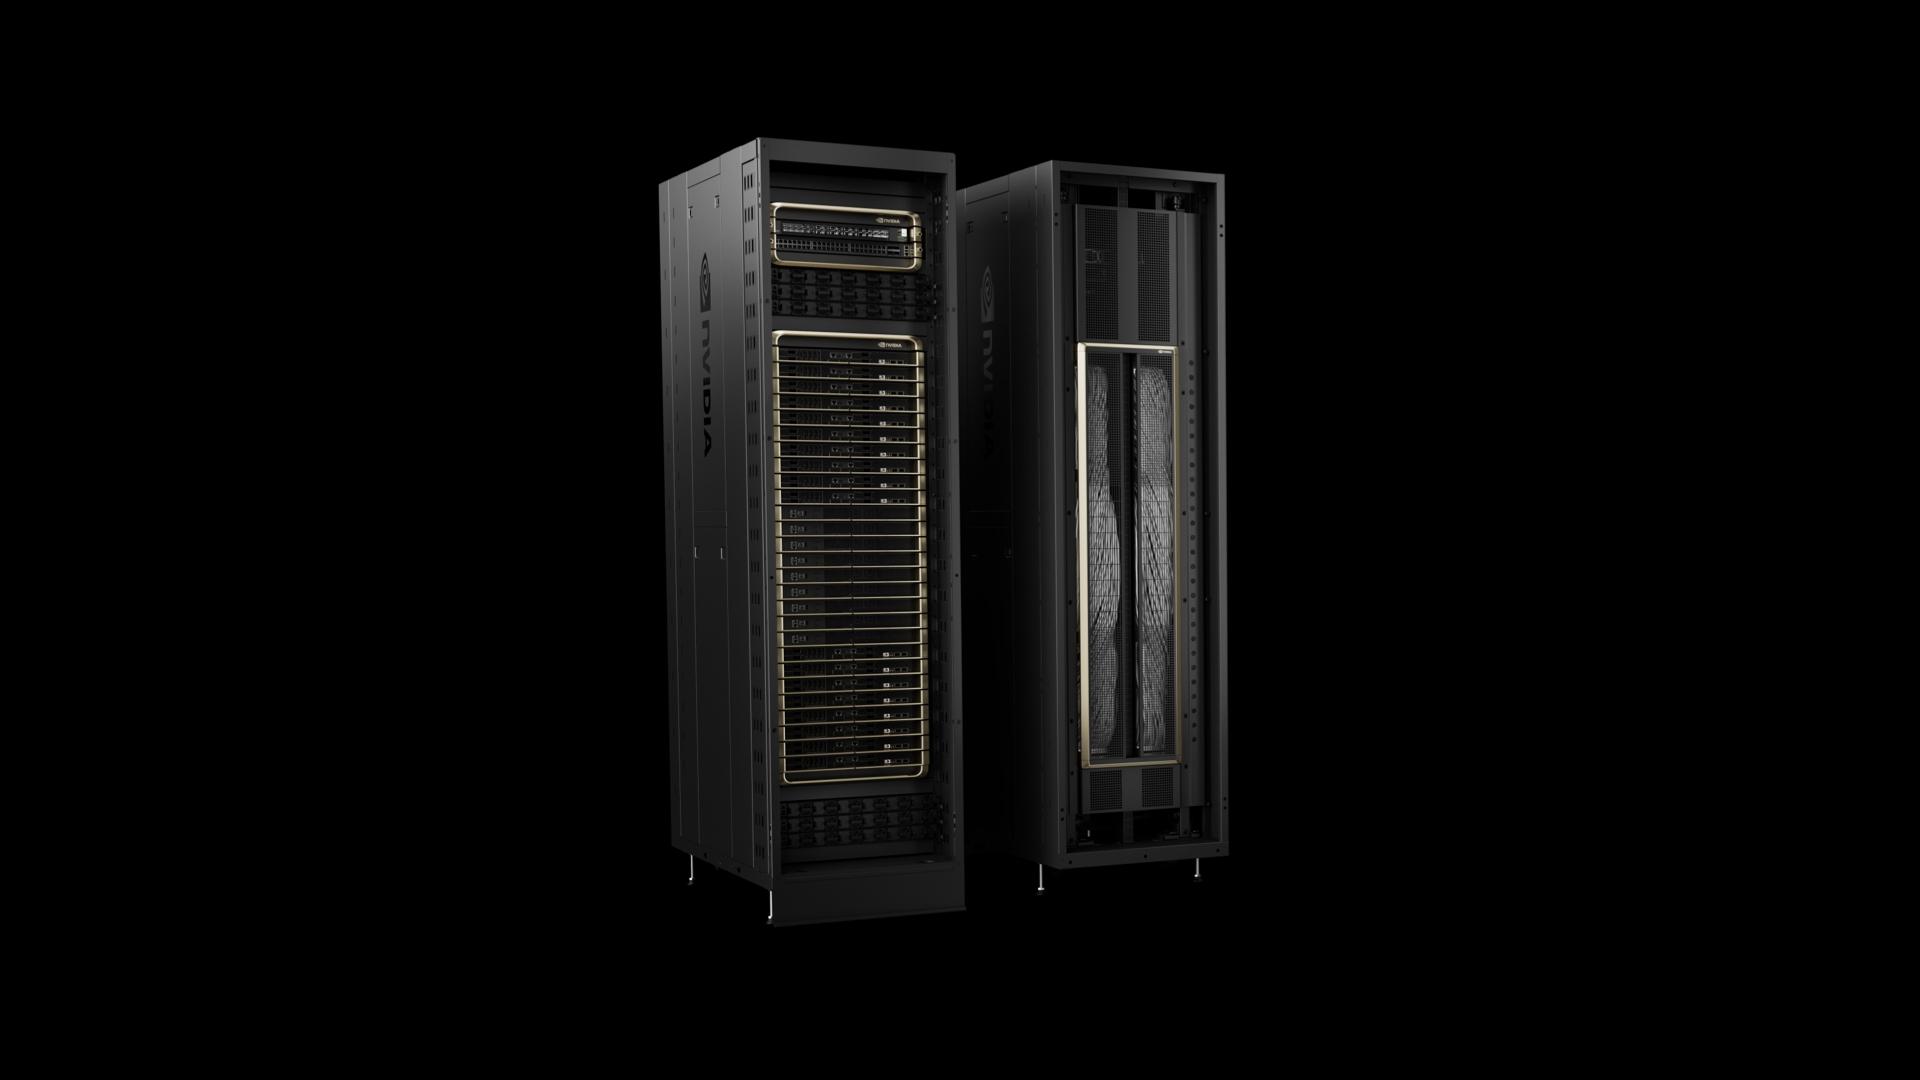
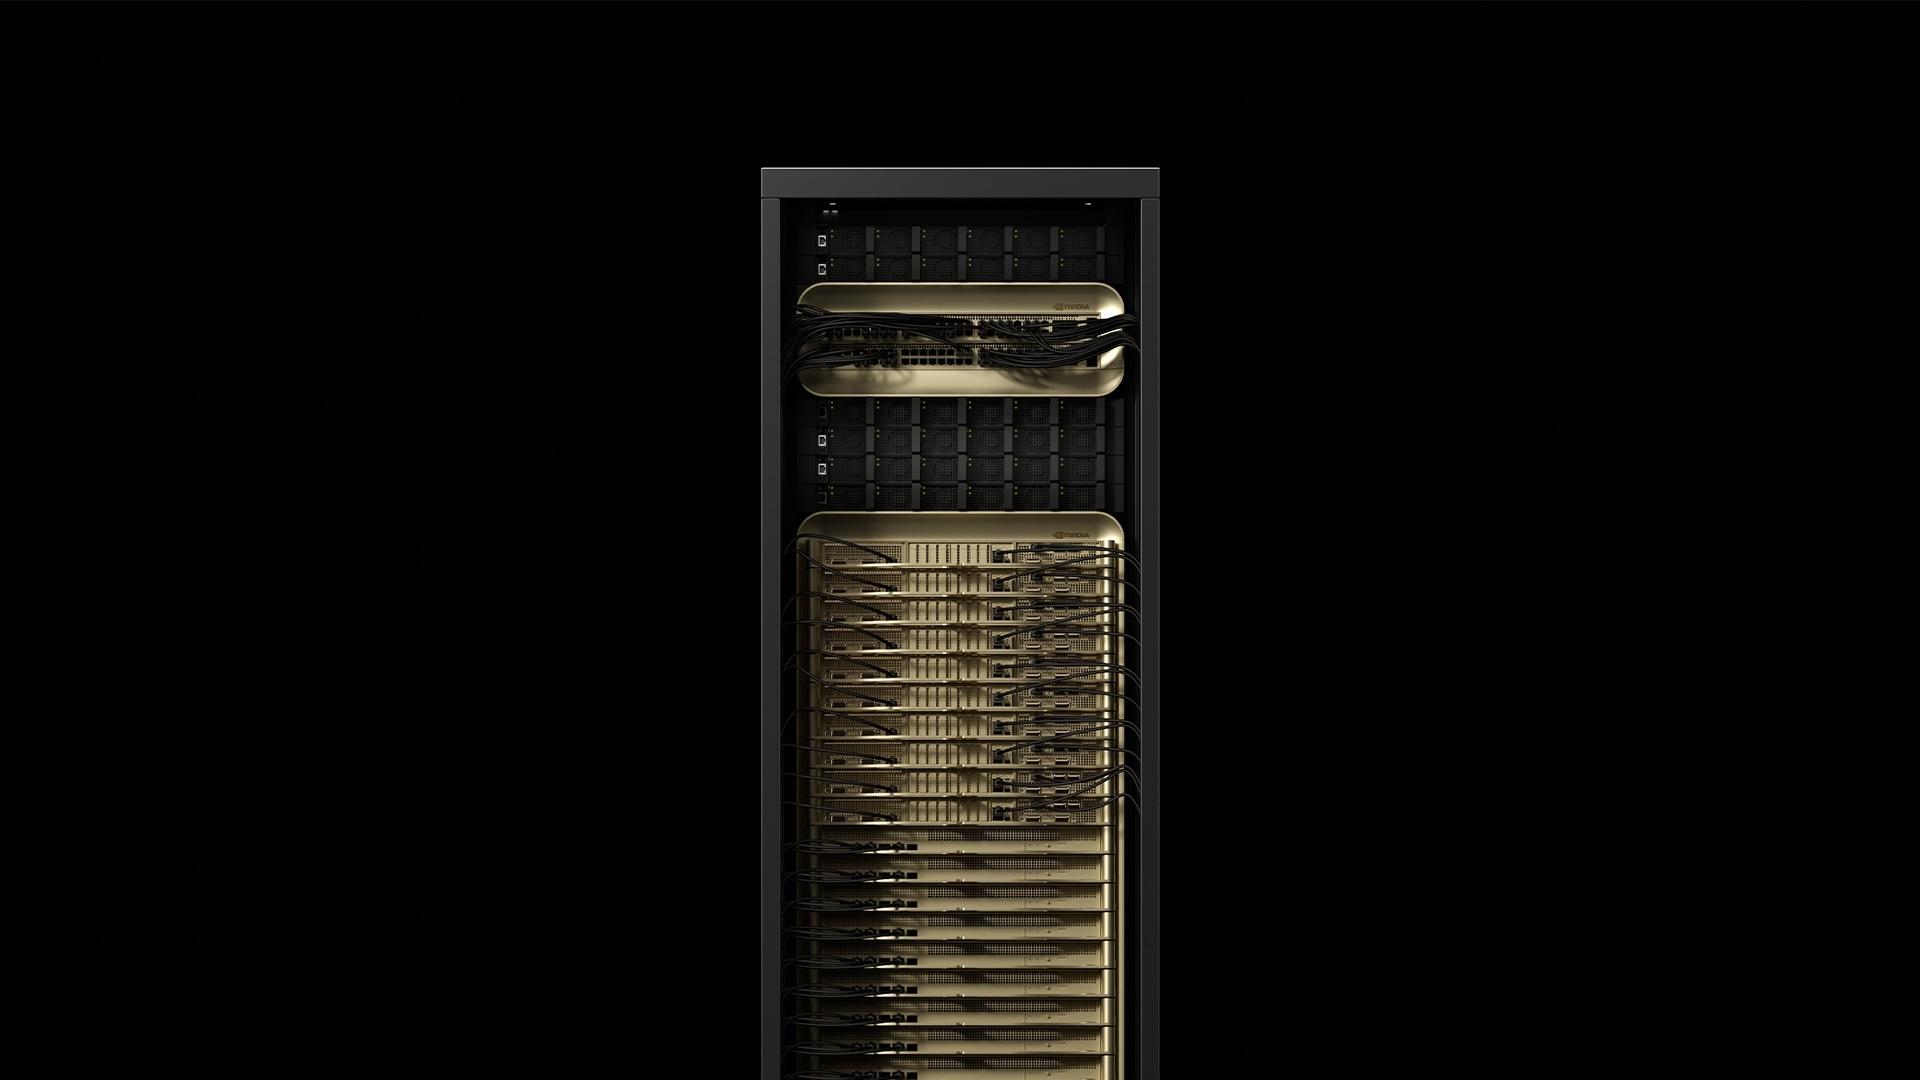
Namun NVIDIA tidak berdiam diri dan telah pun memperkenalkan Blackwell Ultra , satu evolusi yang direka khusus untuk apa yang mereka panggil "AI penaakulan." Versi ini meningkatkan keupayaan model untuk berfikir dalam langkah yang kompleks dan menyelesaikan masalah secara autonomi. Sistem GB300 NVL72, sebagai contoh, menawarkan prestasi 1,5 kali ganda lebih baik daripada GB200 yang asal.
Di sinilah istilah misteri Blackwell-Next memainkan peranan , yang telah mula muncul dalam pemacu Linux 7.2. Semuanya menunjukkan bahawa ia merupakan persediaan untuk seni bina Rubin , pengganti langsung kepada Blackwell. Rubin akan digandingkan dengan CPU Vera, membentuk duo yang ditakdirkan untuk menguasai pengkomputeran berketumpatan tinggi.
Dalam jangka masa panjang, hala tuju syarikat itu bercita-cita tinggi. Selepas Rubin, ketibaan Feynman sudah pun di ambang pintu , menjanjikan seni bina yang baharu sepenuhnya. Jelas sekali bahawa NVIDIA sedang mengambil langkah strategik untuk menjadikan laluan daripada latihan model kepada inferens masa nyata selancar mungkin, memacu penggunaan AI tempatan dan automasi ejen.
Segmen pengguna dan masa depan RTX
Walaupun pelayan merupakan keutamaan utama, pemain permainan tidak diabaikan. Proses TSMC 4N digunakan untuk pasaran pengguna . Cip paling berkuasa, GB202, adalah 20% lebih besar daripada AD102 generasi sebelumnya dan mempunyai 24.576 teras CUDA , mewakili peningkatan besar dalam kuasa mentah.
Dalam keluarga produk, kita akan melihat ketibaan RTX 5090 dan 5080 , selain versi yang lebih sederhana seperti 5060 dan 5050. RTX Spark juga telah disebut , penyelesaian yang mengintegrasikan CPU Arm dan GPU Blackwell ke dalam satu pakej, sesuai untuk memilih komputer riba permainan yang disyorkan dengan keupayaan AI yang kuat.
Salah satu ciri baharu yang paling menarik ialah Pemproses Pengurusan AI (AMP) , cip berasaskan RISC-V yang mengurus sumber GPU. Ini membebaskan pemproses utama daripada tugas penjadualan, meningkatkan prestasi keseluruhan hasil daripada teknologi penjadualan yang dipercepatkan perkakasan Windows.
Cabaran teknikal dan penguasaan pasaran
Tidak semuanya berjalan lancar. Blackwell pernah mengalami beberapa kemunduran, termasuk isu terlalu panas dan kecacatan reka bentuk yang memaksa NVIDIA bekerjasama rapat dengan TSMC untuk membetulkannya. Kesilapan ini mengakibatkan prestasi wafer silikon yang berkurangan, sedikit melambatkan penghantaran awal, yang mengingatkan risiko yang berkaitan dengan teknik overclocking CPU dan GPU.
Walaupun begitu, pasaran begitu lapar sehingga semua pengeluaran tahun 2025 telah habis dijual, menurut beberapa penganalisis. Rantaian bekalan merupakan operasi logistik yang besar yang melibatkan semua orang daripada Foxconn dan SK Hynix hingga Vertiv, memastikan rak NVL72 sampai kepada syarikat gergasi seperti Microsoft, Meta dan OpenAI.
Berkenaan perisian, platform ini bergantung pada NVIDIA AI Enterprise dan rangka kerja inferens NVIDIA Dynamo yang baharu . Perisian ini adalah kunci untuk mengoptimumkan penjanaan token dan mengurangkan kos perkhidmatan, membolehkan kilang AI menguntungkan walaupun pelaburan yang besar diperlukan.
Peralihan teknologi NVIDIA terus maju dengan pesat, mengukuhkan struktur di mana kuasa pengkomputeran dan kecekapan tenaga menentukan rentak inovasi. Daripada cip Blackwell dan varian Ultra mereka kepada seni bina Rubin yang akan datang, syarikat itu telah menjamin kedudukannya di puncak, memastikan bahawa kedua-dua AI generatif dan permainan mewah mempunyai enjin yang mampu menggerakkan model paling bercita-cita tinggi dalam dekad ini.