- Kebanyakan bencana sistem RAID diburukkan lagi oleh tindakan terburu-buru dalam beberapa minit pertama selepas kegagalan.
- Setiap tahap RAID mengurus data dan pariti secara berbeza, yang menentukan risiko sebenar dan strategi pemulihan.
- Intervensi profesional ini menggabungkan pengklonan cakera, pembinaan semula tatasusunan maya dan teknik analisis logik lanjutan.
- RAID tidak menggantikan sandaran: pencegahan dan tindak balas yang teratur adalah kunci untuk menyimpan data.
Apabila sistem RAID gagal, beberapa minit pertama adalah kritikal. Dalam apa yang dipanggil "waktu keemasan" selepas kegagalan, kebanyakan kesilapan manusia berlaku, menjadikan masalah yang boleh dipulihkan menjadi bencana yang tidak dapat dipulihkan. Menukar cakera secara membuta tuli, memulakan semula secara berterusan atau cuba membina semula tanpa mengetahui apa yang salah biasanya merupakan jalan terpantas kepada kehilangan data sepenuhnya.
Mengapa pemulihan RAID begitu halus?
Dalam banyak insiden kritikal, kehilangan data bukan disebabkan oleh kegagalan perkakasan awal, tetapi oleh tindakan tergesa-gesa yang diambil semasa jam pertama . Tempoh ini adalah penting: cakera mungkin berubah kedudukan, proses permulaan mungkin dimulakan secara tidak sengaja, pembinaan semula mungkin terpaksa dilakukan, atau sistem mungkin but daripada sandaran yang tidak lengkap pada tatasusunan storan yang sama, dan apa yang dahulunya merupakan masalah yang kompleks tetapi boleh diurus menjadi teka-teki yang hampir mustahil.
Situasi risiko yang paling biasa termasuk menukar cakera dalam susunan yang salah (dalam RAID 0, 1, 5, 6, 10, dll.), menggantikan pengawal dengan model lain tanpa mengklon atau mendokumentasikan konfigurasi, memaksa cakera "dalam talian" tanpa menganalisis keadaan sebenar, memulakan volum yang salah atau melancarkan binaan semula yang tidak selesai dan merosakkan lagi struktur dalaman array.
Turut berbahaya ialah pemulihan sandaran terus ke sistem yang rosak , migrasi storan jenis VMware Storage vMotion dengan tatasusunan yang tidak stabil dan sebarang operasi yang menulis metadata konfigurasi RAID baharu ke cakera dengan maklumat yang berpotensi boleh dipulihkan.
Tatasusunan RAID merupakan asas bagi kebanyakan pelayan fizikal, sistem NAS dan SAN, dan tidak selalunya jelas sama ada masalah itu berpunca daripada tatasusunan itu sendiri. Oleh itu, apabila ragu-ragu, tindakan paling bijak adalah menghentikan semua penulisan ke cakera , mendokumentasikan situasi secara terperinci dan mendapatkan nasihat daripada pakar pemulihan data sebelum membuat sebarang perubahan selanjutnya.
Kesilapan manusia yang biasa dan amalan asas yang baik
Apabila sistem RAID memasuki keadaan terdegradasi, satu atau lebih cakera gagal, atau NAS tidak dapat boot, reaksi naluri biasanya adalah untuk mencuba sesuatu "sehingga sesuatu berfungsi." Pendekatan ini hampir selalu memburukkan lagi masalah kerana setiap tindakan meninggalkan jejak pada cakera dan boleh menulis ganti pariti, metadata atau data pengguna yang masih utuh.
Antara ralat paling kerap yang merumitkan pemulihan adalah tindakan seperti mengkonfigurasi RAID baharu menggunakan pengawal dan cakera yang sama , memasukkan cakera tersebut ke dalam kandang storan yang berbeza untuk "melihat sama ada ia mengenalinya," atau mengubah susunan fizikal ruang pemacu. Dalam peratusan kes yang tinggi, tindakan ini menulis ganti konfigurasi asal, memusnahkan jalur pariti dan mengurangkan peluang kejayaan secara drastik.
Satu lagi amalan buruk yang biasa berlaku ialah kegagalan merekodkan apa-apa yang berlaku. Dalam senario kegagalan yang kompleks, adalah penting untuk merekodkan semua peristiwa secara kronologi : gangguan bekalan elektrik, mesej sistem , perubahan cakera, percubaan membina semula, kemas kini perisian tegar, dsb. Maklumat ini kemudiannya membantu juruteknik khusus menyelesaikan masalah tersebut.
Sama pentingnya untuk mendokumentasikan dan memelihara kedudukan tepat setiap cakera dalam tatasusunan . Menukar ruang cakera "dengan mata kasar" atau membuang cakera yang dikatakan mati adalah melulu: jika RAID perlu dipasang semula di makmal kemudian, mengetahui cakera yang berada di slot yang mana dan mempunyai semua cakera asal (walaupun yang diganti) boleh membuat semua perbezaan.
Sebagai peraturan umum, sekiranya berlaku kegagalan RAID, tindakan berikut perlu diambil: hentikan komputer, jangan konfigurasi semula apa-apa, pastikan semua cakera dilabel , kumpulkan seberapa banyak maklumat yang mungkin tentang kejadian tersebut dan, jika data tersebut penting, hubungi perkhidmatan pemulihan profesional sebelum meneruskan percubaan.
Cara profesional mendekati pemulihan sistem RAID
Syarikat yang pakar dalam pemulihan data RAID menggunakan prosedur yang sangat berstruktur kerana setiap keputusan teknikal mesti meminimumkan risiko kerosakan selanjutnya . Dalam kes biasa dengan berbilang cakera dan terabait data yang dipertaruhkan, sebarang langkah improvisasi boleh menjadi mahal.
Satu contoh dunia sebenar yang sangat menggambarkan ialah tatasusunan RAID dengan dua belas cakera dan kira-kira 12 TB data. Sandaran tidak diuruskan dengan betul, jadi satu-satunya penyelesaian yang berdaya maju adalah menghubungi syarikat pemulihan data RAID profesional . Situasi ini mendesak; operasi perlu disambung semula secepat mungkin, dan tatasusunan telah pun mencapai keadaan kritikal selepas dua cakera gagal semasa konfigurasi semula.
Dalam senario sedemikian, pakar biasanya bermula dengan mengklon semua cakera yang berfungsi dan sentiasa mengusahakan salinan, bukan yang asal. Pada masa yang sama, mereka cuba membaiki, setakat yang mungkin, pemacu yang rosak secara fizikal, sama ada melalui intervensi makmal (bilik bersih, penggantian kepala, elektronik penderma, dll.) atau dengan teknik bacaan separa yang canggih.
Dalam kes pemacu 12 TB, masalah terbesar ialah konfigurasi semula RAID telah bermula sebelum kegagalan kedua , jadi pengawal telah mengira semula sebahagian daripada nilai pariti baharu. Kelebihan relatifnya ialah cakera kedua gagal pada peringkat awal proses, jadi sebahagian besar struktur logik lama masih boleh dipulihkan.
Selepas memulihkan salah satu cakera yang rosak dan menjana salinan lengkap, cabarannya adalah untuk membina semula struktur logik tatasusunan secara manual : susunan cakera, saiz blok, taburan pariti, kemungkinan perubahan di pertengahan proses… Kerja ini, yang boleh mengambil masa beberapa hari analisis, membolehkan kami memulihkan sekitar 90% data, yang, memandangkan keadaannya, dianggap sebagai kadar kejayaan yang tinggi dalam pemulihan RAID.
Perkhidmatan profesional: apa yang biasanya mereka tawarkan dan cara ia berfungsi
Syarikat yang pakar dalam pemulihan data RAID biasanya menawarkan diagnostik yang pantas dan percuma , terutamanya untuk pelayan kritikal atau peranti NAS pengeluaran. Dalam beberapa kes, mereka komited untuk menilai masalah dalam masa beberapa jam, menyediakan laporan kebolehlaksanaan dan sebut harga tetap, dan mematuhi dasar "tiada pemulihan, tiada caj".
Perkhidmatan biasa bermula apabila klien meminta sebut harga percuma untuk mendapatkan semula RAID mereka . Dalam fasa awal ini, maklumat dikumpulkan tentang jenis tatasusunan (RAID 0, 1, 5, 6, 10, JBOD, dll.), bilangan cakera, sistem fail (cth., ext4, Btrfs, XFS, HFS+, NTFS…), perkakasan yang terlibat (Synology NAS, QNAP, pelayan jenama, tatasusunan SAN…), dan penerangan terperinci tentang simptom dan tindakan yang diambil setakat ini.
Sebaik sahaja kajian diterima, syarikat biasanya akan mengatur pengumpulan peralatan atau cakera secara percuma , dengan menunjukkan arahan pembungkusan yang tepat: gunakan pembalut antistatik atau empuk, letakkan peranti di dalam kotak tegar dengan bahan penyerap hentakan, elakkan cakera daripada bergerak semasa pengangkutan dan labelkan dengan baik dengan nombor aplikasi.
Kembali ke makmal, juruteknik menjalankan diagnostik fizikal dan logik setiap cakera , mencipta imej bit demi bit apabila mungkin, menilai keadaan sektor dan memutuskan cara untuk membina semula RAID secara maya. Hanya selepas itu sebut harga akhir dibentangkan, termasuk anggaran peratusan data yang boleh dipulihkan dan anggaran masa pemulihan.
Jika pelanggan meluluskan, proses pemulihan sebenar akan bermula. Selepas menstabilkan pemacu dan menyediakan RAID dalam persekitaran terkawal, pakar akan menjana senarai fail yang boleh diakses. Sehingga ke tahap ini, pelanggan biasanya belum membayar apa-apa . Hanya jika senarai itu memuaskan, data akan disalin ke media storan baharu (pemacu keras luaran, NAS gantian, dsb.) dan dihantar kembali kepada pelanggan, hampir selalu dengan kos penghantaran.
Asas: cara RAID berfungsi di dalam
Secara ringkasnya, sistem RAID ialah satu set cakera fizikal yang dibentangkan kepada sistem pengendalian sebagai satu unit logik . Kuncinya terletak pada cara data diedarkan dan, berpotensi, pariti antara cakera untuk mendapatkan prestasi, kapasiti, toleransi kesalahan atau gabungannya.
Teknologi RAID membolehkan data diedarkan dalam jalur atau blok yang ditulis secara selari merentasi berbilang cakera, mempercepatkan akses dengan menggabungkan pemindahan. Selain itu, data berlebihan (pariti) disimpan pada tahap tertentu untuk mengira semula data daripada cakera yang gagal tanpa gangguan perkhidmatan, dengan syarat had kegagalan yang dinyatakan dalam reka bentuk tatasusunan tidak dilebihi.
Satu lagi kelebihan penting ialah keupayaan untuk menukar cakera secara panas pada banyak sistem. Ini bermakna cakera yang rosak boleh dialih keluar dan diganti secara fizikal tanpa mematikan pelayan atau susunan storan, membolehkan pengawal membina semula data yang hilang pada cakera baharu di latar belakang sementara sistem terus beroperasi.
Tiada "tahap RAID" tunggal yang sesuai untuk semua senario. Setiap tahap mengutamakan keseimbangan yang berbeza antara prestasi, keselamatan dan kapasiti yang boleh digunakan . Oleh itu, adalah penting untuk memahami jenis RAID yang dikonfigurasikan sebelum mencuba sebarang operasi pembaikan atau pemulihan.
Apabila berlaku sesuatu yang tidak kena, RAID itu sendiri biasanya boleh membina semula data jika toleransi kesalahan yang dirancang dipenuhi. Walau bagaimanapun, apabila beberapa masalah fizikal, logik atau manusia berlaku secara berturut-turut, tatasusunan boleh hilang koheren dan menjadi tidak dapat dipulihkan dengan sendirinya, memerlukan campur tangan pakar.
Tahap RAID biasa dan ciri-cirinya
Setiap tahap RAID mengurus pengagihan data dan pariti antara cakera secara berbeza , menghasilkan perbezaan tingkah laku yang sangat jelas sekiranya berlaku kegagalan. Memahami perbezaan ini membantu menilai risiko sebenar kegagalan dan kemungkinan pemulihan yang berjaya.
RAID 0, yang dikenali kerana prestasinya yang tinggi, mengedarkan data secara berjalur merentasi sekurang-kurangnya dua cakera tanpa menyimpan sebarang maklumat yang berlebihan. Ini bermakna kehilangan satu cakera mengakibatkan kehilangan keseluruhan volum , kerana sebahagian daripada setiap fail tersebar merentasi semua pemacu. Kelebihan utamanya ialah kelajuan, tetapi dari perspektif keselamatan data, ia sangat terdedah.
RAID 1, atau pencerminan, mengekalkan salinan data yang sama pada dua cakera . Jika satu gagal, cakera yang satu lagi akan terus beroperasi dengan lancar. Ia mudah, andal dan menawarkan kelajuan baca yang baik, walaupun ia mengorbankan kapasiti yang boleh digunakan, kerana ruang yang tersedia adalah bersamaan dengan satu cakera dalam pasangan tersebut. Dalam pemulihan, mempunyai sekurang-kurangnya satu cakera yang utuh biasanya menjadikan perkara lebih mudah.
Terdapat juga tahap RAID seperti RAID 3 dan RAID 4, yang kurang biasa pada masa kini, yang menggabungkan cakera data dengan cakera pariti khusus . Dalam RAID 3, akses kepada cakera data adalah serentak, dan cakera pariti menjadi potensi kesesakan, manakala RAID 4 membenarkan akses yang lebih bebas kepada setiap cakera data, meningkatkan prestasi di bawah beban kerja tertentu.
RAID 5 mungkin merupakan konfigurasi RAID yang paling banyak digunakan dalam persekitaran pelayan dan NAS. Ia mengedarkan data secara berjalur merentasi berbilang cakera dan menyelitkan blok pariti yang diedarkan di antara semua pemacu , tanpa mendedikasikan satu cakera secara eksklusif untuk fungsi tersebut. Konfigurasi ini membolehkan pemulihan data pada cakera gantian jika salah satu daripadanya gagal, dengan syarat kegagalan kedua tidak berlaku semasa proses pemulihan.
RAID 6 membawa keselamatan selangkah lebih jauh dengan menyimpan dua blok pariti untuk setiap set data , membolehkannya menahan kegagalan serentak sehingga dua cakera tanpa kehilangan data. Ia memerlukan lebih banyak kapasiti cakera untuk pariti dan lebih banyak kuasa pengkomputeran, tetapi sebagai balasannya menawarkan margin ralat yang jauh lebih besar sekiranya berlaku kegagalan berantai, ciri yang sangat bernilai dalam tatasusunan besar.
Selain tahap RAID "klasik" ini, terdapat kombinasi seperti RAID 10 (pencerminan + jalur), RAID 50 atau 60, dan konfigurasi linear atau JBOD, di mana cakera hanya digabungkan untuk membentuk isipadu yang besar , tanpa redundansi sebenar. Dalam kes ini, RAID tidak menggantikan sistem sandaran yang direka bentuk dengan baik.
Kegagalan sistem RAID biasa dan apabila pemulihan menjadi rumit
Sistem RAID mempunyai reputasi untuk kekukuhan, dan memang wajar begitu, tetapi ia tidak kebal daripada masalah. Dalam praktiknya, ralat fizikal, logik dan manusia berlaku , sering berkait rapat dan membawa kepada situasi pemulihan yang mencabar.
Dari sudut pandangan logik, salah satu halangan paling serius ialah kehilangan atau kerosakan jalur pariti . Apabila metadata yang menunjukkan cara data dan pariti diedarkan merentasi cakera merosot, RAID tidak lagi boleh menjana semula maklumat dengan sendirinya, dan campur tangan luaran diperlukan untuk mencari dan membina semula jalur ini secara manual atau separa automatik.
Berkenaan perkakasan, statistik menunjukkan bahawa sebilangan kecil cakera dalam mana-mana infrastruktur tertentu mungkin gagal secara fizikal setiap tahun, sekitar 2-3%. Dalam tatasusunan dengan banyak cakera, ini bermakna peluang sekurang-kurangnya satu kegagalan tidak boleh diabaikan. Kegagalan mekanikal, lonjakan kuasa, firmware yang rosak, suhu yang melampau atau komponen yang berkualiti rendah adalah punca biasa kegagalan fizikal.
Masalah akan menjadi lebih teruk apabila kegagalan kedua berlaku semasa pembinaan semula, terutamanya dalam RAID 5 atau konfigurasi dengan banyak cakera. Jika, semasa sistem sedang menjana semula data daripada cakera yang gagal, cakera lain mula mengalami ralat yang serius, tatasusunan boleh berubah daripada rosak kepada tidak boleh diakses sepenuhnya. Apabila lebih banyak cakera gagal daripada toleransi yang dijangkakan , logik dalaman RAID tidak lagi mencukupi, dan teknik pemulihan lanjutan mesti digunakan.
Kesilapan manusia melengkapkan lagi masalah: menangguhkan penggantian cakera yang telah memberi amaran, mengabaikan penggera pengawal, mematikan sistem secara tidak betul sekiranya berlaku gangguan bekalan elektrik berulang , memasang pemacu yang tidak mencukupi , memaksa permulaan semula yang berterusan atau menggunakan prosedur penyelenggaraan tanpa sandaran terkini adalah amalan yang meningkatkan risiko kehilangan data dengan ketara.
Penggunaan perisian khusus: contoh praktikal dengan R-Studio
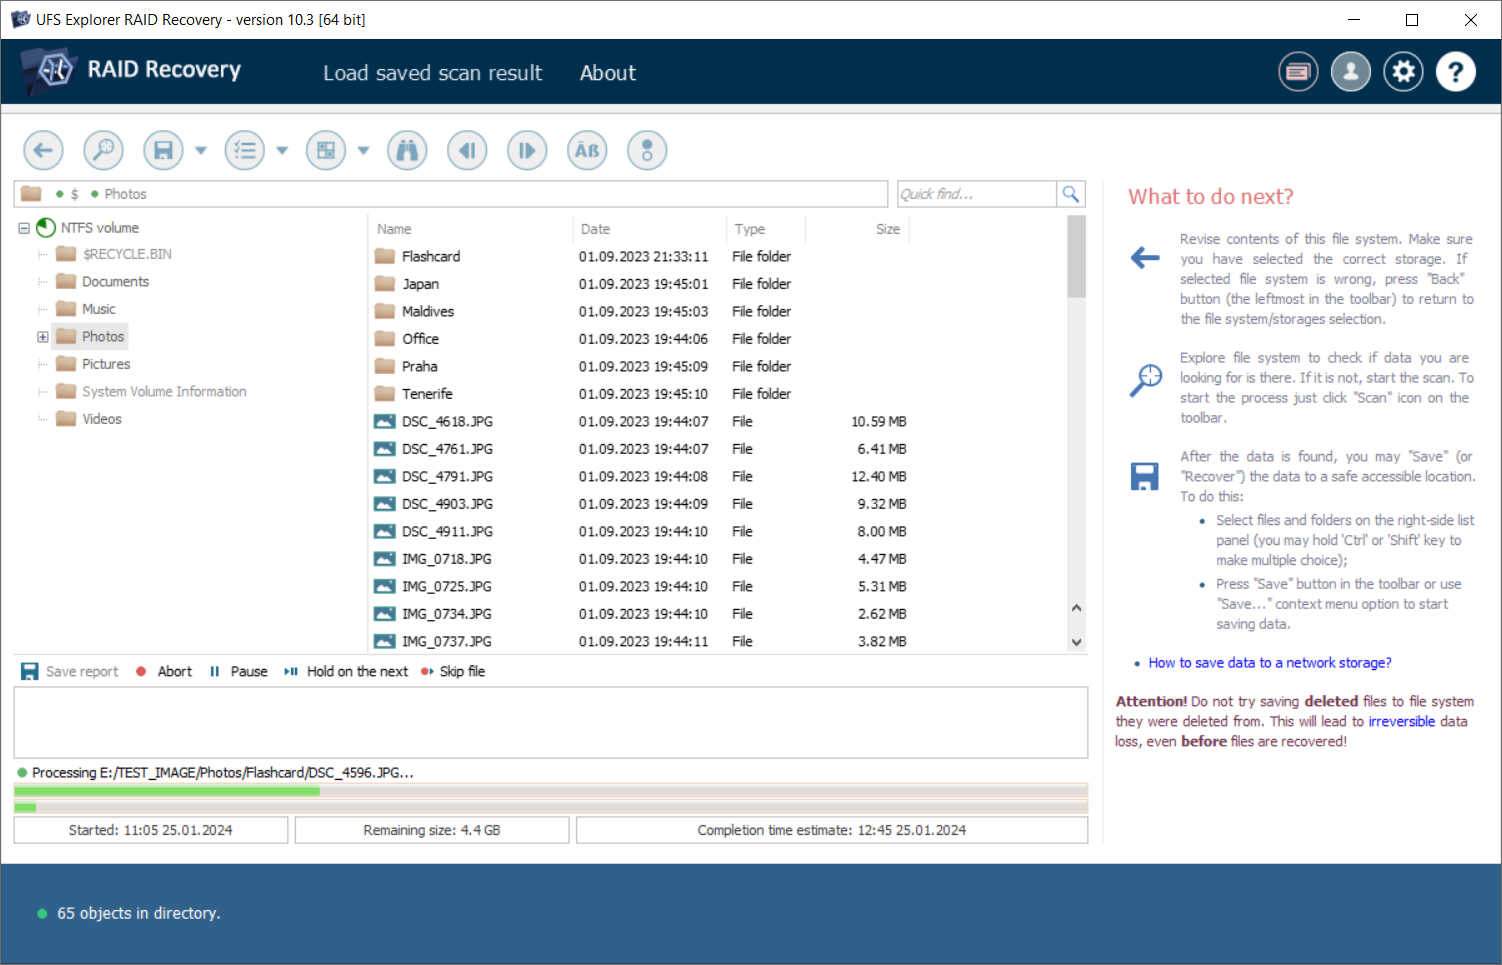
Apabila RAID tidak lagi boleh diakses melalui pengawal asal, salah satu pilihan teknikal adalah dengan membina semula tatasusunan secara maya menggunakan perisian khusus . Alat seperti R-Studio membolehkan anda mengesan RAID yang masih konsisten seolah-olah ia adalah isipadu biasa, dan dalam kes yang lebih serius, untuk mencipta RAID maya daripada cakera atau imej cakera.
Prinsip operasi melibatkan penciptaan tatasusunan RAID maya berdasarkan cakera fizikal atau salinan imejnya , dengan memasukkan parameter secara manual seperti bilangan cakera, saiz blok, ofset permulaan, jenis RAID (0, 1, 4, 5, 6, 10, JBOD, ZFS RAIDZ, RAIDZ2, dll.), dan susunan cakera. Sebaik sahaja perisian mengesan sistem fail yang sah, tatasusunan RAID maya ini dibentangkan sebagai isipadu yang boleh dilayari yang mana fail boleh disenaraikan dan dipulihkan.
Contohnya, untuk tatasusunan RAID 5 ringkas dengan tiga cakera, blok 64 KB dan pariti kiri tak segerak, anda hanya perlu memilih tiga cakera dalam susunan yang betul , menentukan saiz blok, menetapkan ofset yang sesuai dan membiarkan alat mengenal pasti partition. Dari situ, anda boleh membuka volum, memeriksa folder, pratonton fail (terutamanya yang besar) dan mengesahkan bahawa struktur telah dipasang dengan betul.
Dalam konfigurasi yang lebih kompleks, seperti RAID 5 dengan blok 4KB dan corak pariti tersuai, jadual susunan blok mesti ditakrifkan secara manual . Ini melibatkan kemasukan, baris demi baris, cakera yang mengandungi setiap data atau blok pariti, memastikan urutannya konsisten. Perisian ini akan memaklumkan anda apabila ia mengesan ketidakkonsistenan dalam jadual ini supaya ia boleh diperbetulkan sebelum menggunakan perubahan.
Satu langkah berjaga-jaga yang penting ialah RAID maya ini hanyalah objek logik dalam perisian : ia tidak menulis apa-apa pada cakera asal dari mana ia dicipta. Ini membolehkan anda bereksperimen dengan kombinasi parameter yang berbeza sehingga anda menemui kombinasi yang membina semula sistem fail dengan betul tanpa mengambil risiko kerosakan selanjutnya.
Sekiranya cakera fizikal hilang, sesetengah alat membolehkan anda menggantikannya dengan "cakera hilang" atau blok ruang kosong, mensimulasikan tingkah laku RAID yang rosak. Walaupun begitu, agar pemulihan fail boleh dipercayai, semua parameter mestilah betul; satu saiz blok yang salah atau ofset yang salah pengiraan boleh merosakkan fail yang diekstrak, oleh itu pentingnya kepakaran teknikal.
Jenis RAID dan kelakuannya dalam menghadapi kehilangan data
Di luar tahap RAID klasik, sistem RAID hari ini menyokong pelbagai konfigurasi hibrid dan linear . Setiap satu memberikan cabaran yang berbeza apabila melibatkan pemulihan data selepas kegagalan kritikal.
Dalam tatasusunan RAID 0 (jalur tulen), data dipecahkan kepada kumpulan kecil yang ditulis secara berjujukan kepada semua cakera dalam tatasusunan. Jumlah kapasiti ialah jumlah semua pemacu, tetapi tiada redundansi dalam apa jua bentuk . Jika salah satu cakera gagal, keseluruhan volum menjadi tidak boleh digunakan, dan satu-satunya pilihan pemulihan melibatkan teknik lanjutan yang cuba membina semula apa yang boleh dilakukan daripada cakera yang terselamat.
RAID 1 sentiasa mengekalkan salinan semua data yang sama pada setiap cakera dalam cermin . Kesederhanaan ini merupakan kelebihan besar dalam proses pemulihan, kerana jika salah satu cakera kekal utuh, datanya boleh diakses secara langsung seolah-olah ia adalah cakera bebas, atau kandungannya boleh disalin ke pemacu baharu dan cermin itu dicipta semula kemudian.
Dalam tahap RAID seperti RAID 4 dan RAID 5, di mana pariti diagihkan secara berbeza, kapasiti yang boleh digunakan biasanya merupakan jumlah semua cakera ditolak kapasiti hanya satu. Keperluan untuk membina semula data cakera secara matematik daripada pariti adalah apa yang merumitkan pemulihan apabila kegagalan berlaku secara berurutan dan lebih banyak cakera hilang daripada yang dibenarkan oleh reka bentuk.
Konfigurasi Linear atau JBOD (Just a Bunch Of Disks) mengumpulkan beberapa cakera dengan saiz yang sama atau berbeza untuk membentuk satu unit logik yang lebih besar tanpa mengagihkan data secara selari. Konfigurasi ini tidak menawarkan peningkatan prestasi atau redundansi yang ketara: jika mana-mana cakera gagal, akses kepada keseluruhan volum akan hilang . Pemulihan dalam kes ini melibatkan kerja pada setiap cakera dan membina semula kandungan secara manual daripada segmen yang tidak terjejas.
Semua senario ini menekankan bahawa, walau bagaimanapun teknologi storan canggih, sandaran luaran dan yang disahkan kekal penting . RAID mengurangkan atau menghapuskan masa henti sekiranya berlaku kegagalan tertentu, tetapi ia tidak melindungi daripada pemadaman tidak sengaja, kerosakan logik, serangan perisian hasad atau ralat konfigurasi yang memusnahkan maklumat pada peringkat sistem fail.
Petua utama untuk meminimumkan risiko dan melindungi data anda
Cadangan pertama, walau bagaimanapun jelasnya, adalah untuk mengekalkan dasar sandaran tetap yang tidak bergantung pada RAID itu sendiri. Ini termasuk pelayan, stesen kerja, telefon pintar, sistem NAS dan sebarang peranti lain tempat data berharga disimpan. Hanya dengan cara ini, sekiranya berlaku kegagalan yang serius, perkhidmatan boleh dipulihkan tanpa bergantung pada kejayaan pemulihan forensik.
Jika insiden masih berlaku dan tiada sandaran yang boleh digunakan, tindakan paling bijak adalah mengelakkan sebarang percubaan pembaikan DIY tanpa pemahaman yang jelas tentang langkah-langkah dan potensi akibatnya. Sebelum menjalankan alat pembaikan sistem fail, memulakan pembinaan semula automatik atau menukar pemacu antara ruang, adalah dinasihatkan untuk berunding dengan pakar pemulihan data dan menerangkan situasi tersebut kepada mereka secara terperinci.
Adalah penting juga untuk memberi perhatian kepada tanda-tanda awal kegagalan : cakera yang mula menunjukkan sektor yang diperuntukkan semula, pengawal yang menjana amaran, log sistem dengan amaran I/O, tatasusunan storan yang menandakan tatasusunan sebagai terdegradasi… Mengabaikan gejala ini kerana malas atau takut menghentikan perkhidmatan biasanya merupakan permulaan kepada kegagalan yang jauh lebih serius dan mahal.
Akhir sekali, apabila data tersebut berharga, adalah berbaloi untuk mengenal pasti penyedia pemulihan data yang dipercayai terlebih dahulu . Apabila tiba masanya, mempunyai hubungan langsung dapat memendekkan masa tindak balas, membolehkan anda menerima arahan yang tepat dari awal dan meningkatkan kemungkinan memulihkan sebanyak mungkin data.
Pengalaman yang terkumpul dalam banyak kes menunjukkan bahawa gabungan reka bentuk RAID yang sesuai, sandaran yang andal, tindak balas yang tenang terhadap kegagalan dan sokongan pakar apabila diperlukan adalah apa yang benar-benar membezakan antara ketakutan terkawal dan kehilangan data yang dahsyat.