- AI transformeert bestandsbeheer door classificatie te automatiseren, strategische gegevens te extraheren en de authenticiteit te verifiëren.
- Technologieën zoals IDP, computervisie en NLP maken het mogelijk om menselijke fouten te verminderen en de naleving van regelgeving in kritieke sectoren te optimaliseren.
- De mogelijkheid om complexe patronen te analyseren en geavanceerde vormen van fraude op te sporen, maakt documentbeheer tot een concurrentievoordeel en een veiligheidsvoordeel.
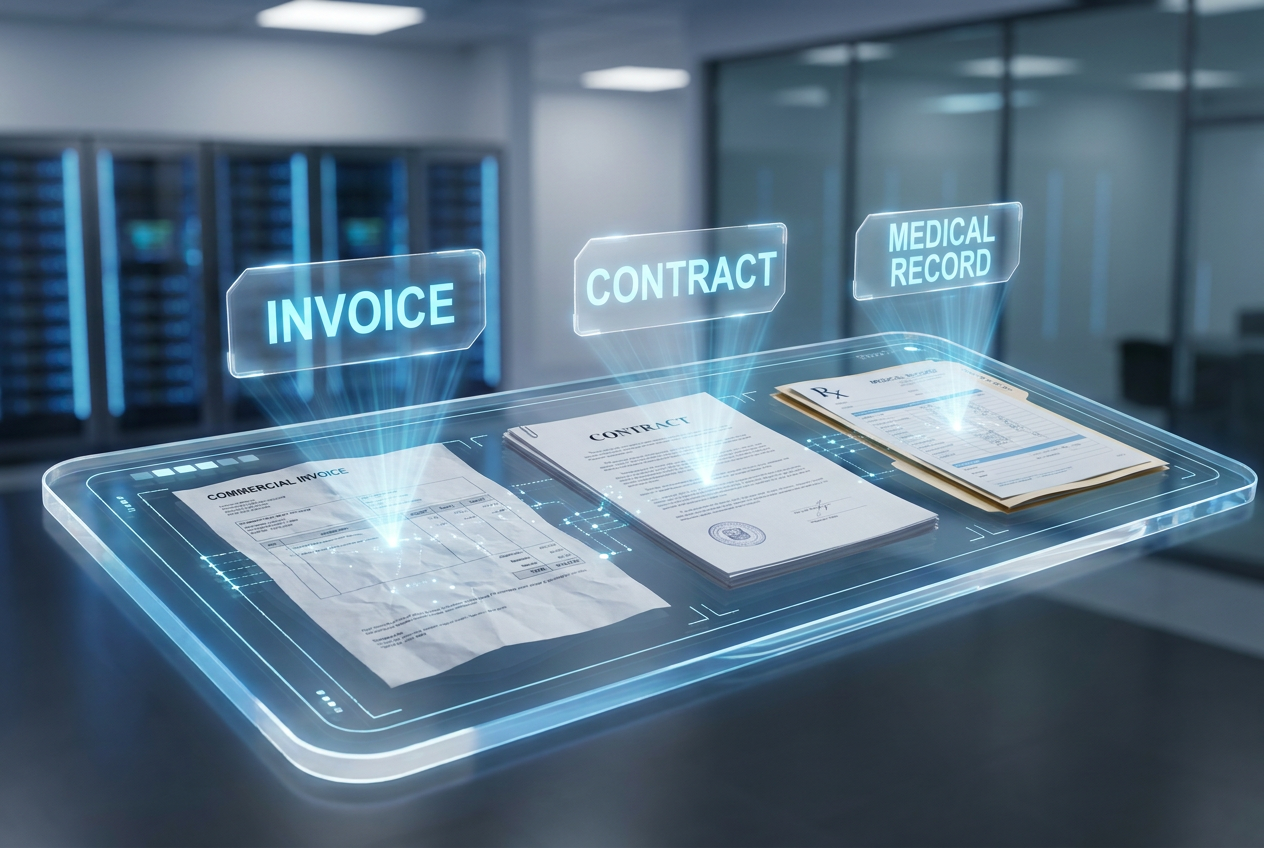
Informatiebeheer in bedrijven is niet langer alleen een kwestie van documenten archiveren of pdf's opslaan in een gedeelde map. Door de explosie aan data raken organisaties verstrikt in een zee van ongestructureerde bestanden , waardoor het vinden van specifieke informatie een ware odyssee kan worden. Hier komt kunstmatige intelligentie in archivering en documentbeheer om de hoek kijken . Het biedt niet alleen een helpende hand, maar verandert de spelregels volledig door documentchaos om te zetten in een strategisch voordeel.
Door intelligente detectie- en analysesystemen te implementeren, kunnen bedrijven stoppen met het verspillen van tijd aan repetitieve en saaie taken. Er is niet langer een expert nodig om elk contract handmatig te lezen of elke factuur te controleren; dankzij machine learning-algoritmen en computervisie kunnen machines nu in een fractie van een seconde begrijpen wat er in een document staat, wat het doel ervan is en welke risico's eraan verbonden zijn – en dat alles met een nauwkeurigheid die het menselijk oog ver achter zich laat.

Intelligente documentclassificatie
Het classificeren van bestanden is meer dan alleen het labelen ervan; het gaat erom zakelijke documenten automatisch te categoriseren om resources te optimaliseren en cruciale fouten te voorkomen. Voorheen was dit proces een knelpunt dat complexe programmering of tijdrovende handmatige inspanning vereiste. Tegenwoordig scant AI elk binnenkomend bestand en plaatst het in vooraf gedefinieerde categorieën, waarna het direct naar de juiste workflow wordt gestuurd voor een naadloze verwerking.
Om dit te laten werken, gebruikt AI fundamentele concepten zoals entiteitsidentificatie (namen, datums of nummers), toewijzing van risicocategorieën (zoals openbare of vertrouwelijke documenten) en permanente labeling. Dat laatste is essentieel zodat andere beveiligingstools weten hoe ze met het bestand moeten omgaan. Bovendien stelt contextualisering AI in staat om het document binnen zijn levenscyclus te begrijpen, waardoor een nauwkeurigheid van meer dan 95% wordt bereikt door niet alleen op trefwoorden, maar ook op de daadwerkelijke betekenis van de tekst te vertrouwen.

Identiteitsverificatie en fraudepreventie
In de beveiligingssector heeft AI een enorme sprong voorwaarts gemaakt in de verificatie van identiteitsdocumenten en is het een essentieel onderdeel geworden van KYC- (Know Your Customer) en AML- (Anti-Money Laundering) processen. Met behulp van computervisie en beeldanalyse kunnen systemen vrijwel onzichtbare wijzigingen detecteren, zoals gemanipuleerde hologrammen, vervalste watermerken of inconsistenties in microdrukwerk die voor de meeste mensen onopgemerkt zouden blijven.
Een van de sterkste punten is het vermogen om digitale fraude te bestrijden. AI analyseert afwijkingen op pixelniveau om Photoshop-retouches of gezichtsveranderingen (deepfakes) te detecteren. Bovendien vergelijkt biometrische gezichtsherkenning de foto in het document met een live video van de gebruiker, waarbij passieve of actieve levendigheidsdetectie wordt gebruikt om te garanderen dat de persoon die het document presenteert fysiek aanwezig is en niet slechts een masker of een foto.

Aandrijftechnologieën: IDP, NLP en OCR
De drijvende kracht achter dit alles is Intelligent Document Processing (IDP), dat verschillende technologieën combineert om daadwerkelijke waarde uit data te halen. Geavanceerde OCR leest niet langer alleen letters; het interpreteert de context om nauwkeurigheid te garanderen en zet afbeeldingen of fysieke documenten om in gestructureerde data. Tegelijkertijd stelt Natural Language Processing (NLP) de machine in staat de semantiek van de tekst te begrijpen, waardoor patronen en afwijkingen kunnen worden gedetecteerd.
- Azure AI-zoekopdracht: Een dienst die diepgaande semantische zoekopdrachten mogelijk maakt in enorme hoeveelheden ongestructureerde data, ideaal voor juridische of HR-afdelingen.
- Taalmodellen (LLM's): Programma's zoals GPT-4, Claude of Gemini kunnen meerdere bestanden tegelijk samenvatten en complexe vragen over de broninhoud beantwoorden.
- Gedragsanalyse: Systemen die monitoren hoe de gebruiker met het document omgaat om te identificeren mogelijke indicatoren van fraude.
Praktische toepassingen in diverse sectoren
De veelzijdigheid van deze tools zorgt ervoor dat vrijwel elke sector er baat bij heeft. In de financiële sector worden betalingen en leningvalidatie geautomatiseerd door middel van realtime data-extractie. In de juridische sector analyseert AI contracten om risicovolle clausules of schendingen aan het licht te brengen, waardoor het eDiscovery-proces wordt gestroomlijnd doordat duizenden documenten binnen enkele seconden worden gefilterd.
De gezondheidszorg gebruikt AI om medische dossiers te digitaliseren en verzekeringsclaims te automatiseren , waardoor het verlies van gevoelige gegevens wordt voorkomen. In de HR-sector maakt de integratie van ERP-systemen (Enterprise Resource Planning) en HR-software het mogelijk om cv's automatisch te classificeren op basis van vaardigheden, zodat de ideale kandidaat gevonden kan worden zonder honderden profielen te hoeven bekijken. In de logistiek zorgt de herkenning van leveringsbonnen en facturen voor een drastische vermindering van operationele fouten en een optimalisatie van de toeleveringsketen.

Systeemimplementatie en uitdagingen
Om een dergelijk systeem te implementeren, is het installeren van software alleen niet voldoende; je moet knelpunten identificeren, zoals tijdrovende processen. Het is cruciaal om meetbare doelstellingen te definiëren en ervoor te zorgen dat de oplossing schaalbaar is en voldoet aan regelgeving zoals de AVG en de CCPA, aangezien de verwerking van persoonsgegevens een gevoelig onderwerp is.
Het verloopt niet altijd even soepel, er zijn namelijk aanzienlijke uitdagingen. Vooroordelen in de trainingsdata kunnen leiden tot oneerlijke resultaten voor bepaalde demografische groepen, waardoor het gebruik van diverse datasets essentieel is. Bovendien ontwikkelen fraudeurs voortdurend hun tactieken, waardoor AI-modellen continu opnieuw getraind moeten worden om te voorkomen dat ze verouderen.
Door deze mogelijkheden te integreren, kunnen tools voor gegevensverliespreventie (DLP) met uiterste precisie werken. Als AI een bestand labelt als 'Vertrouwelijk met hoog risico' , kan het beveiligingssysteem automatisch voorkomen dat het het bedrijfsnetwerk verlaat. Dit transformeert documentbeheer in een echt cyberbeveiligingsschild dat volledige traceerbaarheid van gevoelige informatie garandeert.
De convergentie van semantische analyse, computervisie en generatieve modellen creëert een ecosysteem waarin informatie niet langer alleen wordt opgeslagen, maar actief wordt beheerd. Door het automatiseren van bestandstypedetectie en -validatie besparen organisaties niet alleen kosten en tijd, maar beschermen ze ook hun infrastructuur tegen fraude en stellen ze besluitvorming in staat te baseren op echte, gestructureerde data.
