- Een fundamenteel onderscheid tussen de modeltrainingsfase en de inferentiefase is essentieel voor het genereren van commerciële waarde.
- Analyse van implementatiearchitecturen: van gecentraliseerde cloudverwerking tot edge computing (Edge AI).
- Evaluatie van de technische hardwarevereisten, met name het belang van VRAM in GPU's voor de uitvoering van het model.
- Optimalisatiestrategieën zoals kwantisering en het gebruik van Small Language Models (SLM) om de operationele efficiëntie te verbeteren.

Als we het over kunstmatige intelligentie hebben, denken de meeste mensen aan enorme leerprocessen en supercomputers die triljoenen datapunten verwerken. Er is echter een onderdeel van het proces waar de echte magie voor bedrijven plaatsvindt: inferentie. In wezen is dit het moment waarop AI stopt met leren en begint met werken, waarbij alles wat het heeft geleerd wordt toegepast om problemen uit de praktijk op te lossen en beslissingen te nemen op basis van data die het nog nooit eerder heeft gezien.
In het huidige landschap beschouwen bedrijven AI niet langer alleen als een laboratoriumexperiment, maar als een fundamenteel onderdeel van hun dagelijkse werkzaamheden. Het gaat niet langer alleen om het creëren van het krachtigste model, maar om hoe dit betrouwbaar, veilig en vooral winstgevend kan worden uitgevoerd, waarbij de focus verschuift van theorie naar actieve productie in hybride omgevingen.

Training versus inferentie: ze zijn niet hetzelfde.
Om verwarring te voorkomen, is het belangrijk om deze twee fasen duidelijk van elkaar te onderscheiden. Training is als de schooljaren voor AI; het is een intensief proces waarbij het model historische data en labels analyseert om patronen te vinden. Krachtige hardwareversnellers zoals GPU's of TPU's worden gebruikt in grote datacenters , en de reactietijd is niet de prioriteit, aangezien het proces dagen of weken kan duren.
Inferentie is daarentegen de uiteindelijke test die in realtime wordt uitgevoerd. Het is het uitvoeringsproces waarbij het model een invoer ontvangt (een foto, tekst of sensorwaarde) en direct een resultaat teruggeeft. In deze fase is latentie cruciaal en efficiëntie van essentieel belang. Training legt de basis, maar inferentie genereert directe economische waarde voor de organisatie.
Implementatiestrategieën: cloud, on-premises en edge.
Er is niet één manier om inferentie uit te voeren. Afhankelijk van de urgentie en de hoeveelheid data kiezen bedrijven uit verschillende benaderingen. Batch-inferentie is ideaal voor grote, niet-urgente taken, zoals financiële analyses die 's nachts worden uitgevoerd of grootschalige documentcategorisatie, waarbij de data in de cloud wordt verwerkt en de resultaten later worden teruggestuurd.

Vervolgens hebben we realtime-inferentie , essentieel voor chatbots of fraudedetectiesystemen, waarbij het antwoord binnen milliseconden moet komen. Hoewel de cloud vanwege zijn schaalbaarheid nog steeds de dominante optie is, begint deze zijn beperkingen te tonen door netwerklatentie en hoge bandbreedtekosten bij het verwerken van terabytes aan data.
Hier komt edge inference, ofwel Edge AI, in beeld . Door data direct op het apparaat te verwerken (een IoT-sensor, een robot of een smartphone), worden extreem lage latentie en aanzienlijk meer privacy bereikt, omdat gevoelige informatie niet naar een externe server hoeft te worden verzonden. Dit is cruciaal in sectoren waar een vertraging van milliseconden van essentieel belang kan zijn, zoals autonoom rijden of telechirurgie.
Plant Inference en Industrie 4.0
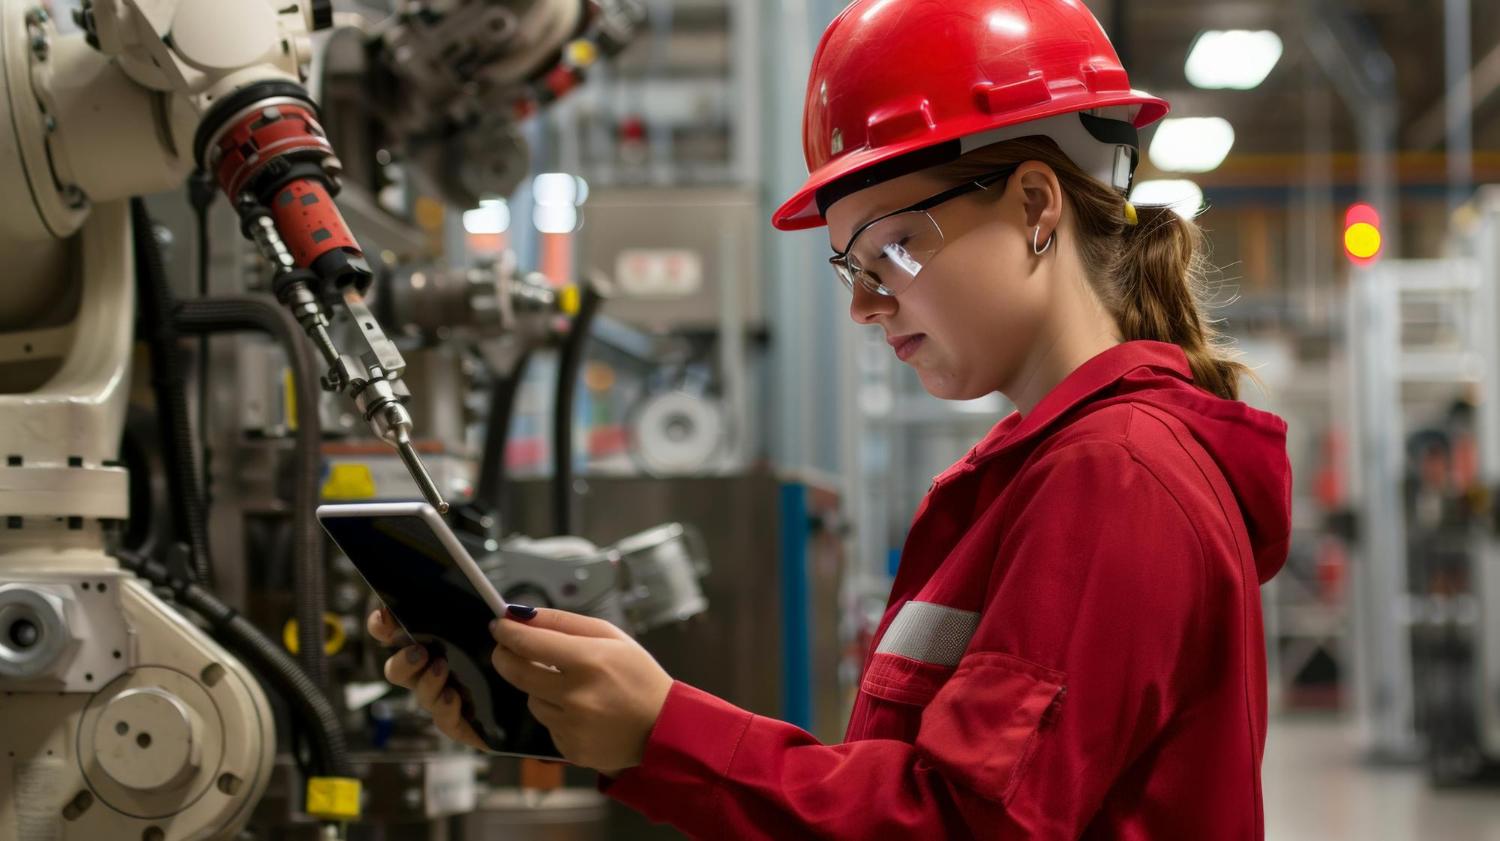
In de maakindustrie is inferentietechnologie een ware aanwinst. Het stelt machines in staat om direct intelligente beslissingen te nemen, zonder internetverbinding. Dit vertaalt zich in realtime kwaliteitscontrole , waarbij defecte onderdelen op de assemblagelijn worden opgespoord voordat ze onnodige kosten met zich meebrengen.

Bovendien vormt het de basis voor voorspellend onderhoud . AI-modellen analyseren de conditie van apparatuur in realtime en geven vroegtijdige waarschuwingen voordat er iets kapot gaat, waardoor productiestops die duizenden euro's zouden kosten, worden voorkomen. In de voedingsmiddelen- en elektronica-industrie zorgt dit ervoor dat het eindproduct altijd aan de strengste kwaliteitsnormen voldoet.
Technische vereisten en modeloptimalisatie
Als een bedrijf besluit om inferentie lokaal uit te voeren, is de hardware cruciaal. GPU's zijn essentieel vanwege hun parallelle architectuur. De meest kritische factor is niet alleen de pure rekenkracht, maar ook het VRAM (videogeheugen); als het model volledig in het VRAM past, schiet de reactietijd omhoog. Anders is het systeem afhankelijk van conventioneel RAM, wat alles aanzienlijk vertraagt.
Om deze modellen te laten werken op apparaten met beperkte mogelijkheden, worden optimalisatietechnieken gebruikt. Kwantisatie verlaagt de precisie van de modelgewichten (bijvoorbeeld van 32 naar 4 bits), waardoor het bestand veel kleiner en sneller wordt zonder al te veel nauwkeurigheid in te boeten. LoRA (Low-Rank Adaptation) daarentegen maakt het mogelijk om grote modellen aan te passen aan specifieke taken zonder het hele model opnieuw te hoeven trainen, wat veel goedkoper en sneller is.

Kleine taalmodellen (Small Language Models, SLM's) winnen ook aan populariteit . In tegenstelling tot de enorme LLM's zijn SLM's ontworpen om efficiënt en lichtgewicht te zijn, waardoor ze perfect geschikt zijn voor edge-hardware. Om hardwarefragmentatie tegen te gaan, wordt WebAssembly (Wasm) gebruikt , waarmee AI op bijna native snelheid kan draaien op elk apparaat, ongeacht de processor.
Bestuur, beveiliging en operationele tools
Het implementeren van AI in productieomgevingen betekent dat het niet langer slechts een spelletje is, maar een bedrijfskritische taak. Veel bedrijven werken al in hybride of multicloudomgevingen , wat de implementatie van strikte routing- en beveiligingsmaatregelen noodzakelijk maakt. Governance richt zich nu op de prompt-, token- en API-lagen, waarbij het beheren van de beveiliging in AI-ontwikkelomgevingen cruciaal is om datalekken te voorkomen.
Voor wie wil experimenteren met lokale inferentie, zijn er een aantal zeer krachtige tools beschikbaar. LM Studio is een uitstekende optie voor gebruikers die op zoek zijn naar een eenvoudige grafische interface en compatibiliteit met Hugging Face-modellen. Voor ontwikkelaars is Ollama dé tool, omdat het open source is en het mogelijk maakt om lokale AI zeer efficiënt op je computer te gebruiken via Docker-containers.

Er zijn ook andere interessante alternatieven, zoals Llama.cpp voor brede hardwareondersteuning, of Jan voor diegenen die prioriteit geven aan een volledig offline omgeving. Er zijn zelfs smartphone-apps zoals PocketPal die inferentie rechtstreeks naar je zak brengen, wat aantoont dat kunstmatige intelligentie niet langer per se een supercomputer nodig heeft om nuttig te zijn.
De trend is duidelijk: kunstmatige intelligentie evolueert naar een gedistribueerd model. De toekomst ligt niet in één centraal brein in de cloud, maar in een intelligent inferentienetwerk verspreid over datacenters en lokale apparaten. Deze hybride architectuur maakt een evenwicht mogelijk tussen rekenkracht, de behoefte aan directe reacties en de bescherming van de privacy van bedrijfsgegevens.
