- Architectonische verschillen tussen CPU en GPU die massaal parallel computergebruik mogelijk maken.
- Cloudimplementatiestrategieën met behulp van standaard-, spot- en flexibele provisioningmodellen.
- Kritische technische criteria voor hardwareselectie op basis van VRAM, bandbreedte en latentie.
- Geavanceerde programmeer- en wereldwijde orchestratiesystemen om het gebruik van AI-clusters te optimaliseren.

Als we het hebben over pure rekenkracht voor het verwerken van enorme hoeveelheden data, kunnen we de fundamentele rol van grafische processoren (GPU's) niet onvermeld laten. Hoewel ze oorspronkelijk ontworpen waren om videogames er fantastisch uit te laten zien, vormen ze tegenwoordig de belangrijkste motor van kunstmatige intelligentie en grootschalige data-analyse, waardoor taken die voorheen weken duurden, nu in slechts enkele uren kunnen worden voltooid.
Het verplaatsen van deze workloads naar de cloud is een ware gamechanger geweest voor ontwikkelaars en datawetenschappers. Het is niet langer nodig om een fortuin uit te geven aan hardware die snel veroudert; in plaats daarvan kunnen we rekenkracht huren die is afgestemd op onze werkelijke behoeften, resources schalen naar gelang het project en elke geïnvesteerde cent in infrastructuur optimaliseren.

CPU versus GPU: Wat is nu eigenlijk het echte verschil?
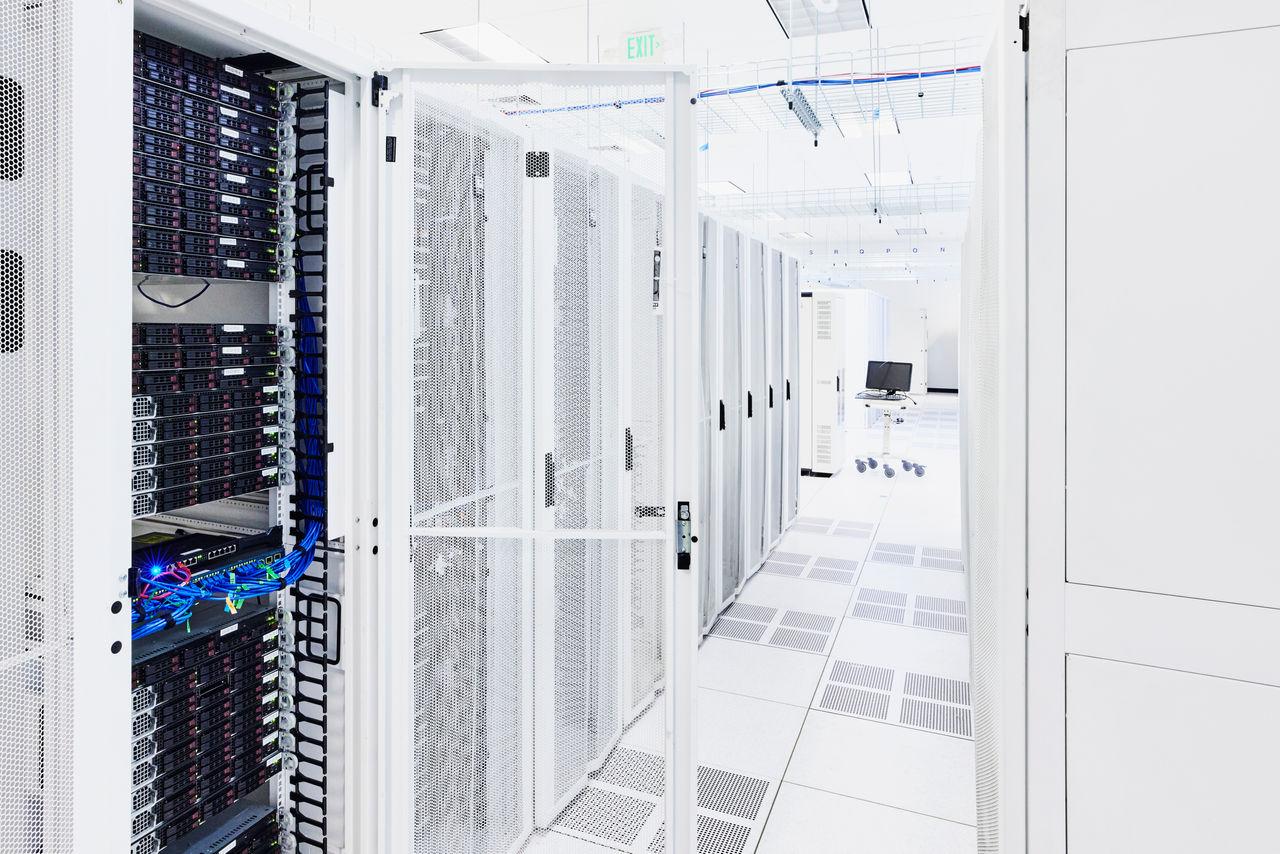
Simpel gezegd is de CPU te vergelijken met een zeer intelligente dirigent die alles kan, maar taken na elkaar verwerkt. De GPU daarentegen is als een leger van duizenden werkers die gespecialiseerd zijn in het steeds opnieuw, maar gelijktijdig uitvoeren van dezelfde wiskundige bewerking. Dit vormt de basis van wat we parallel computergebruik noemen.
Terwijl de CPU complexe logica en systeemcontrole afhandelt, blinkt de GPU uit in matrixverwerking en beeldrendering. Dankzij de honderden of duizenden cores , vergelijkbaar met een multi-core CPU-architectuur maar dan op een gigantische schaal, kan de GPU meerdere deeltaken tegelijk uitvoeren – essentieel voor het trainen van neurale netwerken of het verwerken van terabytes aan data zonder dat het systeem vastloopt.
Batch- en realtime taakbeheer
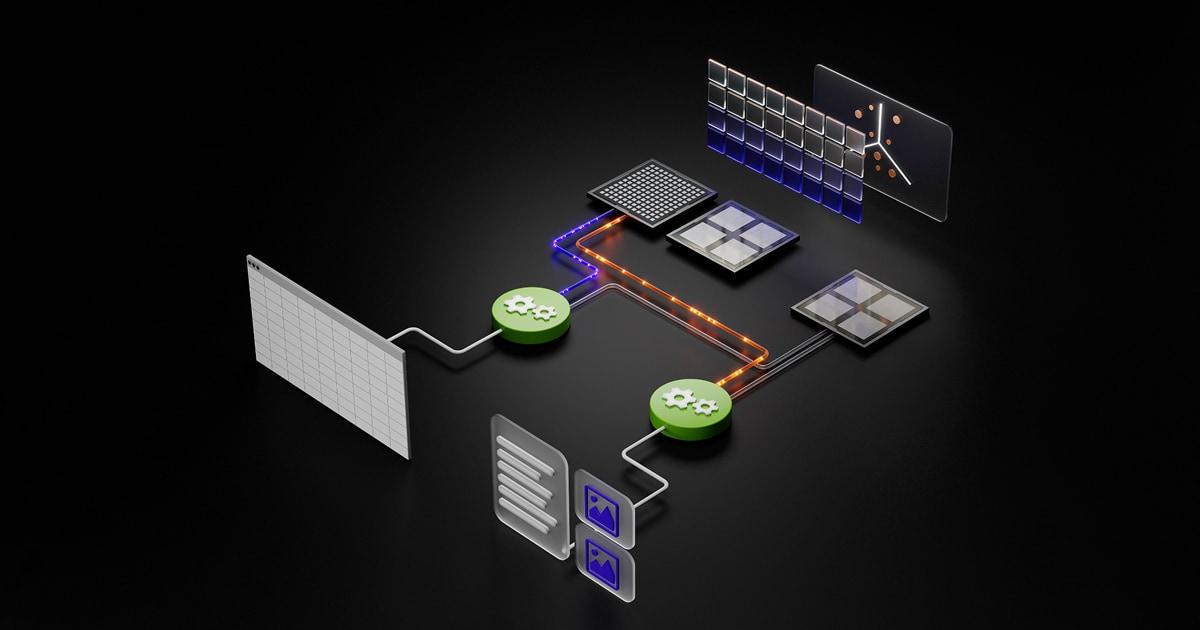
In het cloud-ecosysteem zijn er twee belangrijke manieren om deze taken uit te voeren. Batchverwerking is ideaal voor taken die geen onmiddellijke reactie vereisen, zoals data-voorverwerking of grootschalige inferentie. Het doel hierbij is om de efficiëntie en de algehele systeemprestaties te maximaliseren door taken te laten accumuleren en uit te voeren wanneer er resources beschikbaar zijn.
Aan de andere kant is realtime verwerking cruciaal voor toepassingen die direct moeten reageren, zoals generatieve AI-chatbots of gezichtsherkenning. In deze gevallen is de absolute prioriteit een lage latentie en hoge beschikbaarheid, zodat de eindgebruiker geen vertraging merkt terwijl het model de informatie verwerkt.
Om een project als dit op te zetten, is het essentieel om de vereisten goed in kaart te brengen. Van het selecteren van de juiste machine tot het installeren van de drivers (wat automatisch of handmatig kan gebeuren met behulp van aangepaste images), elke stap is bepalend voor het verloop van het proces en of het een technisch drama wordt.
Verbruiksmodellen en kostenoptimalisatie
Niet alle virtuele machines zijn gelijk, en ze kosten ook niet allemaal hetzelfde. Voor wie geld wil besparen, zijn Spot VM's een aantrekkelijke optie met enorme kortingen, hoewel er wel een risico bestaat dat de cloud ze op elk moment terugvordert. Ze zijn perfect voor taken die fouttolerantie vereisen en waarbij kosten de belangrijkste factor zijn.
Als u iets stabielers maar tegen een lagere prijs nodig hebt, zijn er flexibele virtuele machines voor startups . Deze bieden toegang tot GPU-resources tegen gereduceerde prijzen, in ruil voor een paar dagen vertraging voordat u aan de slag kunt. Voor bedrijfskritische projecten zijn de opties standaard on-demand provisioning of geplande reserveringen , die garanderen dat de hardware er precies is wanneer u die nodig hebt.

Een geavanceerde techniek om het budget te maximaliseren is regionale kostenarbitrage . Door te profiteren van prijsverschillen tussen geografische gebieden of door gebruik te maken van "follow the sun"-planning kunnen teams in Azië, Europa en Noord- en Zuid-Amerika om de beurt de clusters gebruiken, waardoor een hardwarebenutting van bijna 100% wordt bereikt.
Hoe kies je de juiste GPU voor jouw specifieke toepassing?

Het gaat er niet om de duurste kaart te kiezen, maar de kaart die het beste bij de taak past. Bij het trainen van grote taalmodellen (LLM's) is het videogeheugen (VRAM) de belangrijkste bottleneck. Als het VRAM opraakt, moet je de batchgroottes verkleinen, wat de uitvoeringstijden en de totale kosten aanzienlijk zal verhogen.
- AI-training: Het vereist een hoog rekenvermogen in gemengde precisie (FP16/BF16) en een ruime hoeveelheid VRAM om gradiënten en optimalisatietoestanden te verwerken.
- Inferentie in realtime: Netwerklatentie en de stabiliteit van de softwarestack zijn hier cruciaal om productiestoringen te voorkomen.
- Datawetenschap: Er wordt gezocht naar een evenwicht tussen CPU, RAM en GPU, aangezien een groot deel van de gegevensopschoning nog steeds een sequentiële taak is.
- 3D-rendering en VFX: Ze zijn in hoge mate afhankelijk van de geheugenbandbreedte om complexe texturen en geometrieën snel te kunnen verwerken.
- Wetenschappelijke berekeningen: Ze geven prioriteit aan FP32- of FP64-nauwkeurigheid en exacte reproduceerbaarheid van resultaten door middel van vaste driverversies.
Het is van cruciaal belang om de datastroom van het systeem te bewaken . Een extreem krachtige GPU is nutteloos als de CPU of de opslag traag is; in dat geval zal de GPU het grootste deel van de tijd inactief zijn en wachten op data, wat bekend staat als resource underutilization.
Geavanceerde orkestratie en de toekomst van computergebruik
Naarmate clusters groeien, werkt een eenvoudige "first-in, first-out"-planning niet meer. Toonaangevende bedrijven implementeren hiërarchieën voor planning op meerdere niveaus , waarbij taken worden verdeeld op basis van datalocatie, bedrijfsprioriteit en de CO2-voetafdruk van de regio.

Innovaties zoals realtime CPU/GPU-schakeling stellen het systeem in staat om tijdens de uitvoering te bepalen welke processor het meest efficiënt is voor elke thread. Dit pakt het wereldwijde hardwaretekort aan door elke beschikbare klokcyclus te optimaliseren, waardoor generatieve AI en digitale tweelingen zich verder kunnen ontwikkelen zonder belemmerd te worden door een gebrek aan chips.
Het gebruik van Kubernetes met Dynamic Resource Allocation (DRA) en Multi-Instance GPU (MIG)-technologie maakt het mogelijk om één fysieke grafische kaart op te delen in meerdere virtuele instanties. Dit democratiseert de toegang tot krachtige computerkracht, waardoor meerdere gebruikers dezelfde GPU kunnen delen zonder elkaar te hinderen.
Een duidelijke strategie die de juiste hardware, een slim betalingsmodel en flexibele orchestratie combineert, is de enige manier om geldverspilling aan cloudcomputing te voorkomen. Van de selectie van VRAM tot de implementatie van Spot-instances: elke technische beslissing heeft direct invloed op de snelheid van innovatie en de winstgevendheid van elk geavanceerd computerproject.
